Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog GPT-5.6 Sol vs Fable 5.1: どちらのフロンティアモデルがより優れている? ai-comparisons / CometAPIリサーチ
GPT-5.6 Sol vs Fable 5.1: どちらのフロンティアモデルがより優れている? 请提供需翻译为日语的原始文本或文档内容(可为纯文本、HTML、Markdown、JSON、XML、代码片段等)。本助手仅在保持结构与技术元素不变的前提下进行翻译,不生成或比较新内容。
Deon Goodwin AIモデルとAPIの調査チーム 请提供需翻译为日语的原始文本或文档内容(可为纯文本、HTML、Markdown、JSON、XML、代码片段等)。本助手仅在保持结构与技术元素不变的前提下进行翻译,不生成或比较新内容。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR
Claude Fable 5.1 は、難度の高い自律コーディングや長期タスクにおけるベンチマーク上の優位性がより強い。GPT-5.6 Sol は、通常トークン単価が低く、ネイティブのツールスタックが幅広く、独立の最大努力設定比較で最初のトークンまでの時間が短い。適切なデフォルトは、最高スコアだけでなく、タスク失敗のコストに依存する。
2026年9月8日の Intelligence Index スナップショット では、Fable 5.1 が 53、GPT-5.6 Sol が 47。出力スループットは 69.9 対 69.8 tokens/s で事実上同等。これらの結果は品質とコストのトレードオフを裏付けるが、普遍的な速度の勝者を示すものではない。
Key Takeaways
自社評価で高価格を正当化できる最難度の自律タスクには Fable 5.1 を選ぶ。
コスト重視の最先端推論や統合ツールの恩恵が大きいアプリケーションには GPT-5.6 Sol から始める。
出力速度と起動遅延は分けて比較する:GPT-5.6 Sol は最初のトークンまでの時間が短く、スループットはほぼ同等。
明確性、出典の帰属、最新のAPI用語について確認済みです。
モデルキャッシュの書き込み、読み出し、保持期間、長文脈料金を個別に見積もる。入出力の見出し価格はエージェントの全ワークロードを表さない。
データ確認日:2026年9月8日。独立比較は GPT-5.6 Sol を最大努力、Fable 5.1 を Adaptive Reasoning・Max Effort・Default Fallback で使用。ベンダーベンチマークと独立ベンチマークは評価設定が異なる。価格は断りのない限り USD/MTok(百万トークン)単位。
GPT-5.6 Sol vs Fable 5.1: quick verdict Independent Intelligence Index v4.3 (Sep 8) 47 53 Fable 5.1 Independent Terminal-Bench 4.0 (Sep 7) 39.9% 52.0% Fable 5.1 Anthropic-run Terminal-Bench 4.0 37.3% 55.8% Fable 5.1 Context window 1.05M 1M 事実上同等 Maximum output 128K 128K 同等 Text/image input Yes Yes 同等 Official input price / MTok $4 $10 Sol Official output price / MTok $20 $50 Sol Official cache read / MTok $0.40 $0.25 Fable 5.1 Independent output speed (Sep 8) 69.8 tok/s 69.9 tok/s 事実上同等 API tool breadth Very broad Strong
有用な開始方針は、日常のフロンティア業務にはまず Sol を使い、品質や自律性の閾値を満たせないタスクに対して Fable 5.1 にエスカレーションすること。その方針を「成功タスクあたりのコスト」で検証する。
GPT-5.6 Sol は 6 段階の推論努力レベル を公開しており、none から max まで、デフォルトは medium。Fable 5.1 は 常時オンの適応思考 を採用し、努力レベルは推論の深さを調整し、デフォルトは高。
GPT-5.6 Sol の追加 50,000 トークンの文脈は、多くのアーキテクチャで決定打にならない。100 万トークン級に近づくほど、課金やキャッシュ再利用がより重要になる。下記の長文脈セクション参照。
What is GPT-5.6 Sol? GPT-5.6 Sol は、OpenAI の GPT-5.6 ファミリーにおける高性能ティアで、要求の厳しいコーディング、リサーチ、プランニング、エージェントワークフロー向け。本比較での主な魅力は、推論コントロールと周辺の実行環境の組み合わせ。
Responses API を通じ、GPT-5.6 Sol は幅広い ネイティブツール群 (web search、file search、code interpreter、hosted shell、apply patch、computer use、MCP、skills、tool search)をサポート。これにより、アプリケーションが統合すべき個別の実行コンポーネント数を減らせる場合がある。
OpenAI はファミリーに対して プログラム的なツール呼び出し とマルチエージェント実行も説明している。単一回答ではなくツール間で作業を調整する必要がある場合、これらのプラットフォーム機能は重要。
What is Claude Fable 5.1? Claude Fable 5.1 は、要求の厳しいコーディング、プロフェッショナルな知識作業、リサーチ、長時間稼働のエージェントを対象とする。直接的なベンチマーク結果は、短い応答よりも回復・持続・完遂が重要なタスクにおける有力候補であることを示す。
Anthropic は、計画、失敗ステップからの回復、進捗の伝達を含む 持続的な自律実行 を強調。これは長いタスクをテストする理由であり、すべてのワークフローが正しく完了する保証ではない。
Fable 5.1 は API 動作でも GPT-5.6 Sol と異なる:特定ツールの呼び出しが必要なワークフローでは、その 強制的なツール選択の制約 が影響する。決定論的なエージェントループへ移行する際は、サポートされる tool_choice モードを確認すること。
統合の論点は実務的だ。アプリケーションがより自律的な推論ループを許容できるのか、それとも各ステップをより細かく制御する必要があるのか。ルート選択前にツール動作を正確にテストすること。
Benchmark comparison: Fable 5.1 has the stronger direct evidence 競合ベンダー間のベンチマーク比較は誤用されやすい。OpenAI の GPT-5.6 初期評価は Fable 5.1 以前のもので、Anthropic の Fable 5.1 リリースには新しい GPT-5.6 Sol との直接比較が含まれる。
最も素直な読み方は三層構造:Anthropic の直接比較、最新の独立テスト、OpenAI 自身の GPT-5.6 Sol 能力プロファイル。
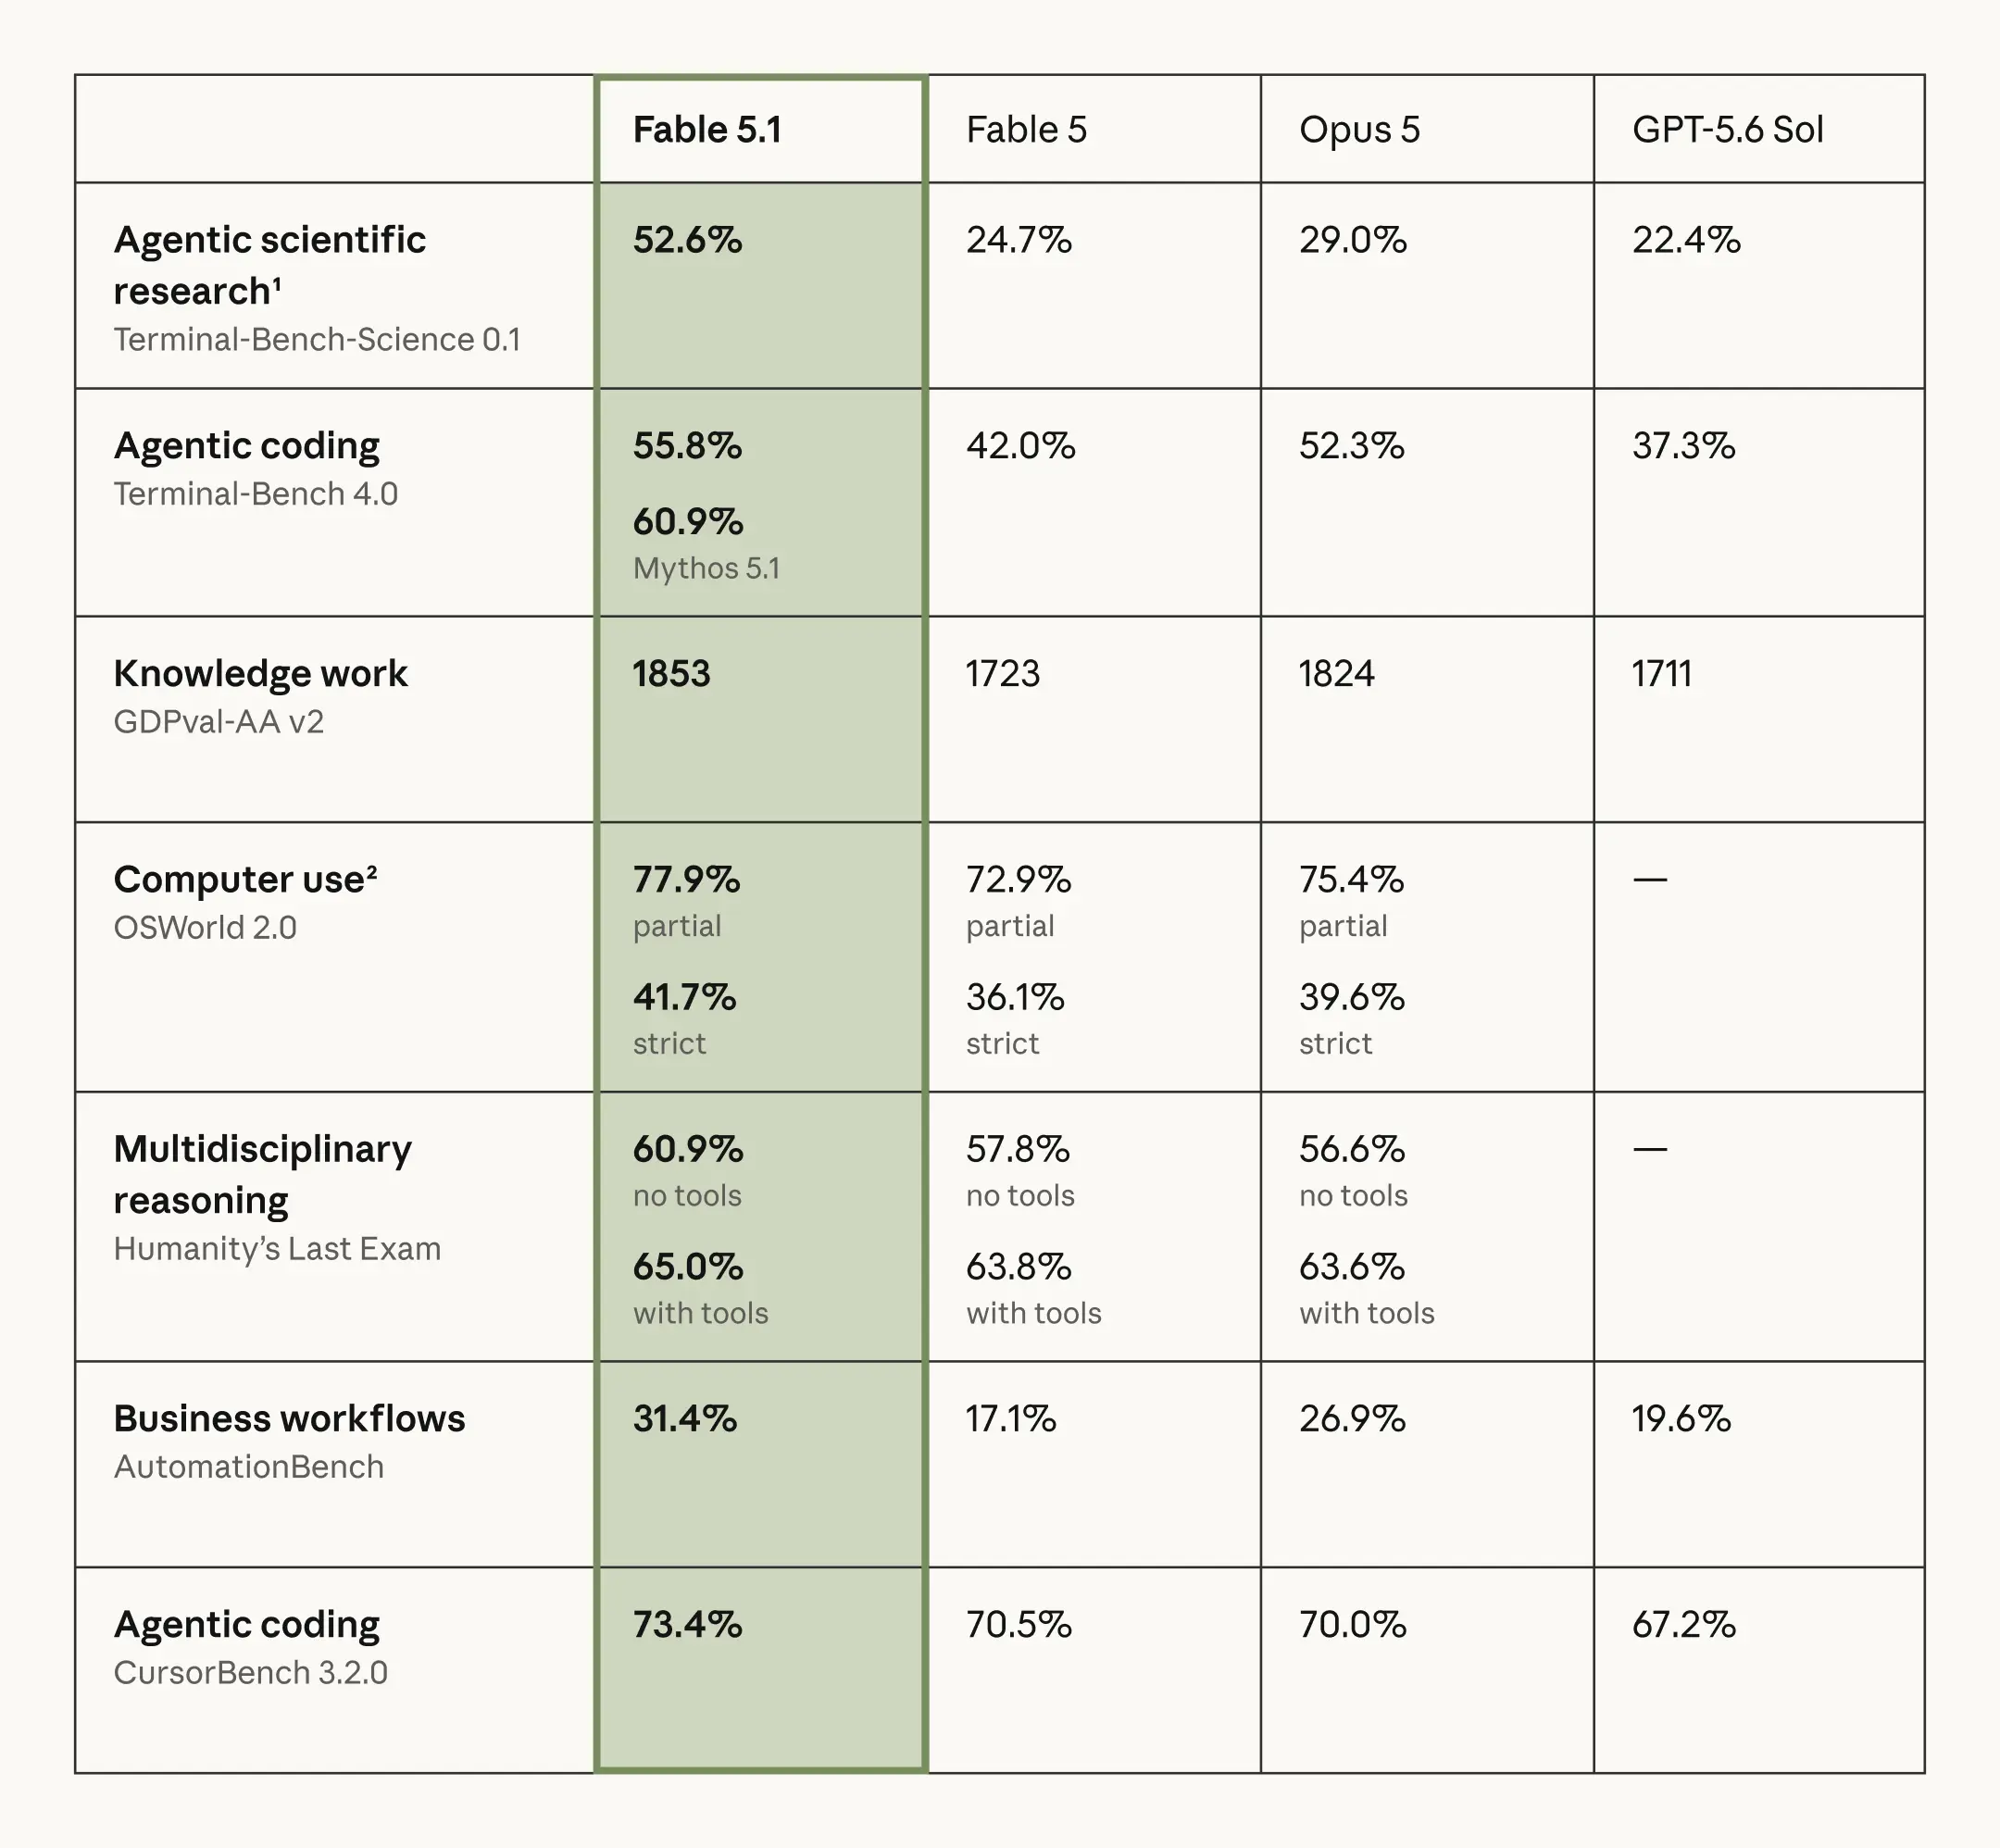
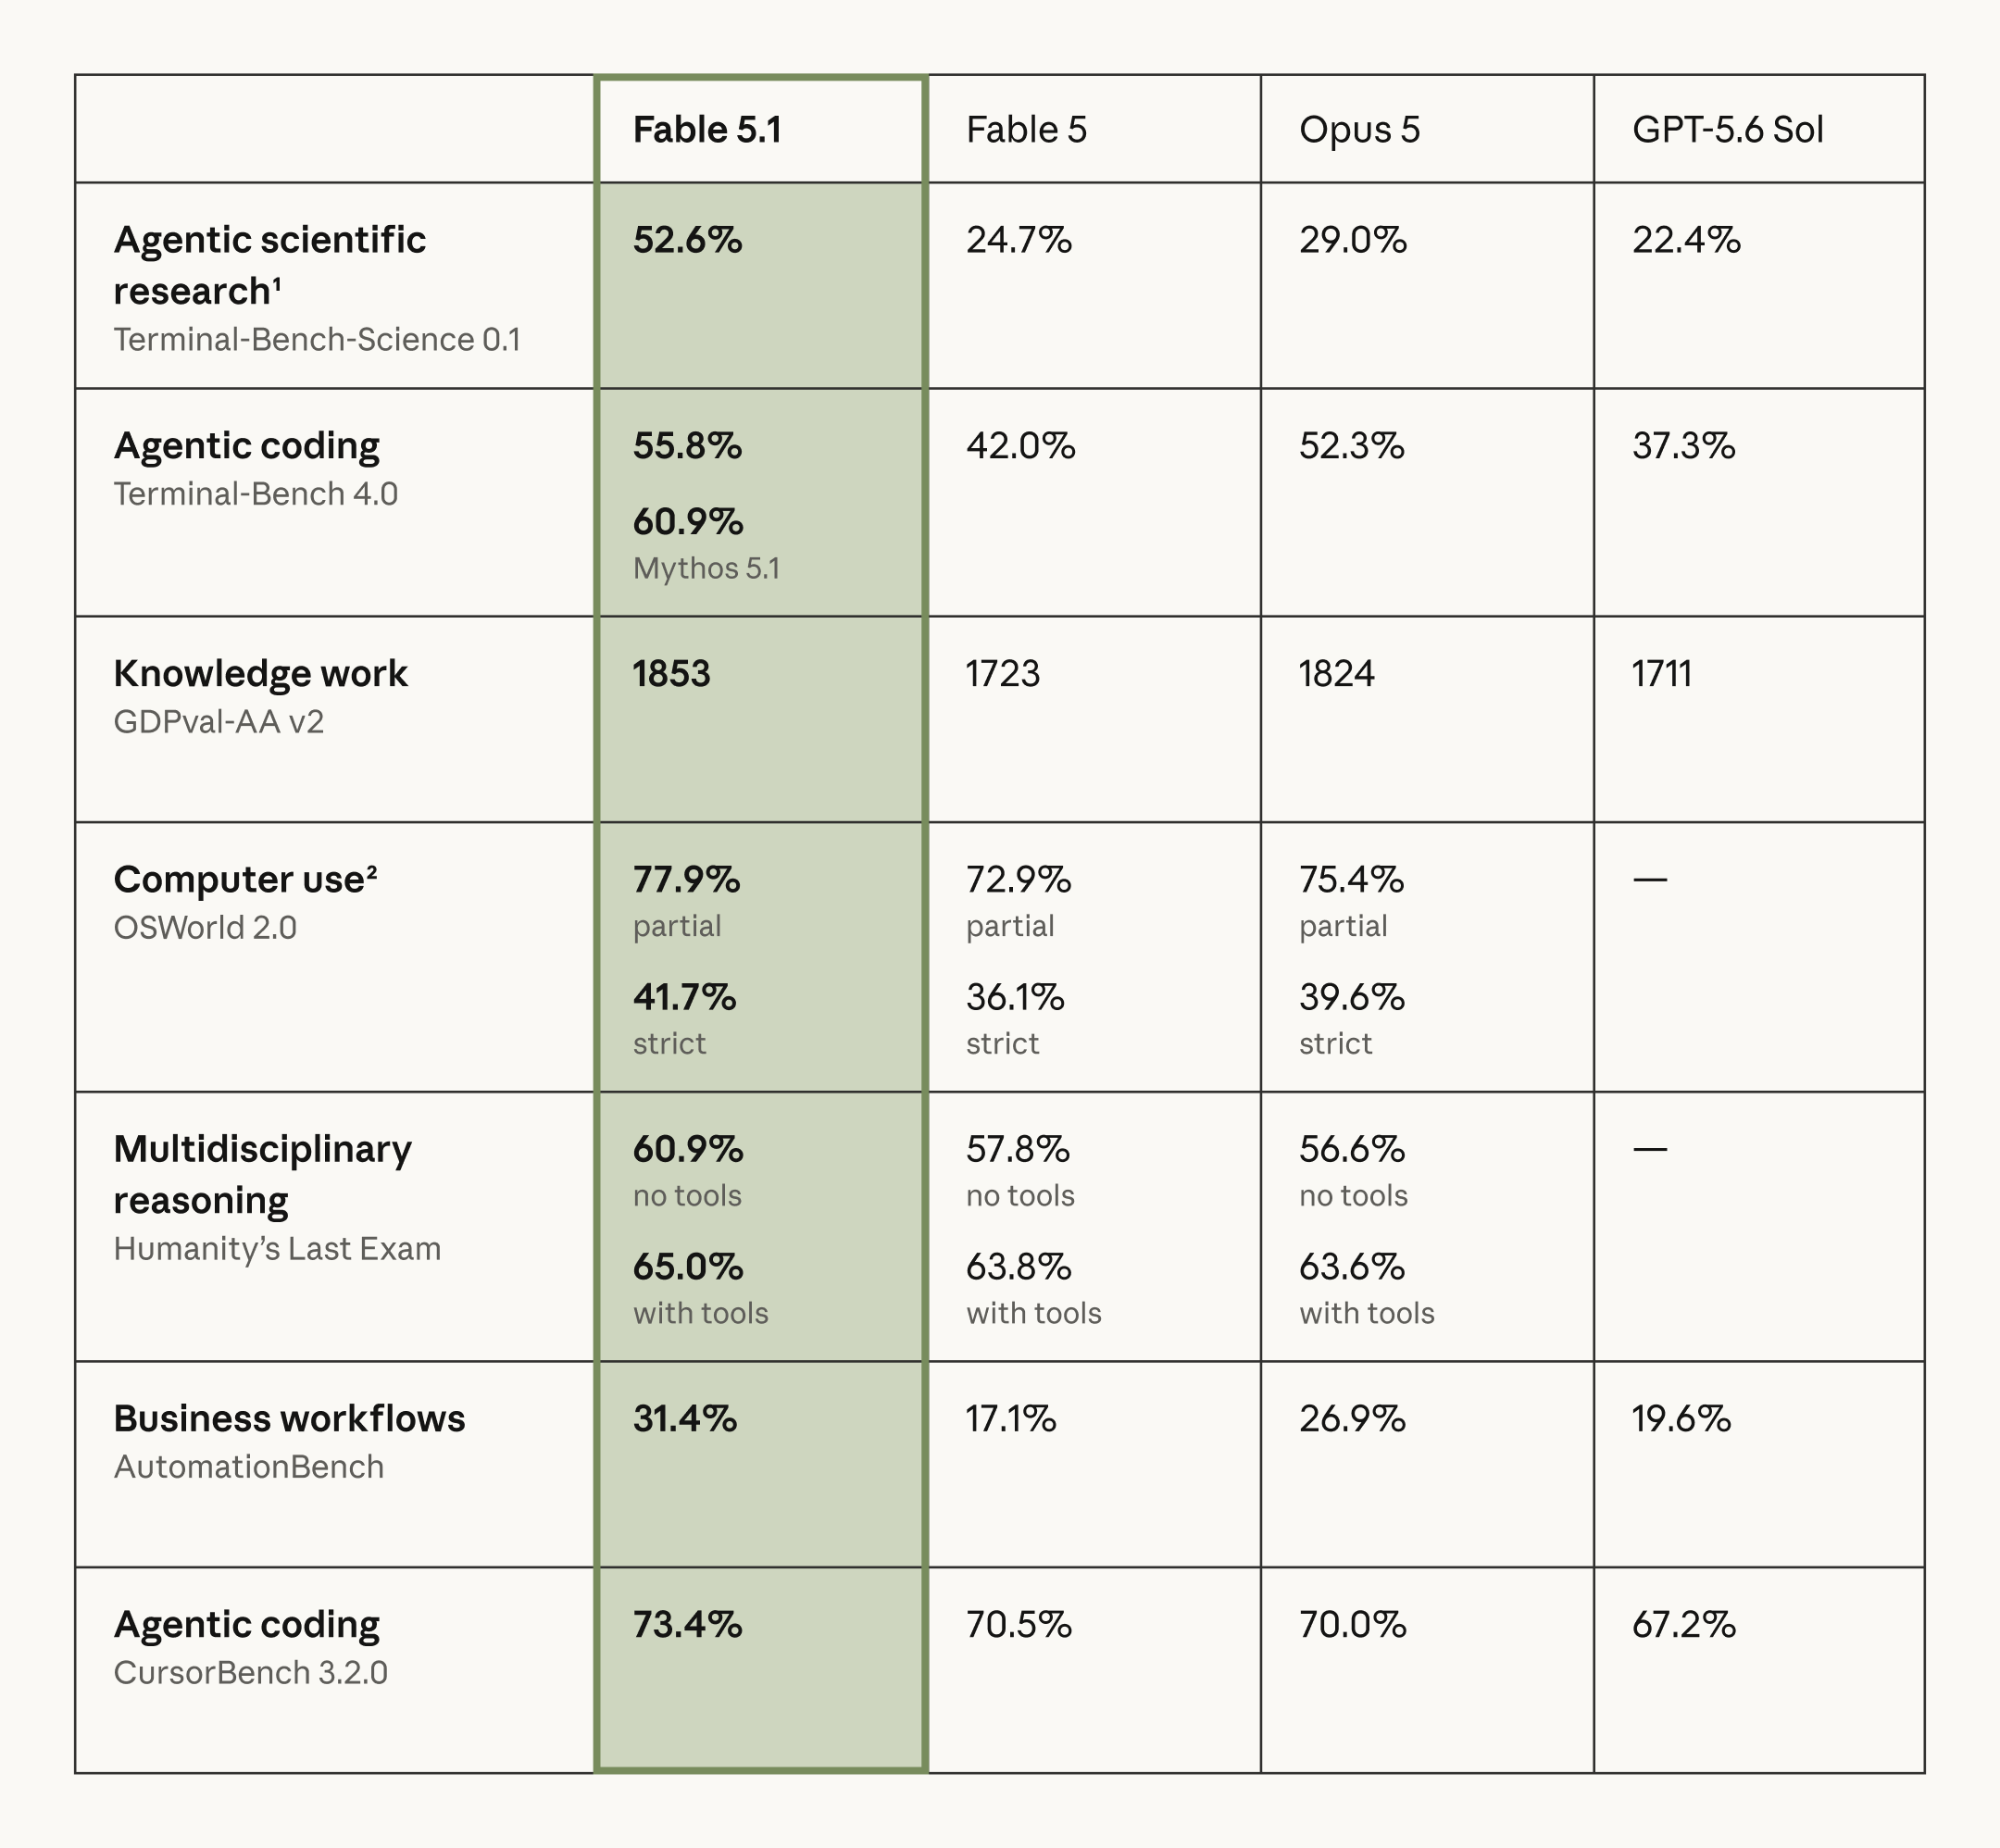
Anthropic’s direct Fable 5.1 vs GPT-5.6 Sol results 公式ベンチマーク結果 は、両モデルのスコアが報告された 5 つのタスクを含む。以下のパーセンテージポイント差と Elo 差は公開値から算出。
Terminal-Bench-Science 0.1 22.4% 52.6% +30.2 ポイント Terminal-Bench 4.0 37.3% 55.8% +18.5 ポイント GDPval-AA v2 1711 Elo 1853 Elo +142 Elo AutomationBench 19.6% 31.4% +11.8 ポイント CursorBench 3.2.0 67.2% 73.4% +6.2 ポイント
結果は異例なほど一貫している:Anthropic が公開したすべての行で Fable 5.1 が GPT-5.6 Sol を上回る。差が大きいのは、一般的な短文推論ではなく、エージェント的な科学研究やターミナルベースのコーディング。
これらはベンダー実施の評価で、Anthropic が自社モデルと競合モデルの両方をテストしている。直接比較の証拠にはなるが、独立テストではない。Anthropic は Terminal-Bench-Science におけるモデルごとの標準誤差を ±3.5–4.5 パーセンテージポイントと報告している。上の表は点推定であり、信頼区間ではない。
ベンダー結果は Fable 5.1 を支持するが、独立証拠は日付と設定の確認が必要。
Independent benchmarks: separate dated results from live measurements Artificial Analysis は 9 月 7 日に Intelligence Index v4.3 を導入し、Terminal-Bench 2.1 を Terminal-Bench 4.0 に置き換え、AutomationBench-AA を追加。リリースでは Fable 5.1 が 53、GPT-5.6 Sol が 47 と報告され、9 月 8 日の比較に示された丸め値と一致。表はリリース時点のターミナル結果と後日の性能スナップショットを区別している。
Intelligence Index v4.3 (Sep 8) 47 53 Fable Terminal-Bench 4.0 (Sep 7 release) 39.9% 52.0% Fable OSWorld 2.0 62.6% 41.7% Output speed (Sep 8) 69.8 tok/s 69.9 tok/s 事実上同等 Time to first token (Sep 8) 132.10 s 277.47 s Sol AA normalized token-mix price / MTok $3.08 $7.175 Sol
スナップショット:2026 年 9 月 8 日(明記された 9 月 7 日の Terminal-Bench 行を除く)。Fable 5.1 は Adaptive Reasoning・Max Effort・Default Fallback、Sol は max。ライブ計測は変動する。AA の正規化トークンミックス価格は 7:2:1 の cache-hit/input/output 比に基づくが、すべての API リクエストのコストではない。
OSWorld 2.0 は本比較で Sol が最も大きく優位な指標で、62.6% 対 41.7%(+20.9 ポイント)。これは Intelligence Index と Terminal-Bench での Fable の優位を相殺する。
証拠は特定のトレードオフを裏付ける:Fable 5.1 は Intelligence Index が高く、Sol は最初のトークンまでの時間が短く正規化価格も低い。出力スループットは事実上同等。これらは、品質重視のバッチ作業とインタラクティブ用途で異なる選択を支持する。
日付付きの独立 Terminal-Bench 比較も Anthropic のテストと同方向を示す:52.0% 対 39.9%、ベンダー側は 55.8% 対 37.3%。評価設定が異なるため、両者の差は互換ではない。
What OpenAI’s benchmarks still tell us about GPT-5.6 Sol OpenAI のローンチ評価は GPT-5.6 Sol の能力に関する追加文脈を与える。これは上記の新しい直接比較以前のもので、Fable 5.1 と数値で直接比較すべきではない。
OpenAI は GPT-5.6 Sol が Terminal-Bench 2.1 で 88.8% と報告。これはローンチ設定下での強力なエージェント的コーディング能力の証拠だが、古いベンチマーク版のため Terminal-Bench 4.0 のスコアと数値比較してはならない。
GPT-5.6 Sol vs Fable 5.1 for coding 単純なコード生成では、どちらのモデルも多くの本番ワークロードには過剰性能。差は、コーディングがエージェント的なソフトウェア工学へと広がると明確になる:大規模リポジトリの調査、複数ファイルの編集、コマンド実行、失敗の診断、テスト作成、パスするまでの反復。
この領域では、Claude Fable 5.1 により強い現行ベンチマーク根拠がある。ベンダー実施・独立の両方の Terminal-Bench 4.0 で優位で、Anthropic の CursorBench でも 73.4% 対 67.2% で優勢。
実践的なコーディング評価では、リポジトリ全体の変更、テスト、レビュー、性能作業を含めるべき。短いコード断片の成功は、複数ファイルや失敗試行にまたがるタスク完遂の弱い代替指標に過ぎない。
周辺の実行環境がモデル品質と同程度に重要な場合、GPT-5.6 Sol は依然として魅力的。shell 実行、apply-patch、code interpreter、file search、computer use、MCP といったネイティブ機能により、自前のオーケストレーション基盤を減らせることがある。
コーディングの結論:最難度の自律的リポジトリ作業を重視する評価では Fable 5.1 を。わずかに低いベンチマーク能力と引き換えに低コストと幅広い統合実行スタックを望むなら GPT-5.6 Sol を。
Reasoning controls and developer experience Sol の none〜max の推論レンジにより、チームは複数設定で品質と遅延を試せる。努力を下げれば推論作業が減る可能性があるが、適切な設定はタスク失敗コストに依存。
Fable の常時オンの適応思考では、努力調整は別の試行になる。同一ラベルの努力=同一計算量と見なさず、実際にデプロイする設定で比較する。
したがって「デフォルトの Sol」と「デフォルトの Fable」を普遍的に公平に比較する方法はない。デフォルトの推論構成が異なるため。実運用の評価では、同等の努力(計算)予算か、実際にデプロイする設定で比較すべき。
GPT-5.6 Sol vs Fable 5.1:Which is better for AI agents? ボトルネックが困難な推論か、その周囲のランタイムかで選択は変わる。
引用ベンチ(ターミナル、オートメーション、プロフェッショナルワーク)での Fable のリードは、最難度タスクに対する妥当な候補であることを示す。一般化の前に、完了率と失敗からの回復を測定すること。
検索、ファイル、shell 実行、パッチ適用を中心にしたアプリケーションでは、GPT-5.6 Sol の Responses ツール群は魅力的。これはタスク正確性と並べて評価すべき統合上の優位であり、代替にはならない。
Hard long-horizon reasoning Excellent Best fit Terminal/repository autonomy Excellent Stronger evidence Native integrated tool portfolio Stronger Strong Forced tool selection Supported; check chosen API Restricted; check tool_choice modes Multi-agent platform integration Strong advantage Available through agent architecture Progress communication during long jobs Good Core behavior Cost-sensitive high-volume agents Better Premium Repeated massive cached context Good Potentially very attractive
必要なタスクの一部だけをエスカレーションする場合、両方を使うのは経済的になり得る。追加の成功完了が、2 つ目のモデルの高価格と起動遅延を相殺するかを測定すること。
Long context: 1.05M vs 1M is not the important difference 見出しの数字はほぼ同じ:GPT-5.6 Sol は 1.05M、Fable は 1M。5% の容量差は、大規模リポジトリ、法的コーパス、研究アーカイブ、複数時間のエージェント履歴を扱えるかを左右しにくい。いずれも百万トークン級。
GPT-5.6 Sol では、272K を超える入力でそのリクエストに 長文脈プレミアム が適用:入力 $8/MTok、キャッシュ読出 $0.80/MTok、出力 $30/MTok。キャッシュ書込も $5 から $10/MTok に上がる。
Fable 5.1 は 標準の 1M 文脈料金 を維持:入力 $10/MTok、出力 $50/MTok、キャッシュ読出 $0.25/MTok。272K 超の別料金は(この記載設定では)ない。
100K の未キャッシュ入力、900K のキャッシュ読出、合計 20K の課金対象出力という一回のターンを考える。GPT-5.6 Sol のコストは 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12。Fable 5.1 は 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225。
このキャッシュ比率の高いターンでは、Fable のキャッシュ読出が安いため価格差がほぼ縮まる。結果はワークロードのトークン構成に依存し、セッション全体で同コストになることを意味しない。
コスト前提:900K トークンのプレフィックスはすでにキャッシュ済みで、100K の新規入力は新たなキャッシュ書込として課金されない。見積もりは初回キャッシュ書込とツール料金を除外。20K の出力には課金対象の推論トークンを含むすべての出力が含まれる。
Pricing: Sol wins ordinary workloads, Fable wins one important cache metric 確認時の料金では、Sol は 入力 $4 / 出力 $20 (MTok)で、キャッシュ読出 $0.40。Fable 5.1 は入力 $10、出力 $50、キャッシュ読出 $0.25。表はプロバイダ公式価格と、CometAPI における GPT-5.6 Sol API と Claude Fable 5.1 API の料金を分けて示す。
Official input / MTok $4.00 $10.00 Official output / MTok $20.00 $50.00 Official cache read / MTok $0.40 $0.25 Official cache write / MTok $5.00 (30 minutes) $12.50 (5 minutes) Above 272K input: input / cache read / cache write / output $8 / $0.80 / $10 / $30 同一の記載ベース料金 CometAPI input / MTok $3.20 $8.00 CometAPI output / MTok $16.00 $40.00
確認時のプロバイダ直契約料金では、Fable 5.1 は未キャッシュ入力($10 vs $4/MTok)と出力($50 vs $20/MTok)の双方で Sol の 2.5 倍。プロバイダのキャンペーンやゲートウェイ価格は変動し得るため、日付付き比較として扱うべき。
短文脈の 100K 入力・10K 課金対象出力のリクエストは、直契約価格で Sol は約 $0.60、Fable は約 $1.50。同条件で上記 CometAPI 料金なら $0.48 と $1.20。これらはキャッシュ書込とツール料金を除外。
Fable の短文脈キャッシュ読出の単価は 37.5% 低い:($0.40 − $0.25) ÷ $0.40。大きな安定プレフィックスを再利用するエージェントでは効くが、総額は新規入力・書込頻度・出力量に依存。
価格の結論:新規文脈のトラフィックでは Sol が安価な出発点。キャッシュ読出比率が高まるほど Fable は競争力を増す。キャッシュ作成・更新を含むセッション全体コストで比較すること。
Speed and latency 最大努力テストでは、最初の可視トークンが出るまでに相当な推論時間を要し得る。
9 月 8 日の スループットとレイテンシ計測 は、Fable が 69.9 tok/s、Sol が 69.8 tok/s。最初のトークンまでの時間は 277.47 秒 対 132.10 秒。出力スループットはほぼ同等で、今回の設定では Sol の開始が早い。
これは最大努力のベンチマーク計測であり、すべての API 呼び出しでのレイテンシを保証するものではない。プロンプト長、推論構成、プロバイダ負荷、ツール、キャッシュ状態により結果は変わる。最初のトークンまでの時間と応答完了時間は異なる指標。
インタラクティブ用途では、観測された短い起動遅延が Sol を支持し得る。非同期のリサーチや夜間のリポジトリ作業では、最初のトークンを待つことより完了の確実性が重要になり得る。意図する設定と並列度で両モデルをベンチマークすること。
Safeguards are a production difference 両モデルは、高度なサイバーセキュリティや科学領域に踏み込む能力を持つため、より強力なセーフガードを適用するが、その実装は異なる。
OpenAI は GPT-5.6 ファミリーに対して 多層の保護とモニタリング を説明。機微領域のアプリケーションは、導入時の振る舞いとして関連セーフガードを評価すべき。
Anthropic の リルーティングと保持条件 では、機微なサイバーセキュリティや生物学のリクエストを、より能力の低いモデルにルーティングする場合があり、その際は Fable の料金を請求しないと記載。デフォルトのデータ保持期間は 30 日で、適格なエンタープライズ契約で例外あり。
通常のコーディングやナレッジワークでは、これらの違いが表面化しないことも多い。セキュリティ製品、規制ワークロード、プライバシー重視のデプロイでは、ベンチ品質や価格と同様にチェックリストに含めるべき。
Which model should you choose? Difficult autonomous coding Excellent Stronger current benchmarks Fable 5.1 Long-horizon research Excellent Core strength Fable 5.1 High-volume frontier API Much cheaper Expensive Sol Interactive coding assistant Lower measured max-effort TTFT Higher measured max-effort TTFT Test deployed settings Tool-heavy API agent Broader native tool stack Strong Sol Million-token cached agent Competitive Very low cache-read price Test both Maximum reasoning quality Excellent Independent lead Fable 5.1 Cost per ordinary request Clear advantage Premium Sol Image/document reasoning Strong Strong Test on workload Single-provider OpenAI stack Natural fit Requires migration/gateway Sol
ルーティング方針は複雑さに見合う価値を生むべき。単一モデルのベースラインと、難度の高いタスクを Fable 5.1 にエスカレーションする Sol 優先方針を比較し、必要品質で「成功タスクあたりのコスト」が改善する場合にのみルーターを維持する。
CometAPI は GPT-5.6 Sol と Claude Fable 5.1 をすでに統合。両モデルへネイティブなリクエスト形式でアクセスし、同一の評価セットを送り、整合した設定下で返却結果を比較する。
各モデルにネイティブ形式のリクエストを使い、プロンプト、データセット、努力設定、同時実行、採点規則を固定する。走行は反復すること;各モデル 1 回の逐次リクエストではレイテンシや品質の信頼できる推定にならない。
本番評価では、固定プロンプト集合を用い、交互順で反復実行し、努力設定を記録し、正答、テスト合格率、ツール成功、リトライ、トークン使用量、経過時間、成功タスクあたり総コストを採点する。共通ベースライン後に、モデルごとに個別チューニングを行う。
Final verdict: GPT-5.6 Sol or Claude Fable 5.1? Fable 5.1 は、最難度の自律コーディングと長期タスクに対して、より強い直接証拠を持つ。共有された 5 行のベンダーベンチでリードし、日付付きの独立ターミナル比較でも優位。自社タスクでの検証を前提に、強力なエスカレーション候補となる。
Sol は、通常トークン価格が低く、より細かな推論コントロールと幅広いネイティブツール群を備える。確認された独立の最大努力設定では最初のトークンまでの時間も短く、出力スループットは事実上同等。
最難度の自律タスクが成功率を左右する場合は Fable 5.1 を優先。コスト重視のフロンティア推論やツール中心のアプリケーションには Sol から始める。インタラクティブ用途では、デプロイ済み努力設定で観測された起動遅延の優位が維持されるかを確認する。
単一モデルで要件を満たすならそれが最善。評価結果が、両者の切替により品質または成功タスクあたりコストが改善することを示す場合に限り、ルーティングを追加する。
FAQ
Is Claude Fable 5.1 better than GPT-5.6 Sol? 9 月 8 日のスナップショットでは独立 Intelligence Index が高い:Fable 5.1 は 53、Sol は 47。また、日付付きの独立ターミナルテストでもリード。これらは当該評価での品質優位を支持するが、あらゆるワークロードで優れているという主張ではない。
Is GPT-5.6 Sol cheaper than Claude Fable 5.1? 通常の未キャッシュ API トラフィックではその通り:確認したプロバイダ直契約の入出力単価は Sol が $4/$20、Fable 5.1 が $10/$50。キャッシュ重視のワークロードでは、Fable のキャッシュ読出が安いため差が縮まる可能性がある。書込と期限の挙動も見積もりに含めること。
Which model is better for coding? 本比較では、自律的コーディングのベンチマーク証拠は Fable 5.1 が強い。Sol は低コストのワークロードや統合実行ツールで依然有力。実行可能なテスト付きのリポジトリタスクで、測定された能力差がアプリケーションにとって重要かを判断すること。
Which model has the larger context window? Sol は 1.05M、Fable 5.1 は 1M で技術的には Sol が大きい一方、両者とも最大 128K 出力を許容。実際には、Sol の >272K での料金しきい値と Fable の安価なキャッシュ読出のほうが、50K トークンの容量差より重要になることが多い。
はい。CometAPI の GPT-5.6 Sol API と Claude Fable 5.1 API はテキスト評価の共通出発点を提供する。ベースラインを本番エージェントへ拡張する前に、ルート固有の推論、キャッシュ、ツール対応を確認すること。
Long-running autonomous work Excellent Core strength Fable 5.1
Cost-sensitive production Better default Premium escalation Sol
Model-independent routing Strong Strong Use both through CometAPI
GPT-5.6 Sol vs Fable 5.1: どちらのフロンティアモデルがより優れている? - CometAPI