SolutionsChoose your path
For individualsBuild, learn, and create with simple usage-based access. For businessScale teams, billing, governance, and model workflows. ai-comparisons/CometAPIリサーチ
GPT-6.1 Terra 対 DeepSeek V4.1 Flash:ベンチマーク、機能、価格
ベンチマーク、コーディング、ビジョン、コンテキスト、API 料金、CometAPI へのアクセスの観点から GPT-6.1 Terra と DeepSeek V4.1 Flash を比較し、どちらが優れているかを判断してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)
TL;DR: 推論品質や複雑なビジュアルワークフローを最重視する場合は GPT-6.1 Terra がより強力な出発点。トークンコスト、生成速度、またはセルフホスティングを優先する場合は DeepSeek V4.1 Flash が魅力的。本比較は DeepSeek の10月17日のアップデート、Flash-1017 を使用。
DeepSeek Flash-1017 はトークン価格が低いが、完了タスクのコストは推論の長さ、リトライ、ツール呼び出しにも依存する。
以下の比較では、アーキテクチャ、コンテキスト、推論、コーディング、ビジョン、速度、価格、デプロイを扱う。価格とライブ評価ページは 2026年10月28日に確認。
Key Takeaways
- Terra は引用された独立系 Intelligence Index 比較で上位にあり、要求の厳しい推論タスクの最初の候補として論理的。
- DeepSeek は掲載トークン価格が低い。ピーク時料金、キャッシュ利用、推論トークン、リトライを含め、成功タスクあたりのエンドツーエンドのレイテンシとコストを比較。
- コーディングは受理されたパッチ数、ビジュアルワークフローは完了タスク数で評価。公開ベンチマークスコアは有用だが、テスト設定は異なる。
- Terra はホスト型のプロプライエタリモデル。DeepSeek は MIT ライセンスのダウンロード可能なウェイトを提供し、セルフホスティングが可能(ハードウェアと運用コストに留意)。
明確性、出典の帰属、最新のAPI用語について確認済みです。
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Overview and Specifications
主な仕様差は、出力上限、推論制御、ツール呼び出し、デプロイに関係する。以下の表は両モデルの概要。
|
| アーキテクチャとパラメータ | 独自アーキテクチャ;パラメータ数は非公開 | 552B の Causal Encoder–Decoder MoE;入力で約 8B、出力で約 16B のアクティブパラメータ |
| コンテキストウィンドウ | 1,050,000 トークン | 1M トークン |
| 最大出力 | 128,000 トークン | 384K トークン |
| 入力モダリティ | テキスト、画像 | テキスト、画像 |
| 出力モダリティ | テキスト | テキスト |
| 推論制御 | none、low、medium、high、xhigh、max | Thinking トグル;Chat Completions では low、high、max |
| ツール呼び出し | Responses API を通じてサポート | サポートあり;挙動はエンドポイントと thinking モードに依存 |
| オープンウェイト | なし | あり、MIT ライセンス |
Architecture and Model Versions
Terra はパラメータ数が非公開の独自アーキテクチャを使用。DeepSeek-V4.1-Flash は Causal Encoder–Decoder の MoE アーキテクチャで、入力処理と出力生成で異なるアクティブパラメータ予算を持つ。
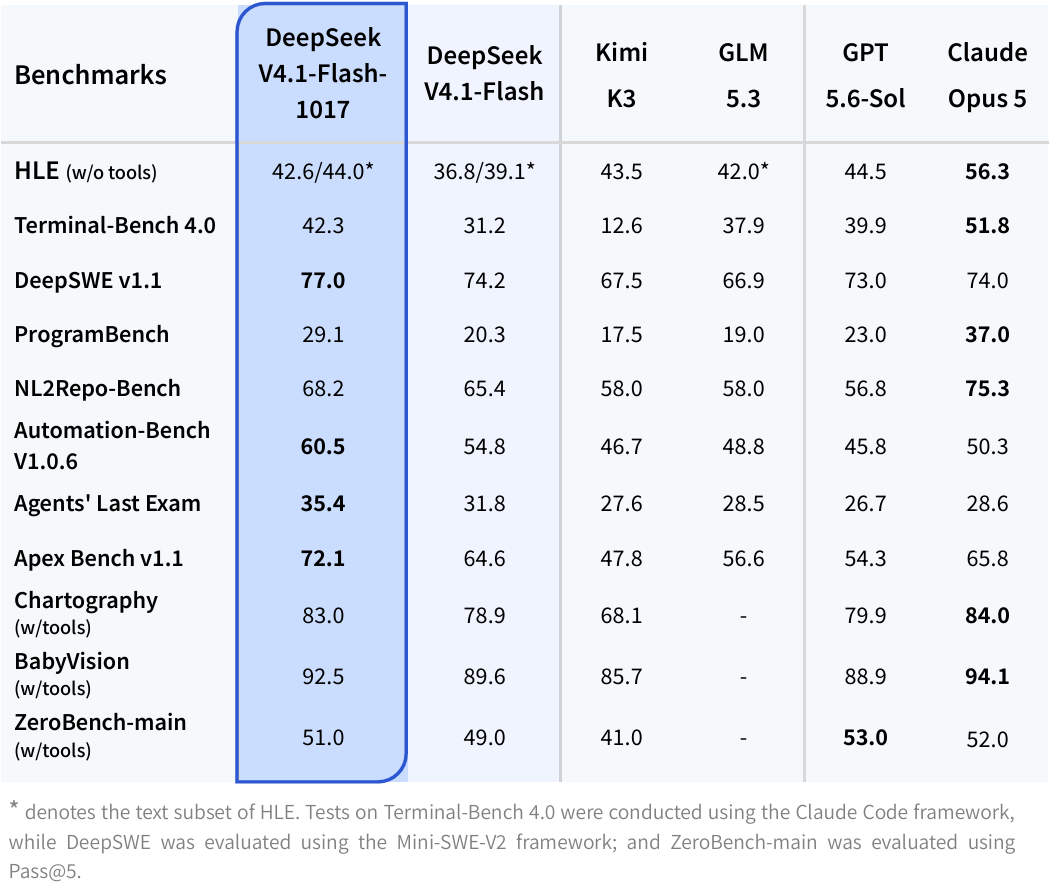
DeepSeek の V4.1 Flash リリース は、552B パラメータの Causal Encoder–Decoder Mixture-of-Experts バックボーンを説明しており、入力処理時に約 8B、出力生成時に約 16B のパラメータがアクティブになる。10月17日の更新は、公開されているコーディング、エージェント、ビジョンの結果を改善。
この記事では Flash-1017 がその 10月のチェックポイントを意味する。汎用的な API エイリアスは後に別バージョンを指す可能性があるため、評価記録には実際に提供されたモデルバージョンを含めること。
KV Cache and Deployment Requirements
DeepSeek はグローバルな KV キャッシュのフットプリントがトークンあたり約 890 バイトで、DeepSeek-V4-Flash の約 4 分の 1 と報告している。これによりキャッシュ効率は向上するが、セルフホスティングではモデルウェイトに相応のリソースが依然として必要。Terra はホスト型サービスで利用可能、DeepSeek はダウンロード可能なウェイトによりセルフホスティングの選択肢も提供。
両モデルはエージェントワークフローをサポートするが、推論制御とツール呼び出しの要件は異なる。Terra の文書化された ツール呼び出しサポート は Responses API を使用。DeepSeek のモデルカードは 1~100 の数値推論労力を記載しているが、ホスト型 API の制御は別途確認が必要。モデル切り替え時は、選択したエンドポイントに合わせて推論パラメータとツール定義を調整。
以下は推論、コーディング、ビジョン、長コンテキストタスクを比較。独立系評価とベンダー報告ベンチマークを区別し、モデル構成とエージェントフレームワークに沿って結果を解釈。
Reasoning and Knowledge
Terra の高い総合スコアは、要求の厳しい推論タスクを試す際に優先候補とする根拠になる。限定的なワークロードでは、必要な精度を満たしつつ成功タスクあたりのコストが低ければ DeepSeek が適している場合もある。
Official Coding and Agent Benchmarks
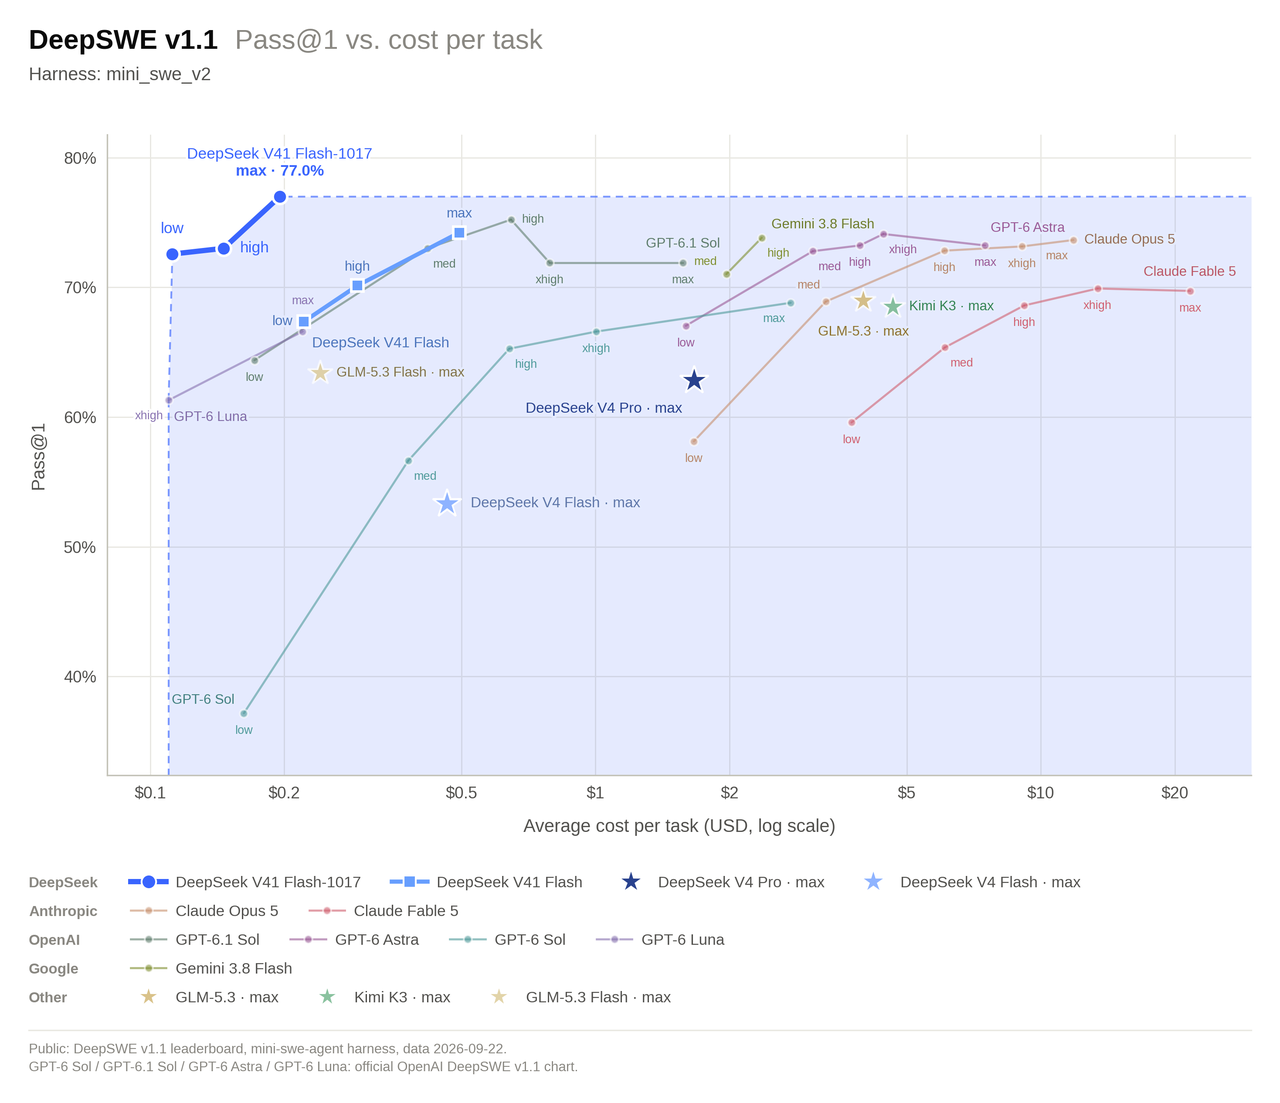
Terminal-Bench 4.0 と DeepSWE v1.1 はコーディングおよびエージェント性能に関する証拠を提供。ベンダー結果を比較する際は、正確なモデルバージョン、推論設定、エージェントフレームワーク、スコアリング指標を特定すること。これらの違いはスコアに大きな影響を与えうる。
実務のコーディングでは、各モデルが既存テストを通過するパッチを生成するか、公開インターフェースを維持するか、エッジケースを処理するか、無関係な変更を避けるかを比較。ツール呼び出しの信頼性や実行エラーからの復旧も、エージェントが完了できる作業量に影響。
DeepSeek の低い掲載トークン価格は、受け入れ基準が明確なリポジトリ保守の繰り返し作業に有用。より複雑な変更では、受理されたパッチ、成功タスクあたりの総コスト、人手による修正時間を両モデルで比較。
Vision and Computer Use
両モデルは画像入力を受け付けるが、画像理解とデスクトップ操作には異なる能力が必要。OpenAI の Terra ローンチ資料は MMMU-Pro と OSWorld 2.1 に言及、DeepSeek のモデルカードは Chartography や BabyVision を含むビジュアルタスクを報告し、ツール支援設定を伴う。
文書抽出では、フィールド精度、見落としテキスト、表構造を比較。デスクトップ自動化では、完了したワークフロー、誤った操作、インターフェイス変更後の復旧を比較。スクリーンショットを正確に記述できるモデルでも、表示されたアプリの操作に苦戦する場合がある。
ワークフローに応じて選択:文書処理では抽出精度、コンピュータ利用エージェントでは信頼できる操作と復旧が重要。両モデルが必要品質を満たした後にコストを比較。
Long-Context Reasoning and Retrieval
両モデルは長文書ワークフローをサポートするが、コンテキスト容量だけでは検索品質は決まらない。同一文書コレクションで比較し、重要な根拠を文頭・中間・末尾に配置。
回答精度、引用パッセージ、文書間の一貫性、応答の完全性を評価。調査や文書分析では、レイテンシとコスト要件内で関連証拠を確実に検索・接続できるモデルを選好。
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Speed
Output Throughput and Task Completion Time
より速くトークンを生成するモデルでも、推論が増えたり、ツール待機やリトライがあれば完了まで時間がかかることがある。ファーストトークンまでの時間、総完了時間、受理タスクのレイテンシを別々に計測。
Interactive Latency on Your API Route
インタラクティブなプロダクトでは、現実的な同時実行で短文と長文のプロンプトをテストし、中央値と 95 パーセンタイルのレイテンシを記録。リージョン、API ルート、プロンプトキャッシュ、推論設定、リトライポリシーを結果に含める。その記録は、単一のトークン/秒指標よりユーザー体験をよく示す。
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Cost
Terra のレートカードと DeepSeek の料金ポリシーに基づく以下のファーストパーティレートは、2026年10月28日に確認。すべて 100 万トークンあたりの米ドル。
Official API Rates
|
| 入力、キャッシュミス | $1.00 | $0.15 | $0.30 |
| 入力、キャッシュヒット | $0.05 | $0.003 | $0.006 |
| 出力 | $5.00 | $0.60 | $1.20 |
DeepSeek のピーク料金は、月~金の 01:00–04:00 および 06:00–10:00 UTC(中国の祝日を除く)に適用。これは中国標準時(UTC+8)で 09:00–12:00 と 14:00–18:00。他の時間帯はオフピークレート。
Terra では 272,000 入力トークンを超えるリクエストに対し、OpenAI はリクエスト全体に 2× の入力・キャッシュ入力レートと 1.5× の出力レートを指定。基準価格を実効価格として扱う前に、実際のプロンプトサイズと条件を比較。
|
| 非キャッシュ入力 | $0.80 | $0.12 |
| 出力 | $4.00 | $0.48 |
| キャッシュ入力 | 別途明示なし | $0.0024 |
| 時間帯による乗数 | 基準価格に明示なし | 指定ピーク時間帯は 2× |
CometAPI は DeepSeek のピーク時間帯を 月~金の 01:00–04:00 および 06:00–10:00 UTC と記載。掲載スケジュールは、DeepSeek のファーストパーティポリシーと同じ祝日例外を確立するものではない。意図する実行時間に対して選択したルートの課金条件を確認。
Fixed-Token Cost Example
100,000 の非キャッシュ入力トークンを消費し、10,000 の出力トークンを生成するリクエストを考える。
これが課金対象トークンの合計であれば、トークンチャージはTerra の場合 $0.150、DeepSeek オフピークの場合 $0.021、DeepSeek ピークの場合 $0.042。オフピークの削減率は 86%。この例は追加のツール料金、インフラ、リトライを除外;別途計上される推論トークンがある場合は計算に含める必要あり。
CometAPI の掲載基準レートでは、同じ 100,000 入力と 10,000 出力トークンで Terra は $0.120、Flash は $0.0168。掲載された 2× ピーク乗数を適用すると Flash は $0.0336。これらは記載のトークン数を用いたトークンのみの計算であり、実タスクの測定ではない。
非キャッシュ入力を 100,000 トークンに固定し、Terra の総課金出力を 10,000 トークンとする。このとき Terra の標準トークン課金は $0.150。Flash はオフピークでは 225,000 課金出力トークン、ピークでは 100,000 で同額に到達。この算術は出力量のみを分離しており、キャッシュ、繰り返し入力、ツール料金、リトライが比較を変える。
Cost per Successful Task
固定のタスクバッチを評価し、受け入れチェックを通過したタスク数で、すべての課金 API とツール支出を割る。失敗試行の支出も計上。成功率も併記し、容易な作業のみを完了してモデルが不当に評価されないようにする。
成功タスクあたりのコスト = 総 API とツールコスト / 成功完了タスク数
Which Should You Choose: GPT-6.1 Terra or DeepSeek-V4.1-Flash?
タスクの品質要件、コスト目標、デプロイニーズに応じて選択。上記のベンチマーク結果を用いて、どのモデルからテストを始めるべきかを決める。
|
| 要求の厳しい推論 | GPT-6.1 Terra | 代表的な難問での精度と是正作業 |
| コーディングエージェント | 両方をテスト | 受理パッチ、回帰チェック、ツール失敗、総コスト |
| 複雑なビジュアルワークフロー | GPT-6.1 Terra | 完了ワークフロー数、インターフェイスエラーからの復旧 |
| 大量のテキストまたは画像抽出 | DeepSeek Flash-1017 | 抽出精度が必要閾値を満たすか |
| 長文書検索 | 両方をテスト | 入力位置全体での証拠検索と回答精度 |
| セルフホスティング | DeepSeek Flash-1017 | 利用可能なハードウェア、運用コスト、ウェイトへのコントロール |
| インタラクティブアプリケーション | 両方をテスト | 選択ルートでの中央値とテールレイテンシ |
When to Choose GPT-6.1 Terra
タスクの中心が複雑な推論である場合は Terra を優先的に評価。要求の厳しいビジュアルやコンピュータ利用ワークフローでも、テストセットに含め、完了タスク数、エラー、復旧を測定。
重要なのは、Terra が失敗試行と手動是正を十分に減らし、より高いトークン価格を正当化できるかどうか。
When to Choose DeepSeek-V4.1-Flash
受け入れ基準が明確でコスト目標が厳しい、繰り返しの大量タスクでは DeepSeek-V4.1-Flash から始める。必要品質を満たしつつ成功タスクあたりのコストが低ければ選択。
DeepSeek の MIT ライセンスウェイトは、セルフホスティングが要件の場合の関連オプション。ハードウェアと運用コストも含めて判断。
When to Test Both Models
コーディング品質、ツール信頼性、レイテンシ、長文書の精度が重要な場合は両方をテスト。同一入力、ツール、実行制限、受け入れ基準で代表タスクを使う。
成功完了率、成功タスクあたりの総コスト、エンドツーエンドのレイテンシ、人手是正時間を比較。モデルバージョンと推論設定を記録し、結果を再現可能にする。
ハイブリッド構成では、DeepSeek で定型タスクを開始し、選別した失敗を Terra にエスカレーションできる。追加モデル呼び出しの価値を確認するため、ワークフロー全体のコストと完了率を測定。
Where Can You Access GPT-6.1 Terra and DeepSeek V4.1 Flash?
Terra には OpenAI のホスト型 API、Flash には DeepSeek のホスト型 API を使用。統合前に現在のモデル識別子、アカウント制限、サポートされるエンドポイントを確認。Flash-1017 のダウンロード可能ウェイトは、セルフホスティングの別選択肢。
CometAPI は OpenAI 互換インターフェースを提供し、マルチモデルアプリ開発を簡素化できる。
Compare Text Responses Through CometAPI
同一のテキストクライアントで両モデルを試すには、OpenAI Python SDK を CometAPI キーと https://api.cometapi.com/v1 エンドポイントで使用。キーは環境変数に保持し、同一プロンプトを gpt-6.1-terra と deepseek-v4.1-flash のルートに送って、戻り応答とトークン使用量を比較。
例として、各モデルに、アイデンポテンシーキーなしでタイムアウトしたリクエストをリトライし、リクエストボディ全体をログ出力する決済ワークフローのレビューを依頼。信頼性とプライバシーのリスクをどれだけ明確に特定し、実践的な修正を説明できるかを比較。共有プロンプトは応答の検査を容易にするが、デフォルトのテキストリクエストは推論予算を均等化せず、性能ランキングを確立しない。各ルートで提供されるチェックポイントを確認し、Flash-1017 に関する証拠として扱う前に確かめる。
Conclusion
GPT-6.1 Terra は現時点でより強力な総合推論結果を示し、DeepSeek Flash-1017 は低いトークン価格、より速い測定出力生成、オープンウェイトデプロイを組み合わせる。役に立つ選択は、最も低い総コストで品質とレイテンシ要件を満たすモデル。
代表的なワークロードから始め、ツール環境と受け入れ基準を固定し、成功完了のコストを比較。共有の CometAPI テキスト統合は評価を容易にできるが、モデル固有の機能には個別設定が必要。
FAQ
なぜ同じタスクでも Terra と Flash-1017 でトークン課金が異なるのか?
テキストプロンプトは、モデル間で同じトークン数になるとは限らない。生成される回答や推論の長さも異なる可能性がある。同一タスクで各ルートが報告する使用量(キャッシュや課金される推論トークンを含む)を比較し、推定トークン数に両方の価格表を適用しないこと。
GPT-6.1 Terra と DeepSeek V4.1 Flash はプロンプトキャッシュを共有できるか?
アプリケーション内でプロンプトテキストを再利用することはできるが、一方のモデルやプロバイダーで作成されたキャッシュが他方の課金を減らすと仮定しない。キャッシュの適用条件と計上はルート固有。各レスポンスの使用量フィールドを確認し、繰り返しリクエストをテストしてから、節約を予測に織り込む。
Terra と Flash-1017 の構造化出力はどう検証すべきか?
モデル選択前に、アプリケーション内で必要なフィールドと型を定義。ルートが JSON やスキーマ制約出力を提供する場合は、正確にサポートされるモードを確認し、レスポンスをパースしてスキーマに対して検証。欠落フィールド、無効値、出力の切り詰め、拒否を別の結果として扱う。正しい JSON であること自体は、抽出された事実が正確であることの証明にはならない。