Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Gemma 3 270Mをローカルで実行するには?開発者のための3つのベストな方法 technology / CometAPIリサーチ
Gemma 3 270Mをローカルで実行するには?開発者のための3つのベストな方法 Googleは最近、新しいGemma 3 270Mモデルを発表しました。コンパクトで効率的なモデルをいじくり回したり、ノートパソコン、携帯電話、または小型の
Googleは最近、新しいGemma 3 270Mモデルを発表しました。コンパクトで効率的なモデルをいじくり回したり、ノートパソコン、携帯電話、または小型の
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

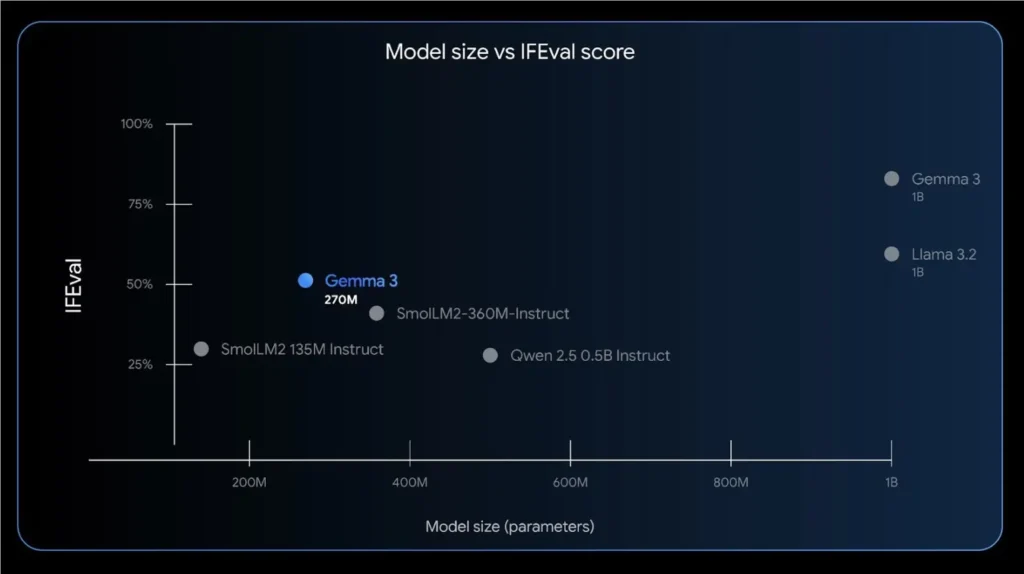
print(response.choices[0].message.content)Googleは最近、新しいGemma 3 270Mモデルを発表しました。コンパクトで効率的なモデルをいじくり回したり、ノートパソコンやスマートフォン、小規模サーバーで実行したりするのがお好きな方には、Gemma 3 270Mは嬉しい新しい友人となるでしょう。この270億1万パラメータのモデルは、極めて高い効率性とタスク固有の微調整が行えるように設計されているのです。意図的に小型で、電力消費が少なく、多くの命令追跡タスクや分類タスクに対して驚くほど優れた能力を備えています。また、エコシステムはすでに、ローカルで実行するための簡単な方法を複数提供しています。(2) Hugging Face / Transformers (PyTorch)、(3) Ollama / LM Studioなどのコンテナ化されたランタイム、(XNUMX) CPUとスマートフォン用の超軽量GGUF / llama.cppスタイルのランナーです。以下では、アーキテクチャのハイライトについて説明し、次に、スタックと格闘して時間を無駄にしないための、実用的でコピー&ペースト可能なXNUMXつの方法(コマンドとコードを含む)、例、長所と短所、そしてとっておきのヒントを紹介します。
Gemma 3 270M とは何ですか? なぜ気にする必要があるのですか?
Gemma 3 270Mは、コンパクトなベースモデルとして設計されたGemma-3ファミリーの中で最小のリリースモデルです。少ないパラメータ数(≈270M)と最新のアーキテクチャ、豊富な語彙、そして命令チューニングされた動作を両立させており、高機能な言語タスクをシングルGPU、あるいは量子化処理を施せばより高性能なCPU/エッジデバイスでも実行できます。このモデルはGoogleによってGemma-3ファミリーとして提供され、モデルハブおよびGGUF/ggmlコレクションを通じてローカル利用向けにオープンに配布されています。
なぜ気にするのでしょうか?270Mモデルでは次のことが可能です。
開発中に迅速に反復する(起動が速く、メモリが少ない)、
プライバシーや遅延の理由からオフラインで実行する
明確性、出典の帰属、最新のAPI用語について確認済みです。
特殊なタスク向けに安価に微調整(LoRA / アダプタ)
制約のあるインフラストラクチャ (デバイス上または単一 GPU サービス) に展開します。
Gemma 3 はどのように設計されていますか? Gemma 3はGemma/Gemini研究の系譜を受け継ぐ、トランスフォーマーベースの因果言語モデルファミリーであり、効率性とマルチモーダル性を重視して調整・設計されたバリアントを備えています。270Mモデルはテキスト中心の構成(Gemma 3の最小サイズはテキストのみ)で、1B~27Bバリアントにスケールアップした際に採用されたファミリー設計を維持しながら、すぐに使えるように学習・最適化されています。このモデルは非常に長いコンテキストをサポートします(注:Gemma 3の最小モデルは32kトークンのコンテキスト制限がドキュメント化されています)。
どのような拡張機能とランタイム エコシステムが存在しますか? Google とコミュニティは、Gemma 3 を簡単に実行できるように、複数のランタイムおよびディストリビューション アーティファクトをリリースしました。
gemma.cpp — 移植性を重視して最適化された、軽量な公式ピュアC++推論ランタイムです。実験や、小型でスタンドアロンなランタイムが重要なプラットフォームを対象としています。ハグフェイスモデルカード および GGUF/llama.cpp アーティファクト - このモデルはHugging Faceで入手可能で、コミュニティコレクションではGGUFビルド、LoRAアダプター、量子化されたバリアントが提供されています。 llama.cpp および同様のランタイム。Ollama / LM Studio / Docker / トランスフォーマー 統合 — 商用およびオープンソースのツールでは、メモリ使用量を削減するための QAT (量子化を考慮したトレーニング) バリアントを含む、Gemma 3 バリアントのネイティブ サポートまたはインストーラーが追加されました。
なぜこの方法を選択するのですか? これは、標準のPyTorchツール、Accelerate、Hugging Face Trainer、またはカスタムループを使用して開発、実験、微調整を行うための最も柔軟な方法です。GemmaをPythonアプリに統合したり、微調整したり、GPUアクセラレーションを利用したりしたい場合に最適です。
あなたが必要なもの
Python、pip、およびオプションで CUDA GPU を搭載したマシン (ただし、小規模なテストの場合は CPU でも動作します)。
HF モデルの承認済みライセンス (ダウンロードする前に、Hugging Face に関する Google の規約に同意する必要があります)。
クイックインストール python -m venv venv && source venv/bin/activate
pip install --upgrade pip
pip install torch torchvision --extra-index-url https://download.pytorch.org/whl/cu118 # or cpu-only
pip install transformers accelerate
from transformers import AutoTokenizer, AutoModelForCausalLM, pipeline
import torch

model_id = "google/gemma-3-270m"  # ensure you've accepted HF license

tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype=torch.float16, device_map="auto")

nlp = pipeline("text-generation", model=model, tokenizer=tokenizer)
print(nlp("Explain Newton's second law in one sentence.", max_new_tokens=64))
出力例(期待される結果) 分類、要約、小規模なチャットフローに適した、指示に従った短い回答です。より高度な推論タスクにはより大きなサイズを検討してください。ただし、270MBは多くのユースケースにおいて優れたエネルギー効率を提供します。
利点とヒント
HF エコシステム (データセット、トレーナー、TRL) との完全な互換性。
device_map="auto" および torch_dtype=torch.float16 GPU メモリを効率的に使用します。小さなローカル マシンの場合は、CPU にオフロードするか、混合精度を使用します。ただし、速度が必要な場合は、適度な GPU が非常に役立ちます。
Ollama または LM Studio (ゼロ構成実行可能) 経由で Gemma 3 270M を実行するにはどうすればよいですか?
Ollama/LM Studio とは何ですか? また、なぜ使用するのですか? OllamaとLM Studioは、モデルのアプリストアのような役割を果たすローカルコンテナ化されたランタイムです。 pull モデルと run たった一つのコマンドで実行できます。パッケージ化/量子化ファイル、メモリ消費量を処理し、便利なCLI/UIを提供します。これはゼロからローカルチャットへの最速ルートです。OllamaはモデルライブラリにGemma 3 270Mを明示的にリストしています。
オラマのクイックステップ # Pull (downloads the model)
ollama pull gemma3:270m
# Start an interactive session (CLI)
ollama run gemma3:270m
使用例(スクリプト) # Run a single prompt and exit
ollama run gemma3:270m --prompt "Summarize the latest Python 3.12 features in one paragraph."
LM Studio (デスクトップ) をインストールします。
アプリ内のモデルハブで「gemma-3-270m」を検索してください。
量子化されたバリアント (Q4_0 または類似のもの) を選択してダウンロードします。
「ロード」をクリックしてチャットを開始します。
利点とヒント
非常に低い摩擦: 手動変換は不要、UI でモデルを検出、デモが簡単。
Ollama はモデルの保存/更新を処理します。no-ops ローカル環境が必要な場合に使用します。
本番環境のコードに統合する必要がある場合、Ollama はローカル エンドポイントを提供するための API を提供します。
小型デバイスで GGUF / llama.cpp を使用して Gemma 3 270M を実行するにはどうすればよいですか?
この道が存在する理由 最小のメモリフットプリント(電話、Raspberry Pi、小型VPS)を目標としている場合、または超高速コールドスタート、GGUF(最新のggml形式)へのコミュニティ変換、および推論が必要な場合は、 llama.cpp/ggml ツールは最適な選択肢です。すでに、量子化が極めて高く、RAM消費量が少ないスマートフォン(Q3/Q270系)でGemma 4 8Mが動作しています。
GGUFの入手方法(変換・ダウンロード)
多くのコミュニティフォークが google/gemma-3-270m GGUFに寄付し、Hugging Face(検索 gemma-3-270m-GGUF)。リポジトリの例としては、 NikolayKozloff/gemma-3-270m-Q8_0-GGUF および ggml-org コレクション。
一緒に走る llama.cpp (CLI) # clone and build llama.cpp
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
make
# then, download or place gemma-3-270m.gguf in the folder
./main -m gemma-3-270m-q8_0.gguf -p "Write a haiku about debugging." --ctx_size 2048
# start a local server (conversation mode)

./llama-server --hf-repo NikolayKozloff/gemma-3-270m-Q8_0-GGUF --hf-file gemma-3-270m-q8_0.gguf -c 2048
例: Android で実行 (コミュニティ ワークフロー)
あらかじめ構築されたGGUFとモバイルフロントエンド(一部のコミュニティアプリとビルドはラップ)を使用します llama.cpp Android向け)。非常に低い量子化(INT4 / Q4_0)では、忠実度と速度をトレードオフすることを想定しておいてください。コミュニティドキュメントページには、スマートフォンでの実行例が記載されています。
利点とヒント
小さなメモリフットプリント : 量子化された GGUF を使用すると、数百 MB でモデルを実行できます。CPUの速度 : llama.cpp CPU 推論に非常に最適化されています。ヒント: 異なる量子レベル(Q4_0、Q5/K)を試してプロンプトの品質をテストしてください。低いビットは高速ですが、品質が低下する可能性があります。 --ctx_size 長いコンテキストが必要な場合に、モデルの意図したコンテキストと一致させます。
どちらの方法を使用するかをどのように選択すればよいですか?
Python / GPUでプロトタイプや微調整をしたい → ハギングフェイス + トランスフォーマー。(トレーニング/微調整に最適です。)最小限のセットアップで、ローカルでの会話デモを素早く行いたい → Ollama / LM Studio。(デモや開発者以外の関係者に最適です。)携帯電話や小さなサーバーでオフラインで実行したい → GGUF + llama.cpp。(エッジ効率を極限まで高めるのに最適です。)
Gemma 3 270M をローカルで実行することの利点と実用的なヒントは何ですか?
リソースと量子化のヒント
メモリフットプリント: 16Mモデルのフル精度270ビットフットプリントは非常に小さい(モデルパラメータで数百MB程度)ですが、ROキャッシュとKVキャッシュによりピーク時のメモリ使用量が増加します。コミュニティの報告によると、フル精度は約0.5GB、INT4量子化バリアントは約100~200MBまで削減できるとされています。これはエッジコンピューティングや低RAM環境にとって大きなメリットです。ランタイム、トークナイザー、システムオーバーヘッドによって使用される追加メモリを常に考慮してください。可能な場合は QAT/INT4 を使用します。 Googleとコミュニティプロバイダーは、量子化を考慮した学習済み(QAT)ビルドとINT4/INT8 GGUFを提供しています。これらはRAMを削減し、多くのタスクで驚くほど良好な品質を維持します。
パフォーマンスとコンテキスト設定
コンテキスト ウィンドウ: Gemma 3ファミリーは非常に長いコンテキストをサポートしており、270M/1Bバリアントは最大32kトークンまでサポートされています。 --context or -c それらを公開するランタイム内のフラグ。スレッドとバッチ処理: CPU推論では、スレッド数を増やし、レイテンシが許容できる場合はバッチ処理を使用します。GPUでは、メモリの断片化を軽減するために、FP16とデバイスマッピングを優先します。
安全性、ライセンス、責任ある使用
Gemma 3は、モデルアーティファクトと使用ガイドラインとともにリリースされています。Responsible Generative AI Toolkitおよび重みに付随するライセンス条件(特に商用利用または配布の場合)を遵守してください。一般向けサービスを展開する場合は、モデレーションレイヤー(ShieldGemmaなど)とコンテンツフィルターを適用してください。
どのような一般的な問題が見られますか? また、それらをどのようにトラブルシューティングできますか?
モデルファイル/フォーマットエラー
ランタイムが不明なモデルアーキテクチャに関するエラーを報告した場合、フォーマットの不一致が発生している可能性があります(例:Transformersのチェックポイントを想定するランタイムでGGUFを読み込もうとした場合)。公式の変換スクリプトを使用してモデル成果物を変換するか、ランタイム推奨の成果物(Hugging Face → Transformers、GGUF → llama.cpp)を使用してください。コミュニティガイドやコレクションには、時間を節約するために、変換済みのGGUFがホストされていることがよくあります。
メモリ不足
量子化ビルド (INT4/INT8) を使用し、バッチ サイズを縮小し、GPU VRAM が不足している場合は CPU に切り替えるか、device_map/accelerate を使用してモデルの一部をオフロードします。
量子化による予期せぬ品質低下
単純な学習後量子化ではなく、高精度量子化(INT8)またはQATアーティファクトを試してください。量子化モデルをいくつかのドメイン例で微調整することで、タスク依存のパフォーマンスを回復できる可能性があります。
最終的な考え Gemma 3 270Mは、ローカル環境での実験、微調整、そしてデプロイメントに最適な「小型ながらも最新」のモデルです。Pythonの完全な制御とトレーニングが必要な場合はHugging Face + Transformersを、最も軽量な推論が必要な場合はGGUF + ggmlソリューションを、迅速なデモや技術に詳しくない関係者向けにはGUI/パッケージングレイヤー(LM Studio / Ollama)をお選びください。微調整には、LoRA/PEFTレシピを活用することでコストを大幅に削減し、270Mモデルを実際のタスクに適応させやすくします。出力は常に検証し、ライセンス/安全性に関するガイダンスに従い、メモリと品質のバランスが取れた量子化レベルを選択してください。
スタートガイド CometAPIは、OpenAIのGPTシリーズ、GoogleのGemini、AnthropicのClaude、Midjourney、Sunoなど、主要プロバイダーの500以上のAIモデルを、開発者にとって使いやすい単一のインターフェースに統合する統合APIプラットフォームです。一貫した認証、リクエストフォーマット、レスポンス処理を提供することで、CometAPIはAI機能をアプリケーションに統合することを劇的に簡素化します。チャットボット、画像ジェネレーター、音楽作曲ツール、データドリブン分析パイプラインなど、どのようなアプリケーションを構築する場合でも、CometAPIを利用することで、反復処理を高速化し、コストを抑え、ベンダーに依存しない環境を実現できます。同時に、AIエコシステム全体の最新のブレークスルーを活用できます。
最新の統合Gemma 3 270MはまもなくCometAPIに登場しますので、お楽しみに!Gemma 3 270Mモデルのアップロードが完了するまで、他のGeminiモデル(gemma 2など)をご覧ください。ジェミニ 2.5 フラッシュ , ジェミニ 2.5 プロ )をモデルページで確認するか、AIプレイグラウンドで試してみてください。まずは、 プレイグラウンド そして相談する APIガイド 詳細な手順についてはこちらをご覧ください。アクセスする前に、CometAPIにログインし、APIキーを取得していることを確認してください。 コメットAPI 統合を支援するために、公式価格よりもはるかに低い価格を提供します。