SolutionsChoose your path
For individualsBuild, learn, and create with simple usage-based access. For businessScale teams, billing, governance, and model workflows. ai-model/CometAPIリサーチ
MiniMax M3.1 Flash をローカルで実行する方法:GPU、vLLM & SGLang ガイド
MiniMax M3.1 Flash をローカルで実行する方法を学ぶ。428B/23B の MoE アーキテクチャ、GPU 要件、vLLM および SGLang のセットアップ、ベンチマーク、API の代替手段を探る。

Deon GoodwinAIモデルとAPIの調査チーム from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-5-mini",
messages=[{"role": "user", "content": "Build this workflow."}],
)
print(response.choices[0].message.content)
TL;DR
MiniMax M3.1 Flash は、オープンウェイトの AI を高度なコーディングやエージェントのワークフローに提供しますが、ローカルでの実行には強力なハードウェアが必要です。4280億パラメータの MoE アーキテクチャはトークンあたり約230億パラメータのみをアクティブ化し、計算量を削減しますが、モデル全体の保存が不要になるわけではありません。対応するマルチ GPU システムを持つ開発者は vLLM や SGLang でデプロイできます。インフラ管理を避けたい場合は、CometAPI の MiniMax M3.1 Flash API を使うと簡単に始められます。
Key Takeaways
- ハードウェアが最大の障壁です。 公開されている vLLM の構成では、対応する Blackwell または AMD MI355X の 4 GPU、もしくは H100/H200 の 8 GPU を使用します。
- モデルは最大 100 万トークンに対応しますが、実際の提供上限は利用可能な GPU メモリと並行性に依存します。
明確性、出典の帰属、最新のAPI用語について確認済みです。
長いコンテキストにはメモリコストが伴います。
デプロイはハードウェア固有です。 一般的なインストールコマンドではなく、互換性のある推論エンジン、量子化形式、アクセラレータ構成を使用してください。ベンチマークは出発点に過ぎません。 コーディング精度、エージェントのタスク完了、レイテンシ、スループットを自分のワークロードで評価してください。ローカルとホスト型の推論は異なるニーズに応えます。 自己ホスティングはインフラ制御を高めますが、API アクセスはセットアップの複雑さと保守の負担を軽減します。What Is MiniMax M3.1 Flash?
MiniMax M3.1 Flash はテキスト・画像・動画を受け取り、テキストを生成します。コーディング、オートメーション、コンピュータ操作、セキュリティのワークフロー向けに設計されています。ウェイトは MiniMax Community License で配布されています。商用サービスを提供する前に、チェックポイントに付属するライセンスを読み、利用条件を確認してください。
MiniMax M3.1 Flash specifications
|
| Developer | MiniMax |
| Model family | ネイティブ多モーダル MoE |
| Total parameters | 約 428B |
| Active parameters | トークンあたり約 23B |
| Maximum context | 1,048,576 トークン(モデルの能力) |
| Input types | テキスト、画像、動画(ルート依存) |
| Output | テキスト |
| Attention | 各層に MiniMax Sparse Attention |
| Quantization | MXFP8 の密層 / NVFP4 のエキスパート |
| Draft decoding | DSpark 統合ドラフトヘッド |
| Reasoning effort | low、medium、high、xhigh、max |
| Reported output speed | 好条件で 200+ トークン/秒;P50 で 170+ トークン/秒 |
| License | MiniMax Community License |
| Documented inference | vLLM、SGLang |
| Typical topology | 対応 Blackwell または MI355X の 4 GPU;H100/H200 の 8 GPU |
How does MiniMax M3.1 Flash use its 428B/23B architecture?
Mixture-of-Experts(MoE)モデルは、各トークンを選択されたエキスパートへルーティングします。MiniMax M3.1 Flash ではトークンあたり約 23B のパラメータがアクティブになり、全体のパラメータプールは約 428B です。スパースなアクティベーションは計算量を削減しますが、チェックポイントを密な 23B モデルに変えるものではありません。
What Changed in MiniMax M3.1 Flash?
- スパースアテンション: 長い入力でのアテンション処理を削減するためモデル全体に適用されています。効果はサービングカーネルとプロンプトに依存します。
- 混合精度ウェイト: MXFP8 の密なコンポーネントと NVFP4 のエキスパートにより保存と計算の負担を軽減しますが、依然として対応ハードウェアとカーネルが必要です。
- DSpark デコード: 統合されたドラフトヘッドにより、対応レシピで生成を高速化できます。結果はトークン受理率とワークロードに依存します。
- 電力認識型サービング: インフラレベルのスケジューリングで利用率を改善できますが、ウェイトをダウンロードしただけでは自動的に得られる機能ではありません。
What Hardware Is Needed for MiniMax M3.1 Flash?
GPU メモリは「チェックポイントのウェイト」「既出トークンの KV キャッシュ」「ランタイムバッファ」「ワークロードの余裕」の 4 つに分けて見積もってください。以下の試算は生のパラメータ保存のみを対象としています。混合精度、量子化スケール、多モーダルコンポーネント、サービングのオーバーヘッドにより実際の要件は変わります。
Validated GPU topologies
|
| NVIDIA GB200/GB300/B200/B300 | 4 GPU、テンソル並列 | Blackwell の NVFP4 ネイティブパス |
| NVIDIA H100/H200 | 8 GPU、テンソル並列 | FP8 キャッシュと Marlin MoE パス |
| AMD MI355X | 4 GPU、テンソル並列 | 対応 ROCm と AITER 設定が必要 |
| 24–32 GB コンシューマ GPU | 参照レシピなし | 単一 GPU の単純ロードには不十分 |
| CPU のみワークステーション | 実用的なデプロイの検証なし | オフロードの実験は本番ガイダンスではない |
メモリ試算: 428B のパラメータを BF16 で生保存すると約 856 GB、8-bit で約 428 GB、理想化された 4-bit で約 214 GB です。公式チェックポイントは形式が混在しているため、これらは実行時の VRAM 要件ではありません。量子化スケール、KV キャッシュ、ランタイムバッファ、並行性を考慮し、実際の チェックポイントファイルと使用 GPU のレシピでシステムを見積もってください。
チェックポイント、一時ダウンロード、ロールバック用コピーのために NVMe 領域を確保してください。
Which Deployment Method Should You Choose?
対応ローカルクラスタがある場合、vLLM は参照構成と親しみやすい API 統合を備えた現実的な出発点です。SGLang は互換性を確認したうえでサービングのカスタマイズを探るチームに適しており、CometAPI はインフラ管理を省略したい場合にモデル切り替えも容易なホスト型ルートを提供します。
|
| Weights and GPUs | ウェイトをダウンロードし、対応 GPU を運用 | ウェイトをダウンロードし、対応 GPU を運用 | プロバイダ管理の推論;ローカルウェイト不要 |
| Blackwell / AMD MI355X | ハードウェア固有のレシピ | ハードウェア固有のレシピ | ハードウェアはプロバイダが管理 |
| H100/H200 | 8 GPU の Hopper レシピが文書化 | 現行のサポートマトリクスを確認 | ハードウェアはプロバイダが管理 |
| Decoding and parallelism | 対応パスで DSpark;テンソル/分散サービング | ハードウェア固有のデコード;テンソル/エキスパート並列 | ルートで公開されているオプションに限定 |
| Control and data processing | 自環境;スケーリングは自分で管理 | 自環境;スケーリングは自分で管理 | 外部プロバイダ;スケーリングはプロバイダ管理 |
まず自分のハードウェアで検証済みのレシピがあるフレームワークを選び、同一のプロンプト、精度、並行性でレイテンシとスループットを比較してください。
How to Run MiniMax M3.1 Flash Locally With vLLM?
以下の手順は、4 枚の互換性のある NVIDIA Blackwell GPU、対応ドライバ/CUDA 環境、公式チェックポイントへのアクセスを備えた Linux ホストを前提としています。検証済みの vLLM ビルドを使用してください。非対応 GPU ハードウェアで通常インストールしても、パッケージのインストール自体は成功して起動時に失敗する場合があります。
python3 -m venv minimax-env
source minimax-env/bin/activate
python -m pip install --upgrade pip
python -m pip install -U huggingface_hub
python -m pip install "vllm>=0.33.0"
python -c "import vllm; print(vllm.__version__)"
インストールしたホイールと CUDA ランタイムが GPU ファミリに一致していることを確認してください。プロジェクト固有の開発ビルドが必要な場合は、起動引数を使う前に参照インストールノートに従ってください。
Step 2: Download the official checkpoint
hf download MiniMaxAI/MiniMax-M3.1-Flash \
  --local-dir ./MiniMax-M3.1-Flash
必要に応じて適切な Hugging Face アクセストークンを使用し、ディレクトリ構造を維持し、サーバー起動前にシャードの完全ダウンロードを検証してください。
Step 3: Launch on four NVIDIA GB200 GPUs
export CUDA_VISIBLE_DEVICES=0,1,2,3
export VLLM_FLOAT32_MATMUL_PRECISION=high

vllm serve ./MiniMax-M3.1-Flash \
  --tensor-parallel-size 4 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype nvfp4 \
  --attention-config '{"indexer_kv_dtype":"nvfp4","use_prefill_query_quantization":true}' \
  --compilation-config '{"cudagraph_mode":"FULL_AND_PIECEWISE"}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"attention_backend":"FLASHINFER_TS","kv_cache_dtype":"fp8","draft_sample_method":"probabilistic","rejection_sample_method":"block"}' \
  --max-model-len 32768 \
  --max-num-seqs 4 \
  --disable-hybrid-kv-cache-manager \
  --host 127.0.0.1 \
  --port 8000
サーバーのロード完了と準備完了の出力が出るまで待ってからリクエストを送信してください。上記のコマンドは初回のスモークテストとしてコンテキストを 32,768 トークン、同時シーケンスを 4 に制限しています。これらの縮小設定はベンチマーク済みの値ではありません。ハードウェア上でメモリ使用量とリクエスト挙動を測定したうえで調整してください。
Step 4: Send a local request
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "./MiniMax-M3.1-Flash",
    "messages": [{"role":"user","content":"Explain sparse attention in three bullets."}],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 1024
  }'
提供される識別子がディレクトリ名と異なる場合は /v1/models を呼び、返却された ID を正確に使用してください。正常なテキスト応答は基本的な推論のみを検証します。ビジョン、ツール呼び出し、並行性、長いコンテキストは別途テストしてください。
Step 5: Integrate with an OpenAI-compatible Python client
python -m pip install openai
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
model_id = client.models.list().data[0].id

response = client.chat.completions.create(
    model=model_id,
    messages=[{"role": "user", "content": "Write a Python duplicate filename detector."}],
    temperature=1.0,
    top_p=0.95,
    max_tokens=2048,
)
print(response.choices[0].message.content)
この例はローカルテストとして 127.0.0.1 で待ち受けます。リモートクライアントを接続する前に、エンドポイントの前段にアクセス制御を配置し、クライアントのタイムアウト、制限付きリトライ、監視を構成してください。
H100/H200 variant: use the eight-GPU Hopper recipe
8 枚の H100/H200 では、Blackwell の NVFP4 構成ではなく Hopper 固有の FP8 キャッシュと Marlin MoE パスを使用してください。以下のコマンドは 公式の vLLM Hopper レシピ に従い、初期テストとしてコンテキストと並行性を 32K と 4 シーケンスに縮小しています。該当レシピに合わせて動画入力を無効化しています。このエンドポイントは既存のアクセス制御の背後に配置してください。
vllm serve MiniMaxAI/MiniMax-M3.1-Flash \
  --tensor-parallel-size 8 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype fp8 \
  --attention-config '{"indexer_kv_dtype": "fp8"}' \
  --compilation-config '{"cudagraph_mode": "FULL_AND_PIECEWISE"}' \
  --max-model-len 32768 \
  --max-num-seqs 4 \
  --limit-mm-per-prompt '{"video": 0}' \
  --gpu-memory-utilization 0.9 \
  --no-enable-log-requests \
  --disable-hybrid-kv-cache-manager \
  --moe-backend marlin \
  --enable-auto-tool-choice \
  --tool-call-parser minimax_m3
How to Run MiniMax M3.1 Flash With SGLang?
SGLang はハードウェア固有の M3.1 デプロイレシピと OpenAI 互換のサービングを提供します。10 月 23 日のスナップショットでは、ドキュメントに専用の開発用コンテナイメージが含まれているため、一般的な SGLang インストールにすべてのモデル固有サポートが含まれると仮定すべきではありません。
Pull the dedicated container image
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
次に、使用するアクセラレータに応じて SGLang MiniMax M3.1 クックブック に従ってください。イメージのプルはランタイムのダウンロードに過ぎず、GPU アクセス付きでコンテナを起動し、その中で対応するサービング構成を立ち上げる必要があります。クックブックの完全なハードウェア固有コマンドを使用し、準備完了まで待機してからエンドポイントのモデル一覧を問い合わせ、テストリクエストを送ってください。文書化された NVIDIA と AMD のパスは依存関係が異なるため、別々に構成する必要があります。
How Does MiniMax M3.1 Flash Compare on Benchmarks?
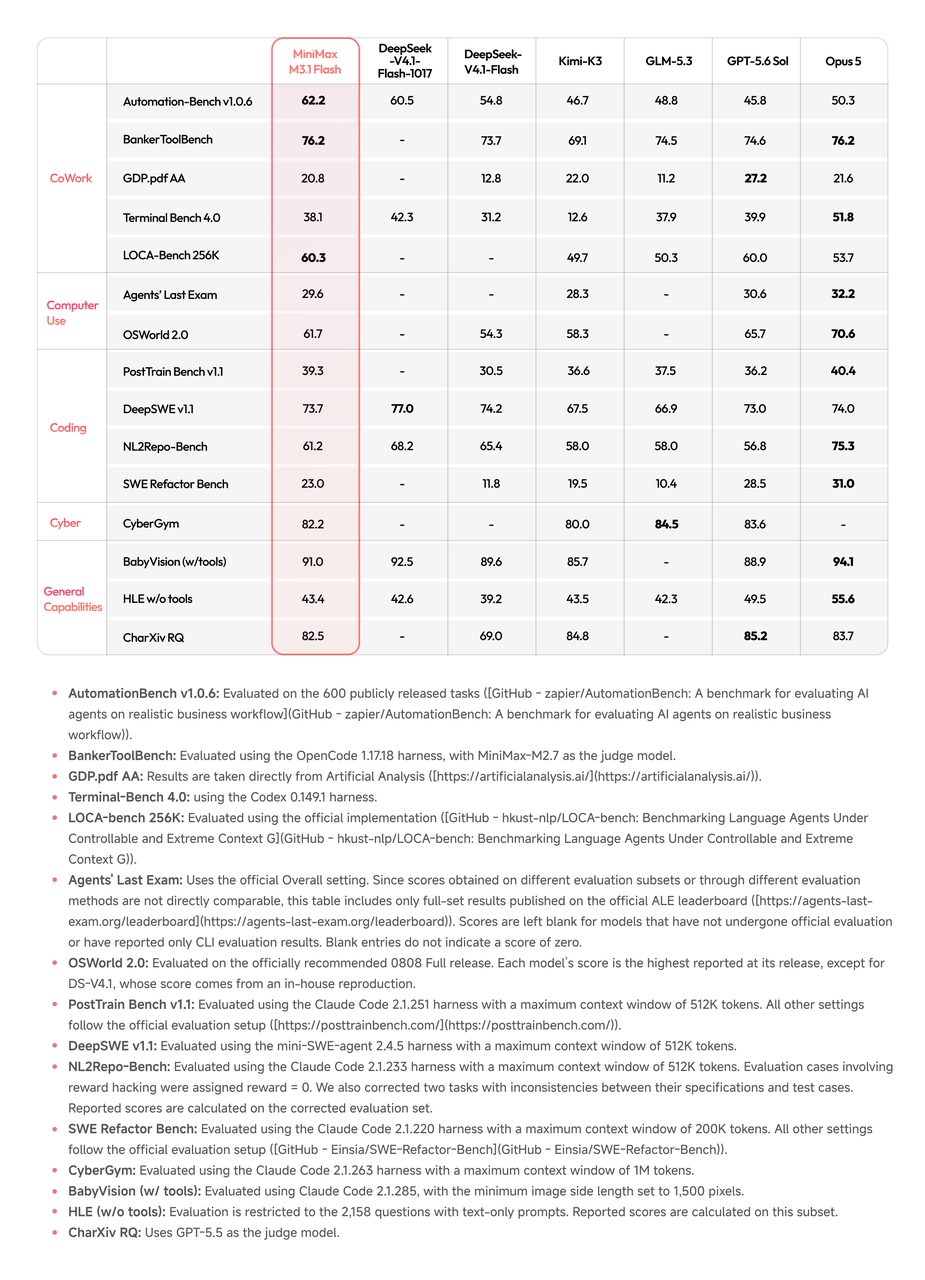
エンドポイントが基本チェックを通過したら、公開ベンチマークを使って次にテストすべきワークロードを決めてください。以下の数値はベンダーが公開した評価であり、あなたのローカルデプロイの測定値ではありません。
|
| Automation-Bench v1.0.6 | 62.8 | 60.5 | 46.7 |
| DeepSWE v1.1 | 73.7 | 77.0 | 67.5 |
| Terminal Bench 4.0 | 38.1 | 42.3 | 12.6 |
| OSWorld 2.0 | 61.7 | N/A | 58.3 |
| NL2Repo-Bench | 61.2 | 68.2 | 58.0 |
| BabyVision with tools | 91.0 | 92.5 | 85.7 |
この比較では、Automation-Bench において MiniMax が掲載モデルの中で優位ですが、DeepSeek は複数のコーディングベンチマークで優位です。結論を出す前にモデルカードと評価設定を読み、あなたのアプリケーションが実際に使うプロンプトとツールでテストしてください。異なるベンチマークのバージョンやセットアップ間でのスコアは直接比較できません。
Control context and concurrency
初回のリクエストが成功したら、入力長、出力長、同時リクエスト数のうち一つだけを段階的に増やしてください。各回でピークメモリと応答レイテンシを記録します。最後に安定した設定をロールバックポイントとして保持し、失敗した実験が新たなベースラインにならないようにします。
Choose reasoning effort deliberately
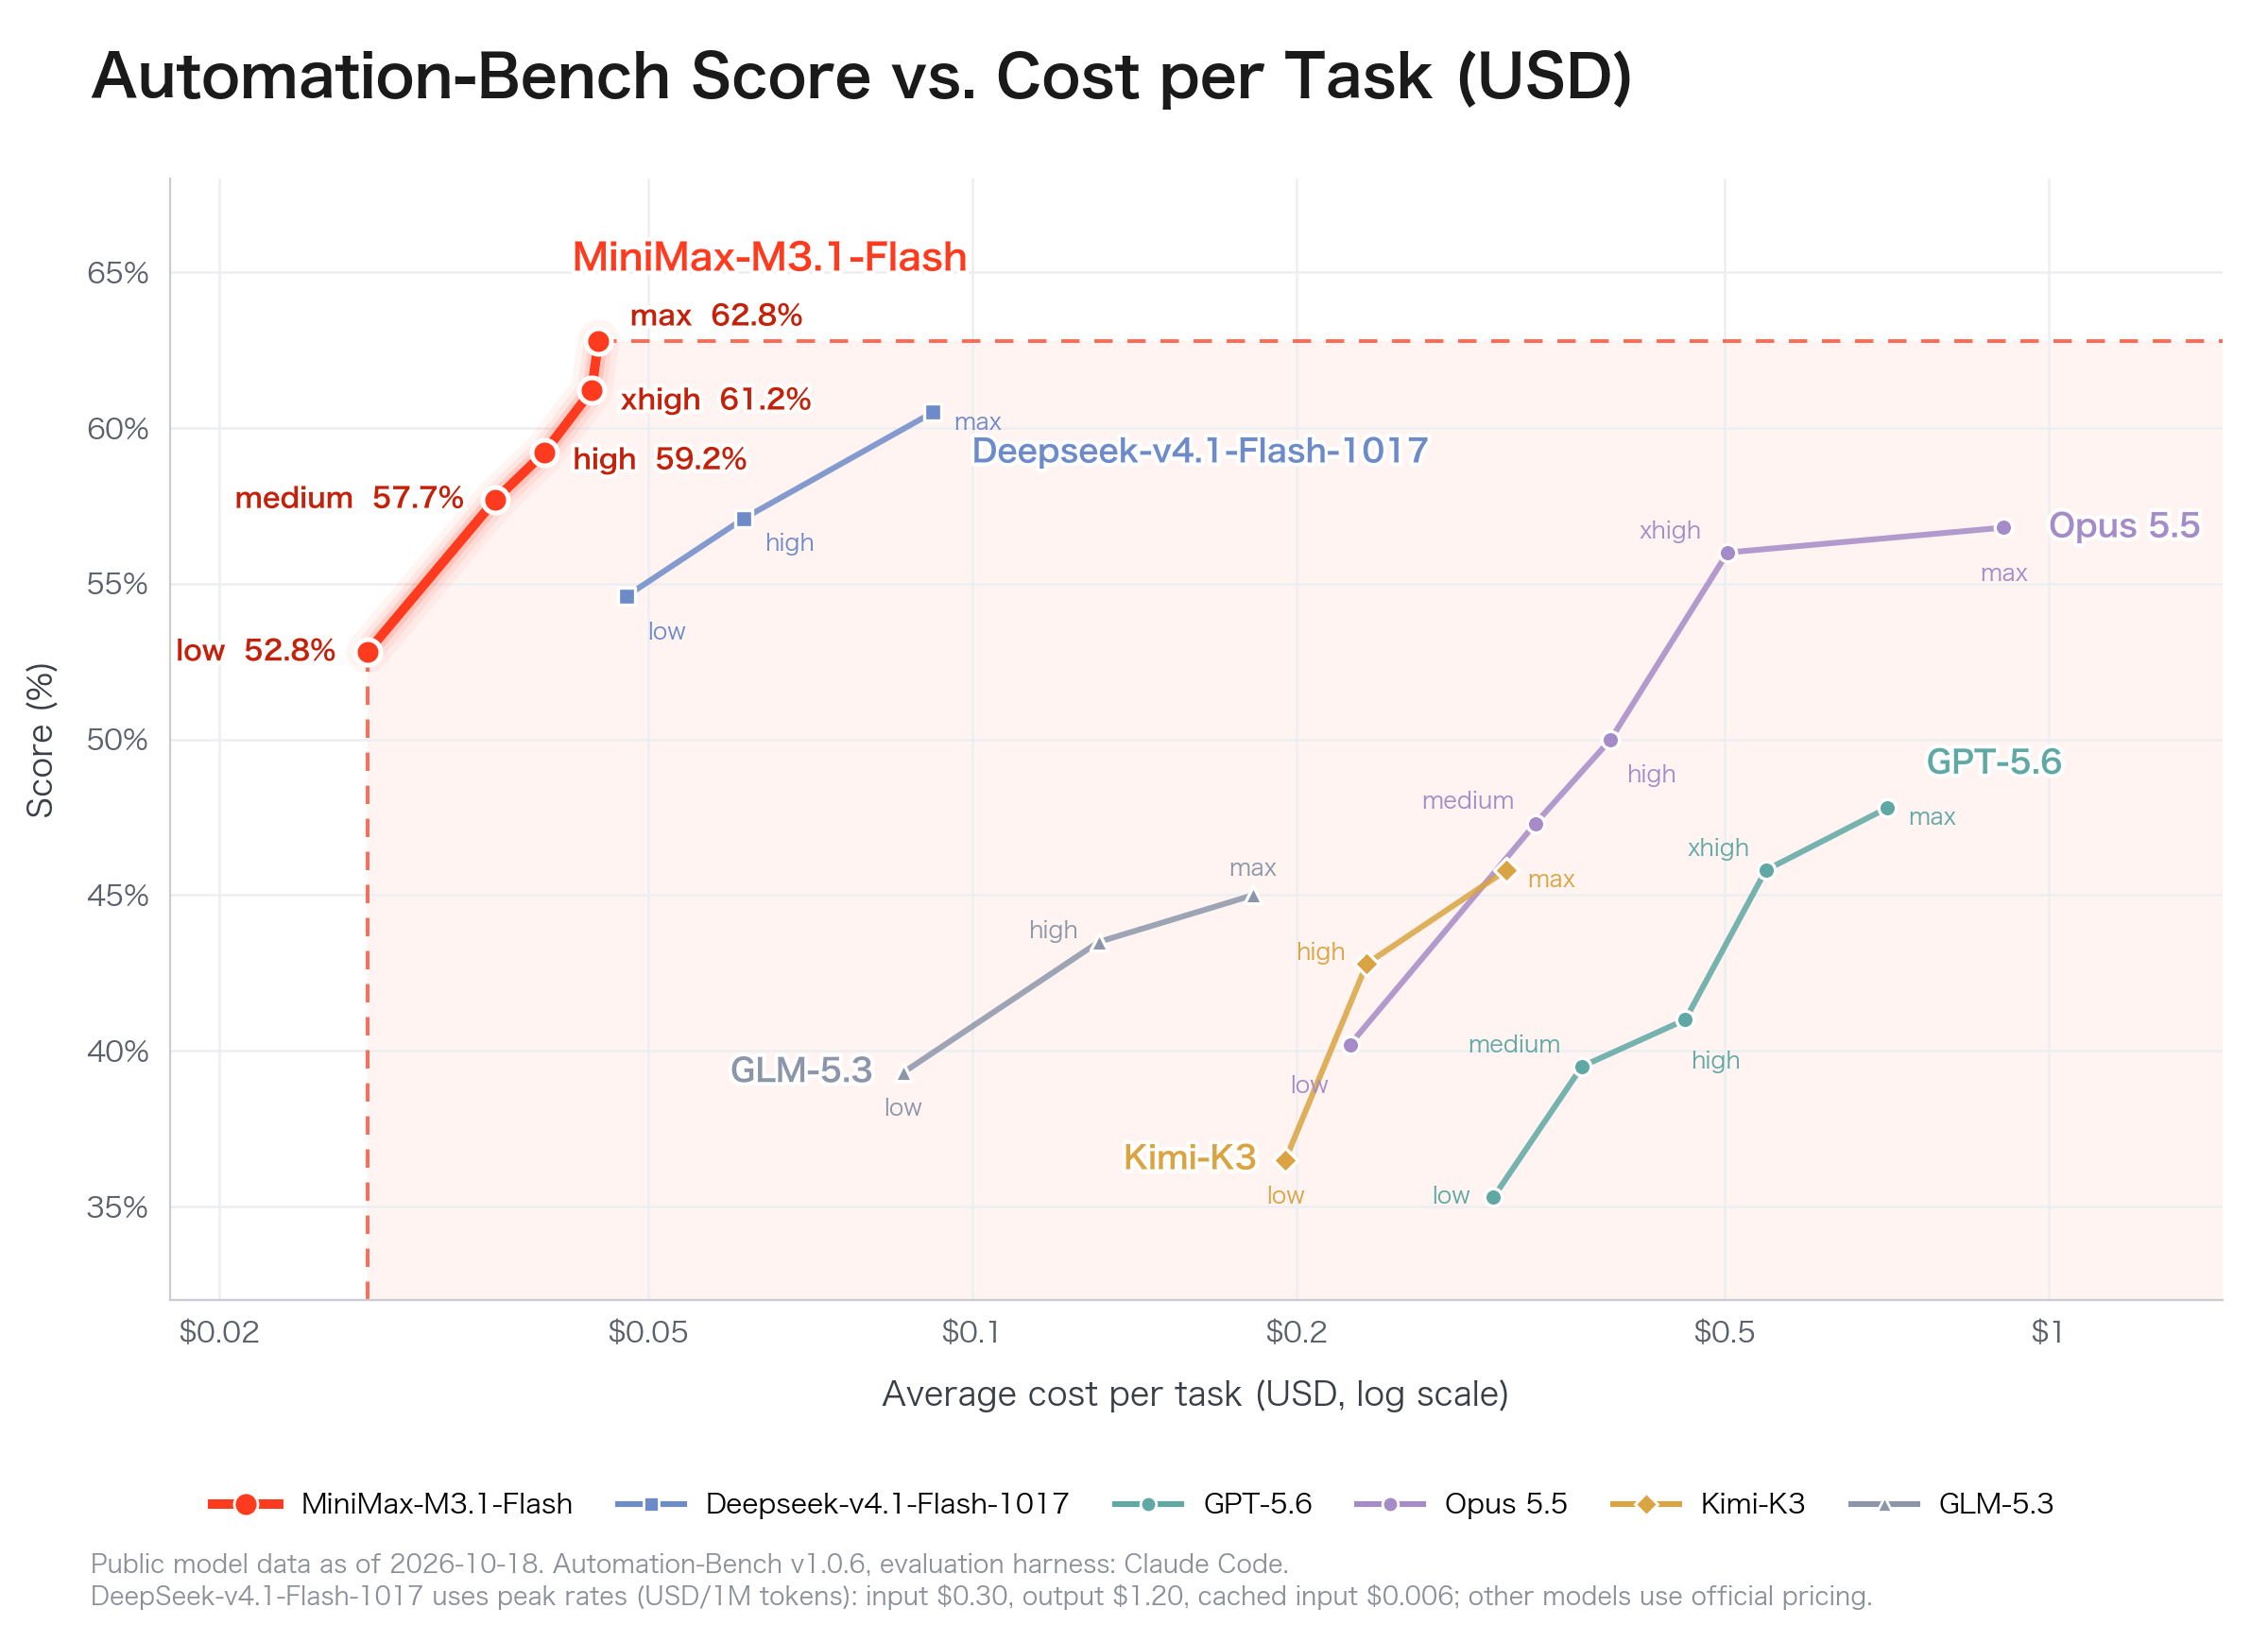
M3.1 Flash は low、medium、high、xhigh、max のエフォートをサポートします。高い設定は難易度の高いタスクのスコアを改善できますが、多くの場合は推論トークンが増え、レイテンシが長くなります。タスク完了の品質と計算コストを併せて評価してください。
|
| Low | 52.8% |
| Medium | 57.7% |
| High | 59.2% |
| Xhigh | 61.2% |
| Max | 62.8% |
ローカル vLLM リクエストでは、レシピに chat_template_kwargs の下でreasoning-effort 設定が示されています。ホスト型とローカルのエンドポイントでは、最終回答と別途返される推論フィールドの扱いが異なる場合があるため、クライアント検証時に両方を確認してください。
Track cost per completed task
エージェントでは、トークン/秒だけでは不十分です。ファーストトークンまでの時間、出力レート、スペキュレーティブデコードの受理率、同時スループット、ツール呼び出しの失敗、メモリ利用率、完了タスクのコストを記録してください。ツールの失敗が少ない遅い応答のほうが、全体の経済性が良い場合があります。
専用アクセラレータのインフラを必要としないチームは、OpenAI 互換のホスト型エンドポイントを利用できます。これによりチェックポイントのダウンロードや GPU の運用は不要になりますが、リクエスト処理は自己ホスト環境の外で行われます。
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
この例を実行する前に、CometAPI コンソールでモデル識別子を確認してください。プロバイダ間で共通 API が役立つ場合にゲートウェイを使用し、想定使用量に対する現在の見積もりを直接アクセスと比較してください。
MiniMax M3.1 Flash API pricing
|
| Input | $0.15 | $0.80 |
| Output | $0.60 | $3.20 |
| Cached input | $0.015 | 現行ルートの見積を確認 |
MiniMax 公式 API の料金(2026 年 10 月 19 日のローンチ告知)は、入力 $0.15、出力 $0.60、キャッシュ入力 $0.015(すべて 100 万トークンあたり)です。CometAPI については、アクティブなモデルルート、入出力レート、キャッシュ規則、アカウント割引を確認してから試算してください。想定するトークンの比率とリトライを踏まえた総コストを比較しましょう。
What Problems Might Occur When Running MiniMax M3.1 Flash?
Out of memory during loading or requests
- ウェイトのロードに失敗する場合: 起動ログの失敗段階を確認し、チェックポイントが完全であること、GPU トポロジーと量子化バックエンドがレシピに一致していることを検証してください。ウェイトが利用可能メモリを超える場合は、十分な容量の構成を使用してください。リクエストを短くしてもウェイトロードの失敗は解決できません。
- ウェイトはロードするが起動時にキャッシュ割り当てが失敗する場合: キャッシュ設定と利用可能メモリを確認し、レシピに応じてコンテキストや並行性を適切に縮小してください。
- サーバーは起動するがリクエストでメモリ不足が発生する場合: 1 件ずつ短いプロンプトで再試行し、入力長、出力長、並行性をそれぞれ個別に増やしながらメモリを監視してください。
Incompatible quantization or attention kernels
NVFP4 の実行は Blackwell、Hopper、AMD ハードウェアで異なります。推論エンジンのバージョン、量子化バックエンド、CUDA/ROCm のバージョン、アクセラレータファミリを一致させ、フラグを無差別に再利用しないでください。
Sparse-attention cache configuration
起動時に未対応のキャッシュレイアウトが報告される場合は、ハードウェア固有のレシピと完全なキャッシュ構成を比較してください。現在の vLLM レシピでは MSA のスパース/インデックスキャッシュに --block-size 128 が必要です。起動時にキャッシュレイアウトやブロックサイズのエラーが報告された場合は、ハードウェア向けレシピの完全構成と照合してください。
Unexpected model identifiers
ローカルパスとリモートゲートウェイのモデル名は必ずしも同一ではありません。ローカルの /v1/models の応答を問い合わせ、別のエンドポイントの仮定をハードコードしないでください。
Poor observed throughput
遅いプロンプト処理と遅いトークン生成を切り分けてください。同じ入力長と出力上限で比較し、バッチサイズを増やす前に GPU の利用率とインターコネクトの挙動を確認してください。プロバイダが公開する速度は、あなたのローカルクラスタのベースラインではありません。
Conclusion
今日運用可能なハードウェアから、最初のデプロイルートを選びましょう。対応ローカルクラスタには vLLM の手順を、別のサービングスタックを試したい場合はハードウェア固有の SGLang クックブックを、アプリ統合に集中したい場合はホスト型 API を使ってください。タスク品質とレイテンシの目標を持続可能な運用コストで満たす構成を維持しましょう。
最も信頼できるサービング方式の選び方は、ピークのトークン/秒だけでなく「正しく完了した作業あたりのコストと時間」を最適化することです。
FAQ
ランタイムをアップグレードした後もデプロイを再現可能にするには?
チェックポイントのリビジョン、ランタイムイメージまたはパッケージのバージョン、ドライバスタック、起動設定を固定(ピン)してください。各アップグレード前に同一の小さな受け入れセットを実行し、ロールバック用に以前の動作構成を保持してください。
エージェントがツールを呼び出す際のリトライはどう扱うべきですか?
モデルのリトライとツールの再実行を分離してください。データを変更するアクションには冪等性キーを使用し、最初の試行が成功したか確認し、実行前にツール引数の完全性を検証してください。
エンドポイント、認証情報、モデル ID を設定可能にしてください。両ルートでストリーミング、ツール呼び出し、推論フィールド、多モーダル入力をテストし、フェイルオーバーを有効化する前にデータルーティング要件を確認してください。
マルチモーダル入力を受け入れる前に何をテストすべきですか?
代表的な画像と動画(低品質や非対応ファイルを含む)をテストしてください。前処理、サイズ上限、回答品質、タイムアウトを別々に確認してください。テキストリクエストの成功は、多モーダルパスの検証にはなりません。
実ユーザーへの公開が可能かどうかはどう判断しますか?
タスク成功率、有効なツール呼び出し、レイテンシ、エラー、コストの目標を設定してください。現実的なトラフィックでテストし、監視とフェイルオーバーの挙動を検証し、それらの目標が維持される範囲でのみ小規模展開から拡大してください。