Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Kimi K3.1 Pro をローカルでデプロイする方法:ハードウェア要件、vLLM のセットアップ guide / CometAPIリサーチ
Kimi K3.1 Pro をローカルでデプロイする方法:ハードウェア要件、vLLM のセットアップ vLLM を使って Kimi K3.1 Pro をセルフホストする方法、GPU要件の確認、モデル重みのダウンロード、推論のテスト、ローカルデプロイとAPIアクセスの比較について学ぶ。
Deon Goodwin AIモデルとAPIの調査チーム vLLM を使って Kimi K3.1 Pro をセルフホストする方法、GPU要件の確認、モデル重みのダウンロード、推論のテスト、ローカルデプロイとAPIアクセスの比較について学ぶ。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)要約
Linux GPU サーバーに Kimi K3.1 Pro をデプロイし、ローカルアプリケーションを推論エンドポイントに接続します。このウォークスルーでは、vLLM を使用した 8 基の NVIDIA B300 GPU を搭載した単一ノードを例にします。サーバーへのシェルアクセス、互換ドライバー、完全なチェックポイント用ストレージが必要です。まずは短いテキストリクエストを 1 件完了させてから、長い入力やエージェントのワークフローをテストしてください。
適切な GPU がない場合は、アプリケーションをローカルで実行し、公式の Kimi API または CometAPI のようなサードパーティプロバイダに接続できます。
重要なポイント
モデルの 104B のアクティブパラメータは、必要なストレージ全体を表すものではありません。
ハードウェア互換性には、GPU メモリ、インターコネクト、量子化のサポート、推論カーネルが含まれます。
強力なベンチマーク結果はテストの価値を示しますが、アプリケーションで同等の性能を保証するものではありません。
動作する推論エンドポイントには、ブラウザ、コードサンドボックス、完全なエージェントランタイムが自動的に含まれるわけではありません。
明確性、出典の帰属、最新のAPI用語について確認済みです。
自己ホスティングと API アクセスは、再試行や保守を含めた「成功したタスクあたりのコスト」で比較してください。
Kimi K3.1 Pro とは? Kimi K3.1 Pro は、Moonshot AI によるコーディング、ドキュメント分析、ツール使用向けのオープンウェイトなマルチモーダルモデルです。主要仕様は以下のとおりで、公式モデルカード に基づきます。
アーキテクチャ MoE; 総パラメータ 2.8T、アクティブ 104B アテンション 93 層: 69 KDA + 24 Gated DSA エキスパート 896 ルーティング; 1 トークンあたり 16 選択; 2 共有 コンテキスト 1,048,576 トークン 入力 テキストと画像; MoonViT-V2 ビジョンエンコーダ 量子化 MXFP4 の重み / MXFP8 のアクティベーション; 混合精度チェックポイント 推奨エンジン vLLM, SGLang, TokenSpeed
このモデルはトークンごとに 104B のパラメータをアクティブ化しますが、デプロイには依然として 2.8T パラメータの完全なチェックポイントが必要です。推論エンジンは、KDA および Gated DSA の各層構造と MXFP4 量子化に対応している必要があります。
Kimi K3.1 Pro をローカルで動かすにはどのハードウェアが必要? 以下の表は、このガイドに関連するvLLM の構成 をまとめたものです。ウォークスルーでは 8 基の GPU を搭載した B300 ノードを使用します。GB300 および AMD のデプロイではそれぞれの構成が必要です。
NVIDIA B300 単一ノード(8 GPU)、TP8 以下のウォークスルーのベースライン NVIDIA GB300 2 トレイにわたる 8 GPU、TP8 マルチノード構成とインターコネクトのセットアップが必要 AMD MI355X AMD 固有構成の 8 GPU ノード ROCm/AITER 経路を使用。NVIDIA の環境設定は再利用しないこと 単一の 24–32 GB コンシューマ GPU 完全チェックポイントの直接ロードには不十分 本チュートリアルの実用的な対象ではない
規模感のみを示すと、2.8T パラメータは BF16 で約 5.6 TB、8 ビットで約 2.8 TB、理想化された 4 ビットで約 1.4 TB を占めます。これは生のパラメータ格納の試算であり、実際のチェックポイントサイズやランタイムの VRAM 最小値ではありません。混合精度やメタデータでファイルサイズは変わり、キャッシュやランタイム割り当てで提供要件は増加します。
完全なダウンロード、テンポラリファイル、ロールバック用コピーのために NVMe 容量を確保してください。マルチノードシステムでは、モデルのロード前に通信を検証してください。
Kimi K3.1 Pro のデプロイ方法 適切なハードウェアがある場合は自己ホスティングを使用し、そうでなければホスト型 API から始めてください。以下の手順では vLLM を使用し、最後に代替として SGLang を示します。動作するリクエストが得られてからホスティングコストを比較してください。
セットアップ、ダウンロード、起動、初期検証の各コマンドは GPU サーバー上の Bash シェルで実行します。ノート PC から作業する場合は、まず SSH でそのサーバーに接続してください。Python クライアントは後述の接続手順に従って、どちらのマシンでも実行できます。
このウォークスルーは公式のデプロイレシピに従いますが、本記事のために独自にテストは行っていません。
1. GPU の可視性、ストレージ、接続性の確認 nvidia-smi
nvidia-smi topo -m
df -h
対象の GPU がすべて見えていること、およびモデルディレクトリに十分な空き容量があることを確認してください。ダウンロードキャッシュ、ログ、将来のチェックポイントバージョンのための追加ストレージも確保します。
マルチノードのデプロイでは、モデルの起動を試みる前にノード間の通信を検証してください。
最初のマイルストーンは狭く保ちます:チェックポイントをロードし、短いテキストリクエストを 1 件完了すること。こうすることで、障害の診断が容易になります。
2. サerving環境の準備 この単一ノードの例では、8 基の B300 GPU を搭載した Linux ホストを使用します。公開レシピに互換な CUDA 環境で、隔離された環境を作成し、サervingツールをインストールします:
python3 -m venv kimi-env
source kimi-env/bin/activate
python -m pip install --upgrade pip
python -m pip install --upgrade huggingface_hub
python -m pip install "vllm>=0.34.0" fastsafetensors
python -c "import vllm; print(vllm.__version__)"
バージョンの下限は、すべてのドライバやホイールとの互換性を保証するものではありません。ハードウェアレシピが専用コンテナやビルドを要求する場合は、その環境を使用してください。運用前には、テスト済みのバージョンを固定します。
3. 完全なチェックポイントをダウンロード Hugging Face CLI をインストールし、モデルリポジトリをダウンロードします:
python -m pip install --upgrade huggingface_hub

hf download moonshotai/Kimi-K3.1-Pro \
  --local-dir /srv/models/Kimi-K3.1-Pro
構成、トークナイザ、プロセッサファイル、重みインデックスを重みシャードと一緒に保持してください。特定のテンソルファイルのみをコピーすると、デプロイが不完全になる場合があります。
再現可能な本番デプロイのために、検証したリポジトリのリビジョンを記録して固定してください。商用利用前にリポジトリの独自ライセンスを確認してください。
4. vLLM サーバーの起動 公式レシピでは「vLLM 0.34.0 以上」が指定されています。ハードウェア固有の環境構成 に従って準備した後、テストに合格したバージョンおよび依存関係を固定します。
環境を準備したら、以下のベースラインコマンドを使用します。これは 8-way のテンソル並列を開始し、初期のコンテキストウィンドウを 32,768 トークンに制限します:
export VLLM_ENGINE_READY_TIMEOUT_S=3600

vllm serve /srv/models/Kimi-K3.1-Pro \
  --served-model-name kimi-local \
  --tensor-parallel-size 8 \
  --trust-remote-code \
  --load-format fastsafetensors \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3 \
  --max-model-len 32768 \
  --host 127.0.0.1 \
  --port 8000
kimi-local の名前はアプリケーションから参照するエイリアスです。後続のリクエストでも同じ名前を使用してください。
32,768 トークンの設定は、このウォークスルーの保守的な開始点であり、モデルがサポートする最大コンテキストではありません。
--trust-remote-code オプションは、リポジトリのカスタムコードのロードを許可します。レビュー済みで固定したチェックポイントリビジョンと組み合わせて使用してください。
ここでの 127.0.0.1 はクライアントを実行しているマシンを指します。以下の curl チェックは GPU サーバー上で実行しており、その推論プロセスに到達します。ノート PC から Python クライアントを使用するには、別のノート PC のターミナルで SSH トンネルを開き、維持してください:
ssh -N -L 8000:127.0.0.1:8000 user@gpu-server
user@gpu-server はあなたの SSH ログインとサーバーアドレスに置き換えてください。このトンネルが開いていると、ノート PC のクライアントは http://127.0.0.1:8000/v1. を使用できます。ノート PC 側でポート 8000 が既に使用中の場合は、別のローカルポートを選び、クライアントの URL を更新してください。
5. ローカルエンドポイントの検証 curl http://127.0.0.1:8000/v1/models
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "kimi-local",
    "messages": [
      {
        "role": "user",
        "content": "Explain database indexes in three sentences."
      }
    ],
    "reasoning_effort": "low",
    "max_tokens": 2048
  }'
期待するモデル名が含まれていること
レスポンスに最終的な回答が含まれていること
生成が完了したか制限に到達したかを示す finish_reason
GPU メモリや未サポート操作に関するエラーの有無
推論のための推理処理が生成予算の一部を消費する可能性があります。最終回答の生成前にリクエストが制限に達した場合は、予算を増やして再試行し、サーバーの障害と結論づける前に確認してください。
6. ローカルの Python アプリケーションを接続 python -m pip install openai
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8000/v1",
    api_key="EMPTY",
    timeout=300.0,
    max_retries=1,
)
response = client.chat.completions.create(
    model="kimi-local",
    messages=[{"role": "user", "content": "Write a Python function that removes duplicate filenames while preserving order."}],
    reasoning_effort="low",
    max_tokens=2048,
)
print(response.choices[0].message.content)
print(response.choices[0].finish_reason)
EMPTY は API キー認証のないループバック専用サーバー用のプレースホルダーです。認証されたエンドポイントでは設定済みの資格情報を使用してください。画像入力とツール実行は、エージェントに接続する前に別途検証してください。
SGLang の代替 SGLang を使用する場合は、公式のハードウェア固有クックブック を参照してください。単一ノードのこのウォークスルーに最も近い構成として、B300、Unified、Low-Latency(TP8)を選択します。表示される検証ステータスを確認してください。生成された構成は、必ずしもテスト済みの構成を意味しません。
GPU サーバー上で Docker をインストールし、NVIDIA Container Toolkit を構成してから、ダウンロードしたチェックポイントを /models/Kimi-K3.1-Pro にマウントしたコンテナを作成します。同じ GPU を争わないよう、先に vLLM を停止してください。
docker pull lmsysorg/sglang:dev-kimi-k31-pro
docker run --rm -it --gpus all \
  --shm-size 32g --ipc=host \
  -p 127.0.0.1:30000:30000 \
  -v /srv/models/Kimi-K3.1-Pro:/models/Kimi-K3.1-Pro:ro \
  lmsysorg/sglang:dev-kimi-k31-pro bash
コンテナ内で、選択した構成に対してクックブックが生成した完全な起動コマンドを貼り付けます。モデルパスは /models/Kimi-K3.1-Pro に置き換え、サービスのホストを 0.0.0.0、ポートを 30000 に設定し、ハードウェア固有のフラグを保持してください。Docker のポートフォワーディングを機能させるには、コンテナがネットワークインターフェースでリッスンする必要があります。上記のホスト側ポートはループバックにバインドされたままです。サービス準備完了メッセージが出るまで待ってからテストしてください。
GPU サーバー上の別シェルで、公開されているモデルを一覧表示し、返されたモデル ID を正確に使用してリクエストを送信します:
curl http://127.0.0.1:30000/v1/models

MODEL_ID="replace-with-id-from-models-response"
curl http://127.0.0.1:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"$MODEL_ID\",\"messages\":[{\"role\":\"user\",\"content\":\"Explain database indexes in three sentences.\"}],\"reasoning_effort\":\"low\",\"max_tokens\":2048}"
成功したレスポンスには最終回答が含まれるはずです。起動に失敗した場合は、コンテナのログを調査し、選択したハードウェアレシピとイメージが一致していることを確認してください。ノート PC からのアクセスには、ポート 30000 を使って同じ SSH トンネルパターンを使用します。コンテナの前提条件については SGLang の Docker インストールガイド を参照してください。
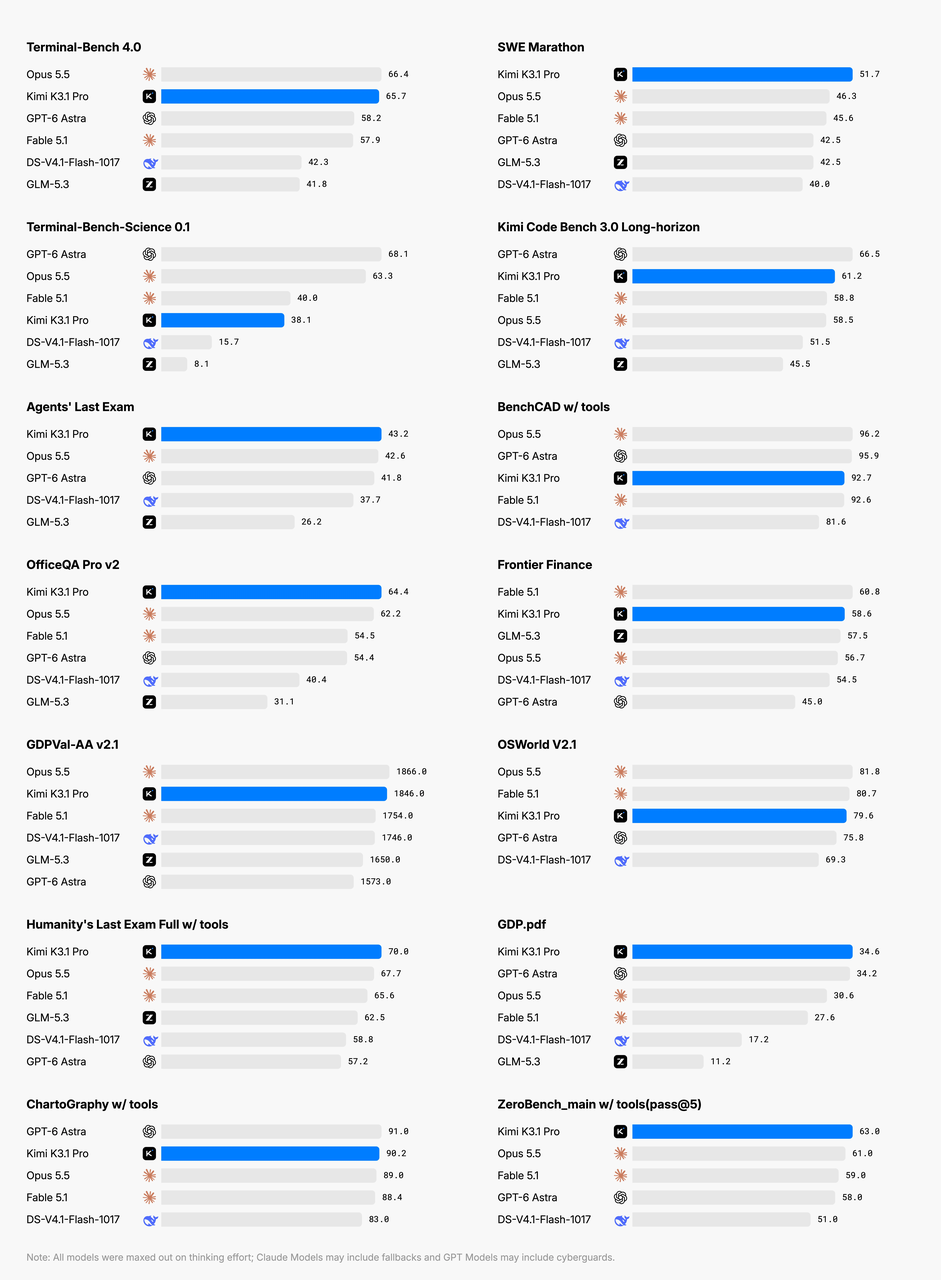
Kimi K3.1 Pro はベンチマークでどう性能を示す? このガイドで構成したローカルサーバーではなく、公開された評価セットアップを説明する公式評価結果 を基に、デプロイテストに使用するタスクを選びます。
以下の表は、モデルカードに掲載された比較セット内での選抜結果とその位置を示します。
Terminal-Bench 4.0 65.7 2位 SWE Marathon v1.1 51.7 1位 Program Bench 31.5 4位 OfficeQA Pro v2 64.4 公式報告内で 1位 Frontier Finance 58.6 2位
これらの結果は、拡張されたエンジニアリングタスクやドキュメント関連のワークフローに向けたモデルのテスト価値を支持します。Kimi K3.1 Pro は SWE Marathon で比較内トップですが、ProgramBench では 4 位であり、いずれもアプリケーション固有のテストに有用な候補です。
これらの位置付けは公式の比較表内で計算されたものであり、リアルタイムのグローバルリーダーボードではありません。評価ハーネス、ツール、推理予算、サンプル選定はベンチマークごとに異なります。
デプロイの意思決定では、実際の業務から小規模な評価セットを作成してください:リポジトリ修正、文書横断の質問、多段のツールタスクなど。完了品質、人間による修正、経過時間を測定します。公開スコアは絞り込みに有用ですが、デプロイが価値あるものかどうかはアプリケーションテストが決定します。
Kimi K3.1 Pro のローカル推論を最適化するには?
コンテキストと同時実行を制御 短いリクエストが動作したら、長いドキュメント、画像、マルチターンの会話、ツール呼び出しをそれぞれ別々にテストしてください。
意図するコンテキスト長と同時実行数で、最初のトークンの待ち時間、1 秒あたりの出力トークン数、ピーク GPU メモリを追跡します。また、タスク成功率と成功したタスクあたりのコストも記録し、より高速な出力が再試行や人手による修正を増加させていないかを見逃さないようにします。
主要な変数は一度に 1 つだけ変更してください。コンテキスト長、同時実行、最適化設定を同時に増加させると、性能低下の説明が困難になります。
推理努力とキャッシュ設定を意図的に選択 タスクに応じて low、high、max の推理努力を使用します。インターフェイスチェックでは low から始め、難しいタスクでは high と max を比較し、補完品質と経過時間の両方を評価してください。推理の痕跡が長くなること自体は、より良い結果の証拠ではありません。
長いセッションでは、推測的デコーディングや同時実行を増やす前に、キャッシュ容量とプレフィックス再利用を評価してください。既知の良好なベースラインを維持し、設定は 1 回に 1 つずつ変更します。
なぜデプロイ後に Kimi K3.1 Pro のツール呼び出しが失敗することがあるのか? アプリケーションはツール呼び出しを実行し、その結果を返し、会話を継続します。reasoning_content と tool_calls を含む完全なアシスタントメッセージを保持し、それぞれのツール結果を対応する tool_call_id とともに返してください。
モデルアーキテクチャが認識されない ランタイムのバージョン、カスタムコード、設定 ロード中にメモリ不足 GPU 容量、並列度、競合するプロセス 短いリクエストは動作するが長いリクエストは失敗 コンテキスト上限、キャッシュ容量、同時実行 ツール呼び出しが解析できない パーサ設定とツールスキーマ ツール要求後にエージェントが停止する アプリケーションの実行とツール結果の取り扱い マルチターンの回答が一貫しなくなる アシスタントメッセージのフィールド欠落
最小の再現可能リクエストを使用して各障害を切り分けてください。動作したら、アプリケーションの追加設定を 1 つずつ戻します。
自己ホスティングすべきか、それともホスト型 API を使うべきか? ウェイト、インフラ、データの所在を制御する必要があり、GPU を有効に活用できる場合は自己ホスティングを選択してください。初期評価や需要が変動する場合は、同じプロンプトと受け入れ基準を用いて公式 Kimi API とCometAPI を比較します。各サービスのモデルアクセス、サポートパラメータ、クォータ、データ取り扱い規約を確認してください。
キャパシティコスト GPU の購入またはレンタル(アイドル時間を含む) API 利用の課金。各プロバイダの最新レートを確認 ストレージとネットワーク チェックポイントのストレージ、キャッシュ、ネットワーク課金 アプリケーション側のストレージとネットワーク課金 運用 デプロイ、監視、アップグレード、復旧 インテグレーション、クォータ管理、リクエスト監視 再試行 GPU 時間を計算コストに含める トークンや API コールを API 課金に含める 人間によるレビュー 同じレートで修正時間を計上 同じレートで修正時間を計上 最適適合 需要が安定し、インフラを制御したい場合 評価段階や需要が変動する場合
成功したタスクあたりのコスト =(GPU 計算または API 課金 + ストレージとネットワーク + 運用 + 人間による修正)/ 成功したタスク数。
同一の測定期間のコストと成功タスク数を使用してください。失敗と再試行は、計算または API 合計に一度だけ含め、二重に再試行コストを加算しないでください。ハイブリッドのワークフローでは、計算と API 課金の両方を含めます。リクエスト試行ではなく、完了した固有のタスクをカウントします。
理論的スループットが優れていても、使用率の低いサーバーは高コストのままになり得ます。逆に、既存インフラ、安定した需要、厳格なデータ要件を持つチームは、自己ホスティングから大きな価値を得られる可能性があります。
デプロイルートを比較する際は、同じプロンプトと受け入れ基準を使用してください。意思決定には、エンドツーエンドのレイテンシと出力品質も含めます。
ウェイトをロードせずにホスト型エンドポイントを試す 公式の Kimi API クイックスタート では、以下のエンドポイントを使用します。環境変数 MOONSHOT_API_KEY を設定し、アカウントでモデルアクセスを確認してください。このリクエストはプロバイダのインフラで実行されます。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    reasoning_effort="low",
    max_completion_tokens=2048,
)
print(response.choices[0].message.content)
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_API_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    max_tokens=2048,
)
print(response.choices[0].message.content)
同じ受け入れ基準で、ローカルエンドポイントの結果と比較してください。本番コストの見積もり前に、現在のルート価格とサポートパラメータを確認しましょう。
結論 Kimi K3.1 Pro の自己ホスティングは、サポート対象の GPU 構成と一致する推論環境があれば実用的です。上記のデプロイ手順で動作するエンドポイントを確立し、独自のワークロードでタスク品質、レイテンシ、コストを測定してください。アプリケーションの検証段階にある場合や適切なハードウェアがない場合は、ホスト型 API を選択します。
FAQ
一般的なノート PC で完全なモデルは動作しますか? 元のチェックポイントの容量要件を満たす実用的な対象ではありません。ノート PC は、自前の推論サーバーやホスト型 API に接続するクライアントとして機能できます。
デスクトップアプリをインストールすればローカルデプロイになりますか? アプリケーションのインストール場所は推論の実行場所を決定しません。自己ホスティングには、モデルのウェイトと推論プロセスがあなたの管理するインフラで実行されることが必要です。
なぜアクティブなパラメータが 104B なのに、モデルがそれほど多くのメモリを必要とするのですか? トークンごとに異なるエキスパートが選択される可能性があります。アクティブパラメータは計算への参加を表し、デプロイでは依然として全体のウェイトを格納・アクセスする必要があります。
すぐに 100 万トークンのフルコンテキストを有効化できますか? コンテキスト長を段階的に増やし、目標の同時実行数で GPU メモリ使用量を測定してください。モデルは 1,048,576 トークンをサポートしますが、使用可能な提供容量はキャッシュや並列設定に依存します。
ローカルデプロイで公開ベンチマークのスコアを再現できますか? 自動的には再現できません。量子化、推理予算、ツール、プロンプト、評価フレームワークが結果に影響します。独自のタスクに対して構成を検証してください。
ハードウェア購入前に API 経由でテストすべきですか? モデルが品質要件を満たすことを確立していない場合、API テストはインフラ作業を少なくして初期ベースラインを提供します。適切なハードウェアと明確なデータ所在地要件があるチームは、管理された自己ホスティング評価に直接進むことができます。