
要約
Kimi K3.1 Pro は Moonshot AI が 2026年10月24日に Kimi K3 をアップグレードしたモデルです。追加のポストトレーニングにより、自律的なコーディング、ファイナンス調査、拡張されたツール活用ワークフローが強化され、約100万トークンのコンテキスト容量は維持されています。
独立評価では全体性能の向上が示され、公式の標準的な入出力トークン単価は3分の1低下しました。一方で、K3.1 Pro への切替にはワークロード検証が必要です。より深い推論によりタスクのレイテンシや総支出が増える場合があり、AA-LCR と自己ホスティング用の公開ウェイトでは K3 がわずかに先行しています。
重要ポイント
- エージェント型実行での伸びが最も明確。Artificial Analysis は Terminal-Bench 4.0 で K3.1 Pro が約67%、K3 が約13%と報告。Moonshot 内部の Financial Research は 58.8 から 70.4 に上昇。
- トークン価格の低下はタスクコストの低下を保証しない。標準の公式入出力単価は 100万トークンあたり $3/$15 から $2/$10 に低下したが、追加の推論、ツール呼び出し、リトライが節約分を相殺しうる。
- コンテキストウィンドウは同一。両モデルとも最大 1,048,576 トークンに対応。AA-LCR v1.1 では K3 がわずかに先行しているため、自身のドキュメントで長文脈精度を検証すべき。
- ウェイト提供状況が選択を左右しうる。2026年10月24日時点で K3 のウェイトは利用可能。K3.1 Pro のウェイトは 11月4日までに公開予定。即時の自己ホスティングが必要なチームは差異を考慮。
Kimi K3.1 Pro と Kimi K3:概要と仕様
Kimi K3.1 Pro は K3 を基盤に追加のポストトレーニングで強化され、コーディング、ファイナンス調査、拡張エージェントワークフローに焦点を当てた改善がなされています。コンテキストは約100万トークンのまま。主な違いはタスク性能、トークン価格、提供形態、ウェイト提供状況です。
| Specification | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Developer | Moonshot AI | Moonshot AI |
| Release date | 2026年10月24日 | 2026年7月16日 |
| Architecture | K3-derived MoE, further post-trained | MoE with KDA, AttnRes |
| Model size | 3T-class and 104B active parameters | 2.8T total and 104B active parameters |
| Context window | Up to 1,048,576 tokens | Up to 1,048,576 tokens |
| Standard API input / output price | $2 / $10 per million tokens | $3 / $15 per million tokens |
| Highspeed version | Available | No separate K3 Highspeed variant is listed |
| Weight availability | Release planned by November 4, 2026 | Available under the Kimi K3 License |
ウェイト提供状況は 2026年10月24日時点の情報に基づく。API 価格は USD の通常入出力向けで、キャッシュ書き込み料、税金、その他の適用手数料は除外。
アーキテクチャとポストトレーニング
K3 は 2.8 兆パラメータのアーキテクチャを導入し、Kimi Delta Attention、Attention Residuals、Stable LatentMoE を組み合わせました。トークンあたり約 1040 億パラメータがアクティブになります。
Moonshot は K3.1 Pro を、より大量のポストトレーニング計算資源で開発した K3 のポストトレーニング版と説明しています。ツール使用、デバッグ、結果検証などのマルチステップタスクで能力を発揮することに焦点を当てています。別名のベースアーキテクチャは発表されていません。
共通の機能と API 要件
両モデルともマルチモーダル入力、ツール呼び出し、構造化出力、コンテキストキャッシングをサポート。画像・動画入力形式は選択する API ルートに依存。両モデルは常に推論を行い、low、high、max の推論強度をサポートし、デフォルトは max です。
マルチターン会話やツール呼び出しでは、API が要求するとおり、推論内容やツール呼び出しを含むアシスタントメッセージを完全に保存する必要があります。実際のコンテキスト上限や機能可用性は、選択したプロバイダ、製品、サブスクリプション階層で確認してください。
Kimi K3.1 Pro と Kimi K3:性能
根拠は Moonshot の内部テストや報告比較に加え、独立した第三者評価に基づきます。
評価ハーネス、テストセット、推論設定、採点基準は異なりうるため、結果は分けて解釈してください。
Artificial Analysis のローンチ評価では、複合 Intelligence Index が 11 ポイント上昇し、とくにターミナルベースのコーディングとエージェント型ワークフローでの改善が大きいと報告しています。
| Independent Benchmark (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Difference |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 percentage points |
| AutomationBench-AA | 58% | 73% | +15 pp |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 pp |
| AA-Omniscience hallucination rate | 53% | 44% | −9 pp |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 pp |
これらは独立評価の結果です。評価者が丸め値を報告している場合は丸め値を使用。ハルシネーション率は低いほど良い。
最大の改善はターミナルベースのコーディングで見られます。コマンド実行、環境との相互作用、デバッグ、反復的検証を要するタスクで K3.1 Pro は大幅に良好です。
AutomationBench-AA でも有意な伸びが見られ、SaaS ワークフローでの実行能力向上が示唆されます。
Moonshot のリリースベンチマークは、コーディング、科学、3D 再構成、ファイナンス、知識労働、自律エージェントに焦点を当てています。
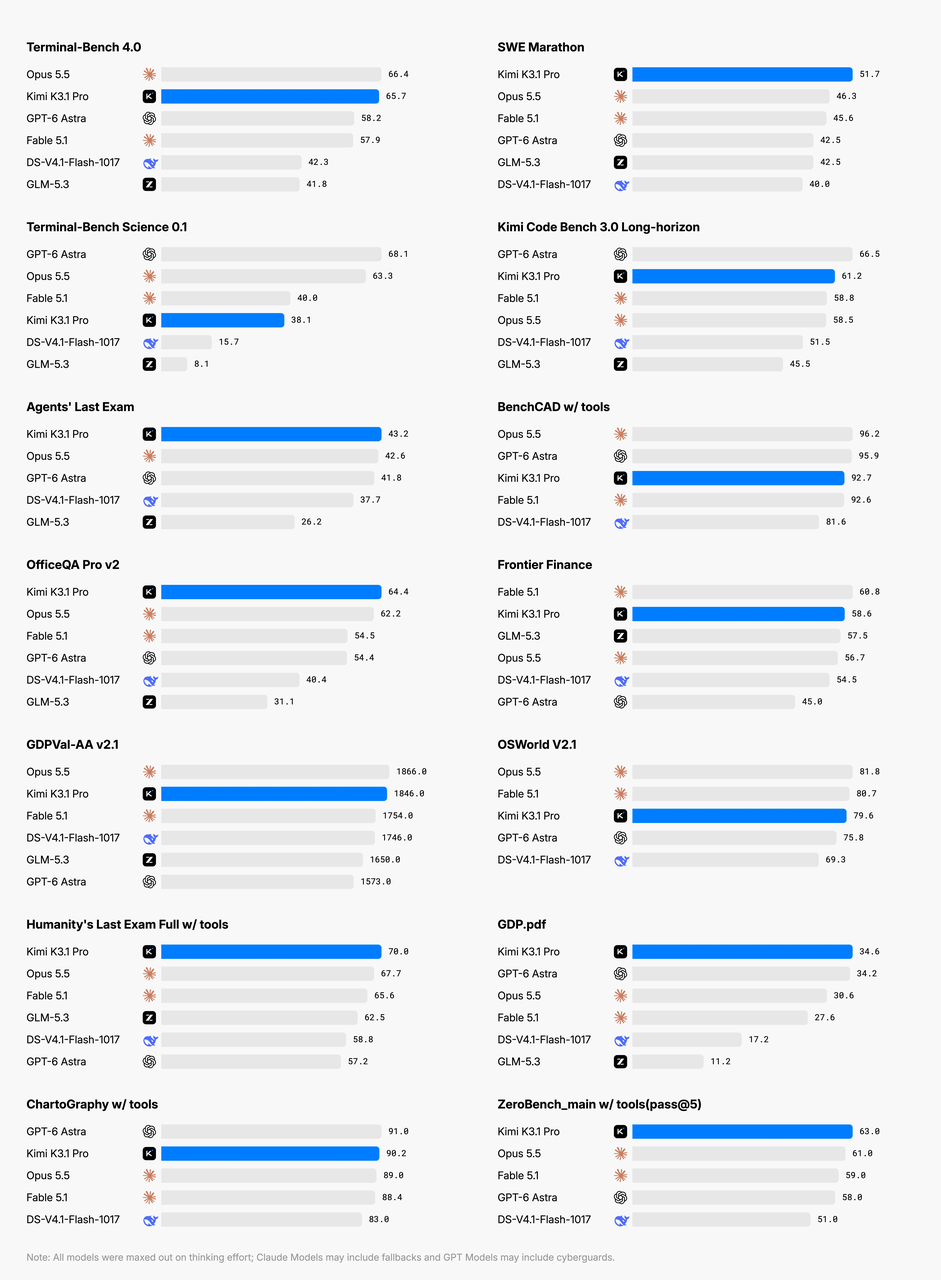
選択された比較には Claude Opus 5.5 および GPT-6 Astra が含まれます。各結果は、記載されたベンチマーク名と設定に限定して比較してください。
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Other Model | Comparison Model Score |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD with tools | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
K3.1 Pro は、特定のタスクで主要なプロプライエタリモデルに迫るか上回る結果もあります。ただし、すべてのカテゴリで優位というわけではありません。
たとえば、ベンダー報告の BenchCAD と OSWorld 比較では Claude Opus 5.5 に劣り、公式チャートでは Terminal-Bench Science における弱さがより大きく示されています。
評価設定は異なります。Artificial Analysis は Terminal-Bench 4.0 に mini-swe-agent ハーネスを使用し、Moonshot は Claude Code を使用しています。同一のテスト設定内でスコアを比較してください。ハーネス、推論強度、実行時間上限は結果に影響します。
コーディングとソフトウェアエンジニアリング
複雑な自律コーディングでは、一般に K3.1 Pro が有力です。
Moonshot の内部 Kimi Code Bench 3.0 Long-horizon は、K3 の 55.95% から K3.1 Pro の 61.2% へ、約 5.25 ポイント上昇。
独立の Terminal-Bench 結果でも大幅な伸びが確認されます。これらのテストは、リポジトリの理解、ファイル変更、コマンド実行、エラー診断、結果検証といったマルチステップ実行を評価します。
K3.1 Pro は、多数ファイルの開発、自律的なターミナル作業、拡張デバッグに有力です。単純なコード生成では、両モデルを自分のタスクで比較してください。自己ホスティングが必須な場合は、即時に利用可能な K3 に利点があります。
重要な相違として、コーディングベンチマークのスコアはエージェントフレームワークに強く依存します。ツール、プロンプト、実行時間上限、テスト環境が結果に影響します。
本番のソフトウェア開発では、自身のリポジトリでの厳密な比較が依然として最良です。
ファイナンス調査とビジネスオペレーション
ファイナンシャル・モデリングは両モデルの直接比較が最も明瞭です。
Moonshot は、スプレッドシート構築、調査品質、模擬ビジネスオペレーションをカバーする内部評価で K3 と K3.1 Pro をテストしました。
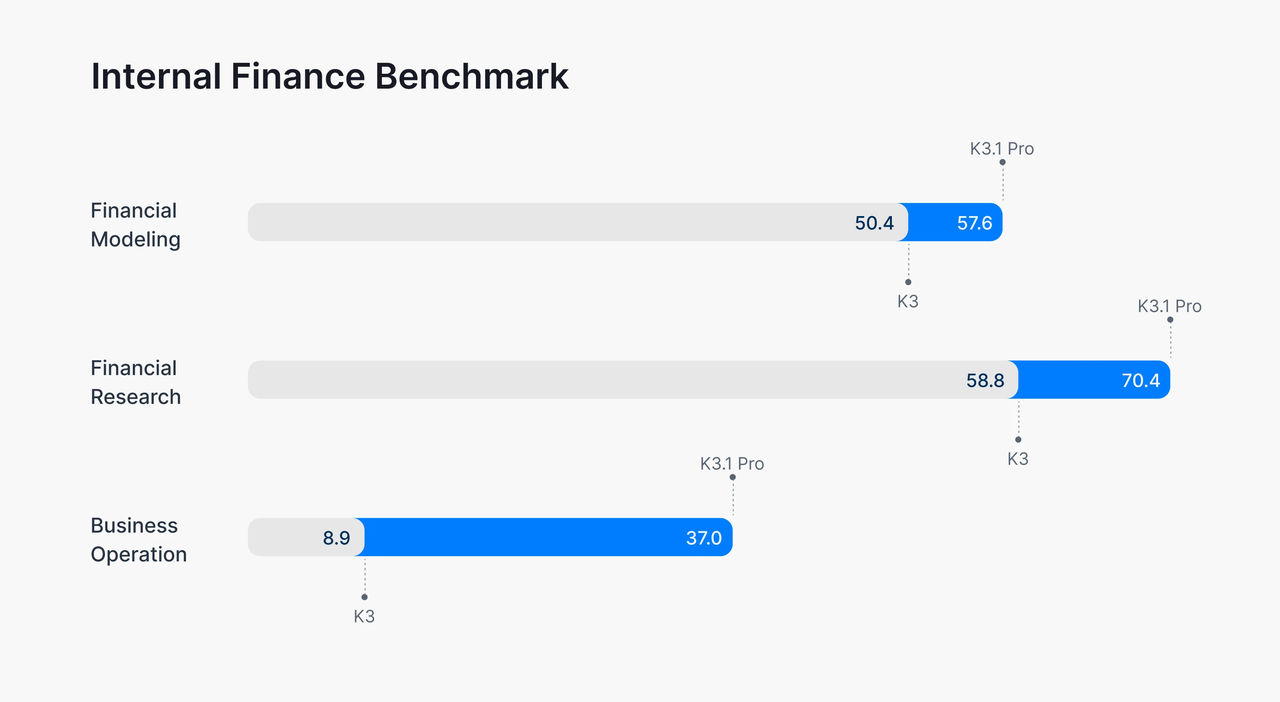
Moonshot の内部ファイナンス結果は、ファイナンシャル・モデリング、調査、模擬ビジネスオペレーションを対象としています。これらベンダー報告のタスクスコアは投資リターンの測定ではありません。タスクごとの設定は、他のベンチマークと同一とみなすべきではありません。
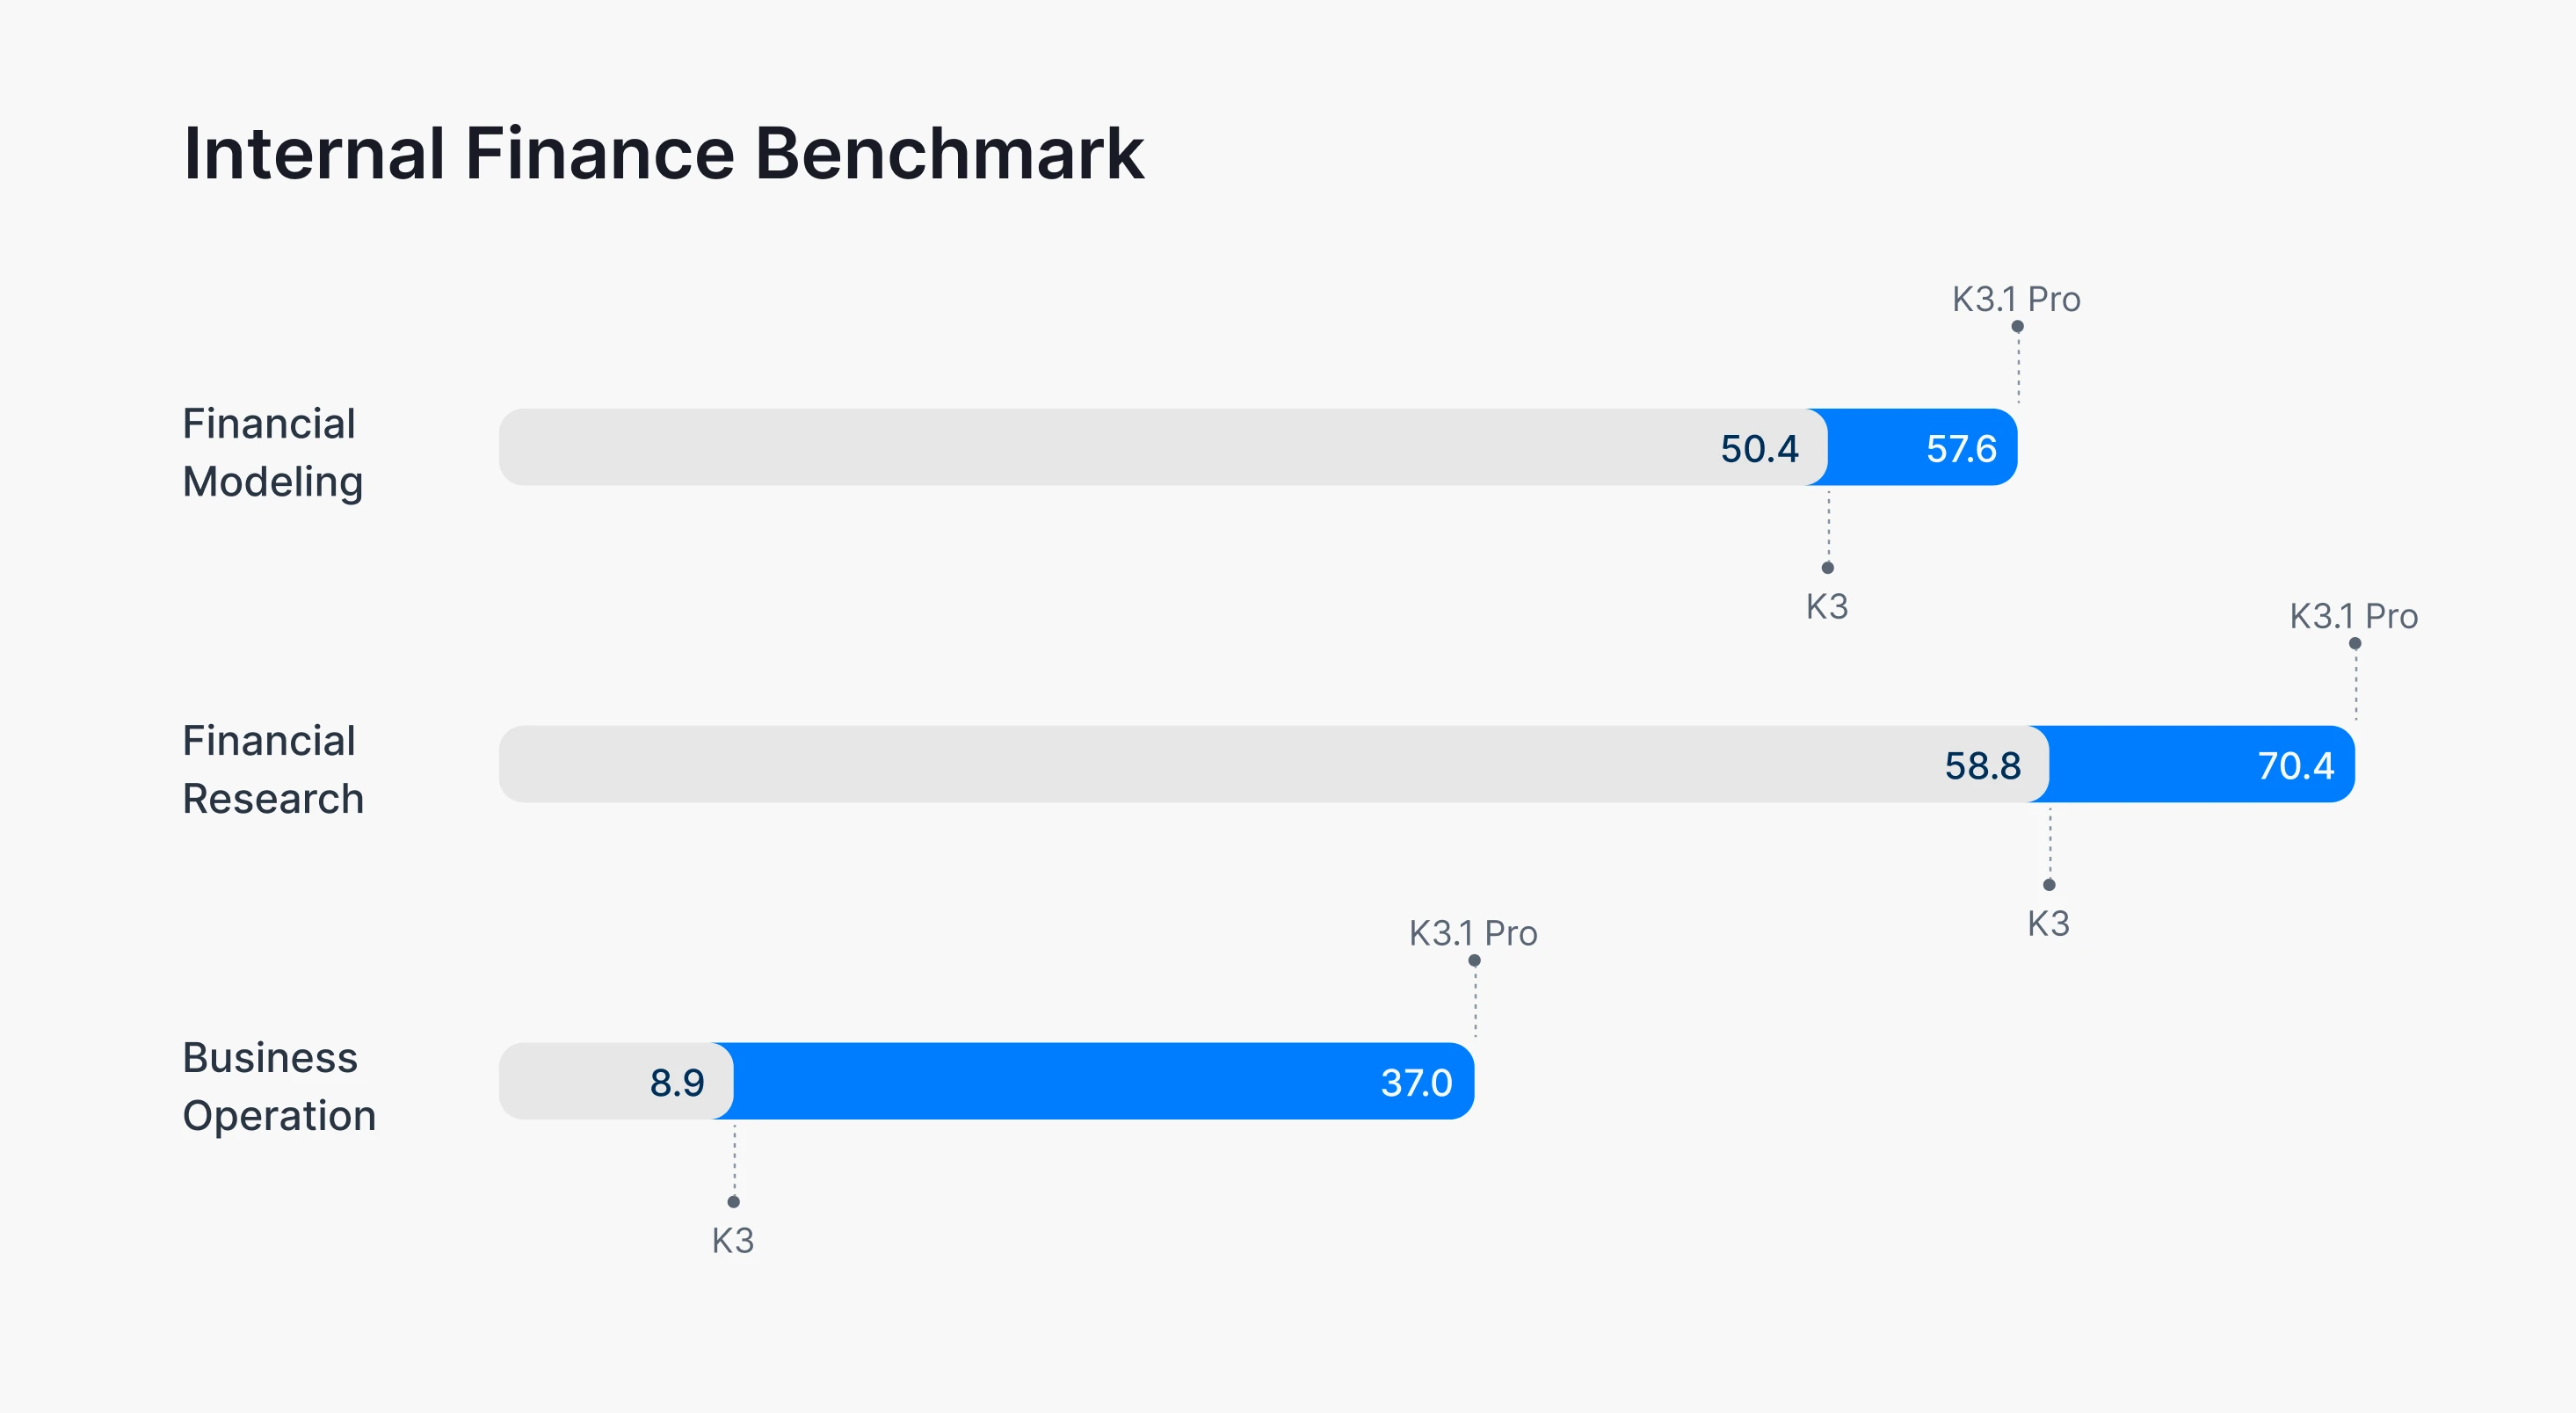
内部テストでは、Financial Modeling が 50.4 から 57.6 へ 7.2 ポイント上昇、Financial Research が 58.8 から 70.4 へ 11.6 ポイント上昇。Business Operation は 8.9 から 37.0 へ、約 4.2 倍に増加。
このベンチマークは、模擬ビジネス環境での長期的なマネジメントと意思決定を評価します。したがって、単純なファイナンス Q&A よりも、エージェント型の計画に近い性質です。
Financial Research は、出典要件と情報カットオフを遵守しつつ、エビデンスに基づく調査を行う能力を測定。Financial Modeling は、数理関係、スプレッドシートロジック、ワークブック品質に焦点を当てます。
このパターンは、継続的な推論、検証、構造化成果物を要するファイナンス作業で K3.1 Pro がとくに有用であることを示唆します。
投資家、アナリスト、ビジネスユーザーにとっては、マルチドキュメント・ワークフローの扱いの向上が実務的利点となりえます。いずれのモデルも、ファイナンス上の重要判断で無条件の権威として用いるべきではありません。
長文脈推論と事実信頼性
一方で、AA-LCR の長文脈結果では K3 がやや上回っています。新モデルは全体的に大幅改善しても、すべての専門タスクで勝るわけではないという有用な示唆です。
報告では、各テストセットでの事実誤りが減少。
Kimi Hallu Bench Hard(ツールあり)において、Moonshot は主張レベルのエラー率が K3 の 23.4% から K3.1 Pro の 8.3% に低下したと報告しています。
これは日常的なエラー率の推定ではなく、意図的に困難なストレステストにおける相対的な約 65% の低減です。別途、Artificial Analysis は AA-Omniscience のハルシネーション率が 53% から 44% に低下したと報告。二つの評価は手法が異なるため、百分率は直接比較できません。
実務上の教訓は、評価されたタスクでは K3.1 Pro の信頼性が高まっているように見えるものの、重要なワークフローでは依然として検索(RAG)、引用、計算チェック、人間レビューが必要ということです。
データ分析:Plotly の評価からの証拠
Plotly は OpenRouter 経由で標準の K3.1 Pro を、合成風力発電データウェアハウスに関する非公開の 43 問テストで評価しました。Highspeed は未評価。これは特定の SQL ベース分析ワークフローにおける、回答品質、完了時間、コストのトレードオフを示します。
| Plotly Data Analytics Measure | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Correct answers | 35/43 | 42/43 |
| Accuracy | 81.4% | 97.7% |
| Hidden patterns discovered | 0/5 | 5/5 |
| Data-quality issues identified | 1/3 | 3/3 |
| Full evaluation cost | $5.01 | $13.47 |
| Median time per question | 43 seconds | 2.5 minutes |
この評価では、K3.1 Pro はより多くの設問に正答し、隠れたパターンやデータ品質問題を多く特定しましたが、コストが高く中央値の完了時間も長くなりました。
記載の料金は観測された評価コストであり、Moonshot の標準 API 価格から計算した推定ではありません。公開された設定は、両モデル実行でプロバイダ設定が完全に同一であったことを立証しないため、相違をモデル単独に帰すことはできません。
これらの結果は、追加の発見がより多くの時間と支出を正当化しうる分析タスクで K3.1 Pro を評価する根拠を与えます。同一の精度やコスト上の優位性を確立するものではありません。
Kimi K3.1 Pro は Kimi K3 より速いのか?
出力トークンスループットとエンドツーエンドのタスクレイテンシを区別してください。
Artificial Analysis は、Kimi の API を用いた最大推論強度で、K3.1 Pro の出力が毎秒 73.5 トークン、K3 が 38.5 トークンと報告(2026年10月24日確認)。これはトークン生成の測定であり、総レイテンシは推論長やツール実行にも依存します。
しかし、トークン生成が速いことは、タスク完了が速いことを保証しません。
Moonshot は K3.1 Pro Highspeed も提供しており、標準版の約 2〜3 倍の出力速度を謳っています。これは提供速度の改善であり、知能の検証済み向上とは別です。
K3.1 Pro は出力トークンスループットが高いと報告されていますが、必ずしもタスク完了が速いとは限りません。トークン生成速度と、推論・ツール呼び出し・完了までの時間を区別してください。
出力速度 vs. タスク完了時間
Artificial Analysis は、Kimi の API を用いた最大推論強度で、K3.1 Pro が毎秒 73.5 トークン、K3 が 38.5 トークンの出力速度と報告(2026年10月24日確認)。これはトークン生成スループットであり、エンドツーエンドのタスクレイテンシではありません。
モデルはトークンを速く生成しても、より多くの推論トークンを生成したり、追加のツール呼び出しを行えば、全体の時間は長くなりえます。前述の Plotly 評価では、K3.1 Pro の設問あたり中央値は 2.5 分、K3 は 43 秒で、精度は K3.1 Pro が高い結果でした。
対話型アプリケーションでは、実際のプロバイダルートで初回トークンまでの時間と総完了時間を測定してください。出力スループットだけでは応答性は予測できません。
K3.1 Pro Highspeed の検討
Moonshot は K3.1 Pro Highspeed について、標準版の約 2〜3 倍の出力速度を謳っています。これは提供速度に関する主張であり、総タスク完了時間が 2〜3 倍短縮されると解釈すべきではありません。
対話型のコーディングやアシスタント用途では Highspeed を検討し、標準エンドポイントと比較してエンドツーエンドのレイテンシ、タスク成功率、総請求コストを確認してください。Highspeed は通常入出力トークン単価が高く、キャッシュ済み入力の単価は同一です。
Kimi K3.1 Pro と Kimi K3:コスト
公式 API と CometAPI の料金
標準の K3.1 Pro は、公式の入出力およびキャッシュヒット単価が K3 より 3 分の 1 低い。記載の CometAPI の入出力単価は、対応する公式単価よりさらに 20% 低い。
| Model | Official Input / 1M | Official Output / 1M | Official Cached Input / 1M | CometAPI Input / 1M | CometAPI Output / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Check current quote | Check current quote |
USD/100万トークン。2026年10月24日確認。入力は通常の非キャッシュ入力単価。税金や別請求の料金は除外。
公式 Kimi 価格にはキャッシュ書き込み料金も掲載:標準 Pro は 5 分/1 時間保持で 100万トークンあたり $2/$4、Highspeed は $4/$8。キャッシュヒット、キャッシュ書き込み、通常入力は相互排他的な課金カテゴリです。
公式 Kimi と CometAPI は別のプロバイダルートです。選択したルート(Highspeed 可用性を含む)の現行価格とキャッシュ対応を確認してください。トークン単価だけでなくタスク全体の請求額も比較しましょう。
固定トークンのコスト例
非キャッシュの入力 100,000 トークン、出力 20,000 トークンを消費するワークロードを考えます。
この固定ワークロードでは、公式 API のコストは K3 で $0.60、K3.1 Pro で $0.40。記載の CometAPI 単価では、それぞれ $0.48 と $0.32。これら合計は記載の入力・出力トークンのみを含む。
ただし、これは固定トークンの比較です。複雑なエージェントワークフローでは、モデルにより推論トークンやツール呼び出し量が異なる場合があります。
トークン節約は消える
非キャッシュの入力トークン数を I、Kimi K3 の課金対象出力トークン数を O、Kimi K3.1 Pro の課金対象出力トークン数を P(いずれも 100万単位)とします。価格表の標準公式単価では、料金は 3I + 15O と 2I + 10P ドル。同額となるのは P = 1.5O + 0.1I のとき。
出力比率が高いリクエストでは、K3.1 Pro は約 50% 多い課金対象出力トークンまで価格優位を維持できます。この計算は単価不変を仮定し、キャッシュ、ツール料金、その他の別課金は除外。可視の回答長ではなく、実際に課金されたトークンカテゴリで比較してください。
成功タスクあたりのコスト
成功タスクあたりコストは、全評価試行の総請求額を、事前定義の合格基準を満たしたユニークタスク数で割って計算。プロバイダが課金する失敗、リトライ、タイムアウトも含めます。成功実行の費用だけを成功件数で割ると、成功あたりコストを過小評価し得ます。
Kimi K3 と K3.1 Pro 間で、タスクセット、合格基準、リトライ上限、タイムアウト方針を固定してください。難易度の高いタスクを外すことで見かけ上の経済性が向上しないよう、成功率と併せて成功あたりコストを報告。成功が 0 の場合、成功あたりコストは未定義(ゼロではない)。
Kimi K3.1 Pro と Kimi K3:比較と選定
多くのホステッドなエージェント型ワークロードでは、K3.1 Pro が有力な出発点です。ただし、選定はタスクの複雑性やデプロイ要件を反映すべきです。
| Use Case | Recommended Model | Reason |
|---|---|---|
| Autonomous coding | Kimi K3.1 Pro | 複数ファイル変更、ターミナル作業、デバッグ、最終テスト結果を評価。 |
| Multi-document financial research | Kimi K3.1 Pro | 調査とビジネスオペレーションのベンチマークが改善 |
| Complex data analysis | Kimi K3.1 Pro | 問題発見やデータ品質検査が向上 |
| 3D creation and CAD workflows | Kimi K3.1 Pro | 特化ツール併用能力が強力 |
| Straightforward text tasks | Benchmark both | ルーチン文章や単純コーディングは両モデルで比較。余分な推論はレイテンシを増やすだけで許容解の質を上げない場合あり。 |
| Long-context retrieval accuracy | Benchmark both | AA-LCR では K3 が微差で先行 |
| Immediate self-hosting | Kimi K3 | ダウンロード可能なウェイトが既に利用可能 |
| Interactive high-capability agents | K3.1 Pro Highspeed | より高速な提供。コスト検証が前提 |
| Cost-sensitive production workflows | Benchmark both | トークン単価の低下がタスクコスト低下を保証するわけではない |
ホステッド自動化とプロフェッショナル・ワークフロー
ホステッドなコーディングエージェントや分析ワークフローでは、K3.1 Pro を実業務の難所で評価してください:複数ファイル変更、エビデンス収集、計算チェック、ツール失敗後の復旧。見出しスコアの高さより、失敗や手戻りの実測減少を優先。
既存の K3 アプリケーションでは、比較のベースラインとして現行ルートを維持。ルーチンタスクは既に合格閾値を満たしている可能性があり、長文脈の特殊タスクは集計ベンチマークと異なる挙動を示しうる。アップグレードの効果が測れるワークロード区間を優先。
自己ホスティングとデプロイ制約
2026年10月24日時点で、K3 のフルウェイトは利用可能で、モデルライセンスとハードウェア要件に従いデプロイ可能。K3.1 Pro のフルウェイトは未公開。
Moonshot は K3.1 Pro のウェイトを 2026年11月4日までに公開予定としています。これはリリース計画の発表であり、利用可能なチェックポイントではありません。自己ホスティングを予定する前に、公開ウェイトと適用条項を確認してください。
本番評価の基準
同一のプロンプト、ツール、合格基準、リトライ上限、タイムアウトで代表的タスクを用い、K3 と K3.1 Pro を比較。プロバイダと推論設定を記録し、API 要件どおりアシスタントメッセージを完全保存。
タスク成功、レイテンシ、トークン使用量、成功あたりコストを測定。失敗やリトライ・タイムアウトの課金も含める。K3 が成功し K3.1 Pro が失敗したケースをレビュー。人間による評価では、モデルラベルを隠し、出力順をランダム化。
K3.1 Pro が品質・レイテンシ・コストの閾値を満たすなら、K3 のフォールバックを確保しつつ段階的にロールアウト。
制御された移行とフォールバック
実務的には、まず本番トラフィックの一部を K3.1 Pro へ。
検証中は K3 をフォールバックとして保持。タスク品質、レイテンシ、失敗率、支出を比較し、K3.1 Pro の利用比率を拡大。
とくにツール呼び出しスキーマ、推論関連メッセージフィールド、マルチモーダル入力、出力パースに注意。API 互換でも、アプリの挙動が同一とは限りません。
ベンチマークの伸長と後退
同一の 43 問で 35 と 42 のスコアだった場合、K3.1 Pro は K3 の失敗 7 件を訂正し、後退は無し、あるいは 8 件を訂正しつつ以前正答だった 1 件を落とした可能性があります。合計スコアだけでは両者を区別できません。
ペアの回答を精査し、両方正解、K3 のみ正解、K3.1 Pro のみ正解、両方不正解に分類。移行前に、K3 のみ成功したケースが高影響タスクに該当しないか確認。その 42/43 はそのテストセットの記述であり、別ワークロードで 97.7% の成功率を保証しません。
盲検での出力評価
モデルラベルを隠し、出力提示順をランダム化。評価基準は事前に定義:コードは実行テストと回帰チェック、調査は出典、計算、要求された成果物の完全性を確認。まず正確性を採点し、プレゼンや文体は後。
品質評価の記録後に、モデルの正体、レイテンシ、請求コストを開示。これにより、新モデルへの期待と出力品質を切り分けられます。レビュア間の不一致は同一のテストや資料に照らして解決し、後続のモデルやプロンプト変更でも一貫評価できるよう決定を保持。
Kimi K3.1 Pro と Kimi K3 はどこで使える?
公式プロバイダのアクセス
Moonshot のドキュメント化された Kimi K3 API または Kimi K3.1 Pro API を使用して直接統合。選択したエンドポイントのモデル識別子、対応リクエスト項目、アカウント上限を確認。公開 API アクセスとダウンロード可能なモデルウェイトは別のデプロイオプションです。
CometAPI 経由でのアクセス
開発者は Kimi K3.1 Pro API と Kimi K3 API に CometAPI の統一インターフェースでアクセスし、同じアプリケーションワークロードで両ルートを比較可能。
OpenAI 互換のチャットインターフェースをすでに使用しているアプリケーションにとって、K3 から K3.1 Pro への移行は比較的容易です。
CometAPI を利用するには、アカウントと API キーを作成し、統合ドキュメントに従ってエンドポイントとモデル識別子を設定。K3 は kimi-k3、標準の K3.1 Pro は kimi-k3.1-pro、Highspeed ルートは対応環境で kimi-k3.1-pro-highspeed を選択。小さなリクエストから開始し、モデル間で同一ワークロードを比較しつつ、返却結果、レイテンシ、請求使用量を確認。
結論
Kimi K3.1 Pro は、ここで確認した評価において、要求の厳しい自律コーディング、ファイナンス調査、拡張エージェントワークフローにより有力な候補です。Kimi K3 は、即時の自己ホスティングや、既存の精度・レイテンシ特性が要件を満たすワークロードにおいて依然有用です。
代表的タスクと実際のプロバイダルートで選定してください。成功アウトカム、レイテンシ、総支出を比較し、段階的に移行。トークン単価の低下や集計ベンチマークの上昇は出発点として有用ですが、すべてのアプリケーションに最適な構成を保証するものではありません。