Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog プロンプトキャッシュとは? 2026年の OpenAI vs Claude vs Gemini ai-comparisons / CometAPIリサーチ
プロンプトキャッシュとは? 2026年の OpenAI vs Claude vs Gemini 2026年におけるプロンプトキャッシングの仕組みについて学ぶ。OpenAI、Claude、Geminiのキャッシュ方式、TTL、料金、性能、Pythonのサンプル、CometAPIへのアクセスを比較する。
Deon Goodwin AIモデルとAPIの調査チーム 2026年におけるプロンプトキャッシングの仕組みについて学ぶ。OpenAI、Claude、Geminiのキャッシュ方式、TTL、料金、性能、Pythonのサンプル、CometAPIへのアクセスを比較する。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR
プロンプトキャッシュは、同じ入力の再計算を避けるために、言語モデルが既に処理したプロンプトのプレフィックスを再利用できるようにする仕組みです。特にエージェントワークフロー、カスタマーサポート、RAG、大規模ドキュメント分析で、入力トークンのコストを下げ、レイテンシを改善できます。2026 年時点で、OpenAI は自動キャッシュと新しい明示的なキャッシュ制御を提供し、Claude は自動およびブロック単位のキャッシュブレークポイントをサポートし、Gemini は最新モデルでの暗黙的キャッシュを重視しています。プロバイダはキャッシュの書き込み・読み出し・(該当する場合)保管に異なる課金を行います。有効期限切れは再書き込みや入力の全額課金を引き起こす可能性があるため、実際の節約は再利用頻度とキャッシュヒットの実測に依存します。
このガイドは、繰り返し入力を用いるアプリケーションを開発する技術者向けに、GPT-6.1 Sol、Claude Opus 5.5、Gemini 4 Argon のプロンプトキャッシュを比較します。キャッシュ制御、料金、再利用の検証方法に焦点を当てます。
Key Takeaways
プロンプトキャッシュは処理済みの入力を再利用するもので、モデルの以前の回答そのものを再利用するわけではありません。
OpenAI のプロンプトキャッシュは、安定したプレフィックス、サポート対象モデル機能、モデル固有の最小要件と保持設定に依存します。
Claude のプロンプトキャッシュは、デフォルト 5 分と任意の 1 時間 TTL を備え、自動および明示的なキャッシュ制御を提供します。
Gemini のコンテキストキャッシュは、最新モデルでは暗黙的です。明示的なキャッシュリソースはモデル依存で提供されます。
プロンプトキャッシュによる節約は、キャッシュの書き込み、読み出し、保管、および実際のヒット率に依存します。CometAPI を使う場合は、エンドポイントのサポートとキャッシュ済みトークンの課金を確認してください。
明確性、出典の帰属、最新のAPI用語について確認済みです。
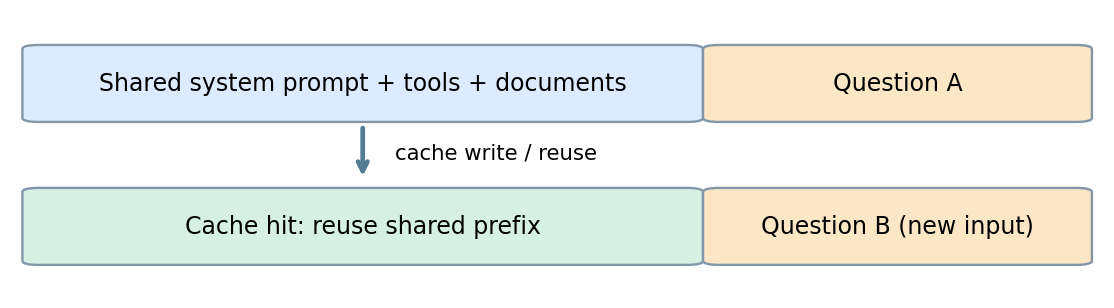
What Is Prompt Caching in LLMs? プロンプトキャッシュは、以前に処理されたプレフィックスから導出された計算状態を再利用できるようにする推論最適化です。プロンプトには、安定した指示、ツール定義、またはドキュメントが含まれ、その後に可変のユーザー質問が続くことがよくあります。後続のリクエストで同一の適格なプレフィックスが繰り返されると、プロバイダはキャッシュされたキー・バリュー(KV)状態を再利用し、未キャッシュ部分のみを処理します。レスポンスキャッシュとは異なり、以前の回答を再生するものではありません。現在のリクエストに対して新しい応答を生成します。
最初のリクエスト: 大きく再利用可能なプレフィックスと特定の質問を送信。
キャッシュ作成: プロバイダが適格な中間計算状態を保存。
次のリクエスト: 同一のプレフィックスを再利用し、質問を差し替え。
キャッシュ読み出し: 既に処理済みのトークンを再利用しつつ、新規トークンは通常どおり処理。
概念図はオリジナル原稿に付属のものです。繰り返されるプロンプト素材の後に可変の質問が続きます。これは公式のプロバイダアーキテクチャ図ではありません。
共通の設計原則はプレフィックスの安定性です。API 契約、対象モデルファミリ、キャッシュ有効期間、料金はプロバイダ間で互換ではありません。
OpenAI, Claude, and Gemini Caching at a Glance 同じ安定プレフィックスの原則は各プロバイダに共通しますが、以下の制御は本ガイドで使用する各モデルに固有です。設定を流用する前に、モデルとエンドポイントの組み合わせを必ず確認してください。
Cache activation 暗黙的マッチング;明示的ブレークポイントをサポート リクエストレベルまたはコンテンツブロックの cache_control でオプトイン 既定で暗黙的キャッシュが有効 Minimum prefix 1,024 可視入力トークン キャッシュ境界前に 512 トークン 4,096 入力トークン Lifetime controls Responses API: prompt_cache_options.ttl;デフォルト 30m または 12h デフォルト 5 分;任意で 1 時間 TTL プロバイダ管理の暗黙的な有効期間 Where to place stable content 先頭の指示、ツール、参照資料 安定したツール定義、システムコンテンツ、またはブレークポイント前のメッセージブロック プロンプト冒頭の大きな共有コンテンツ Usage to inspect input_tokens_details.cached_tokens と報告されるキャッシュ書き込みの使用量 cache_creation_input_tokens と cache_read_input_tokens usage_metadata の cached_content_token_count(存在する場合) Important distinction prompt_cache_key は会計を分離可能だが、Sol の自動ルーティングには必須ではない ブレークポイントは不変のコンテンツの末尾で終える必要がある Argon には明示的キャッシュリソースがない;旧来の対応モデルは別インターフェースを提供
Prompt Caching Controls and Python Examples 各例は、同じ参照資料と 2 つの異なる質問を送信します。共有コンテンツを変更せず、リクエストを連続で実行し、2 回目のリクエストで実際に入力が再利用されたかを使用量で確認してください。
OpenAI: Cache Controls and Python Example OpenAI はキャッシュ適格なプロンプトプレフィックスを自動的にマッチし、対応する新世代モデルでは明示的なブレークポイントと保持期間の設定も可能です。長いシステム指示、ツールスキーマ、リポジトリコンテキストがリクエスト間で繰り返される場合に特に有用です。必要なプレフィックスの長さやトークン価格の係数はモデル世代と選択した保持ティアによって異なります。
この例では Responses API を使用し、prompt_cache_options を暗黙モード、保持期間を 30 分に設定します。旧世代モデルは保持パラメータが異なるため、ご利用の正確なモデルの設定 に従ってください。
openai SDK をインストールし、OPENAI_API_KEY を設定します。安定したプレフィックスには少なくとも 1,024 の可視トークンを使用してください。両方のリクエストを連続実行し、使用量の input_tokens_details.cached_tokens と cache_write_tokens を確認します。キャッシュ済みトークン数が正であれば、課金対象のキャッシュ読み出しが行われたことを示しますが、すべてのリクエストでレイテンシ低減を保証するものではありません。
例を実行するには、対象の Python SDK をインストールし、プロバイダの API キーを設定、そしてそのモデルのキャッシュ最小要件を満たす十分な安定コンテンツを含む UTF-8 の reference.txt を作成してください。
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: Cache Controls and Python Example Claude の Messages API では、プロンプトキャッシュはオプトインです。自動ブレークポイント配置にはリクエストレベルで cache_control を追加し、明示的なブレークポイントにはコンテンツブロックに付与します。開発者は、安定した指示、ドキュメント、選択したプロンプトブロックをマークしつつ、後段のユーザー入力を変更できます。標準の短期キャッシュは 5 分で、適切なワークロード向けに 1 時間のオプションもあります。
anthropic SDK をインストールし、ANTHROPIC_API_KEY を設定します。Claude Opus 5.5 では、キャッシュ境界前に少なくとも 512 トークンを用意してください。システムブロックはすべてのリクエストで同一に保ちます。キャッシュエントリは最初のレスポンス開始時に利用可能になります。この例ではデモを簡単にするため、レスポンスの完了まで待機します。キャッシュ作成と読み出しのカウントを確認してください。短いプレフィックスでは、エラーなしに両方がゼロのまま返ることがあります。
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: Implicit Caching and Python Example Google はこの実装をコンテキストキャッシュと呼びます。Gemini 4 Argon は暗黙的キャッシュを使用し、明示的なキャッシュリソースをサポートしません。一部の旧来モデルファミリでは、TTL を設定可能な明示的キャッシュをサポートします。すべての Gemini モデルが同じ制御を公開していると仮定せず、各モデルの契約に基づいてキャッシュインターフェースを選択してください。
google-genai をインストールし、GEMINI_API_KEY を設定します。Gemini 4 Argon では、先頭の共有コンテンツに少なくとも 4,096 トークンを使用し、2 回目のリクエストは最初の直後に送信します。存在する場合は usage_metadata の cached_content_token_count を確認します。暗黙的キャッシュは、プレフィックスが適格でもヒットしない場合があります。
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
How Much Does Prompt Caching Cost Across OpenAI, Claude, and Gemini? キャッシュコストは、書き込み、読み出し、そして一部の明示的キャッシュシステムにおける保持または保管の組み合わせとして評価すべきです。以下の係数は一般的な設計を例示したものであり、モデルバージョンをまたぐ普遍的な価格を約束するものではありません。
Uncached input 通常の入力トークン単価 通常の入力トークン単価 通常の入力トークン単価 Cache write 新世代モデルで書き込みプレミアムあり 5 分 / 1 時間のプレミアム 暗黙または明示(モデル固有) Cache read モデル固有の割引単価 モデル固有の割引単価 モデル固有の割引単価 Cache lifetime モデル固有 5 分 / 1 時間 暗黙管理 / 明示的に設定可能 Additional storage モデルに依存 通常は書き込みティアに反映 明示的ストレージ料金が発生する場合あり
例示: 10,000 トークンのプレフィックスを N 回再利用し、初回のキャッシュ書き込みが通常入力の 1.25 倍、以降の読み出しが 0.1 倍の単価であるとします。基準入力単価を 100 万トークンあたり $2 とし、最初のリクエスト以外はすべて完璧にキャッシュヒットするものとします。
10 $0.200 $0.043 78.50% 100 $2.000 $0.223 88.85%
計算式: Cached prefix cost = 1.25P + (N − 1) × 0.1P、ここで P は共有プレフィックスを 1 回処理する通常コストです。本例には動的入力、出力、有効期限切れ、ミス、ストレージおよびその他のサービスは含まれていません。
上記の例は読み出し率 10% を例示しており、GPT-6.1 Sol の現在の単価ではありません。Sol の標準短コンテキストの料金 は、未キャッシュ入力が 100 万トークンあたり $2、キャッシュ済み入力が $0.10、デフォルトの保持での書き込みが $2.50 です。実際のモデル、ティア、エンドポイントの請求に基づいて再計算してください。
より長い保持期間は、再書き込みや未キャッシュリクエストを十分に防いでその価格差を相殺できる場合にのみ有益です。Claude の 5 分および 1 時間の書き込みは、それぞれ通常入力の 1.25 倍と 2 倍で課金されます。旧来の対応モデルでの Gemini の明示的キャッシュも、ストレージ料金が発生する場合があります。短時間の連続呼び出しだけでなく、実際のアイドル間隔を挟んだ再利用で測定してください。
ミス、有効期限切れ、出力生成も請求の一部として扱ってください。プレフィックスが再利用される前に期限切れになった場合、次のリクエストでは再書き込みや入力の全額処理が必要になる可能性があります。短いプロンプトは適格でない場合があり、長い回答は強いキャッシュ再利用があっても最大のコスト要因になり得ます。キャッシュの複雑化を進める前に、完了タスクあたりの総コストを比較してください。
Which Prompt Caching API Is Best for Different Workloads?
コーディングエージェントやカスタマーサポートには、安定したツール定義、リポジトリコンテキスト、ポリシー、ナレッジを、可変のタスクより前に配置してください。OpenAI と Claude は再利用境界を定義するのに役立つブレークポイント制御を提供します。繰り返しのテキストがキャッシュされたと仮定せず、エンドポイントの実際のキャッシュ読み出しを評価してください。
ドキュメント分析やマルチモーダル作業には、ソースドキュメントやサポート対象のメディアを質問より前に置いてください。Gemini の暗黙的アプローチはキャッシュ管理作業を軽減し、Claude は安定ブロックを直接マークできます。再利用に頼る前に、対象メディアタイプとモデルのサポートを確認してください。
長い会話では、冒頭を書き直すのではなく新しいターンを末尾に追加し、ターン間の間隔に合う有効期間を選択してください。明示的に作成して参照できる名前付きキャッシュリソースが必要なアプリケーションでは、そのインターフェースをサポートする Gemini モデルを評価してください。Argon は対応しません。
万能の勝者は存在しません。実際のトラフィックパターン下で、キャッシュヒット率、完了タスクあたりのコスト、レイテンシを比較してください。
キャッシュヒットは、繰り返し入力の処理を減らし、最初のトークンまでの時間を短縮する可能性があります。回答品質を本質的に向上させたり、出力生成を高速化したりはしません。また、キャッシュされた入力もコンテキストウィンドウを占有します。同等のリクエストで、最初のトークンまでのレイテンシと総応答時間の両方を測定してください。キャッシュヒットだけでは、ユーザーが最終回答を早く受け取った証拠にはなりません。
How to Optimize Prompt Caching and Troubleshoot Misses
Start with a Stable, Useful Prefix 再利用可能な指示、ツール定義、ポリシー、ドキュメントを先頭に置き、タイムスタンプ、リクエスト ID、変化するコンテキスト、ユーザーの質問はその後に配置してください。ツールの順序やスキーマを安定させます。明示的キャッシュを使う場合は、ブレークポイントを最後の不変ブロックの末尾に置きます。タスクに役立つ場合は参照資料を追加し、キャッシュ指標だけを追うために各リクエストを膨らませないでください。
If Cached Tokens Stay at Zero プロンプトを変える前に適格性を確認します。具体的には、モデル、エンドポイント、最小トークン長、必要なキャッシュ制御設定です。そのうえで、共有コンテンツが同一の 2 つの連続リクエストを送信します。キャッシュ作成と読み出しを個別に確認してください。最初のリクエストが、後続リクエストで再利用できるエントリを作成する場合があります。暗黙的キャッシュはヒットの可能性があるだけで、保証ではありません。
Claude では、最小要件未満のリクエストは、エラーなくキャッシュ作成と読み出しのトークン数がゼロで返ることがあります。キャッシュエントリは最初のレスポンスが開始されると利用可能になります。Claude のキャッシュガイド は、ブレークポイント配置やリクエスト設定の変更が再利用に与える影響も説明しています。
If Hits Disappear Between Requests プロンプトテンプレートだけでなく、実際のペイロードを比較してください。ドキュメント本文の変更、ツールの順序変更、スキーマ変更、会話冒頭ターンの書き換え、再利用境界より前に挿入された動的フィールドなどを確認します。前回リクエストからの経過時間と、選択した有効期間がそれをカバーしているかを確認してください。変数は一度に 1 つずつ変更し、使用量の結果を記録します。
If Hits Do Not Produce Savings キャッシュ済み入力、書き込み、未キャッシュ入力、出力、ストレージ料を切り分けて評価します。アイドル後の再書き込み、低い再利用率、長い生成回答は、入力割引を打ち消す可能性があります。上記のコスト計算を、実測の使用量とエンドポイントの実際の課金率で適用してください。総タスクコストまたはユーザー視点のレイテンシを改善する場合にのみ最適化を維持します。
Check Endpoint Support and Data Boundaries 互換性エンドポイントは、ネイティブ API と同じキャッシュ制御や使用量フィールドを公開せずともリクエストを受け付ける場合があります。パラメータのサポートを確認し、再利用を節約と見なす前に、返却された使用量とアカウント請求を比較してください。テナント分離とアクセス制御を維持し、プロバイダの保持・データ処理ポリシーに従ってください。キャッシュはそれらのコントロールの代替にはなりません。
CometAPI は、モデルファミリを横断するリクエストのテストを単一点で行える統合を提供します。キャッシュについては、選択したエンドポイントがどのプロバイダ固有の制御を受け付けるか、キャッシュ済み入力が使用量や請求にどう現れるかを確認してください。プロキシや互換エンドポイントでは、ネイティブプロバイダのオプションが同一である保証はないため、モデルのテストを一元化しつつも、キャッシュ動作と会計は個別に検証できます。
openai SDK をインストールし、COMETAPI_KEY を設定します。次の例は、CometAPI の OpenAI 互換 Chat Completions インターフェース経由で、プレフィックスを繰り返すリクエストを送信します。モデルの利用可否を確認し、返却された使用量とアカウント請求を検査して、キャッシュ再利用の証拠を確認してください。Responses API のキャッシュパラメータを、このエンドポイントに確認なくコピーしないでください。
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Conclusion 繰り返しの多い AI アプリケーションでは、プロンプトキャッシュが推論コストに実質的な差を生むことがあります。OpenAI はプロンプトと保持の制御をより詳細に提供し、Claude は自動とブロックレベルの便利な制御を提供し、Gemini は最新モデルでの暗黙的な再利用を簡便にします。最適な実装は、安定したプロンプト量、ヒット率、有効期限、総コストに依存します。まず明確な共有プレフィックスを用意し、使用量のテレメトリで検証し、その後に保持期間とプロバイダ選定を本番に近い測定で最適化してください。
FAQ
How can I compare caching providers fairly? 同じ有用なソースドキュメントと同等の質問を再生しつつ、各プロバイダ固有のトークンカウントと実際の課金率を使用してください。出力要件を同程度に保ち、成功したリクエストだけでなく失敗したリクエストも報告します。一定文字数でもトークン数は一致しない場合があるため、キャッシュヒット測定に加えて、完了タスクあたりのコストで比較してください。
Should I cache every document in a changing knowledge base? ドキュメントを、変更頻度と再利用頻度でグルーピングしてください。頻繁に更新されるドキュメントは大きな共有プレフィックスを繰り返し無効化し得ます。安定したポリシー素材を先頭に、変化する素材を後段に置くことで、その影響を抑えられます。ソース資料には意図的にバージョンを付し、正確性が必要なときには、キャッシュ再利用が減っても更新してください。