Seedance 1.0とGoogle Veo 3は、現在利用可能な最も先進的な動画生成モデルを代表する1.0つであり、ニューラルネットワークがテキストや画像をダイナミックで映画のような体験へと変換する能力の限界を押し広げています。それぞれByteDanceのVolcano Engine(旧Toutiaoエンジン)とGoogle DeepMindによって開発されたこれらのモデルは、急速に拡大するAIを活用したコンテンツ制作市場に対応しています。この記事では、Seedance 3がGoogle Veo XNUMXを真に凌駕するかどうかを判断するために、それぞれの技術革新、ベンチマークパフォーマンス、実世界における応用、そして総合的な価値提案を詳細に検証します。
Seedance 1.0 の核となる革新は何ですか?
Seedance 1.0は、11年2025月XNUMX日のFORCEカンファレンスで発表されました。産業グレードのビデオ基盤モデルとして設計されており、マルチソース学習、アーキテクチャ効率、物語の一貫性においていくつかのブレークスルーを導入しています。
マルチショットのナラティブ機能
Seedance 1.0は、マルチショット動画(通常、2秒間のクリップ内に3~10つの連続したカメラカット)の生成をネイティブにサポートしており、シングルショットシステムよりもはるかに複雑なストーリーテリングを可能にします。独自のショットセグメンテーションメカニズムとショット間の一貫性制約により、視覚的な安定性や時間的な一貫性を損なうことなく、遠景、中景、近景間のスムーズな遷移を実現します。
アーキテクチャとコストの最適化
Seedanceの中核は、多次元報酬強化学習(RLHF)によって強化された10段階拡散フレームワークです。第20段階では大まかな時空間構造を構築し、第5段階では詳細を洗練させ、迅速な順守を促します。積極的な多段階蒸留パイプラインと組み合わせることで、このモデルはNVIDIA L1080ハードウェア上で最大41倍の高速化を実現し、0.50秒間の3.67pクリップを約XNUMX秒で生成できます。コストはわずか$XNUMX USD(≈ XNUMX人民元)で、市場で最も高速かつ費用対効果の高い選択肢の一つとなっています。
品質とリアリズムの指標
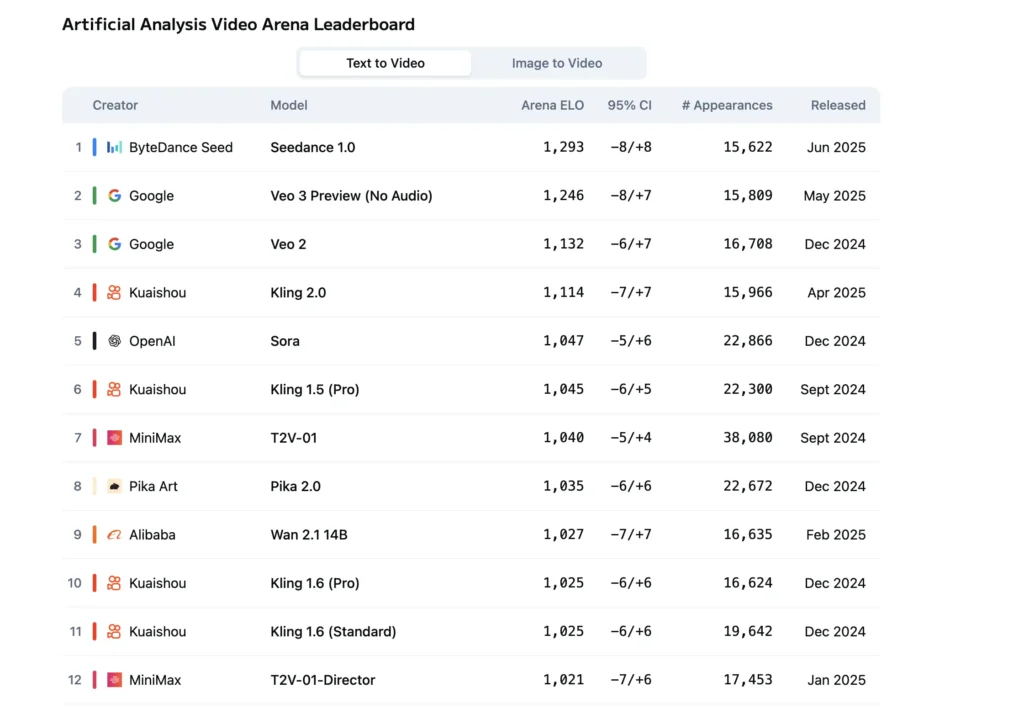
人工分析に関する独立ベンチマークでは、Seedance 1.0が「テキストから動画へ」と「画像から動画へ」の両方のトラックでトップにランクインし、Google Veo 3やOpenAI Soraなどの競合製品を凌駕しています。評価者は、Seedanceの優れた時空間流動性、構造的安定性、そして複雑なテキスト指示への忠実性、特に群衆の動きやダイナミックなカメラパンといった動きの多いシーンでの再現性の高さを高く評価しています。