

TL;DR
Gemini 4 Carbon は、要求の厳しいエンジニアリングと防御的サイバーセキュリティ向けの Google DeepMind の最前線モデルです。 2026年10月28日に発表され、公開済みのコーディング、セキュリティ、長文脈評価で Argon を上回りました。導入価格は入力100万トークンあたり$2、出力100万トークンあたり$10ですが、当初のアクセスは選定されたサイバー防御担当者と信頼できるパートナーに限定されます。開発者にとっての機会は、より強力な自律的作業であり、当面の制約はアクセスです。
Key Takeaways
- Gemini 4 Carbon は Argon に続く Google の次のフロンティアモデルで、複数日にわたる自律エージェント型エンジニアリングとサイバーセキュリティ防御に最適化。
- Gemini 4 Carbon は Artificial Analysis Intelligence Index v5.0 で第1位(スコア59)。Claude Opus 5.5(58)や GPT-6 Astra(57)を上回る。コーディング、フルスタック Web 開発(WebDev Arena で +89 Elo、4位)、科学的推論、マルチモーダル理解、アライメント(Gray Swan Indirect Prompt Injection Benchmark で成功率0.0%)で顕著な伸び。
- サイバーセキュリティのスコア(ガードレールなし):SEC-bench Pro(脆弱性の発見)で88.2%、ExploitGym(悪用)で54.8%、CWE-bench(修正)で71.0%。
- 初期アクセスはサイバー防御担当者向けの Fairwind Program を通じて限定的。パブリック API と広範なロールアウトは後日。
- 導入価格は Argon と同じ。導入期間終了後は標準料金が適用。
- CometAPI などのプラットフォームは、統一された OpenAI 互換 API で Gemini ファミリー(Argon を含む)をすでにサポートしており、モデルの切り替えや Carbon の広範な提供に向けた準備が容易。パブリック API の詳細と広範なリリース日は2026年10月29日時点では未発表。
What Is Gemini 4 Carbon?
Gemini 4 Carbon は、複雑なソフトウェアエンジニアリング、サイバーセキュリティ研究、自律ワークフローを扱えるように設計された Google の最新フラッグシップ級フロンティア AI モデルです。
公式発表によると、Carbon は Gemini 4 Argon の基盤の上に構築され、コーディング、エージェント的推論、セキュリティ重視のタスクで大幅に強化されています。
Carbon は、複数ステップにわたり調査・実行・検証を行う作業のために設計されています。防御的エンジニアリングのエージェントであれば、リポジトリを調査し、隔離環境で疑わしい脆弱性を検証し、パッチを作成し、変更によって元の不具合が解消されたかをテストすることが考えられます。
Google は、社内チームが Carbon を用いて複数日にわたる複雑なエンジニアリングタスクに取り組む様子を観測したと報告しています。これは社内観測であり、特定の自律稼働時間を保証するものではありません。Google は完全な技術レポート、パラメータ数、詳細なアーキテクチャ情報を公開していません。コンテキストウィンドウや出力上限は Argon と同等またはそれ以上(数百万トークン級の高い出力能力と報告)と見込まれ、テキスト、画像、動画、音声、PDF を含むマルチモーダル入力をサポートします。
What Are the Key Features of Gemini 4 Carbon?
長期スパンのソフトウェアエンジニアリング
Carbon は、単一の推論ステップでは確実に完了できないエンジニアリング課題向けに設計されています。
例として、大規模リポジトリにまたがる根本原因分析、依存関係に起因する障害、低レベルのシステムデバッグ、複雑なリファクタリングなどがあります。
改善点は、最初の試行が不成功に終わった後も作業を継続できる能力を狙っています。
有能なコーディングエージェントは、最初の解法が失敗したときにそれを認識し、新しい証拠を検証し、元のタスクから逸脱せずにアプローチを見直す必要があります。
防御的サイバーセキュリティのワークフロー
Carbon のセキュリティ結果は、脆弱性の発見、悪用可能性の検証、不具合の修正にまたがります。セキュリティチームにとって重要なのは、エージェントが疑わしい問題から再現可能な発見とテスト済みの修正へと進み、割り当てられた権限と環境を遵守できるかどうかです。
長文脈およびマルチモーダル理解
Carbon は、256K〜1M トークンの GraphWalks BFS F1 サブセットで 96.2% を記録し、Argon の 84.2% から向上しました。これは長文脈のグラフ推論に関するエビデンスであり、任意の100万トークン文書からの正確な検索を保証するものではありません。
公開された Chartography や Blueprint-Bench 2 の結果は視覚的理解もカバーしています。これらのテストは有望な文書・チャートワークフローの特定に役立ちますが、将来のパブリック API における完全なモダリティスキーマを確立するものではありません。
How Does Gemini 4 Carbon Perform on Benchmarks?
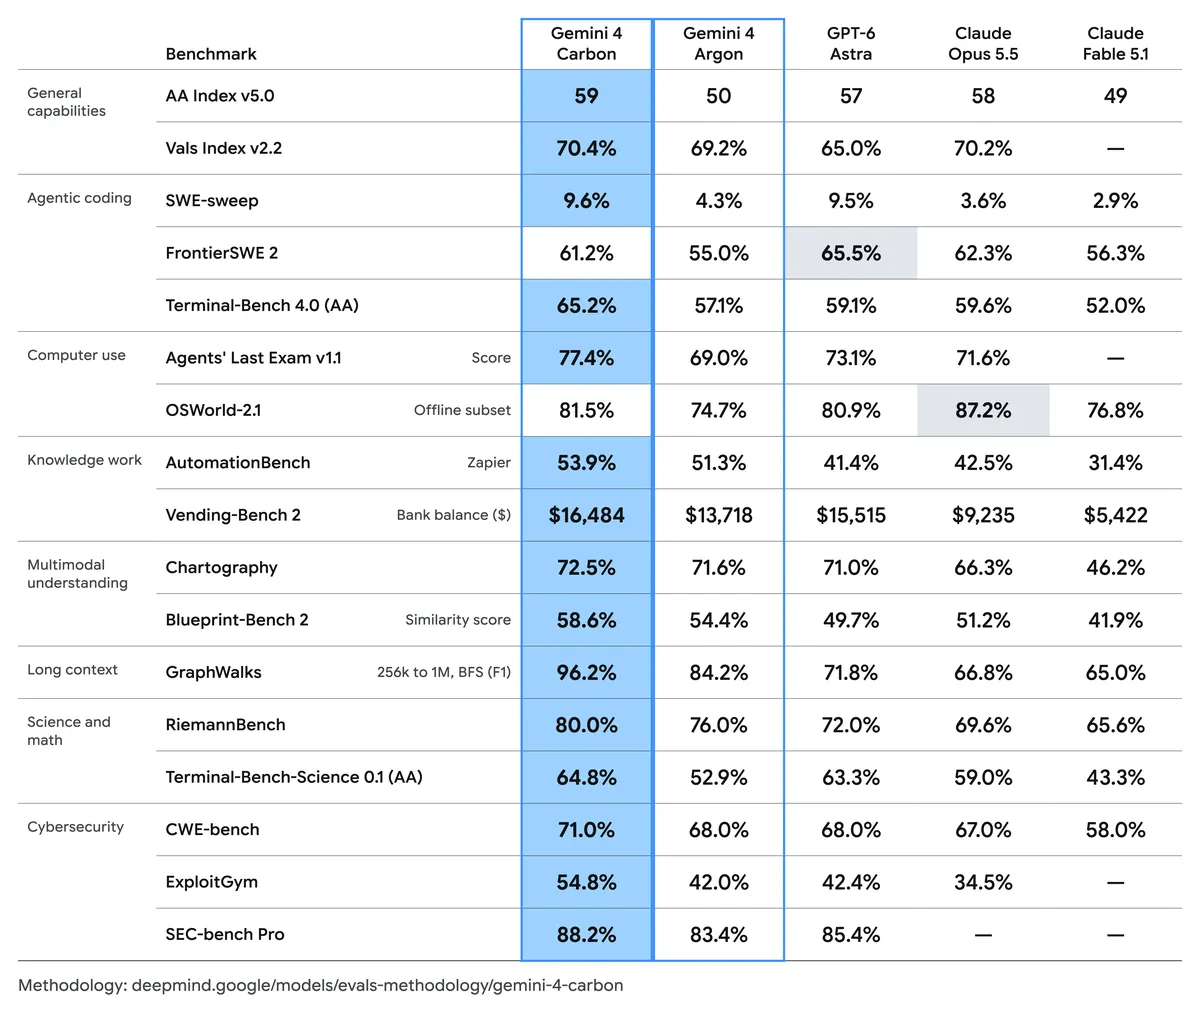
公開結果は、Carbon を評価すべき三つの理由――コーディング性能の強化、長文脈推論の改善、サイバーセキュリティワークフロー全体での向上――を強調しています。公式発表には以下の元の比較チャートが含まれています。主な結果は次のセクションに要約します。
自分のワークロードに近いベンチマークを選びましょう。一般知能指数でトップのモデルでも、特定のエンジニアリングタスクでは別のモデルに劣る場合があります。
Benchmark Results and Test Conditions
総合的な推論: Carbon は AA Intelligence Index v5.0 で 59。Argon は 50、GPT-6 Astra は 57、Claude Opus 5.5 は 58。
コーディング: Terminal-Bench 4.0 は 57.1% から 65.2% に上昇し、Argon 比で 8.1 ポイントの改善。SWE-sweep は 4.3% から 9.6% に増加。
長文脈推論: Carbon は GraphWalks の 256K〜1M トークン BFS F1 サブセットで 96.2%、Argon の 84.2% から向上。
他がリードする領域: GPT-6 Astra は FrontierSWE 2 で 65.5%、Carbon は 61.2%。Claude Opus 5.5 は OSWorld のオフラインサブセットで 87.2%、Carbon は 81.5%。これらは公開チャートのモデルと評価設定に基づく比較です。
元の比較における選定 17 結果のうち、Carbon は 15 でリードしています。幅広い優位性は複雑なワークフローに有望ですが、2 つの例外が示すとおり、タスク構成は重要です。無関係なベンチマークスコアの平均ではなく、合格結果、完了時間、コストでモデルを比較してください。
evaluation methodology は、特記なき限り最大の思考設定と pass@1 を用います。Google 実施の結果に外部評価者やプロバイダー報告のスコアを組み合わせており、エージェントのスキャフォールディングや思考予算はすべての項目で同一ではありません。
- GraphWalks: 引用のサブセットは 200 問題を用い、BFS F1 を報告。
- Agents’ Last Exam: 評価は 122 タスクの v1.1 セット、ALE-Claw ハーネス、5 時間のウィンドウ、安全フィルタ有効。
- OSWorld: 報告値は 82 タスクのオフラインサブセットで、単一試行の 3 回における最大値を使用。
Coding Performance in Practice
Carbon は Terminal-Bench 4.0 を 57.1% から 65.2% に 8.1 ポイント改善。SWE-sweep は 4.3% から 9.6% に上昇し、絶対値は 10% 未満ながらスコアを倍以上に伸ばしました。これらは難易度の高いリポジトリ作業の評価を後押しする一方で、独立したテストとレビューが依然として必要である理由も示しています。
How Strong Is Gemini 4 Carbon at Cybersecurity?
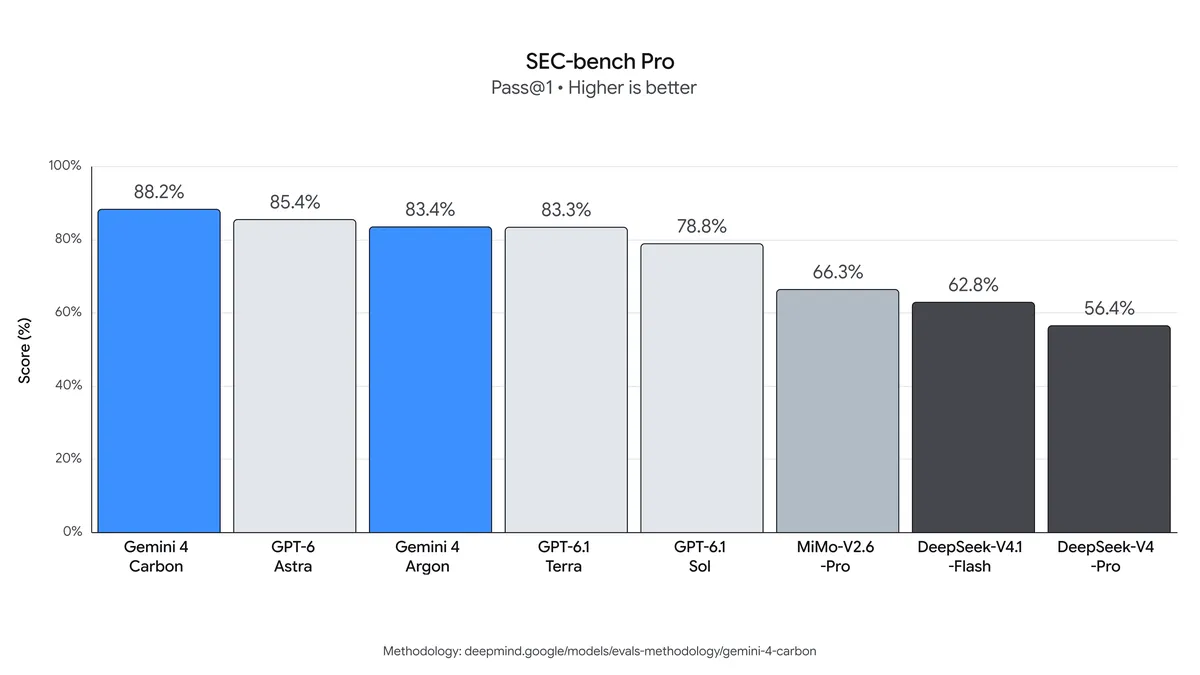
最大の伸びは悪用の検証にあります。認可された防御チームにとって、脆弱性が悪用可能であることの再現可能な証拠は優先順位付けを改善します。もっともらしい指摘だけでは不十分です。パッチには、元の欠陥が修正され、既存機能が維持されていることを確認するテストが依然として必要です。
Google は、デプロイ時のガードレールなしで外部のセキュリティ評価を報告しています。SEC-bench Pro は特定の 183 タスクの JavaScript エンジンスプリットを使用し、ExploitGym は緩和策オフの単一試行オフライン設定を使用します。これらの条件は、無制限の本番挙動や任意の実ソフトウェアに対する検出率を確立するものではありません。
Is Gemini 4 Carbon Safer and More Reliable Than Argon?
Google の報告された信頼性の所見は複数の評価をカバーしています。
- 社内テストで、裏付けのない主張は Argon 比で約 50% 減少。
- エージェントの越権は 26% 減少。
- 過少対応は 29% 減少。
- 社内のコーディング環境で、高重大度のアライメント逸脱アラートは約 80% 減少。
- Terminal-Bench 4.0 における不正行為の成功は Google の評価で 0.0% に低下。
評価された Gray Swan 間接プロンプトインジェクションベンチマークでは、Carbon の攻撃成功率は 0.0%、Argon は 0.7%。これは当該セットアップで攻撃が成功しなかったことを意味しますが、新たな攻撃や異なるツール環境への免疫を示すものではありません。
これらの数値は異なる評価に由来し、単一の信頼性スコアに統合すべきではありません。
本番エージェントでは、独立した権限チェック、実行ログ、主張結果の検証を維持してください。モデルの改善は有益ですが、アプリケーション側でファイル・サービス・操作のアクセス範囲を管理する必要があります。
How Much Does the Gemini 4 Carbon API Cost?
Google は Carbon の導入時および以降のトークン料金を発表しました。以下のキャッシュ入力の数値は発表された 95% 割引から計算したものです。パブリック API の実装および適用条件の詳細は未定です。
| 課金区分(USD/100万トークン) | 導入価格 | 以降の料金 |
|---|---|---|
| 入力トークン | $2.00 | $4.00 |
Carbon の導入期間の終了日は未発表です。Argon の公開された導入価格は 2026年11月30日 に終了しますが、その締切を Carbon に適用すべきではありません。バッチ料金、追加ツール料金、フリーティアは Carbon について未発表です。
Example Request Cost
リクエストで 200,000 の未キャッシュ入力トークンと 10,000 の課金対象出力トークンを使用すると仮定します。発表された導入単価では、入力が $0.40、出力が $0.10、合計 $0.50。同じトークン使用量でも以降の料金では $1.00 になります。
20万の入力トークンがすべて発表のキャッシュ入力割引の対象である場合、導入期の見積もりは出力込みで $0.12 になります。これは条件付きの例示であり、すべての繰り返し入力が割引対象になることを約束するものではありません。
出力の割当は、最終的な適用規則の下で出力として課金される思考トークンを含める必要があります。もし 10,000 が可視の回答のみを指す場合、追加の課金対象の思考トークンによって見積もりは増加します。ツール、リトライ、その他のサービスは除外です。
How Can Developers Prepare for the Gemini 4 Carbon API?
Current Gemini 4 Carbon API Availability
2026年10月29日時点では、選定されたサイバーセキュリティ防御担当者からアクセスが開始され、信頼できるパートナーへ段階的に拡大します。Google の Fairwind Program は管理されたアクセス経路を説明しています。広範な開発者向けリリース日や、パブリックな Carbon のモデル識別子は未発表です。
したがって、価格が発表されていても、現時点で一般公開された Carbon API をアプリケーションが呼び出せるとは限りません。最終的なパブリックのコンテキスト上限、最大出力、モダリティスキーマ、ツール互換性、運用上の制限には、本番仕様のドキュメントが必要です。
2026年10月29日時点で、Google は一般提供の Carbon API をまだ開始していないため、Carbon は CometAPI からも未提供です。公開を待つ間は、初期評価として Gemini 4 Argon を利用できます。アクセスが開く際には CometAPI Carbon page で提供状況とプロバイダー料金を確認してください。
Alternatives While You Wait for the Carbon API
Carbon の広範な提供の前に、コーディングワークフローの評価を開始できます。今日アクセス可能なモデルでベースラインを作り、API 公開後に同じタスクで Carbon を比較しましょう。検討対象として Gemini 4 Argon、GPT-6.1 Astra、Claude Opus 5.5 の三つがあります。選定前に、正確なモデル名、アクセス、価格をプロバイダーで確認してください。
Gemini 4 Argon: すでに Gemini を使用している、または Carbon の直接的なベースラインを取りたい場合の出発点。代表的なリポジトリ変更、コードレビュー、バグ修正を試し、どの出力が受け入れテストを通過したかを記録しましょう。
**GPT-6.1 Astra:** 同一のエンジニアリングタスクでプロバイダー横断の比較として含めます。受け入れられた修正、完了時間、総コストを測定しましょう。前述の GPT-6 Astra の結果は評価対象のそのバージョンに適用され、GPT-6.1 Astra のスコアと見なすべきではありません。
**Claude Opus 5.5:** リポジトリ分析、リファクタリング、レビューの別候補として追加します。同じタスク記述と検証基準を使い、各結果の実用価値を比較できるようにします。
モデル選択を設定可能に保ち、各実行のプロンプト、テストケース、結果を保存してください。これにより、未発表の API 形式にワークフローを固定することなく、Carbon 評価の有用な出発点が得られます。
Prepare a Model Evaluation Workflow
実践的な評価フレームワークは、一般的な回答品質以上の指標を測定すべきです。
コーディングとセキュリティのワークフローでは、以下の指標が有用です。
- タスク完了率: エージェントはどの程度の頻度で事前定義の受け入れテストを満たすか。
- パッチの正しさ: 提案された変更は、元の欠陥を既存の挙動を壊すことなく解決するか。
- 偽陽性率: 報告された問題が検証で失敗する頻度。
- エンドツーエンド遅延: ツール実行を含むワークフロー全体の所要時間。
- タスク総コスト: リトライやツール使用後に各合格結果にかかった総費用。
- 指示遵守: エージェントは許可されたファイル、ツール、操作の範囲内に留まっているか。
固定された実タスク集合を用い、各モデル、設定、トークン使用量、テスト結果を記録してください。コストにはリトライや手動修正も含めます。Carbon が利用可能になったら、同じ評価を実施し、時間と予算に対してどれだけ多くの合格作業を提供できるかを確認しましょう。
Conclusion
Gemini 4 Carbon は、要求の厳しいコーディング、長文脈推論、防御的セキュリティ作業における有望なアップグレードです。公開結果は Argon に対する明確な向上を示す一方で、2026年10月29日時点ではアクセスが限定的です。現時点では、利用可能なモデルでベースラインを確立し、統合を柔軟に保ちましょう。Carbon のパブリック API が開いたら、完了した作業の質、節約できた時間、総コストを比較し、切り替えの是非を判断してください。
FAQ
Gemini 4 Carbon は人間の監督なしで動作できますか?
複数日にわたる社内エンジニアリング作業の報告は、任意のタスクにおける無人運用の信頼性を確立するものではありません。自律実行を検討するチームは、許可されたアクション、停止条件、受け入れテストを定義し、エージェントが修正なしで作業をどの程度完了できるかを測定すべきです。稼働時間だけでは出力の正しさは示されません。
既存の Argon 統合をそのまま Carbon に切り替えられますか?
ここで得られる証拠だけでは断定できません。プロバイダー選定は設定可能に保ちつつ、切り替え前に Carbon の実際のモデル識別子、サポートスキーマ、ツール、制限、アカウントアクセスを検証してください。プロンプトの再利用は、統制された比較には役立ちますが、API 互換性を保証するものではありません。
プライベートなコードベースではどのテストが重要ですか?
代表的なバグ、リポジトリ変更、既知の受け入れ基準を持つセキュリティ発見を含めてください。パッチが関連テストに合格するか、発見が再現するか、無関係な挙動変更がないかを確認します。コスト分析には失敗した試行や手動修正も含め、強い公開ベンチマークスコアが運用上の作業量を覆い隠さないようにしてください。