Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog 「GLM-5.1」が指す対象は文脈によって異なります。どれについてお尋ねでしょうか?
- Zhipu AI(清華系)の大規模言語モデル GLM シリーズのバージョン
- 統計学の一般化線形モデル(Generalized Linear Model; GLM)関連(例:ソフトウェアや教科書の版)
- C++ の数値計算ライブラリ glm(OpenGL Mathematics)のバージョン
- その他の製品名・規格名
該当する分野や出典をもう少し教えていただけると、正確に説明できます。 technology / CometAPIリサーチ
「GLM-5.1」が指す対象は文脈によって異なります。どれについてお尋ねでしょうか?
- Zhipu AI(清華系)の大規模言語モデル GLM シリーズのバージョン
- 統計学の一般化線形モデル(Generalized Linear Model; GLM)関連(例:ソフトウェアや教科書の版)
- C++ の数値計算ライブラリ glm(OpenGL Mathematics)のバージョン
- その他の製品名・規格名
該当する分野や出典をもう少し教えていただけると、正確に説明できます。 GLM-5.1 は、Z.ai(旧 Zhipu AI)の次世代オープンソース旗艦大規模言語モデルで、2026年4月7日にリリースされました。エージェント指向のエンジニアリングと長期的なタスク向けに設計され、SWE-Bench Pro において最先端の性能(スコア 58.4)を発揮し、オープンソースモデルの中でトップを走り、主要なコーディングベンチマーク全体で世界 #3 にランクイン、独立評価では Claude Opus 4.6 のコーディング性能の 94.6% を達成しました(45.3 vs. 47.9)。600+ 回のイテレーションおよび 8+ 時間の自律実行にわたり生産的な最適化を維持でき、GLM-5 を大きく超える一方で、西側のフロンティアモデルと比べて大幅に低コストです。
GLM-5.1 は、Z.ai(旧 Zhipu AI)の次世代オープンソース旗艦大規模言語モデルで、2026年4月7日にリリースされました。エージェント指向のエンジニアリングと長期的なタスク向けに設計され、SWE-Bench Pro において最先端の性能(スコア 58.4)を発揮し、オープンソースモデルの中でトップを走り、主要なコーディングベンチマーク全体で世界 #3 にランクイン、独立評価では Claude Opus 4.6 のコーディング性能の 94.6% を達成しました(45.3 vs. 47.9)。600+ 回のイテレーションおよび 8+ 時間の自律実行にわたり生産的な最適化を維持でき、GLM-5 を大きく超える一方で、西側のフロンティアモデルと比べて大幅に低コストです。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)GLM-5.1 は AI の状況における重要な転換点を示します。中国の AI 企業が先端能力をオープンソース化しつつ商用化を加速する中、このモデルは OpenAI の GPT-5.4、Anthropic の Claude Opus 4.6、Google の Gemini 3.1 Pro といったプロプライエタリのリーダーとの差を、とりわけ実世界のソフトウェアエンジニアリングで縮めています。GLM-5 と同じ 744B パラメータの MoE アーキテクチャで訓練されつつ、エージェント型ワークフローに大幅最適化されており、計画、試行、デバッグ、自己修正を数千回のツール呼び出しにわたって要する、長大かつ曖昧で反復的なタスクで多くの LLM がつまずく場面に強みを発揮します。
現在、CometAPI は GLM-5.1 と GLM-5 を統合しており、開発者は他の主要な西側モデルも確認し、非常に低い API 価格でアクセスできます(これは他の競合と比べた CometAPI の優位点でもあります)。
What is GLM-5.1?
GLM-5.1 は Z.ai による最新のフラッグシップ言語モデルで、長期ホライズンのエージェント型ソフトウェア作業への最新の取り組みです。Z.ai 自身の言葉では、ワンショット応答ではなく継続的な実行を必要とするタスク向けに設計され、1 回の拡張実行の中で計画・実行・洗練・成果の提示まで行えるモデルとして位置づけられています。リリースノートによれば、GLM-5.1 はマルチターンの教師あり微調整、強化学習、プロセス品質評価フレームワークで構築され、長時間のタスクにおける安定性、一貫性、ツール使用を改善しています。
この位置づけは重要です。GLM-5.1 は単なる「別のチャットモデル」として売られているわけではありません。目標を保持し、中間ステップを扱い、脈絡を失わずに誤りから復帰することが求められるエンジニアリングのワークフローを狙っており、自律的計画、持続的実行、バグ修正、戦略の反復を担うモデルとして提示されています。これはカジュアルなアシスタントや短文脈のコーディングコパイロットとはまったく異なる製品ストーリーです。
明確性、出典の帰属、最新のAPI用語について確認済みです。
実用的なディテールとして、GLM-5.1 はテキスト専用で、GLM Coding Plan によりサポートされ、Claude Code や OpenClaw といった人気のコーディングエージェントで利用できます。既存の開発者ワークフローの中にモデルを組み込めることから、置き換えではなく統合を望むチームにとりわけ有用です。
Core Technical Specifications (Inherited and Refined from GLM-5):
Architecture : Mixture-of-Experts (MoE)、総計 7440 億パラメータ、推論あたりアクティブ約 400 億パラメータContext Window : 203K–204.8K トークン(最大 131K の出力トークンをサポート)Key Enhancements : 長文脈処理の効率化と展開コスト削減のための DeepSeek Sparse Attention (DSA)、より効果的な事後訓練のための先進的な非同期強化学習基盤(Z.ai の “slime” フレームワーク経由)Availability : オープンウェイト(Hugging Face 上の zai-org/GLM-5.1 に MIT ライセンス)、Z.ai プラットフォームおよび CometAPI などのアグリゲーター経由の API アクセス、GLM Coding Plan ツールへの統合(Claude Code / OpenClaw 互換) 従来の GLM が汎用知能や短期の “vibe coding” に焦点を当てていたのとは異なり、GLM-5.1 はプロダクションレベルの自律エージェント をターゲットにしています。人手を介さずに何時間にもわたり複雑なエンジニアリングプロジェクトの計画、実行、ベンチマーク、デバッグ、反復を独立して行えるため、Anthropic や OpenAI の専用コーディングエージェントに対する直接の競合候補となります。
このリリースは約 10% の API 価格改定(入力トークン 約 $0.54/M、出力 約 $4.40/M)と同時期でしたが、Anthropic の Opus 4.6(250–470% 高価)などの同等品に比べれば依然として大幅に安価です。
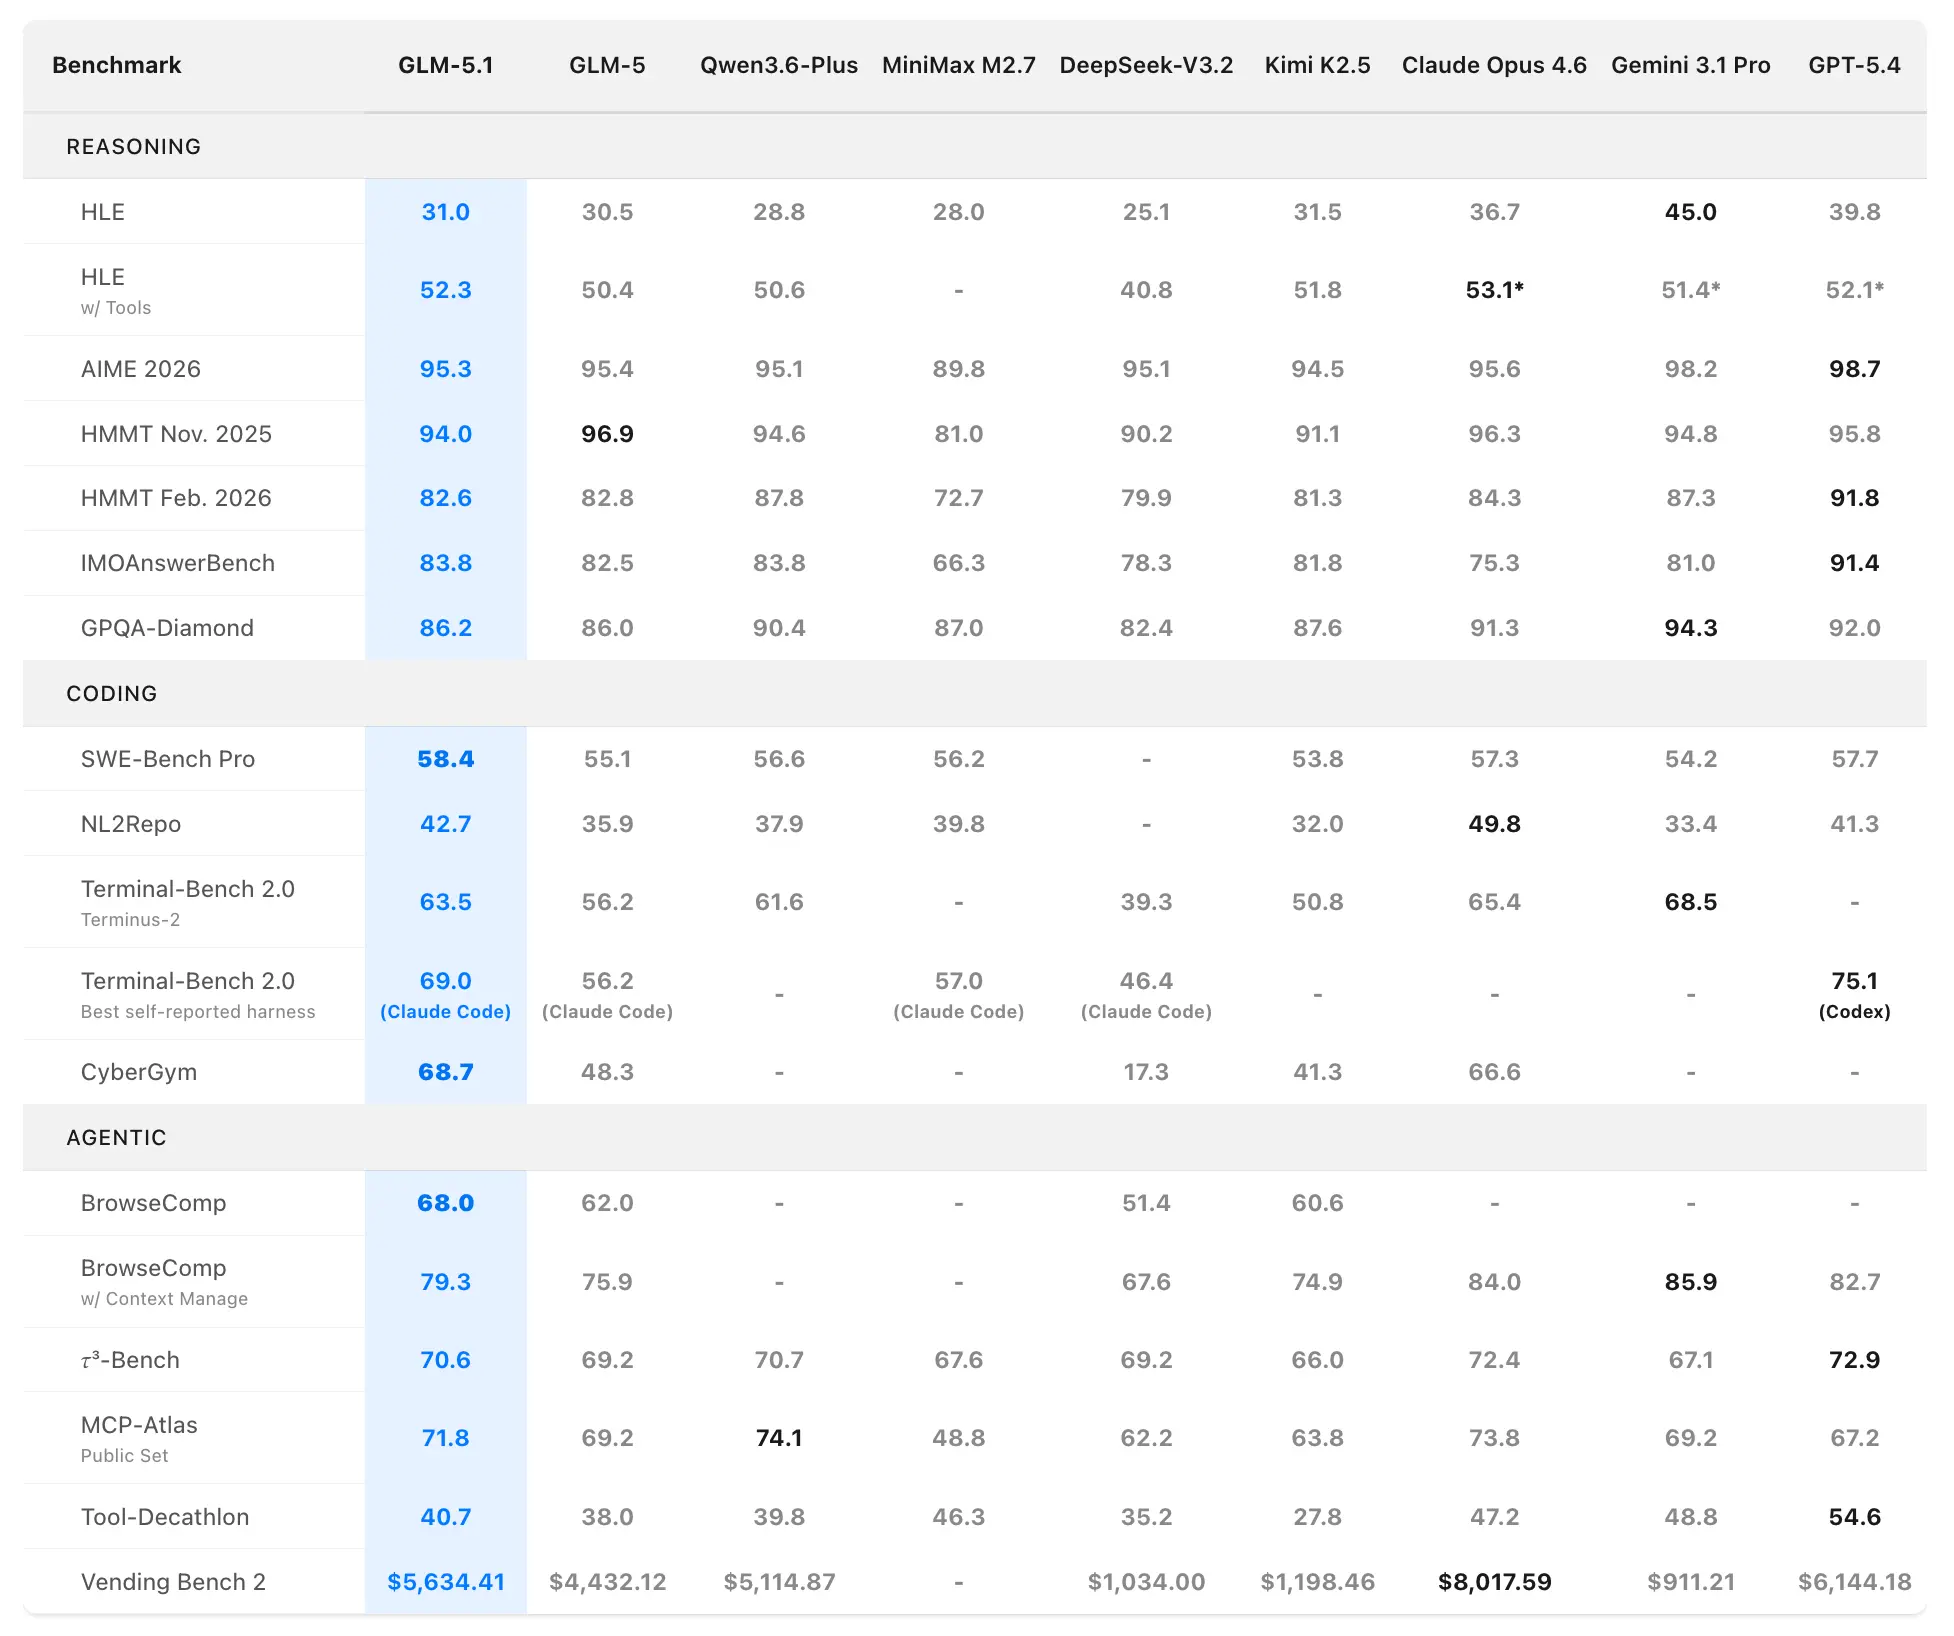
Z.ai は GLM-5.1 を世界最強のオープンソースモデルかつエージェント型コーディングで世界トップ 3 のパフォーマーとして位置づけています。性能データは SWE-Bench Pro、NL2Repo、Terminal-Bench 2.0、そしてカスタムの長期ホライズンシナリオに関する公式評価に基づきます。
Coding and Agentic Benchmarks SWE-Bench Pro (リポジトリのナビゲーション、コード編集、機能検証を要する現実的なソフトウェアエンジニアリングタスク):
GLM-5.1: 58.4 (新 SOTA)
GLM-5: 55.1
GPT-5.4: 57.7
Claude Opus 4.6: 57.3
Gemini 3.1 Pro: 54.2
GLM-5.1 は、この厳格で実務の開発者ワークフローに近いベンチマークで、国内(中国)およびオープンソースのモデルとして初のトップを獲得したと主張しています。
NL2Repo (自然言語からフルリポジトリを生成):
GLM-5.1: 42.7 (GLM-5 の 35.9 を大きく上回る)
競合モデルは 32.0–49.8 の範囲(ハーネスにより首位は異なる)
Terminal-Bench 2.0 (実世界のターミナル/システムタスク):
Terminus-2 ハーネス: GLM-5.1 63.5 (GLM-5 の 56.2 に対し)
自己申告ベスト(Claude Code): 最大 69.0
別のコーディングハーネス評価(Claude Code スタイル)では、GLM-5.1 は 45.3 を記録—Claude Opus 4.6 の 47.9 に対して 94.6% 、GLM-5 の 35.4 比で 28% の改善 。
Composite Ranking : オープンソース #1、中国モデル #1、SWE-Bench Pro + NL2Repo + Terminal-Bench における世界 #3
標準ベンチマークはワンショットや短セッションの性能を測定します。GLM-5.1 が真価を発揮するのは拡張された自律実行です。
VectorDBBench Optimization (600+ イテレーション、6,000+ ツール呼び出し): Rust のスケルトンから出発し、インデクシング、圧縮、ルーティング、プルーニングを反復的に再設計。SIFT-1M で再現率 ≥95% を維持しつつ 21.5k QPS を達成(Claude Opus 4.6 による 50 ターンでの従来ベスト 3,547 QPS の 6 倍)。100–200 イテレーションごとに構造的ブレークスルーが現れる「階段状」の進展を示しました。KernelBench Level 3 (ML モデルのフル最適化、1,000+ ターン): 50 の複雑な問題群で幾何平均 3.6× の高速化(torch.compile の max-autotune の 1.49× を上回る)。GLM-5 が頭打ちになった後も GLM-5.1 は改善を継続し、4.2× の Claude Opus 4.6 のみが僅差で上回りました。Linux Desktop Web App Build (8+ 時間、オープンエンド): 自然言語プロンプトのみ、スターターコードなしの条件で、GLM-5.1 はタスクバー、ウィンドウ、インタラクション、外観の磨き込みまで備えた実用的な Linux 風デスクトップ環境を自律的に構築。従来モデルが基本的なスケルトンしか生成できなかった場面との差を示しました。 これらの結果は、GLM-5.1 が非常に長いホライズンにおいても整合性を保ち、自己評価し、戦略を改訂し、局所最適から脱却できること—Z.ai が現実世界のエージェントシステム向けに意図的に設計した能力—を示しています。
How is GLM-5.1 different from GLM-5? GLM-5 と GLM-5.1 は密接に関連していますが、同じ位置づけではありません。GLM-5 は Z.AI による初期のAgentic Engineering 向け基盤モデルです。複雑なシステムエンジニアリングと長距離エージェントタスク向けに設計され、オープンウェイトでの SOTA コーディング/エージェント能力を備え、実際のプログラミングシナリオで Claude Opus 4.5 に迫るコーディング性能を示します。SWE-bench Verified で 77.8 、Terminal Bench 2.0 で 56.2 を記録しています。
対照的に GLM-5.1 は、長期タスク とより信頼できる持続実行に向けた次の一歩として位置づけられ、長時間タスクにおける安定性、一貫性、ツール使用を改善し、全体的に Claude Opus 4.6 に近づけたとされています。言い換えれば、GLM-5 はエンジニアリング中心の基盤モデルであり、GLM-5.1 はタスク持久力に重点を置いたフラッグシップです。
GLM-5 世代には、飛躍を説明できるアーキテクチャおよび学習面の差異もあります。GLM-5 は 355B パラメータ(32B アクティブ) から 744B パラメータ(40B アクティブ) に拡張し、事前学習データを 23T から 28.5T に増やし、非同期強化学習フレームワークを追加し、長文の品質を保ちながら効率を高めるために DeepSeek Sparse Attention を統合しました。これらは GLM-5 に紐づく詳細ですが、GLM-5.1 はその基盤の上に構築されていると見られます。
GLM-5.1 vs Other Frontier Models GLM-5.1 は最強のオープンソース候補 として際立ち、価格/性能の面でも説得力があります。
Comparison Table: Major Coding & Agentic Benchmarks (April 2026)
GLM-5.1 58.4 (SOTA) 42.7 63.5 45.3 (94.6% of Opus) Yes (600+ iter, 8 hrs) Yes $0.54 / $4.40 GLM-5 55.1 35.9 56.2 35.4 Limited Yes Lower (pre-hike) GPT-5.4 57.7 — — — Strong No Higher Claude Opus 4.6 57.3 — — 47.9 Strongest No ~250–470% more expensive Gemini 3.1 Pro 54.2 — — — Good No Higher
Verdict : GLM-5.1 はオープンソースのアクセス性、コスト、特定の長期コーディング指標で勝利。エージェント的シナリオでクローズドソースのリーダーと互角に渡り合いながら、先端能力の民主化を進めます。
Application scenarios of GLM-5.1
1) 自律型ソフトウェアエンジニアリング GLM-5.1 が最も輝くのは、実際のエンジニアリングスプリントに似たタスクです。コードベースを読み、変更を計画し、実装し、テストし、リグレッションを修正し、結果が安定するまで反復します。Z.ai のリリースノートは自律的計画、持続実行、バグ修正、戦略の反復を明確に強調しており、このモデルがコーディングエージェントやソフトウェアデリバリーパイプライン向けに作られていることを感じさせます。
2) 長時間稼働のエージェントワークフロー 多くのツール呼び出し、長い多段ワークフロー、繰り返される自己修正が関わるユースケースなら、GLM-5.1 の設計は強力に適合します。ドキュメントではツール呼び出し、構造化出力、MCP 統合、ツールストリーミング対応を強調しており、モデルが単に回答するのではなく、より大きなシステム内部で動作する際に有用です。
3) エンタープライズのナレッジワークとレポート作成 GLM-5.1 は PowerPoint、Word、PDF、Excel といったオフィス生産性タスクにも位置づけられています。複雑なコンテンツの構成、レイアウト設計、構造化出力、視覚的な仕上げを改善したとされ、レポート生成、教材、研究サマリー、その他ドキュメント中心の作業に適した選択肢となり得ます。
4) フロントエンドのプロトタイピングと成果物 GLM-5.1 はウェブサイト生成、インタラクティブページ、フロントエンドのプロトタイピングに適しており、テンプレート的な構造が少なく、タスク完了品質が高いと Z.ai は述べています。ブリーフからプロトタイプまでの迅速な橋渡しが必要で、見栄えだけでなく実用性も求められるプロダクトチームに好適です。
5) 複雑な対話と指示追従 主役はコーディングであるものの、GLM-5.1 はオープンエンドの Q&A、複雑な指示、多ターンの対話でも強化されたと説明されています。制約を保持し、出力を改訂し、長い会話にわたってコンテキストを維持する必要があるアシスタント型ワークフローにも有用です。
Conclusion: Why GLM-5.1 Matters in 2026 GLM-5.1 は単なる小幅な更新ではありません。本格的なオープンソースのエージェント型 AI の到来を告げています。現実世界の最難関エンジニアリングベンチマークで優れた成績を収めながら、手頃でオープンであり続けることで、Z.ai は業界全体の水準を引き上げました。個人開発者、エンタープライズチーム、研究者のいずれであっても、GLM-5.1 は長期ホライズンのコーディングタスクにおいて、プロプライエタリのコストの一部で比類ない自律性を提供します。
Ready to try it? CometAPI の GLM-5.1 モデル、Hugging Face のリポジトリ、または GLM Coding Plan をチェックして今すぐアクセスしてください。