Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
無料で始める 無料で始める
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog Step 5 Preview とは? 仕様、ベンチマーク、価格、オープンウェイト ai-model / CometAPIリサーチ
Step 5 Preview とは? 仕様、ベンチマーク、価格、オープンウェイト StepFun Step 5 Preview、その600BのMoEアーキテクチャ、1Mトークンのコンテキスト、コーディングベンチマーク、料金、公開ウェイト、およびAPIアクセスについて詳しく見る。
Deon Goodwin AIモデルとAPIの調査チーム StepFun Step 5 Preview、その600BのMoEアーキテクチャ、1Mトークンのコンテキスト、コーディングベンチマーク、料金、公開ウェイト、およびAPIアクセスについて詳しく見る。
この要約で素早く答えを把握し、ガイドで背景、例、実装詳細を確認してください。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR
Step 5 Preview は、ソフトウェアエンジニアリング、金融リサーチ、複雑なエージェントワークフロー向けの StepFun の旗艦 AI モデルです。競争力のあるタスク性能とコスト効率の高い推論を両立しますが、ベンチマークによって結果はばらつきます。開発者はホスト型 API でアクセスするか、要件に応じて公開ウェイトを用いてデプロイできます。
Key Takeaways
Architecture: Step 5 Preview は総 600B パラメータ、トークン当たり 27B 稼働のスパース MoE アーキテクチャを採用し、モデル容量と推論効率のバランスを取ります。Context and multimodal support: ホスト型 API 経由で 1M トークンのコンテキストウィンドウ、テキスト・画像・動画入力、最大 64K 出力トークンに対応します。Benchmark performance: Step 5 Preview は DeepSWE v1.1 で 67.7%、FrontierFinance で 66.4% を達成する一方、Terminal-Bench v4 では複数の競合に及びません。
明確性、出典の帰属、最新のAPI用語について確認済みです。
API pricing:
Deployment flexibility: Step 5 Preview は StepFun のホスト型 API で利用可能、または vLLM、SGLang、Transformers などの互換フレームワークで公開ウェイトを用いて自前運用できます。
What Is Step 5 Preview? Step 5 Preview は StepFun(阶跃星辰)が開発した大規模マルチモーダル推論モデルです。拡張推論、繰り返しのツール実行、大規模情報集合にまたがる分析を要するワークロードを対象にしています。StepFun はホスト型 API とダウンロード可能なモデルウェイトを提供します。
会話応答に最適化された汎用アシスタントと異なり、Step 5 Preview はエージェント的実行に重きを置きます。すなわち、計画、ツール利用、中間結果の検査、誤り修正、複雑な目標に向けた継続が可能です。
Key Specifications 公式モデルカード にはスパースアーキテクチャ、パラメータ数、デプロイ構成が記載されています。ホスト型 API 仕様 には対応入力、生成上限、提供機能が別途定義されています。これはデプロイ契約の異なるレイヤーです。
Developer StepFun Model identifier step-5-preview Model category Multimodal reasoning and agentic LLM Architecture Sparse Mixture-of-Experts Total parameters Approximately 600B Active parameters per token Approximately 27B Active parameter proportion Approximately 4.5% Context window Up to 1M tokens Supported inputs Text, images, and video on the hosted API Hosted API maximum output 64k tokens Primary output Text Reasoning modes low, medium, high; reasoning_effort on Chat Completions Tool calling Supported Structured output JSON Mode and JSON Schema on the hosted API Prompt caching Supported Hosted API status Available as of October 19, 2026 Weight availability
ホスト型 API では最大出力 64k トークンが文書化されていますが、モデルカードには最大 1M トークンのシーケンス生成能力が記載されています。後者はホスト型エンドポイントが 1M トークンの完了出力を受け付けることを約束するものではありません。自前運用の vLLM 例では、設定された 1M トークンのシーケンス予算は入力と出力の合計を対象とします。利用可能な KV キャッシュメモリや同時実行数により、実効容量は縮小され得ます。
How the 600B/27B MoE Architecture Works 従来の密なトランスフォーマーは推論時にモデルパラメータの多くを活性化します。Step 5 Preview はスパースルーティングによって関連するエキスパートを選択します。約 600B のうち 27B のアクティブパラメータで、典型的なトークン計算には総数の約 4.5% が参加します。
この違いはコスト効率戦略の背景説明になります。ただし、アクティブ 27B は 27B のデプロイフットプリントを意味しません。全エキスパートのウェイトは依然として保存・アクセスが必要であり、GPU メモリ容量、エキスパート並列、インターコネクト帯域が重要な検討事項です。
ホスト型 API はテキスト、画像、動画を受け付け、最大 1M トークンのコンテキストウィンドウと最大 64k トークンの出力に対応します。これらの入力は、リポジトリ分析、金融ドキュメントリサーチ、視覚的解釈などのタスクを支援します。自前運用では、使用可能なシーケンス長はランタイム構成、利用可能メモリ、同時実行数に依存します。
マルチモーダル対応や API 機能は、ホスト型と自前運用構成で異なる場合があります。
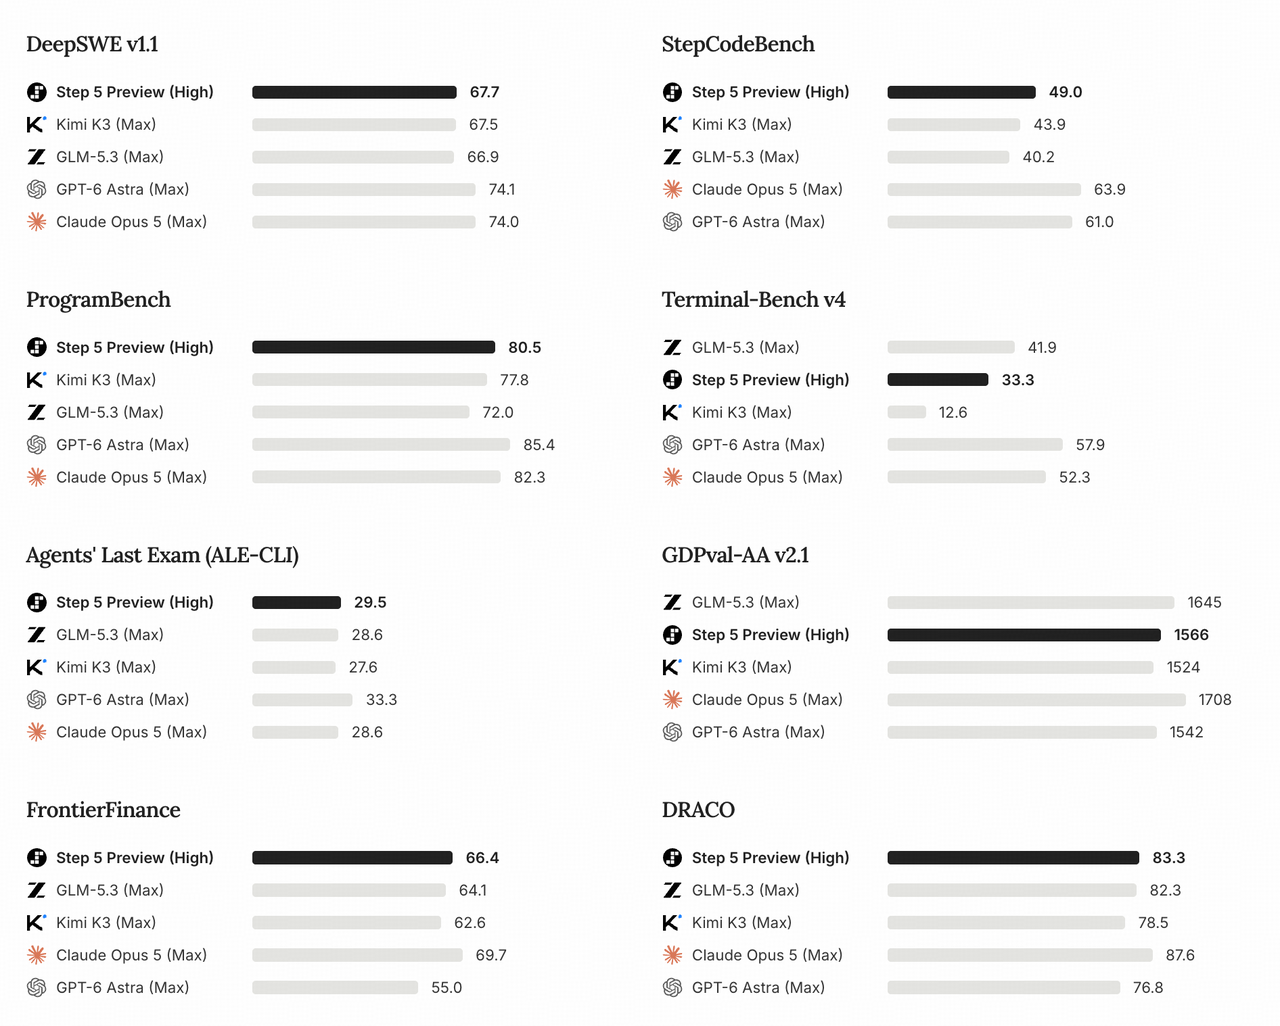
以下は StepFun 公表の結果です。Step 5 Preview は High の推論設定を用い、比較モデルは Max を用いています。ラベル名を一致させても計算量が等しいことは保証されず、公開スコアはアプリケーションのレイテンシやタスク成功あたりのコストを測定していません。
元の公式チャートは発行者の評価結果を要約しています。以下の表は、本分析に関連するコーディング、推論、金融のスコアを抜粋したものです。
DeepSWE v1.1 67.7 67.5 66.9 74.1 74.0 StepCodeBench 49.0 43.9 40.2 61.0 63.9 ProgramBench 80.5 77.8 72.0 85.4 82.3 Terminal-Bench v4 33.3 12.6 41.9 57.9 52.3 Agents’ Last Exam (ALE-CLI) 29.5 27.6 28.6 33.3 28.6
スコアはパーセンテージで、値が高いほど各ベンチマークでの性能が高いことを示します。DeepSWE v1.1 は SWE-agent ハーネスを使用し、temperature=1.0 と top_p=0.95 を設定しています。StepCodeBench は avg@4 を、ProgramBench は合格率を報告します。各ベンチマークは独自の評価設定下で異なるタスクを測定するため、これらのパーセンテージは互換の精度指標ではありません。公開された比較は、モデル間で同一のハードウェアや実行予算を確立するものでもありません。
DeepSWE v1.1 では、Step 5 Preview が 67.7% を記録し、Kimi K3 と GLM-5.3 を僅差で上回りました。これは、リポジトリを扱うコーディングエージェントや自動ソフトウェアエンジニアリングタスクで競争力があることを示唆します。
ProgramBench でも前向きなシグナルがあります。Step 5 Preview は 80.5% に到達し、Kimi K3 の 77.8%、GLM-5.3 の 72.0% と比較して上回っています。
一方、Terminal-Bench v4 は重要な制約を露呈します。Step 5 Preview の 33.3% は GLM-5.3 の 41.9% を下回り、GPT-6 Astra は 57.9% に達しています。すなわち、Step 5 Preview はリポジトリ指向のソフトウェアエンジニアリングでは競争力があるものの、その相対的優位はターミナル駆動の実行や複雑なデバッグに一様には及ばないことが示唆されます。
GPQA Diamond 93.5% 91.7% 93.5% 96.1% Humanity’s Last Exam 46.5% 42.3% 46.9% 54.7% AA-LCR v1.1 88.3% 79.7% 88.7% 80.7% CritPt 20.9% 19.1% 23.4% 31.7%
Step 5 Preview は GPQA Diamond で 93.5% を記録し、Kimi K3 と同等で、GPT-6 Astra の 96.1% に次ぎます。AA-LCR v1.1 では 88.3% と、Kimi K3 の 88.7% をわずかに下回り、GPT-6 Astra の 80.7% を上回ります。一方、Humanity's Last Exam と CritPt では Kimi K3 や GPT-6 Astra に及びません。結果は、知識および長文脈推論で競争力がある一方、タスクにより相対的な強みが変化することを示しています。
金融リサーチは Step 5 Preview の最も特徴的な適用領域の一つです。モデルは定量推論、根拠の検索、構造化分析を組み合わせるよう設計されています。これらの能力は、企業評価、金融文書の解釈、投資リサーチに特に関連性があります。
StepFun は情報収集から防御可能な結論の作成まで、多段階の金融リサーチを評価するために FinStepBench を導入しました。
FrontierFinance 66.4 62.6 64.1 55.0 69.7 FinStepBench LiveSearch 74.5 70.9 73.3 74.5 76.2 FinStepBench CorporateValuation 60.6 60.6 56.1 77.3 69.7 FinStepBench DeepResearch 55.8 48.9 53.3 45.0 59.1
値が高いほどベンチマーク性能が高いことを示します。FinStepBench は StepFun が開発したため、独立検証が特に重要です。
Step 5 Preview は FrontierFinance で 66.4% を達成し、報告された構成では Kimi K3、GLM-5.3、GPT-6 Astra を上回りました。ただし、Claude Opus 5 は 69.7% で依然として先行しています。
FinStepBench DeepResearch の結果は特に注目に値します。Step 5 Preview は 55.8% に到達し、Kimi K3 の 48.9%、GLM-5.3 の 53.3% と比較して上回っています。これは、検索、統合、拡張分析を要する金融リサーチワークフローにモデルが適している可能性を示唆します。
一方で CorporateValuation のスコアはよりニュアンスがあります。60.6% にとどまり、GPT-6 Astra の 77.3% と大きな差があります。したがって、Step 5 Preview を金融分析で一律に優れていると見なすべきではありません。DeepResearch では相対順位が高い一方、CorporateValuation では劣るため、広範な優位性主張ではなくタスク固有の評価が妥当です。
本番用途では、金融出力に対して独立検証された計算、前提の文書化、追跡可能な根拠の提示が引き続き必要です。
Step 5 Preview vs Other AI Models Step 5 Preview はホスト型の代替や専有フロンティアサービスと競合します。ベンチマーク結果は候補モデル選定に役立ちますが、API アクセス、入力対応、デプロイ制御、実際のワークロードコストが本番適合性を左右します。
Step 5 Preview は文書化された 600B/27B のスパース MoE チェックポイントと自前運用オプションを提供します。代替モデルでは、ウェイト提供可否、パラメータ数、コンテキスト上限、受け付ける入力は各モデルやエンドポイントに依存します。公開ベンチマークは候補の短縮に役立ち、代表的なコーディングやリサーチタスクは各サービスの実行時挙動を明らかにします。
Step 5 Preview vs Kimi K3 Step 5 Preview は DeepSWE v1.1、ProgramBench、FrontierFinance でわずかに上回ります。Kimi K3 は推論や特定の技術評価で競争力を維持します。実務上の違いは、決定的な知能差というより、コスト、提供条件、開発者が得られるタスク固有の信頼性に重心があります。
Step 5 Preview vs GLM-5.3 Step 5 Preview は複数の金融およびソフトウェア開発評価で GLM-5.3 を上回ります。しかし、GLM-5.3 が Terminal-Bench v4 で高スコアを記録していることは、報告されたターミナル指向タスクでの優位を示唆します。コーディングエージェントでは、単一の集約スコアに依存するのではなく、リポジトリへの改変成功、ツール呼び出しエラー、実行時間、パッチの正確性を比較してください。
Step 5 Preview vs GPT-6 Astra and Claude Opus 5 専有フロンティアモデルは、最難関のソフトウェアエンジニアリングベンチマークで概して高い性能を示します。Step 5 Preview の主な魅力は、選択したワークロードで競争力に近づきつつ、公開ウェイトによるデプロイオプションと比較的アクセスしやすい API 価格を提供する点です。
失敗のコストが高く、タスク精度の微増が追加費用を正当化する状況ではプレミアムモデルを選択してください。価格、デプロイ制御、繰り返しのエージェント実行を重視する場合は Step 5 Preview を検討してください。
How Much Does Step 5 Preview API Cost? Step 5 Preview の価値はタスク能力と運用コストの両方に依存します。エージェントワークフローは多数の呼び出し、繰り返しの文書取得、再試行を伴う場合があり、トークン単価が低くてもモデルが確実にタスクを完了できなければ意味がありません。成功裏に完了したタスク当たりのコストは、以下の料金と併せて有用です。
API Availability and Token Pricing この 2026年10月19日のスナップショットは、StepFun のネイティブ API 料金 と、モデル比較セクションにリンクした CometAPI の料金を比較します。すべての価格は 100 万トークンあたりの米ドルです。サービスごとに課金、キャッシュ、エンドポイント条件が異なります。「not listed」はこの記事のソーススナップショットにキャッシュ入力料金の記載がないことを意味します。
Step 5 Preview StepFun native API step-5-preview $1.00 $0.10 $2.70 Kimi K3 CometAPI kimi-k3 $2.40 Not listed $12.00 GLM-5.3 CometAPI glm-5.3 $1.12 Not listed $3.53 GPT-6 Astra CometAPI gpt-6-astra $8.00 (short-context tier) Not listed $40.00 (short-context tier) Claude Opus 5 CometAPI claude-opus-5 $4.00 Not listed $20.00
GPT-6 Astra のショートコンテキスト階層は最大 272,000 トークンに適用され、長文脈レートは入力 $16、出力 $60(100 万トークンあたり)です。記載料金にはツール、再試行、インフラは含みません。Step 5 Preview の CometAPI 経由での提供可否はこの比較で確立されていません。以下の Step 5 Preview の例は StepFun のネイティブエンドポイントを使用しています。
キャッシュヒットの入力単価は未キャッシュレートより 90% 低価です。未キャッシュ価格には新規コンテンツのキャッシュ書き込みが含まれ、出力課金には推論と最終回答の両トークンが含まれます。同一のプロンプトテキストが低価格で計上されるのは、サービスが適格なキャッシュヒットを報告した場合に限られます。見かけの回答長だけでは請求される出力量を過小評価します。
Example Cost Calculations Short analytical request 10K 0 5K $0.0235 Medium coding workflow 100K 0 20K $0.154 Repeated agent request 10K 90K 20K $0.073 Large document analysis 500K 0 30K $0.581 Long-context cached workflow 100K 400K 50K $0.275
Cost formula: C = (Tu × Pu + Tc × Pc + To × Po) / 1,000,000, where Tu/Tc/To represent uncached input, cached input, and billable output tokens, respectively, and Pu/Pc/Po are their prices per million tokens.
同じ 100,000 入力トークンと 20,000 の請求対象出力トークンで StepFun の 2 つのリクエストを比較します。
キャッシュミス: 100,000 入力トークンすべてが未キャッシュ。Cost = (100,000 × $1.00 + 20,000 × $2.70) / 1,000,000 = $0.154。
キャッシュヒット: 90,000 入力トークンがキャッシュレートの適用対象で、10,000 が未キャッシュのまま。Cost = (10,000 × $1.00 + 90,000 × $0.10 + 20,000 × $2.70) / 1,000,000 = $0.073。
キャッシュヒットの例は $0.081(約 52.6%)の節約になります。節約はサービスが適格なキャッシュヒットを報告した場合に依存します。どちらの例も外部ツール、再試行、インフラコストは除外しています。
トークン価格だけでは最も価値のあるモデルは決まりません。複数回の再試行が必要なエージェントは、初回で成功する高価格モデルより高くつくことがあります。信頼できるコスト比較には、トークン価格と併せて成功裏に完了したタスク当たりのコストを用いてください。
Is Step 5 Preview Open Source, and Can It Run Locally? StepFun は公式の Hugging Face リポジトリでダウンロード可能なウェイトを公開しており、2026年10月19日現在 FP8、BF16、NVFP4 の各種が利用可能です。ウェイトへのアクセスは自前運用を可能にしますが、メモリ要件が小規模な密モデルと同等になるわけではありません。
利用可能なファイルには、Step 5 Preview チェックポイント、BF16 バージョン、NVFP4 バージョンが含まれます。
用語は重要です。Step 5 Preview は StepFun Model License 1.0 の下で公開ウェイトを提供します。ライセンスにはモデル固有の帰属と商用ライセンス条件が含まれます。デプロイ前に、計画する使用や配布に対する条件を評価してください。
Local Deployment Requirements
FP8(vLLM): NVIDIA B300 ×4 または NVIDIA H200 ×8、OpenAI 互換 API を提供
BF16(vLLM): NVIDIA B300 ×8 または NVIDIA H200 ×16、OpenAI 互換 API を提供
FP8(SGLang): NVIDIA B300 ×4、OpenAI 互換 API を提供;FP8(Transformers): オフライン生成に NVIDIA H200 ×8
これらはリファレンス構成であり、すべてのチェックポイント、ランタイム、コンテキスト長、同時実行設定に対する最低保証ではありません。スパース活性化は計算量を減らしますが、エキスパートウェイトの保存と KV キャッシュメモリは依然として主要な考慮事項です。
600B モデルはメモリ容量以外にも、多 GPU 通信、フレームワーク互換性、チェックポイント読み込み、長文脈スループットなどの課題を伴います。大規模 GPU クラスタを持たないチームにとっては、ホスト型 API が通常はより実用的な出発点です。
How Can Developers Use the Step 5 Preview API? StepFun は OpenAI 互換の Chat Completions インターフェースに対応しています。以下の Python 例を実行する前に環境変数 STEPFUN_API_KEY を設定してください。max_tokens はこのリクエストの生成出力の上限を設定します。選択した地域プラットフォームの API キーと課金条件を使用してください。この例では api.stepfun.ai エンドポイントを保持し、上記のドル価格は StepFun のインターナショナルプラットフォームのものです。
Python 例: 制限付きのテキストリクエストを StepFun API に送信し、返された回答を出力します。
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["STEPFUN_API_KEY"],
    base_url="https://api.stepfun.ai/v1",
)
response = client.chat.completions.create(
    model="step-5-preview",
    messages=[{
        "role": "user",
        "content": (
            "モノリシックアプリケーションをマイクロサービスへ移行する際のアーキテクチャ上のリスクを分析してください。"
        ),
    }],
    max_tokens=4000,
)
print(response.choices[0].message.content)
本番使用前に、選択した StepFun エンドポイントが受け付けるパラメータと生成上限を確認してください。reasoning_effort、プロンプトキャッシュ、ツールスキーマ、出力予算は、信頼性、レイテンシ、最終的な請求に影響します。
Step 5 Preview in Agent Workflows
リポジトリのドキュメントと関連ファイルを読む。
要求された変更を特定し、計画を提案する。
選択したコードを修正し、外部ツールでテストを実行する。
失敗を検査し、実装を修正する。
検証済みの変更の最終説明を作成する。
モデルは推論とツール要求を生成し、アプリケーションは実際のファイルアクセス、実行環境、権限、安全チェックを提供します。モデル能力だけでは自律的な実行は保証されません。
CometAPI は上記の代替モデルへのアクセスを共有統合サービスを通じて提供します。各モデルの文書化されたエンドポイントとリクエスト形式を選択し、同一ワークロードで成功率、トークン使用量、再試行、エンドツーエンドレイテンシを比較してください。
上の例は StepFun のネイティブエンドポイントを使用しています。ゲートウェイに切り替えるには、Step 5 Preview の提供可否と、ゲートウェイに文書化されたモデル識別子、エンドポイント、課金条件の確認が必要です。
When Should You Choose Step 5 Preview?
代表テストで信頼できる結果が確認できるリポジトリコーディングや文書主体のリサーチで選択してください。長いコンテキストと公開されたコーディング・金融スコアが候補にする根拠となる一方、ターミナルタスクや企業評価の結果は、ワークロード固有のテストが重要であることを示します。
大規模 GPU クラスタを運用せずに始めたい場合はホスト型 API を選択してください。受理タスクあたりのコスト、キャッシュヒット率、再試行、レイテンシを比較してください。大きなコンテキストウィンドウは高速応答や低総コストを保証しません。
デプロイ制御がハードウェアと運用負担を正当化する場合は自前運用を選択してください。全エキスパートウェイトの保存、KV キャッシュ、多 GPU 通信、ライセンス要件に予算を見込んでください。重大な金融や工学の作業では、ソースチェック、エラー検出、人によるレビューを含めてください。
FAQ
How should you choose Step 5 Preview’s reasoning effort? 代表的な少数のタスクから始め、同一の受理基準で low、medium、high を比較してください。正確性、請求対象出力、レイテンシ、ツール失敗を記録します。品質閾値を一貫して満たす最も低い設定を使用してください。公開された High のベンチマークスコアは、low や medium の挙動を予測しません。推論構成ガイドに従い、比較時は Chat Completions で reasoning_effort を明示的に設定してください。
Why can a Step 5 Preview request stop before 64k output tokens? 文書化された最大値は上限であり、目標長ではありません。max_tokens の予算に達した、自然停止した、ツール呼び出しを生成してアプリケーションが処理すべきだった、などの理由で早期終了することがあります。自動再試行の前に、返された終了理由とツール要求を確認してください。短い完了回答はコンテキストウィンドウの失敗を示すものではありません。
短く代表的なクリップと、検証可能な答えを持つ質問から始めてください。ホスト型 API の動画入力仕様は URL、Base64、stepfile 参照での動画入力に対応し、文書化された形式には MP4、QuickTime、Matroska が含まれます。URL 入力では、個別の MP4 ファイルが 128 MB 未満で、5 分未満を推奨しています。バッチ化の前に形式とサイズ上限を確認し、単一フレーム認識だけでなく時間的質問もテストしてください。
Which metrics reveal Step 5 Preview’s real agent cost? 受理タスク完了数、全ターンにわたる総入力・出力トークン、キャッシュヒット、再試行、外部ツール料金、経過時間を測定します。モデル間で成功基準を固定した上で、総実行コストを成功完了数で割ってください。これにより、試行回数が増える安価な呼び出しや、後続の失敗を減らす高エフォート実行の経済的効果を捉えられます。
Conclusion Step 5 Preview は、長文脈処理、繰り返しのツール利用、モデルデプロイの制御が必要なアプリケーションで評価する価値があります。StepFun の公開結果は、リポジトリコーディングや金融リサーチの候補となる一方、Terminal-Bench v4 や CorporateValuation は、掲載された代替のほうが高スコアである領域を示します。固定された受理基準、受理タスクあたりの総コスト、エンドツーエンドのレイテンシを用いてモデルを比較してください。自前運用では、インフラコストとライセンス要件を意思決定に含めてください。
Official FP8, BF16, and NVFP4 repositories available
Local deployment vLLM, SGLang, Transformers
Model license StepFun Model License 1.0