Qwen3.8-Flash의 기술 사양
| 사양 | Qwen3.8-Flash |
|---|---|
| 제공자 | Alibaba / Qwen |
| 모델 계열 | Qwen3.8 |
| 모델 ID | qwen3.8-flash |
| 모델 유형 | 멀티모달 추론 모델 |
| 입력 모달리티 | 텍스트, 이미지, 비디오 |
| 출력 모달리티 | 텍스트 |
| 컨텍스트 윈도우 | 1,000,000 토큰 |
| 최대 출력 | 128,000 토큰 |
| 최대 추론 예산 | 262,144 토큰 |
| Thinking 모드 | 지원 |
| 함수 호출 | 지원 |
| 내장 도구 | 지원 |
Qwen의 최신 API 문서에는 qwen3.8-flash가 1M-토큰 컨텍스트 윈도우와 128K 최대 출력값을 갖춘 프로덕션 Qwen3.8 모델로 기재되어 있습니다. 텍스트, 이미지, 비디오 입력과 함수 호출, 내장 도구, 구조화된 출력을 지원합니다.
비주얼 작업의 경우, 문서화된 한도는 이미지당 최대 16 메가픽셀, 최대 2,048개 이미지 URL 또는 250개 Base64 이미지, 그리고 최대 64개 비디오(비디오는 최대 2시간)입니다.
Qwen3.8-Flash란?
Qwen3.8-Flash는 Qwen3.8 패밀리 내에서 코딩, 에이전트형 워크플로, 장문맥 분석 및 비주얼 이해를 위해 설계된 Alibaba의 비용 효율적인 멀티모달 추론 모델입니다. Qwen3.8-Max와 동일한 1M-토큰 컨텍스트 등급을 제공하면서 API 비용은 크게 낮추는 것을 목표로 합니다. Qwen의 개발자 가이드에서는 유사한 기능을 더 낮은 가격에 원할 때 Qwen3.8-Flash를 명시적으로 권장하며, Qwen3.8-Max는 더 강력한 추론 성능이 필요한 경우에 적합한 옵션으로 포지셔닝되어 있습니다.
이 모델이 특히 흥미로운 점은 "Flash"가 단순한 소형 모델을 의미하지는 않는다는 것입니다. 프로덕션 API 모델은 비교적 저렴한 엔드포인트에서 장문맥 추론, 멀티모달 입력, 도구 사용, 구조화된 출력을 결합합니다.
Qwen3.8-Flash의 주요 기능은?
- 1M-token context: Qwen3.8-Flash는 매우 긴 문서와 코드베이스를 처리할 수 있어 리포지토리 분석과 장시간 에이전트 세션에 적합합니다.
- 멀티모달 이해: API는 텍스트, 이미지, 비디오를 수용하여 개발자가 코드, 스크린샷, 차트, 문서, 비디오를 하나의 워크플로로 결합할 수 있게 합니다.
- 추론 모드: 이 모델은 Qwen의 Thinking mode를 지원하며, 문서화된 최대 추론 예산은 262,144 토큰입니다.
- 에이전트 및 도구 지원: 함수 호출과 내장 도구를 지원하며, 웹 검색, 코드 실행 및 관련 Qwen 호스팅 도구 등의 기능을 포함합니다.
- 구조화된 출력: 개발자는 구조화된 응답을 요청할 수 있어 JSON 또는 스키마 제약 결과가 필요한 애플리케이션에 더 쉽게 통합할 수 있습니다.
- 장시간 비디오 이해: 비주얼 API 문서에는 최대 2시간 길이의 비디오 입력이 명시되어 있어, Qwen3.8-Flash는 단순한 짧은 이미지 캡셔닝 작업을 넘어 비디오 분석에 유용합니다.
Qwen3.8-Flash의 최적 활용 사례는?
코딩 및 소프트웨어 엔지니어링
1M-토큰 컨텍스트는 대규모 리포지토리, 긴 디버깅 세션, 다중 파일 코드 분석에 유용합니다. 이 모델의 함수 호출과 추론 지원은 단순한 코드 자동완성을 넘어 코딩 에이전트에도 적합하게 만듭니다.
에이전트형 워크플로
Qwen3.8-Flash는 함수 호출과 내장 도구를 지원하여, 애플리케이션이 모델로 하여금 정보를 검색하고 코드를 실행하며 외부 시스템과 상호작용하도록 할 수 있습니다.
장문서 분석
100만 토큰 컨텍스트는, 정보를 반복적으로 청킹해야 할 대형 계약서, 기술 문서, 연구 컬렉션, 엔터프라이즈 지식베이스에 이 모델이 적합하도록 해 줍니다.
비디오 및 비주얼 분석
Qwen3.8-Flash는 이미지와 비디오를 모두 수용합니다. 현재 비주얼 API 한도는 최대 2시간의 비디오를 허용하므로 회의 녹화, 튜토리얼, 강의, 데모, 장문형 비주얼 콘텐츠 분석에 적합합니다.
비용 민감형 프로덕션 AI
이는 아마도 이 모델의 가장 큰 상업적 장점입니다. Qwen은 Qwen3.8-Max의 저비용 대안으로 Flash를 명확히 권장하고 있어, 모든 요청에서 플래그십 수준의 추론이 필요하지 않은 대량 트래픽 애플리케이션에 적합합니다.
Qwen3.8-Flash의 한계는?
Qwen3.8-Flash는 Qwen3.8-Max와 1M 컨텍스트 윈도우를 공유한다는 이유만으로 Qwen3.8 패밀리에서 최고의 성능을 내는 모델로 해석되어서는 안 됩니다.
주요 트레이드오프는 역량과 비용 간의 균형입니다. 가장 강력한 추론 성능이 필요할 때는 Qwen 자체도 Qwen3.8-Max를 권장합니다.
두 번째로, 1M 컨텍스트 윈도우가 모든 요청에 100만 토큰을 담아야 함을 의미하지는 않습니다. 큰 컨텍스트는 처리 요구를 증가시키므로, 전체 컨텍스트가 불필요한 경우 개발자는 검색, 캐싱, 컨텍스트 관리 등을 활용해야 합니다.
마지막으로, 개발자는 호스팅된 qwen3.8-flash와 오픈 웨이트 Qwen3.8-Flash-Next를 구분해야 합니다. 후자는 아키텍처 프리뷰로서 독립적으로 문서화된 웨이트와 아키텍처를 가지며, 프로덕션 API 모델은 자체 API 사양에 따라 문서화되어야 합니다.
프로덕션 API 애플리케이션에 Qwen3.8-Flash가 적합한가?
예, 특히 애플리케이션에 멀티모달 추론, 긴 컨텍스트, 도구 사용, 상대적으로 낮은 토큰 비용이 필요할 때 적합합니다.
요구 사항이 단순히 호스팅된 Qwen API를 호출하는 것이라면 Flash-Next보다 더 강력한 프로덕션 후보입니다. qwen3.8-flash는 Qwen의 API 문서에서 컨텍스트, 출력, 도구, 멀티모달 한도가 명시된 프로덕션 모델로 명확히 공개되어 있기 때문입니다.
최대 수준의 추론 품질이 필요하다면 Qwen3.8-Max가 더 적합한 선택입니다. 비용과 처리량이 더 중요한 대량 워크로드에서는 Qwen3.8-Flash가 더 경제적인 옵션입니다.
Qwen3.8-Flash API 매개변수
표준 OpenAI 호환 요청에서는 다음과 같은 매개변수를 사용할 수 있습니다:
| Parameter | Purpose |
|---|---|
| model | qwen3.8-flash |
| messages | 대화 및 멀티모달 입력 |
| temperature | 샘플링 제어 |
| max_tokens | 최대 생성 출력 |
| stream | 스트리밍 응답 |
| tools | 함수/도구 정의 |
| tool_choice | 도구 선택 동작 |
| response_format | 구조화된 출력 구성 |
| enable_thinking | 지원되는 Qwen API에서 추론 모드를 활성화 |
퀵스타트 문서는 모델 식별자 qwen3.8-flash와 함께 OpenAI SDK를 사용합니다. 예제에서는 extra_body={"enable_thinking": True}로 추론을 활성화합니다.
CometAPI에서 qwen3.8-flash API를 사용하는 방법
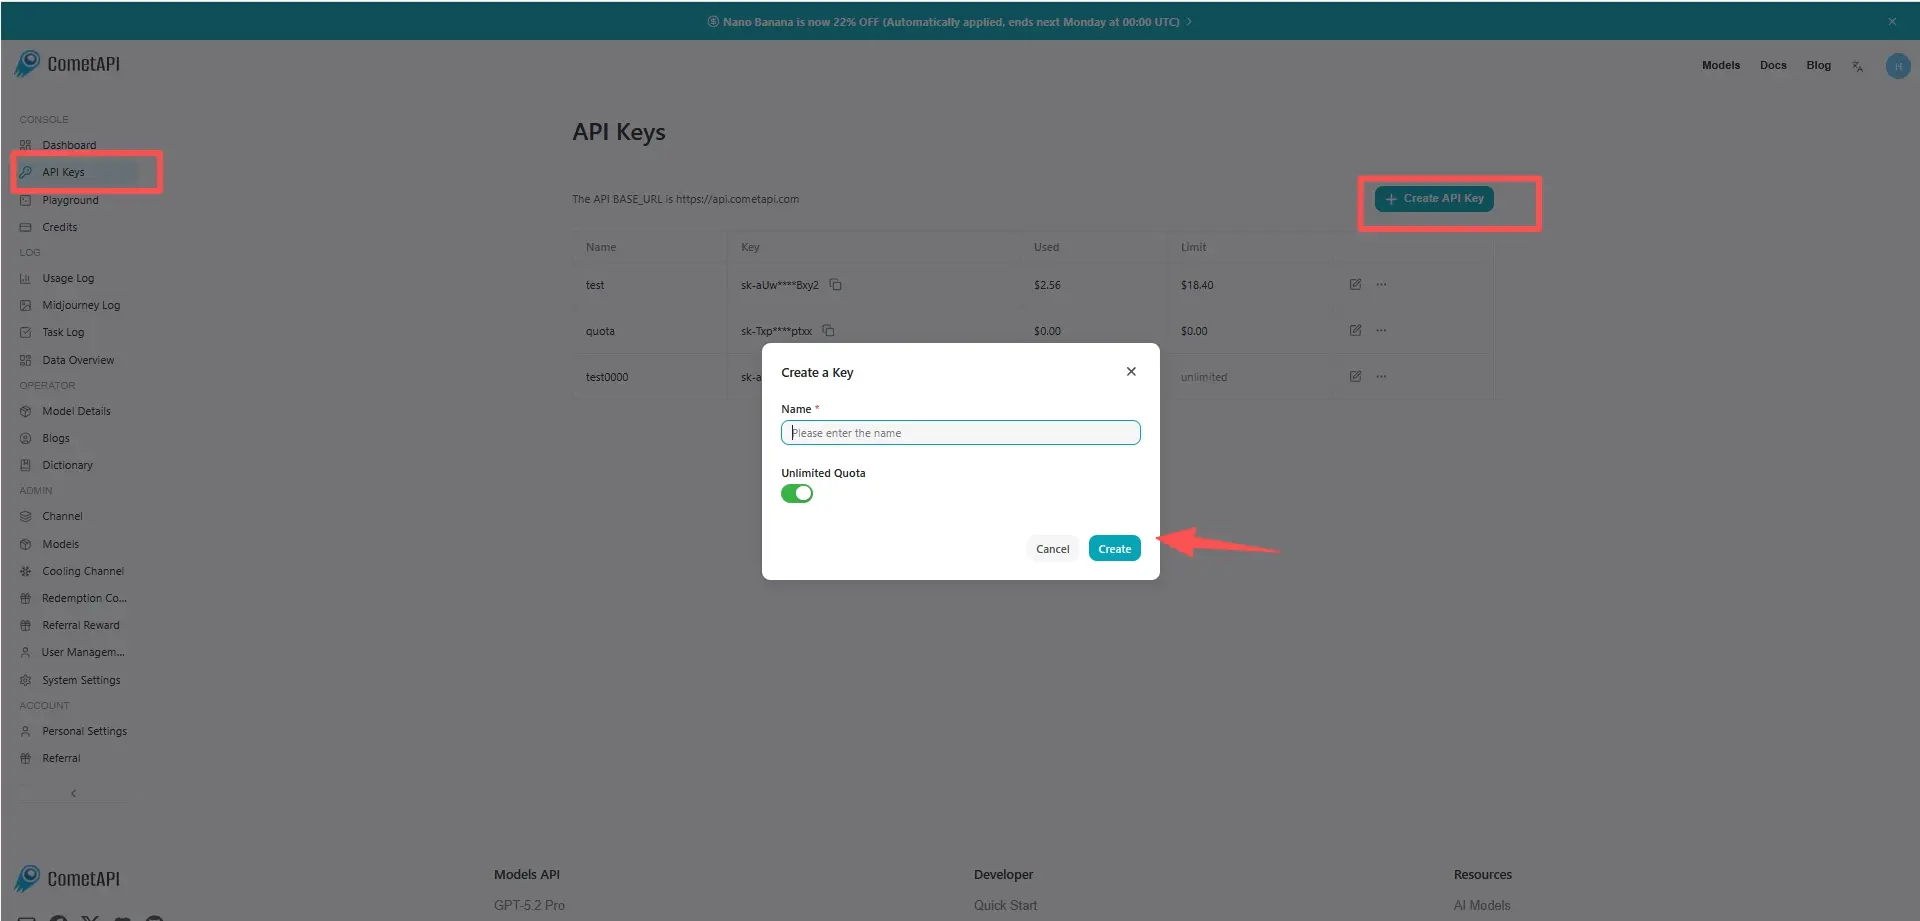
1단계: API 액세스 받기
CometAPI에 로그인하세요. 아직 사용자가 아니라면 먼저 가입하세요. CometAPI 콘솔에 로그인합니다. 인터페이스의 액세스 자격 증명인 API 키를 발급받습니다. 개인 센터의 API 토큰에서 “Add Token”을 클릭하고 토큰 키: sk-xxxxx를 발급받아 제출합니다.
2단계: qwen3.8-flash API로 요청 보내기
API 요청을 보내고 요청 본문을 설정하려면 “qwen3.8-flash” 엔드포인트를 선택하세요. 요청 방식과 요청 본문은 당사 웹사이트의 API 문서에서 확인할 수 있습니다. 편의를 위해 웹사이트에서 Apifox 테스트도 제공합니다. 계정의 실제 CometAPI 키로 <YOUR_API_KEY>를 교체하세요.
질문이나 요청을 content 필드에 입력하세요—모델은 여기에 응답합니다. API 응답을 처리하여 생성된 답변을 얻습니다. AI SDK, OpenAI Chat Completions, OpenAI Responses 및 Anthropic Messages 호환 인터페이스를 지원합니다.
3단계: 응답 처리
API는 생성된 텍스트, 인용, 안전 메타데이터, 선택적 도구 출력 등을 포함한 구조화된 후보 응답을 반환합니다. 멀티모달 요청의 경우, 선택한 CometAPI 엔드포인트가 모델의 비전 기능을 노출할 때 메시지 콘텐츠를 텍스트와 이미지 입력으로 구조화할 수 있습니다.