
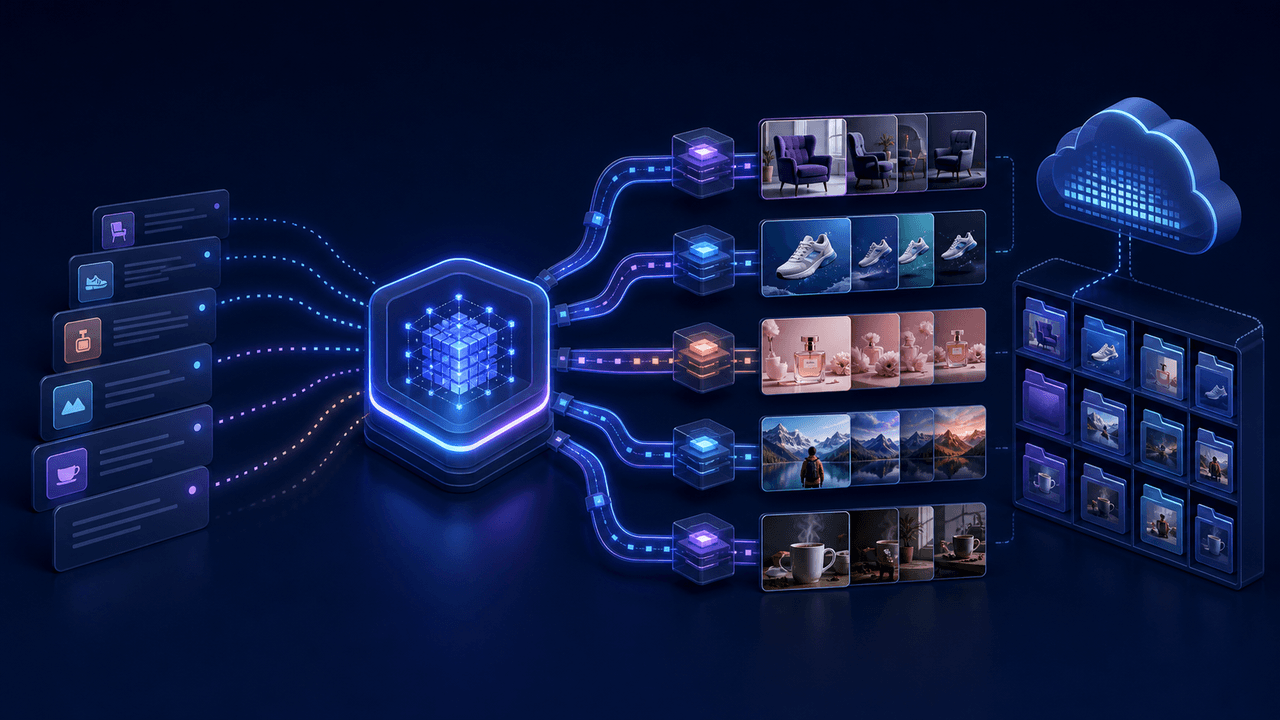
Den enkleste måten å automatisere bildegenerering i stor skala uten å håndtere flere forskjellige API-er, er å skille arbeidsflyten fra modellleverandøren. Legg hver bilderequest i én kø, ruter hver jobb til en gjeldende model ID, og send kompatible forespørsler gjennom én CometAPI-nøkkel og den OpenAI-kompatible base-URL-en https://api.cometapi.com/v1.
Denne veiledningen bygger den pipeline-en i Python. Den tar imot produkt-, annonse- og innholdsjobber fra en JSON Lines-kø; velger en modell; begrenser samtidighet; prøver på nytt ved forbigående feil; lagrer enten URL- eller base64-baserte resultater; og registrerer bruk per jobb og estimert kostnad. Eksemplet samler disse produksjonsnødvendighetene i én kompakt blokk, slik at du kan teste arbeidsflyten uten å gjøre artikkelen til en kodereferanse.
Hvordan et enhetlig bilde-API forenkler batch-generering
Til slutt vil arbeidsflyten se slik ut:
jobs.jsonl → bounded worker pool → CometAPI /v1/images/generations → object storage → manifest.jsonl
Køen og lagringslaget forblir dine. Å bytte bildemodeller endrer model-verdien, ikke autentiseringssystemet eller hovedrute for requests. Det er den praktiske fordelen med et enhetlig bilde-API: modellvalg blir en rutingsbeslutning inne i én pipeline i stedet for en egen leverandørintegrasjon.
Hva trenger du for å automatisere bildegenerering?
Du trenger Python 3.10 eller nyere, pakken requests, en CometAPI-nøkkel, en skrivbar utplassering for output, og minst én gjeldende bildemodell-ID.
Installer den eneste avhengigheten:
pip install requests
Sett nøkkelen på serveren, aldri i nettleserkode eller et repository:
export COMETAPI_KEY="your-key"
Base-URL-en er https://api.cometapi.com/v1, og kompatible tekst-til-bilde-jobber bruker POST /images/generations. Før en produksjonssetting, verifiser hver modell i live model catalog; katalogen returnerer gjeldende ID, støttet endepunkt, funksjoner og prismetadata uten å kreve en autorisasjonsheader.
Per 20. august 2026 listet live-katalogen disse to nyttige rutene:
| Arbeidslast | Model ID | Hvorfor den passer |
|---|---|---|
| Produktbilder med kontrollerte utdata-innstillinger | gpt-image-2 | Returnerer bruksdata og base64-bildeinnhold på den dokumenterte OpenAI-kompatible ruten |
| Annonse- og innholdskonsepter i høyt volum | doubao-seedream-4-5-251128 | Bruker samme generasjonsrute og er oppført med pris per forespørsel |
Tabellen er et utgangspunkt, ikke en påstand om at modellene har identiske kapabiliteter. Størrelse, kvalitet, format, støtte for referansebilder og responsatferd forblir modellspesifikke. Sjekk modelloppføringen og dens lenkede dokumentasjon før du sender valgfrie parametere.
Hvordan bygge en batch-arbeidsflyt for bildegenerering i Python
1. Gi hver jobb en varig ID
Bruk ett JSON-objekt per linje slik at en kø, databaseeksport eller regnearkjobb kan mate den samme arbeideren:
{"id":"sku-1001","kind":"product","prompt":"Studio product photo of a ceramic coffee dripper on a warm neutral background"}
{"id":"campaign-204","kind":"ad","prompt":"Editorial summer travel image, vivid natural light, wide composition, no text"}
{"id":"blog-088","kind":"content","prompt":"Minimal illustration of a developer automating a creative workflow, no text"}
ID-en blir output-filnavnet og manifestnøkkelen. I produksjon, bruk den som idempotensnøkkel og hopp over ID-er som allerede er markert som vellykkede før du reprosesserer en kø.
2. Ruter etter jobbtype, og valider deretter mot live-katalogen
Eksemplet mapper produktarbeid til gpt-image-2 og annonse- eller innholdsarbeid til doubao-seedream-4-5-251128. En jobb kan overstyre det valget med sitt eget model-felt. Ved oppstart laster arbeideren ned den offentlige katalogen og avviser en ID som ikke lenger er oppført.
Dette er tryggere enn å hardkode en leverandørspesifikk SDK gjennom hele applikasjonen. Du kan endre en rute i én mapping etter å ha evaluert kvalitet, latens og pris for dine egne prompt-er.
3. Begrens samtidighet i stedet for å starte hele batchen
Arbeideren starter med fire samtidige forespørsler. Det tallet er en konservativ applikasjonsinnstilling, ikke en universell tjenestegrense. Mål latens og 429-responser for kontoen din, og øk eller senk MAX_WORKERS bevisst.
Bare 408, 429 og 5xx-responser prøves på nytt med eksponentiell backoff og jitter. Autentiseringsfeil, ugyldige modell-ID-er og ikke-støttede parametere feiler umiddelbart fordi gjentatte forsøk på samme ugyldige request bare gir forsinkelse.
4. Normaliser resultatet før lagring
Bildemodeller returnerer ikke alltid samme container. Den dokumenterte GPT Image-responsen inneholder data[0].b64_json; andre kompatible modeller kan returnere data[0].url. Arbeideren håndterer begge, skriver bildet til en midlertidig fil, og gir det nytt navn først etter at nedlasting eller dekoding lykkes.
I produksjon, erstatt den lokale output/-katalogen med S3, R2, GCS eller en annen objektlagring. Ikke behandle en leverandørhostet URL som permanent lagring med mindre oppbevaringspolitikken eksplisitt sier det.
5. Registrer bruk, forsøk og estimert kostnad
Hvert resultat blir en kompakt manifestrad med jobb-ID, modell, lagret sti, status og estimert USD-kostnad når live-katalogen gir nok prisdata. Mislykkede jobber beholder feilen i stedet for å forsvinne fra batchen.
Komplett Python-skript for batch-bildegenerering
Lagre følgende som batch_image_pipeline.py, legg køen ved siden av som jobs.jsonl, og kjør python3 batch_image_pipeline.py.
import base64, json, os, random, time
from concurrent.futures import ThreadPoolExecutor
from pathlib import Path
import requests

BASE_URL = "https://api.cometapi.com/v1"
KEY = os.environ["COMETAPI_KEY"]
WORKERS = int(os.getenv("MAX_WORKERS", "4"))
OUT = Path("output")
ROUTES = {
    "product": "gpt-image-2",
    "ad": "doubao-seedream-4-5-251128",
    "content": "doubao-seedream-4-5-251128",
}

catalog = requests.get("https://api.cometapi.com/api/models", timeout=30)
catalog.raise_for_status()
CATALOG = {model["id"]: model for model in catalog.json()["data"]}

def generate(job):
    model = job.get("model", ROUTES[job["kind"]])
    if model not in CATALOG:
        raise ValueError(f"Unknown model: {model}")
    payload = {"model": model, "prompt": job["prompt"], "n": 1}
    if model == "gpt-image-2":
        payload.update(quality="low", size="1024x1024", output_format="jpeg")

    for attempt in range(4):
        response = requests.post(
            f"{BASE_URL}/images/generations",
            headers={"Authorization": f"Bearer {KEY}"},
            json=payload,
            timeout=180,
        )
        if response.status_code not in {408, 429} and response.status_code < 500:
            break
        time.sleep(2**attempt + random.random())
    response.raise_for_status()
    body = response.json()
    item = body["data"][0]

    if item.get("b64_json"):
        data = base64.b64decode(item["b64_json"])
        extension = body.get("output_format", "png")
    else:
        download = requests.get(item["url"], timeout=120)
        download.raise_for_status()
        data = download.content
        extension = {"image/png": "png", "image/webp": "webp"}.get(
            download.headers.get("content-type"), "jpg"
        )
    path = OUT / f"{job['id']}.{extension}"
    path.write_bytes(data)

    price, usage = CATALOG[model].get("pricing") or {}, body.get("usage", {})
    cost = price.get("per_request")
    if cost is None and price.get("input") is not None:
        cost = (usage.get("input_tokens", 0) * price["input"] +
                usage.get("output_tokens", 0) * price["output"]) / 1_000_000
    return {"id": job["id"], "model": model, "path": str(path),
            "estimated_usd": cost * price.get("ratio", 1) if cost is not None else None}

def safe_generate(job):
    try:
        return {"status": "success", **generate(job)}
    except Exception as error:
        return {"id": job["id"], "status": "failed", "error": str(error)}

OUT.mkdir(exist_ok=True)
jobs = [json.loads(line) for line in Path("jobs.jsonl").read_text().splitlines() if line]
with ThreadPoolExecutor(max_workers=WORKERS) as pool:
    results = list(pool.map(safe_generate, jobs))
with (OUT / "manifest.jsonl").open("w") as manifest:
    manifest.writelines(json.dumps(result) + "\n" for result in results)
Skriptet bruker gjeldende katalog ved runtime, mens de to fallback-mappingene er eksempler verifisert 20. august 2026. Sjekk dem på nytt før du publiserer eller deployer koden på en annen dato.
Hvordan teste arbeidsflyten for batch-bildegenerering
Start med én jobb og én arbeider:
MAX_WORKERS=1 python3 batch_image_pipeline.py
En vellykket GPT Image-respons følger denne strukturen:
{
  "created": 1776841943,
  "output_format": "jpeg",
  "quality": "low",
  "size": "1024x1024",
  "usage": {
    "input_tokens": 16,
    "output_tokens": 208,
    "total_tokens": 224
  },
  "data": [{"b64_json": "<base64-image-data>"}]
}
Arbeideren dekoder bildet, skriver output/<job-id>.jpeg, og legger til en vellykket rad i output/manifest.jsonl. Hvis en modell returnerer en URL i stedet, laster arbeideren den ned og lagrer den lokale stien i samme manifestformat.
Koden er syntaks-sjekket lokalt. Et live generasjonskall krever fortsatt din CometAPI-nøkkel, så kjør røyktesten med én jobb før du øker samtidigheten.
Hvor mye koster batch-bildegenerering?
Priser må tidsstemples fordi modellpriser endres. Per 20. august 2026 returnerte live CometAPI model catalog følgende basisprisfelt og en 0.8-faktoreringsratio:
gpt-image-2: $5 per 1M input tokens og $30 per 1M output tokens; anvendt ratio gir effektive satser på $4 og $24 per 1M tokens.doubao-seedream-4-5-251128: $0.04 per forespørsel; anvendt ratio gir $0.032 per forespørsel.
CometAPI pricing guide forklarer token-basert fakturering for modeller med offisiell prising og kall-basert fakturering for modeller priset per forespørsel. Skriptet leser katalogen når det kjører og bruker samme regel:
token cost = ratio × (input tokens × input rate + output tokens × output rate) / 1,000,000
request cost = ratio × per-request price
For eksempel rapporterer den dokumenterte GPT Image-responsen ovenfor 16 input tokens og 208 output tokens. Med verdiene fra katalogen 20. august gir det illustrerende resultatet et estimat på omtrent $0.005056. Den reelle totalen endres med modell, kvalitet, størrelse, prompt, forsøk og responsbruk. Behandle API-responsen og kontobruk-dashbordet som fakturagrunnlag, ikke en fast antakelse per bilde.
Budsjetter også for mislykket arbeid. Et nytt forsøk etter en ubekreftet timeout kan produsere et annet fakturerbart resultat, og et teknisk vellykket bilde som stryker i gjennomgang, bruker fortsatt budsjett. Spor både API-kostnad og akseptgrad:
effective cost per accepted image = total batch spend / approved images
Vanlige feil med bilde-API-er og hvordan du retter dem
| Symptom | Sannsynlig årsak | Løsning |
|---|---|---|
| 401 | Manglende eller ugyldig nøkkel | Sjekk servervariabelen COMETAPI_KEY |
| 400 | Ugyldig modell eller ikke-støttet valg | Sjekk live-katalogen på nytt og fjern modellspesifikke felt |
| 429 | For høy samtidighet | Senk MAX_WORKERS og behold eksponentiell backoff |
| Gjentatte 5xx | Midlertidig feil oppstrøms | Prøv på nytt med en grense, flytt så jobben til dead-letter-kø |
| Ingen lagret fil | Respons brukte en annen container | Inspiser data[0] og støtt både b64_json og url |
| Dobbel kostnad | Jobben ble spilt av etter delvis feil | Bruk varige ID-er og bekreft først etter vellykket lagring |
Ikke prøv på nytt for hver feil. En permanent 400-request forblir ugyldig, mens en ubegrenset 429-loop for nye forsøk kan gjøre en trafikkbølge til et etterslep.
Beste praksis for produksjonsbildegenerering i skala
Gå fra JSON Lines til en varig kø når flere arbeidere er involvert. Sett en synlighetstimeout lengre enn maksimal genereringstid, bekreft en jobb først etter at bildet og manifestet er lagret, og send oppbrukte jobber til en dead-letter-kø for gjennomgang.
Hold valgfrie kontroller i modellspesifikk konfigurasjon. En delt payload bør kun inneholde felles felt som model, prompt og n: 1; legg til quality, size eller output_format først etter at den valgte modelldokumentasjonen bekrefter dem. Hvis du legger til fallback-ruting, velg en modell som støtter samme oppgave og bygg payload-en på nytt for den modellen i stedet for å gjenta leverandørspesifikke valg blindt.
Lagre API-nøkkelen i en secret manager, begrens prompt-inndata, skann genererte ressurser i henhold til policyen din, og hold leverandør-URL-er ute av langvarige produktregistre. Logg jobb-ID, modell-ID, latens, forsøk, bruk, lagringssti, gjennomgangsresultat og katalogens snapshot-dato. Disse feltene lar deg sammenligne modeller etter kostnad per akseptert bilde i stedet for bare listepris.
Sett til slutt budsjettvernsrekkverk: en maksimal batch-størrelse, en grense for nye forsøk per jobb, et varsel for daglig forbruk og en stoppbetingelse når godkjenningsraten faller. Å skalere en dårlig prompt raskere er ikke en optimalisering.
Vanlige spørsmål om automatisering av bildegenerering i skala
Hva er den enkleste måten å automatisere bildegenerering i skala uten å håndtere flere API-er?
Bruk én kø og lagringsarbeidsflyt, og send deretter kompatible bilderequests gjennom én CometAPI-nøkkel og https://api.cometapi.com/v1/images/generations. Endre modell-ID i rutingslaget ditt i stedet for å vedlikeholde separat autentisering og leverandør-SDK-er.
Kan jeg sende én forespørsel og be flere bildemodeller generere samtidig?
Eksemplet sender én modell per jobb. Fan-out er en applikasjonsarbeidsflyt: dupliser en jobb med distinkte ID-er og modellverdier, og sammenlign de lagrede outputene. Dette holder kostnad og gjennomgangsstatus attribuerbar til hver modell.
Hvilken samtidighet bør jeg bruke?
Det finnes ikke et universelt tall for hver konto og modell. Start med en liten, begrenset pool som fire arbeidere, overvåk latens og 429-responser, og juster basert på evidens.
Bør jeg lagre den returnerte URL-en eller selve bildet?
Lagre bildet i din egen objektlagring. En returnert URL kan være midlertidig, mens GPT Image-modeller kan returnere base64-innhold i stedet for en URL.
Hvordan velger jeg den billigste modellen?
Beregn kostnad per akseptert bilde, ikke bare pris per kall. Inkluder token- eller forespørselsavgifter, nye forsøk, mislykkede nedlastinger, avviste ressurser, etterbehandling og menneskelig gjennomgang. Sjekk live model catalog på nytt den dagen du publiserer eller deployer.
Hvor bør jeg verifisere endepunktet og responsformatet?
Bruk CometAPI Quick Start, modellkatalogdokumentasjonen, referansen for bildegenerering og priseringsveiledningen.