
TL;DR: Hvilket alternativ til GPT-6 Astra API bør du velge?
Velg modell etter arbeidsmengde: Claude Opus 5 for den nærmeste premium-erstatteren, Claude Fable 5.1 for den mest krevende, vedvarende resonnementsevnen, GPT-5.6 Sol for minst friksjon ved OpenAI-migrasjon, Claude Sonnet 5 for produksjon i høyt volum, Gemini 3.8 Flash for rimelig multimodalt arbeid, og DeepSeek V4.1 Flash når tokenkostnad er den primære begrensningen.
Behold GPT-6 Astra for arbeidsmengder der sterkere computer use, autonom utførelse, vitenskapelig resonnement eller cybersikkerhetsytelse materielt reduserer nye forsøk og menneskelig inngripen.
Viktige punkter: Hva betyr mest når du erstatter GPT-6 Astra?
- GPT-6 Astra er vanskelig å erstatte på sine sterkeste agentiske oppgaver. Den offisielle GPT-6 Astra-benchmarktabellen viser 57.9% på Terminal-Bench 4.0, 97.6% på FrontierMath Tier 4 og 96.0% på GPQA Diamond.
- Claude Opus 5 er det mest balanserte direkte alternativet å teste først. Anthropic priser Opus 5 til $5/$25 per million input-/output-tokens, halvparten av Astras grunnpriser.
- Claude Fable 5.1 er ikke et budsjettalternativ. Dets $10/$50 input-/output-prising matcher Astras listepris, mens utvalgte kunnskaps- og langhorisont-resonnerings evalueringer favoriserer Fable 5.1.
- GPT-5.6 Sol er den enkleste nedgraderingen snarere enn et ekte plattformbytte. Kontekstvindu på 1,05M, maks 128K utdata og $4/$20-prising reduserer migrasjonsfriksjon for OpenAI-applikasjoner.
- Gemini 3.8 Flash tilbyr et sterkt forhold mellom pris og ytelse for hostet bruk. Dets introduksjonspris i 2026 er $0.75/$3.75 per million input-/output-tokens.
- DeepSeek V4 Flash er i en annen kostnadsklasse. Offisielle topp- og lavtrafikkpriser ligger langt under premium-modellenes nivåer, men lavere tokenkostnad etablerer ikke tilsvarende agent-suksessrater.
- Det beste produksjonsmålet er vanligvis kostnad per akseptert fullført oppgave. Inkluder nye forsøk, verktøyfeil, ventetid, bruk av output-tokens og menneskelig etterarbeid.
Hva er GPT-6 Astra API?
OpenAI posisjonerer GPT-6 Astra som sin flaggskipsmodell for komplekst end-to-end-arbeid. API-spesifikasjonen inkluderer et kontekst-vindu på 1,050,000 tokens og 128,000 tokens maksimalt utdata, tekst- og bildeinput, støtte for resonnementstokens og fem nivåer for resoneringsinnsats: low, medium, high, xhigh og max.
Astra skiller seg fra en konvensjonell chatbot fordi den er designet for langvarig kjøring. Den offisielle oversikten over kapabiliteter vektlegger computer use og profesjonelt arbeid, sammen med programvareutvikling, nettlesing, vitenskap, cybersikkerhet og komplekst resonnement.
| GPT-6 Astra-spesifikasjon | Verdi |
|---|---|
| API-modell-ID | gpt-6-astra |
| Leverandør | OpenAI |
| Kontekstvindu | 1,050,000 tokens |
| Maksimalt utdata | 128,000 tokens |
| Inndata | Tekst, bilder |
| Utdata | Tekst |
| Kunnskapsavgrensning | April 30, 2026 |
| Resonneringsnivå | Low, medium, high, xhigh, max |
| Standardpris inndata | $10 / 1M tokens |
| Bufret inndata | $1 / 1M tokens |
| Standardpris utdata | $50 / 1M tokens |
| Grense for lang kontekst | Mer enn 272K input-tokens |
Merknad om prising for lang kontekst:
forespørsler over 272K input-tokens
prises på nytt for hele forespørselen til $20/M inndata og $75/M utdata. Budsjetter disse forespørslene separat.
Hvorfor team ser forbi GPT-6 Astra
Astra er mest overbevisende når dens ekstra kapabilitet eliminerer mislykkede forsøk, verktøyfeil, manuell inngripen eller gjentatte kall til svakere modeller. Dens premiumprising er vanskeligere å rettferdiggjøre for oppsummering, ekstraksjon, klassifisering, rutinemessig RAG, ordinær chat og standard kodegenerering.
Team evaluerer derfor alternativer for å redusere kostnad, holde seg innenfor et eksisterende leverandørøkosystem, forbedre cache-økonomi, legge til multimodal støtte eller bruke en raskere modell for rutinetrafikk mens Astra reserveres for eskalering.
Benchmark-sammenligning og begrensninger
Evidensmerknad: Tabellen bruker OpenAIs publiserte sammenligningsrammeverk for å plassere flere alternativer under et felles oppsett. Disse leverandørrapporterte poengsummene kan endres med modelsnapshots, prompt, verktøy og evalueringsmetodikk; bruk dem til å lage en shortlist, og valider deretter finalistene på representative produksjonsoppgaver.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 52.6% | 19.1% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | 73.7% | 73.8% |
| FrontierCode 1.1 Extended | 64.5% | 60.6% | 63.6% | 63.6% | 56.3% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% | 95.3% |
| FrontierMath Tier 4 | 97.6% | 83.0% | 87.8% | 73.2% | — |
| Humanity’s Last Exam, with tools | 57.2% | — | 65.0% | 63.6% | — |
Resultatene viser hvorfor det er misvisende å kalle en modell en universell “Astra-erstatter”. Astra har et tydelig forsprang på flere agentiske og vitenskapelige evalueringer, mens Fable 5.1 presterer bedre på Humanity’s Last Exam, og flere alternativer ligger svært nær på DeepSWE.
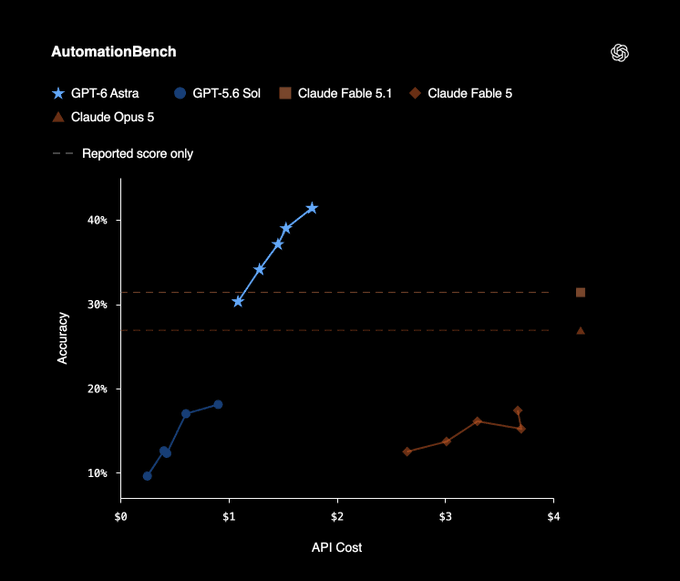
Offisiell OpenAI AutomationBench-benchmarkgrafikk.
Offentlige benchmarkindekser kan også endres etter hvert som metodikk og modelsnapshots revideres. Bruk dem til å lage en shortlist, ikke som erstatning for arbeidslastspesifikk evaluering.
Alternativer til GPT-6 Astra
Ingen enkeltmodell erstatter Astra på tvers av alle arbeidsmengder. Det mest praktiske valget avhenger av kapabiliteten du trenger, leverandørøkosystemet du allerede bruker, og kostnaden ved mislykkede eller gjentatte kjøringer.
| Alternativ | Offisiell input-/output-pris per 1M tokens | Kontekst | Beste grunn til å velge det |
|---|---|---|---|
| Claude Opus 5 | $5 / $25 | 1M | Nærmeste samlede premium-erstatter |
| Claude Fable 5.1 | $10 / $50 | 1M | Hardeste resonnement og langvarige agenter |
| GPT-5.6 Sol | $4 / $20 | 1.05M | Minst friksjon ved OpenAI-migrasjon |
| Claude Sonnet 5 | $2 / $10 | 1M | Produksjon i høyt volum |
| Gemini 3.8 Flash | $0.75 / $3.75 kampanje | 1M | Rimelig multimodalt og batch-arbeid |
| DeepSeek V4.1 Flash | $0.22–$0.44 / $0.66–$1.32 | 1M | Laveste tokenkostnad og høyt volum |
Claude Opus 5
Hvorfor vurdere det
Claude Opus 5 er det første alternativet å teste når et produkt trenger premium-resonnering, koding eller profesjonell-arbeidsytelse til en lavere listepris enn Astra.
Pris, kontekst og cache
Anthropic lister Claude Opus 5 til $5/M inndata og $25/M utdata med et kontekstvindu på 1M tokens. Bekreft gjeldende cache-vilkår før produksjonsbudsjettering.
Hvor det presterer godt
Det er konkurransedyktig på koding, analyse, profesjonell skriving og agentarbeidsflyter; den siterte benchmarktabellen plasserer det nær Astra på DeepSWE og FrontierCode.
Begrensninger
Det overgår ikke Astra konsekvent. Astra forblir et sterkere kandidat når computer operation, avansert autonom utførelse, cybersikkerhet eller OpenAI-native verktøy er sentrale for produktet.
Best for / Unngå når
Best for: premium-kodingsagenter, kompleks analyse og profesjonell skriving. Unngå når: arbeidsflyten er sterkt avhengig av Astra-spesifikke verktøy eller computer-use-kapasitet.
Claude Fable 5.1
Hvorfor vurdere det
Claude Fable 5.1 er et konkurrerende flaggskip for de mest krevende resonnement-, forsknings-, kode- og langvarige agentoppgavene, snarere enn en lavkost-erstatter.
Pris, kontekst og cache
Dets $10/M inndata og $50/M utdata matcher Astras listepriser. Kontekstvindu på 1M tokens og $0.25/M cache-lesepris kan forbedre økonomien når store prompt gjenbrukes ofte.
Hvor det presterer godt
Det er spesielt attraktivt for vedvarende resonnement og cache-tunge agenter; i den siterte sammenligningen leder det Astra på Humanity’s Last Exam med verktøy.
Begrensninger
Det reduserer ikke listeprisen for tokens, og Astra beholder fordeler på flere agentiske og vitenskapelige benchmarks samt OpenAI-native verktøy.
Best for / Unngå når
Best for: maksimal resonnementskvalitet og gjentatte langkontekst-arbeidsflyter. Unngå når: primærmålet er en stor reduksjon i standard tokenpriser.
GPT-5.6 Sol
Hvorfor vurdere det
GPT-5.6 Sol tilbyr minst friksjon for applikasjoner som allerede er bygget rundt OpenAI-kompatibel atferd og verktøy.
Pris, kontekst og cache
Den siterte modellspesifikasjonen lister $4/M inndata og $20/M utdata, et kontekstvindu på 1.05M tokens og 128K maks utdata. Verifiser gjeldende vilkår for bufret inndata før endelig budsjettering.
Hvor det presterer godt
Det ligger nær Astra på DeepSWE og GPQA Diamond, mens det koster betydelig mindre under standard kortkontekst-nivå.
Begrensninger
Gapet øker på oppgaver representert av Terminal-Bench og FrontierMath, så besparelser kan forsvinne hvis svakere oppgavefullføring skaper nye forsøk eller manuell reparasjon.
Best for / Unngå når
Best for: eksisterende OpenAI-applikasjoner og generelle arbeidsmengder som ikke trenger Astras sterkeste agentiske kapabiliteter. Unngå når: arbeidsmengden gjentatte ganger drar nytte av Astras store benchmark-gevinster.
Claude Sonnet 5
Hvorfor vurdere det
Claude Sonnet 5 er et pragmatisk produksjonsstandardvalg for kompetent, repeterbart kunnskapsarbeid som ikke krever et frontier-flaggskip på hver forespørsel.
Pris, kontekst og cache
Dets siterte permanente pris er $2/M inndata og $10/M utdata med et kontekstvindu på 1M tokens. Bekreft gjeldende cache-vilkår for distribusjoner med tungt prompt-gjenbruk.
Hvor det presterer godt
Det passer til ticket-klassifisering, dokumentekstraksjon, standard RAG, innholdstransformasjon, kodeforklaring, rutinemessig funksjonskalling og strukturert generering.
Begrensninger
Det kan ikke pålitelig erstatte Astra på hver langhorisont- eller frontier-resonneringsoppgave.
Best for / Unngå når
Best for: produksjonstrafikk i høyt volum og rutinepreget forretningsautomatisering. Unngå når: feil på en vanskelig agentisk oppgave er dyrere enn premiumen for en flaggskipsmodell.
Gemini 3.8 Flash
Hvorfor vurdere det
Gemini 3.8 Flash kombinerer multimodal inndata, stor kontekst og lav hostet-API-kostnad for dokumenter, media, koding og batch-pipelines.
Pris, kontekst og cache
Den siterte introduksjonsprisen er $0.75/M inndata og $3.75/M utdata til 31. desember 2026, med et kontekstvindu på 1M tokens og rabattert caching i kampanjeperioden.
Hvor det presterer godt
Det passer godt til multimodal ekstraksjon, PDF-er, lyd, video, bilder, store dokumentmengder, batch-analyse og kostnadssensitive kodearbeidsmengder.
Begrensninger
Kampanjeprisingen er tidsbegrenset, og de vanskeligste autonome agent- eller computer-use-oppgavene krever fortsatt arbeidslastspesifikk validering mot Astra.
Best for / Unngå når
Best for: rimelig multimodalt arbeid og batch-prosessering i høyt volum. Unngå når: applikasjonen krever den sterkeste autonome utførelsen uansett tokenkostnad.
DeepSeek V4.1 Flash
Hvorfor vurdere det
DeepSeek V4.1 Flash er kostnadsførst-alternativet for høy gjennomstrømning innen resonnement, koding, oppsummering, ekstraksjon, klassifisering og offline-prosessering.
Pris, kontekst og cache
Den siterte topp-/lavtrafikkplanen viser cache-treff inndata til $0.007–$0.014/M, cache-miss inndata til $0.22–$0.44/M og utdata til $0.66–$1.32/M, med et kontekstvindu på 1M tokens. Sjekk den gjeldende V4.1-prissiden før publisering.
Hvor det presterer godt
Det er attraktivt når tokenkostnad dominerer og applikasjonen kan bruke ruting, validering eller offline kvalitetskontroller for å håndtere variasjon.
Begrensninger
En mye lavere tokenpris etablerer ikke tilsvarende suksess for autonome oppgaver. Pålitelighet, verktøyatferd, ventetid og akseptgrad må måles på mål-arbeidslasten.
Best for / Unngå når
Best for: storskala, kostnadssensitiv prosessering med validering. Unngå når: en mislykket autonom kjøring med høy verdi vil oppveie tokensparingen.
GPT-6 Astra vs alternativer: Hvilken modell vinner i hver kategori?
Når man setter pris, arkitektur, kontekst og benchmark-evidens sammen, får man en mer nyttig beslutningstabell enn å rangere modeller fra første til sjette.
| Kategori | Beste valg | Hvorfor |
|---|---|---|
| Overordnet Astra-alternativ | Claude Opus 5 | Sterk nær-frontier-ytelse til halvparten av Astras listepris |
| Maksimalt resonnement | Claude Fable 5.1 | Flaggskipsresonnement og sterk langhorisont-ytelse |
| Forbli innen OpenAI | GPT-5.6 Sol | Lignende API-økosystem med 60% lavere tokenpriser |
| Produksjon i høyt volum | Claude Sonnet 5 | Sterk kvalitet til $2/$10 |
| Multimodal pris/ytelse | Gemini 3.8 Flash | 1M kontekst pluss svært lav introduksjonspris i 2026 |
| Laveste API-kostnad | DeepSeek V4.1 Flash | $0.22–$0.44 inndata og $0.66–$1.32 utdata |
| Computer-use-tunge agenter | GPT-6 Astra | En av Astras tydeligste differensiatorer |
| Vitenskapelige og vanskelige matematiske arbeidsflyter | GPT-6 Astra | Svært sterke FrontierMath- og science-agent-resultater |
| Cache-tunge lange agenter | Claude Fable 5.1 | $0.25/M cache-lesinger |
Det viktigste resultatet er at GPT-6 Astra fortsatt vinner noen kategorier. En artikkel om alternativer bør ikke antyde at en billigere modell universelt erstatter den. Astra blir dyrt når det brukes overalt; det kan fortsatt være økonomisk når høyere oppgavefullføringsrate erstatter flere forsøk med svakere modeller.
Hvor mye kan du faktisk spare ved å erstatte GPT-6 Astra API?
Tenk på en arbeidsmengde som bruker 1 million ubufrede input-tokens og 200,000 output-tokens. Ser bort fra cache-rabatter, verktøysgebyrer, nye forsøk, batch-priser og tillegg for lang kontekst:
| Modell | Omtrentlig API-kostnad |
|---|---|
| GPT-6 Astra | $20.00 |
| Claude Fable 5.1 | $20.00 |
| Claude Opus 5 | $10.00 |
| GPT-5.6 Sol | $8.00 |
| Claude Sonnet 5 | $4.00 |
| Gemini 3.8 Flash kampanjepris | $1.50 |
| DeepSeek V4.1 Flash lavtrafikk | $0.35 |
Den grunnleggende beregningen er:
total_cost =
(input_tokens / 1,000,000 * input_rate)
+
(output_tokens / 1,000,000 * output_rate)
Dette enkle eksempelet demonstrerer også hvorfor tokenprising ikke kan være den eneste metrikken. Hvis en $20 Astra-forespørsel lykkes én gang, mens en $4-modell krever seks forsøk, flere verktøy-retrier og menneskelig reparasjon, var Astra faktisk billigere.
En bedre produksjonsmetrisk er:
cost_per_accepted_task =
total_model_and_tool_cost
/
number_of_tasks_accepted_without_rework
Følg med på dette tallet sammen med ventetid, oppgavesuksess, retry-rate, verktøykall-feil og eskalering-til-menneske-rate.
Hvordan kan du teste GPT-6 Astra-alternativer via CometAPI?
En praktisk fordel ved et multimodell-API-lag er at evaluering ikke trenger å bli et leverandørintegrasjonsprosjekt. CometAPI tilbyr GPT-6 Astra API, GPT-5.6, Claude Fable 5.1, Claude Sonnet 5, Gemini 3.8 Flash og DeepSeek V4.1 Flash gjennom én modellsamling.
Med en OpenAI-kompatibel klient kan modellen gjøres konfigurerbar i stedet for hardkodet:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Gå gjennom denne migrasjonsplanen og identifiser de tre antagelsene med høyest risiko.",
        }
    ],
)

print(response.choices[0].message.content)
Du kan kjøre det samme evalueringssettet på nytt ved å bruke modell-ID-er som:
gpt-6-astra
gpt-5.6
claude-fable-5-1
claude-sonnet-5
gemini-3.8-flash
deepseek-v4-flash
Dette er generelt mer informativt enn å velge et alternativ kun fra en benchmark-ledertabell. Ta 100–500 representative produksjons-prompt og registrer oppgavesuksess, menneskelig aksept, nye forsøk, verktøyfeil, totale tokens, ventetid og total API-kostnad.
Bør du erstatte GPT-6 Astra med én modell eller bruke model routing?
For mange applikasjoner er det feil optimalisering å erstatte Astra med én universell modell. En mer effektiv arkitektur ser slik ut:
- Routine-trafikk → Claude Sonnet 5, Gemini 3.8 Flash, eller DeepSeek V4.1 Flash
- Vanskelig resonnement → Claude Opus 5 eller GPT-5.6 Sol
- Svært vanskelige langhorisont-oppgaver → Claude Fable 5.1 eller GPT-6 Astra
- Computer-use eller Astra-spesifikke agent-arbeidsflyter → GPT-6 Astra
Dette gjør Astra til en eskaleringsmodell snarere enn standardmodellen. Hvis bare 10% av forespørslene virkelig krever frontier-agent-ytelse, betyr ruting av 100% av trafikken gjennom Astra at du betaler premiumen for de andre 90% også.
Hvilket alternativ til GPT-6 Astra API bør du velge?
Velg Claude Opus 5 hvis du vil ha den nærmeste samlede balansen mellom kvalitet og pris.
Velg Claude Fable 5.1 hvis maksimalt resonnement er viktigere enn å redusere listepriser.
Velg GPT-5.6 Sol hvis du allerede bruker OpenAI og ønsker minst mulig integrasjonsendring.
Velg Claude Sonnet 5 hvis mesteparten av produksjonstrafikken er kompetent, men ordinært kunnskapsarbeid.
Velg Gemini 3.8 Flash hvis multimodalitet, skala og lav hostet-API-kostnad er viktige.
Velg DeepSeek V4.1 Flash hvis tokenkostnad er den dominerende begrensningen og arbeidsmengden din tåler mer evaluering og validering.
Og velg GPT-6 Astra når applikasjonen din virkelig drar nytte av sterkere computer use, vanskelig autonom programvarearbeid, vitenskapelig resonnement eller andre agentiske kapabiliteter.
Den største feilen er ikke å velge “feil” frontier-modell. Det er å betale frontier-modellpriser for forespørsler som aldri trengte en frontier-modell i utgangspunktet.
FAQ
Hva er det beste overordnede alternativet til GPT-6 Astra API?
Claude Opus 5 er et av de sterkeste general-purpose-erstatterne. Det tilbyr et 1M kontekstvindu, sterke kode- og agentkapabiliteter og $5/$25 listeprising—halvparten av Astras standard tokenpriser.
Hva er det billigste alternativet til GPT-6 Astra?
Blant modellene som dekkes her, har DeepSeek V4.1 Flash den laveste førsteparts tokenprisingen. Dens gjeldende lavtrafikkpris er $0.22/M ubufret inndata og $0.66/M utdata. Det bør imidlertid ikke antas å matche Astras autonome oppgavesuksess bare fordi det er billigere.
Er Claude Fable 5.1 bedre enn GPT-6 Astra?
Ingen av modellene vinner hver arbeidsmengde. OpenAIs sammenligning gir Astra betydelige fordeler på FrontierMath Tier 4 og Terminal-Bench 4.0, mens Fable 5.1 scorer høyere på Humanity’s Last Exam med verktøy.
Er GPT-5.6 Sol fortsatt verdt å bruke etter GPT-6 Astra?
Ja. Dets $4/$20 standard API-prising er betydelig under Astras $10/$50, mens det beholder et kontekstvindu på 1.05M. Det kan derfor være et bedre standardvalg for arbeidsmengder der Astras gevinster ikke materielt forbedrer oppgavefullføring.
Er Gemini 3.8 Flash god nok til å erstatte GPT-6 Astra?
For enkelte kode-, multimodale, dokument- og batch-prosessering-arbeidsmengder, ja. Det er dramatisk billigere og har et kontekstvindu på 1M. For de vanskeligste autonome agent- og computer-use-oppgavene forblir Astra det sterkere valget.
Har GPT-6 Astra en prisulempe for svært lange prompt?
Ja. OpenAI anvender et høyere prisnivå når inndata overstiger 272K tokens, så forespørsler med lang kontekst bør budsjetteres separat.
Bør jeg sammenligne modeller etter tokenpris eller benchmark-score?
Bruk begge kun som screening-metrikker. Produksjonsmetrikken som oftest betyr mest er kostnad per akseptert fullført oppgave, inkludert resonnementstokens, nye forsøk, verktøykall, ventetid og menneskelig etterarbeid.
Kan jeg bruke flere GPT-6 Astra-alternativer i samme applikasjon?
Ja. I mange applikasjoner er model routing å foretrekke fremfor å binde hver forespørsel til én modell. En lavkostmodell kan håndtere rutineforespørsler, mens sterkere modeller håndterer stadig vanskeligere eskaleringer.