
TL;DR: Velg DeepSeek-V4-Flash for rask, lav-latens tekstautomatisering; velg GLM-5.3-Flash for multimodale kapabiliteter, overlegen agent-benchmarking og svært effektiv privat serverhosting for lange kontekster. Begge modellene tilbyr åpne vekter under MIT-lisensen**** og er utgitt under den permissive MIT-lisensen.
DeepSeek-V4-Flash**** er et bedre valg hvis du vil ha en ultrarask, høy-gjennomstrømming, tekst-only API for tradisjonelle kodingssløyfer og massiv batch-prosessering. Den oppnår 50 på Artificial Analysis Intelligence Index, genererer opptil 122+ tokens/sek med sin integrerte DSpark spekulative dekoder-motor, og tilbyr utenom-rushtid API-satser ned til $0.22/$0.66 per million inndata-/utdatatokens.
GLM-5.3-Flash er det mer allsidige valget når native multimodalitet, visual-in-the-loop-programmering og svært effektiv egenforvaltet skalering kreves. Den oppnår 57 på Artificial Analysis Intelligence Index, utnytter en hybrid lineær-og-spars oppmerksomhetsmekanisme (KDA + NoPE Sparse MLA) for å redusere KV-cacheminne med 4.44× ved 1M kontekst, og har innebygd visuell resonnering. API-et er priset svært konkurransedyktig til $0.15/$0.50 per million inndata-/utdatatokens (kampanjesatser ned til $0.075/$0.25).
Viktige punkter
- DeepSeek-V4-Flash gikk fra den første forhåndsvisningen på DeepSeek API News Announcement til sin offisielle lansering på Hugging Face, med Token-wise Compression, DeepSeek Sparse Attention (DSA) og DSpark spekulativ dekoding for å øke generasjonshastigheter.
- GLM-5.3-Flash ble lansert August 26, 2026, etter å ha blitt svært populær under sin anonyme testfase på OpenRouter under kodenavnet "Ox Alpha."
- GLM-5.3-Flash leder den samlede Artificial Analysis Intelligence Index med 57 poeng sammenlignet med 50 poeng for DeepSeek-V4-Flash-0731, noe som reflekterer sterkere total kapasitet på kompleks resonnering og agentoppgaver.
- Begge arkitekturer er Mixture-of-Experts (MoE)-modeller med svært slanke beregningsfotavtrykk under inferens: DeepSeek aktiverer 13B av 284B totale parametere per token, mens GLM aktiverer 18B av 320B.
- Begge modellene har fullt åpne vekter og distribueres under MIT-lisensen, noe som gir maksimal frihet for kommersialisering i enterprise, tilpasset finjustering og on-premise-distribusjon.
DeepSeek-V4-Flash vs GLM-5.3-Flash: Rask sammenligning
| Spesifikasjon | DeepSeek-V4-Flash-0731 | GLM-5.3-Flash |
|---|---|---|
| Utvikler | DeepSeek-ai | Z.ai (Zhipu AI) |
| Utgivelsesdato | July 31, 2026 | August 26, 2026 |
| Modell-ID | deepseek-v4-flash | glm-5.3-flash |
| Hugging Face-repositorium | deepseek-ai/DeepSeek-V4-Flash | zai-org/GLM-5.3-Flash |
| Arkitektur | MoE; DSA + tokenvis komprimering | MoE; KDA + NoPE Sparse MLA + mHC |
| Totalt antall parametere | 284B (304B med DSpark-modul) | 320B |
| Aktive parametere | 13B per token | 18B per token |
| Kontekstvindu | 1,000,000 tokens | 1,048,576 / about 1M tokens |
| Inndata / utdata | Tekst → tekst | Tekst + bilde + video + fil → tekst |
| Resonnering | Konfigurerbar (Thinking / Non-Thinking) | Tre nivåer (Low / High / Max) |
| Funksjon-/verktøybruk | JSON Schema / Tool Calls | ToolCalls, constraints, dynamisk verktøyinnlasting |
| Åpne vekter | Ja (MIT-lisens) | Ja (MIT-lisens) |
| AA Intelligence Index | 50 | 57 |
| Offisiell pris (1M tokens) | Peak: $0.44 / $1.32 Off-peak: $0.22 / $0.66 | List: $0.15 / $0.50 Promo: $0.075 / $0.25 |
| Best egnet | Høy-gjennomstrømmingsagenter, rask tekstgenerering | Visuell programmering, tilpassede on-prem-distribusjoner |
Hva er DeepSeek-V4-Flash?
DeepSeek-V4-Flash er en lett, hyperrask MoE-modell konstruert for å støtte autonome utvikleragenter og massive tekstprosesseringstasker. Opprinnelig forhåndsvist på DeepSeek API News Announcement, mottok modellen en stor ettertreningsoppgradering i sin offisielle utgivelse som DeepSeek-V4-Flash-0731 på Hugging Face.
Modellen er optimalisert for ren tekstgjennomstrømming, strukturert API-kalling og rask programkodekjøring. Den minimerer både latens og kost per token-inferens, og retter seg mot multirunde programvareutviklingssløyfer der hastighet og kostnad er avgjørende.
Hva ble endret fra forhåndsvisningen?
Den offisielle 0731-versjonen inkluderer en valgfri, samskolert spekulativ utkastmodell som øker den totale lokale parameterstørrelsen til 304B. Ved hosting opererer dette spekulative dekodingsrammeverket (DSpark) sammen med den aktive 13B-banen for å akselerere generasjonshastigheter til 122.7 tokens per sekund.
I tillegg ble tilpasningsprosessen omfattende trent på nytt med forsterkningslæring (RL) i sandkassebaserte kjøringsmiljøer, noe som gir langt høyere pålitelighet i flertrinns terminalarbeid, skallskripting og strukturert verktøybruk.
DeepSeek-V4-Flash-spesifikasjoner
| Egenskap | DeepSeek-V4-Flash-0731 |
|---|---|
| Kontekst | 1,000,000 tokens |
| Modaliteter | Tekstinn; tekstut (standardmodell) |
| Resonnering | Støtter Non-thinking og Thinking-moduser |
| Native API-kapasiteter | JSON Output, Tool Calls, Responses API |
| Kunnskapsavgrensning | Uoppgitt |
| Standardpriser (per MTok) | Peak: $0.44 Input / $0.014 Cached / $1.32 Output Off-peak: $0.22 Input / $0.007 Cached / $0.66 Output |
Hva er GLM-5.3-Flash?
GLM-5.3-Flash er Z.ai sin flaggskip, åpne-vekter, multimodale MoE-modell. Offisielt introdusert på Z.ai Blog den August 26, 2026, er modellen designet for å utføre svært kompleks agentkjøring, automatisert nettnavigasjon og visuell dokumentresonnering til standard "Flash"-nivåkostnader. Vektene er offentlig tilgjengelige på Hugging Face.
Modellen er pre-trent på et massivt 30-billions tokens multimodalt datasett, noe som gjør visuelle innganger til en native modalitet i stedet for en ettertanke. Den retter seg mot programvareutvikling, robotisert prosessautomatisering og multimodal databaseforespørsel.
Hybrid oppmerksomhet, mHC og spars MoE-skalerings
GLM-5.3-Flash skiller seg ut gjennom tre arkitektoniske pilarer:
- Hybrid Attention: Som omtalt på Z.ai Blog, kombinerer modellen Kimi Delta Attention (KDA) med NoPE Sparse MLA (Multi-head Latent Attention uten posisjonell koding). Dette hybride oppmerksomhetslaget komprimerer projeksjonsstørrelsene til keys og values, kutter KV-cachelagring med 4.44× og reduserer oppmerksomhetsberegninger med 3.01× under 1M-kontekst-evalueringer.
- Stable LatentMoE: Med 896 totale eksperter og nøyaktig 16 aktivert per token unngår modellen ekspert-rutingskollaps og forblir stabil under lange, flertrinns inferensspor.
- Manifold-Constrained Hyper-Connections (mHC): Denne teknikken stabiliserer dype gradienter på tvers av dens 45-lags struktur og optimaliserer maskinvareytelse når den kjøres på distribuerte GPU-klynger eller lokale AI-brikker.
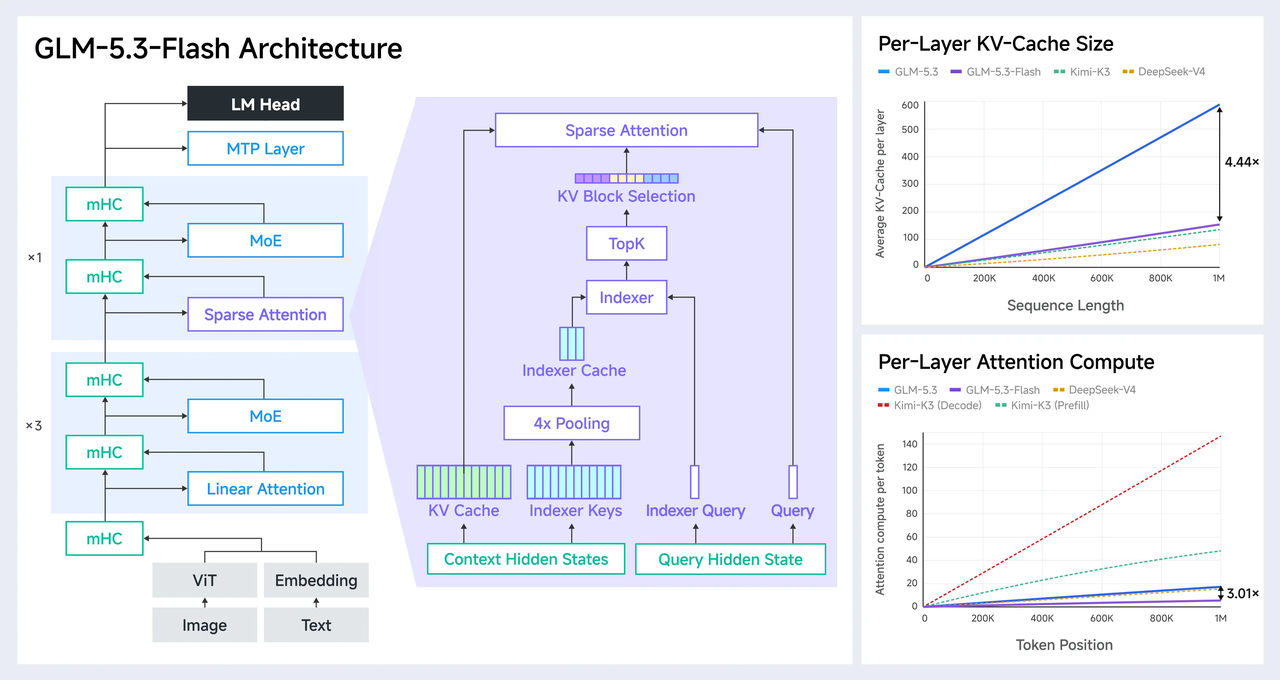
GLM-5.3-Flash: Arkitektur for ekstrem effektivitet Kilde: z.ai
GLM-5.3-Flash-spesifikasjoner
| Egenskap | GLM-5.3-Flash |
|---|---|
| Totale / aktive parametere | 320B / 18B |
| Arkitektur | MoE med hybrid spars og lineær oppmerksomhet |
| Eksperter | 896 totalt; 16 aktivert per token |
| Kontekst | 1,048,576 tokens (~1M) |
| Visjon | Naturlig multimodal (tekst, bilde, video, dokumentfil) |
| Resonnering | Støtter Low, High, Max thinking-moduser |
| Verktøy | ToolCalls, constraints, dynamisk verktøyinnlasting |
| Åpne vekter | Tilgjengelig på Hugging Face (MIT-lisens) |
| Offisiell prising (per MTok) | List: $0.15 Input / $0.03 Cached / $0.50 Output Promo (ends Sept 9): $0.075 Input / $0.015 Cached / $0.25 Output |
DeepSeek-V4-Flash vs GLM-5.3-Flash: Funksjonssammenligning
Arkitektur og parametereffektivitet
DeepSeek-V4-Flash opererer en arkitektur med 284B totale parametere (13B aktive) med en samskolert spekulativ utkastmodell (som øker lokal distribusjonsstørrelse til 304B). GLM-5.3-Flash bruker 320B totale parametere (18B aktive) over et svært sparsomt 45-lags oppsett. Begge modellene aktiverer svært få parametere per token, slik at de kan yte i høy hastighet typisk for mye mindre modeller, samtidig som de beholder den rike kunnskapsrepresentasjonen til en massiv modell.
Oppmerksomhetsmekanisme og minneoptimalisering
DeepSeek-V4-Flash benytter DeepSeek Sparse Attention (DSA) og tokenvis komprimering. Den analyserer dynamisk sekvensstrukturer og komprimerer redundante tokens (f.eks. standard kodestrukturer eller repetitive systemoverskrifter) under lang prompt-prosessering.
GLM-5.3-Flash kombinerer lineær KDA med latent projeksjon (NoPE Sparse MLA). Dette fjerner eksplisitte posisjonelle kodinger fra key/value-komprimeringsblokken, reduserer minneavtrykket til den fysiske KV-cachen til bare 22.5% av tradisjonelle oppsett. Dette gjør at minnebegrensede klynger kan støtte betydelig høyere samtidighet under langkontekst-arbeidslaster.
Modalitet og multimodal dybde
DeepSeek-V4-Flash-0731 er en tekst-only modell. Den utmerker seg i å parse tekniske filer, JSON-skjemaer og strukturell markdown. For visuelle parsingoppgaver må utviklere bruke en separat multimodal eksperimentell modell (deepseek-v4-flash-vision-exp).
GLM-5.3-Flash er naturlig multimodal. Den aksepterer høyoppløselige bilder, videoer og komplekse kontordokumentfiler (PDF-er, PPTX-er, regneark) direkte. Denne native multimodaliteten støtter "visual-in-the-loop"-programvareutvikling, der modellen kan inspisere et rendret UI-oppsett, oppdage justeringsproblemer og iterativt korrigere sin egen kode uten manuell utviklerintervensjon.
Lisensiering og åpenhet
Begge modellene er utgitt under den svært permissive MIT-lisensen. Dette gir bedriftsutviklere full frihet til å modifisere, distribuere, underlisensiere og kommersielt distribuere modellvektene lokalt, innenfor en privat VPC, eller inne i luftgapede on-premise skyinfrastrukturer.
DeepSeek-V4-Flash vs GLM-5.3-Flash: Benchmark-sammenligning
Ved evaluering på de samme datasett under identiske testoppsett, presterer begge modellene konkurransedyktig på programvareutvikling og agentautomatiseringsoppgaver.
Koding og agentytelse
| Benchmark | GLM-5.3-Flash (Z.ai) | DeepSeek-V4-Flash-0731 |
|---|---|---|
| Artificial Analysis Index v4.1.1 | 57 | 50 |
| Terminal Bench 2.1 (Acc) | 84.3 | 82.7 |
| DeepSWE v1.1 (GitHub Issues) | 63.4 | 54.4 |
| Toolathlon (Verified / Pass@1) | 78.4 | 70.3 |
| NL2Repo (Acc) | 56.3 | 54.2 |
| Automation Bench (Acc) | 48.8 | 25.1 |
| GDPval-AA v2 (Agent Elo) | 1773 | 1554 |
GLM-5.3-Flash opprettholder et forsprang på de fleste agent- og programvareutviklingsbenchmarker, med 63.4% på DeepSWE v1.1 og 84.3 på Terminal Bench 2.1. Den 18B aktive parameterbanen og flerturns ettertreningsjustering hjelper den å håndtere komplekse lager- og operativsysteminteraksjoner.
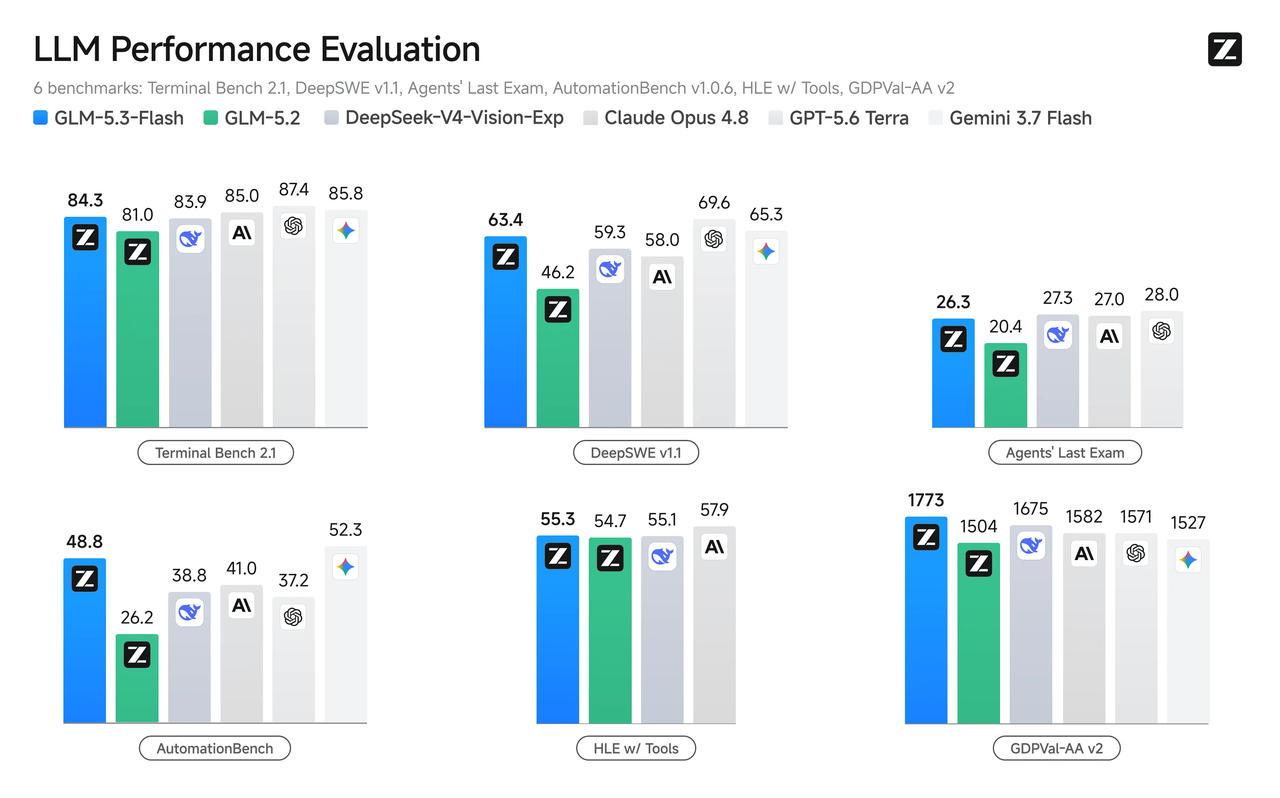
GLM-5.3-Flash Benchmark: 84.3 på Terminal Bench 2.1 Kilde: z.ai
DeepSeek-V4-Flash-0731 er også svært kapabel, med 82.7 på Terminal Bench 2.1 og 70.3 på Toolathlon. Den leverer pålitelig ytelse på deterministiske API-strukturer og streng funksjonskalling.
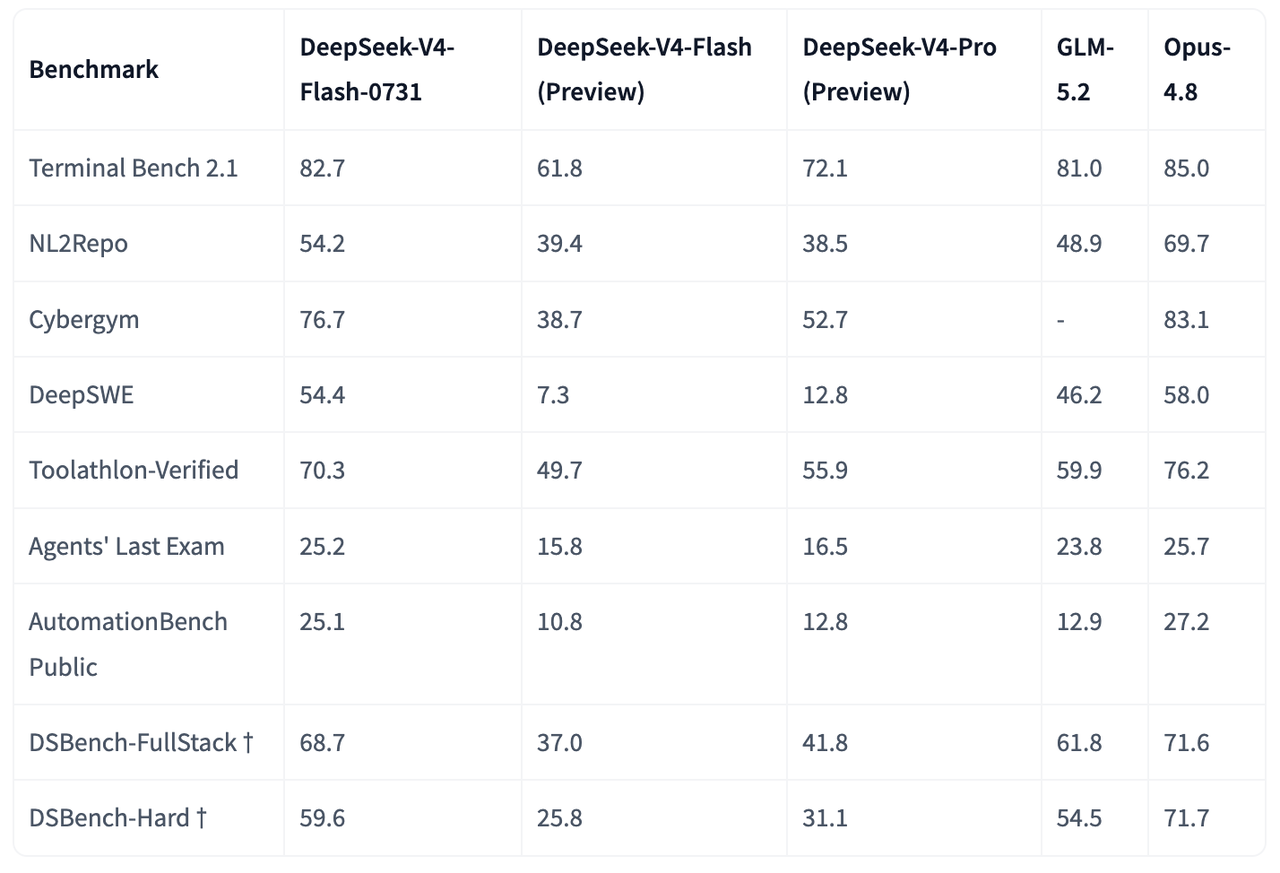
DeepSeek-V4-Flash Benchmark 0731: 82.7 på Terminal Bench 2.1 Kilde: Hugging Face
Multimodal og visuell resonnering
GLM-5.3-Flash sin native multimodale trening gir den en tydelig fordel på visuelle resonneringsoppgaver:
- OfficeQA Pro: 62.4 (GLM-5.3-Flash) vs 57.9 (DeepSeek-V4-Vision eksperimentell gren). GLM viser overlegen native parsing av innebygde bilder, strukturerte PDF-tabeller og lysbildepresentasjoner.
- Chartography with Tools: 78.0 (GLM-5.3-Flash). Modellen viser utmerket evne til å ta inn systemflytskjemaer, wireframe-diagrammer og fakturaskanninger, og oversette dem direkte til kjørbar systemlogikk.
Hastighet og latens
- Generasjonshastighet: DeepSeek-V4-Flash-0731 er raskere, med en gjennomsnittlig utdatahastighet på 122.7 tokens/sek på standard enterprise-skypunkter, assistert av sitt spekulative dekodingsrammeverk.
- Time to First Token (TTFT): GLM-5.3-Flash har lavere TTFT på 1.21 sekunder, sammenlignet med over 3.0 sekunder for DeepSeek-V4-Flash, noe som gjør at den oppleves mer responsiv i sanntids brukerrettede chat-applikasjoner.
DeepSeek-V4-Flash vs GLM-5.3-Flash: API-prising
Begge modellene tilbyr svært kostnadseffektive prissettingsmodeller, noe som gjør dem svært konkurransedyktige mot tradisjonelle tette arkitekturer.
Offisielle API-listepriser (per 1 million tokens)
| Prislag | DeepSeek-V4-Flash-0731 (Peak) | DeepSeek-V4-Flash-0731 (Off-Peak) | GLM-5.3-Flash (Standard) | GLM-5.3-Flash (Promo - to Sep 9) |
|---|---|---|---|---|
| Input Price (Cache Miss) | $0.44 | $0.22 | $0.15 | $0.075 |
| Input Price (Cache Hit) | $0.014 | $0.007 | $0.03 | $0.015 |
| Output Price | $1.32 | $0.66 | $0.50 | $0.25 |
Utenom rushtid er DeepSeek-V4-Flash-0731 svært økonomisk, med inndata-kost på $0.22/MTok og utdata på $0.66/MTok, og en bufret inndata-kost på $0.007/MTok.
GLM-5.3-Flash tilbyr konkurransedyktige standard flate satser ($0.15 input / $0.50 output) uten rushtidsgebyr. Kampanjesatsen (tilgjengelig til 9. september 2026) senker inndata- og utdata-kostnader til henholdsvis $0.075 og $0.25, noe som gjør den til et utmerket alternativ for storskala migreringer og bulkprosessering.
Styrker og svakheter
DeepSeek-V4-Flash-0731
- Styrker:
- Eksepsjonell generasjonshastighet: Genererer opptil 122.7 tokens per sekund ved hjelp av den samskolerte spekulative utkastmodellen (DSpark).
- Utenom-rushtid-økonomi: Tilbyr en svært lav inngangsterskel utenom rushtid på $0.22 input og $0.66 output per million tokens.
- Sterk CPU-kvantiseringsstøtte: Har en moden GGUF-integrasjonssti, noe som gjør den høyt optimalisert for CPU-baserte lokale kjøremiljøer og personlig systemminne.
- Avveininger:
- Topp-timers ratevolatilitet: API-priser dobles i rushtid (0.44/1.32 per MTok).
- Tekst-only kjernevekter: Standardvektene støtter ikke native visuell resonnering, bilder eller video.
- TTFT-overhead: Har lengre målt Time to First Token (TTFT) sammenlignet med GLM.
GLM-5.3-Flash
- Styrker:
- Topptier intelligens: Oppnår svært konkurransedyktige 57 poeng på Artificial Analysis Index.
- Native vision-in-the-loop: Integrerer bilde- og videohåndtering direkte i ettertreningsjusteringen, og muliggjør visuell evaluering av front-end-kode.
- Eksepsjonell cache-reduksjon: Hybrid lineær KDA og NoPE MLA-lag kutter minnebruk med 4.44×, og låser opp høyere lokal samtidighet.
- Flate langkontekst-satser: Standard prising forblir flat opp til 1M tokens med bransjens laveste cache-treff-rate ($0.03 standard, $0.015 promo).
- Avveininger:
- Saktere token-output: Rå generasjonshastigheter er saktere enn DeepSeek sin dedikerte spekulative dekoder.
- Maskinvarekrav: Hosting av den fulle 320B-parameter MoE-strukturen lokalt krever et multinode GPU-miljø til tross for høy sparsitet.
| Modell | Styrker | Avveininger |
|---|---|---|
| DeepSeek-V4-Flash | Rask generasjon (122.7 tok/s i Artificial Analysis); svært billig utenom-rushtid-prising; moden tekstkvantiseringsøkosystem; høyt optimalisert for lokal GGUF på CPU. | Varians i rushtid-satser; tekst-only basemodell (ingen native visjon); tregere TTFT. |
| GLM-5.3-Flash | 57 poeng på AA Intelligence; native multimodal parsing; 4.44× KV-cache-komprimering; flat prising; rask TTFT (1.21s); MIT-lisens. | Litt saktere rå token-generasjon enn DeepSeek; lokale multinode-distribusjoner er maskinvaretunge. |
DeepSeek-V4-Flash vs GLM-5.3-Flash: Hvilken bør du velge?
| Brukstilfelle | Anbefalt | Hvorfor |
|---|---|---|
| Standard frontier API | GLM-5.3-Flash | Høyere score på intelligensindeks (57) og dominerer flertrinns agent-benchmarker. |
| Langvarig tekstagent | DeepSeek-V4-Flash | Lynrask generasjon (122+ tok/s) gjør den svært effektiv for massiv tekst-/kodegenerering. |
| Visuell koding / UI-arbeidsflyt | GLM-5.3-Flash | Native multimodal design støtter visual-in-the-loop-debugging og UI-rendreringsanalyse. |
| Privat/egenforvaltet VPC | GLM-5.3-Flash | MIT-lisensiert med KDA + NoPE MLA-komprimering, som kutter VRAM-krav med 4.44×. |
| Lokal kun-CPU-kjøring | DeepSeek-V4-Flash | Sterkere lokal GGUF-kvant-støtte (92GB Unified Memory for ekstreme 1-bit- eller 3-bit-kjøringer). |
| Lavere topp-uttadakost | GLM-5.3-Flash | Standard utdata-pris på $0.50/MTok forblir flat og er billigere enn DeepSeek sin $1.32 topp-uttada-rate. |
| Tung prompt-caching | DeepSeek-V4-Flash | Utenom-rushtid cache-treff koster ekstremt lave $0.007 per million tokens. |
Hvorfor bruke Cometapi for å få tilgang til DeepSeek-V4-Flash og GLM-5.3-Flash
Begge modellene er fullt integrert i CometAPI. Utviklere kan få tilgang til DeepSeek-V4-Flash, og støtte for Chat Completions / Responses-stil tilgang og GLM-5.3-Flash model page eksponerer GLM-5.3-Flash gjennom det enhetlige CometAPI-endepunktet. Det gjør A/B-testing enklere fordi du kan bytte modell-ID-er samtidig som du beholder autentisering og det meste av applikasjonsrørleggingen.
Konklusjon
Introduksjonen av DeepSeek-V4-Flash-0731 og GLM-5.3-Flash har transformert økonomien i langkontekst, spars MoE-modell-distribusjon. Begge arkitekturene leverer høy intelligens til ekstremt lave prisnivåer.
DeepSeek-V4-Flash-0731 er en svært optimalisert tekst- og kode-motor som utmerker seg i rå generasjonsgjennomstrømming, spekulativ dekoding og lokal CPU-basert kvantisering. GLM-5.3-Flash representerer et stort steg fremover for multimodale og agent-baserte arbeidsflyter, ved å kombinere lav-latens visuell resonnering med en hybrid oppmerksomhetsmekanisme som gjør on-premise-hosting svært effektiv.
FAQs
Hva var GLM-5.3-Flash sitt anonyme testnavn?
Før den offisielle lanseringen ble GLM-5.3-Flash testet anonymt på OpenRouter og OpenCode under kodenavnet "Ox Alpha," hvor den raskt ble en populær modell for utviklere.
Kan jeg kjøre disse modellene lokalt på en standard personlig datamaskin?
Ja, begge modellene har åpne vekter og er tilgjengelige på Hugging Face. Men på grunn av parameterstørrelsene krever lokal hosting betydelig samlet minne:
- DeepSeek-V4-Flash-0731: Ekstrem 1-bit kvantisering krever ~92GB RAM; en 3-bit kvantisering anbefales på det sterkeste og krever mellom 110–135GB RAM.
- GLM-5.3-Flash: Ekstrem 1-bit kvantisering krever ~100GB RAM, mens 3-bit-kjøringer yter best med 128GB–150GB samlet systemminne.
Støtter DeepSeek-V4-Flash visuell eller video-prosessering?
Nei, standard DeepSeek-V4-Flash-0731 er en tekst-only modell. For visuelle oppgaver må du bruke deres separate multimodale eksperimentelle modell (deepseek-v4-flash-vision-exp).
Hvordan fungerer "visual-in-the-loop"-programmering på GLM-5.3-Flash?
Fordi modellen har native visuell og bildeforståelse, kan den skrive front-end-kode, gjennomgå rendret visuelt output, oppdage layout- eller stilfeil og skrive om koden for å rette disse uten at et menneske trenger å beskrive layoutproblemene i tekst.
Hvordan sparer Prompt Caching penger med disse modellene?
Hvis du sender den samme store konteksten (som en kodebase eller dokument-samling) i flere API-kall, kan begge modellene cache denne prompten. Ved påfølgende kall belastes de kun for "cache-hit"-raten, som faller til $0.007/MTok for DeepSeek-V4-Flash (utenom rushtid) og $0.015/MTok for GLM-5.3-Flash (promo), noe som reduserer API-kostnader betydelig.