
TL;DR
Claude Fable 5.1 har sterkere benchmark-grunnlag for vanskelige autonome kodeoppgaver og arbeid med lang horisont. GPT-5.6 Sol tilbyr lavere ordinære tokenkostnader, et bredt innebygd verktøystack og lavere tid til første token i den uavhengige maks-innsats-sammenligningen. Riktig standardvalg avhenger av kostnaden ved en mislykket oppgave, ikke bare høyeste benchmark-score.
I øyeblikksbildet av Intelligence Index 8. september 2026 (https://artificialanalysis.ai/models/comparisons/claude-fable-5-1-vs-gpt-5-6-sol) scorer Fable 5.1 53, mot 47 for GPT-5.6 Sol. Utdata-gjennomstrømning er praktisk talt lik på 69.9 mot 69.8 tokens/s. Resultatene støtter en kvalitet-versus-kost-beslutning; de etablerer ikke en universell fartsvinner.
Viktige poenger
- Velg Fable 5.1 for de vanskeligste autonome oppgavene når dine egne evalueringer forsvarer høyere pris.
- Start med GPT-5.6 Sol for kostnadssensitiv grenseinfferens og applikasjoner som drar nytte av dets integrerte verktøy.
- Sammenlign oppstartsforsinkelse separat fra utdatahastighet: GPT-5.6 Sol har lavere målt tid til første token, mens gjennomstrømningen er nesten lik.
- Regn på cache-skriving, -lesing, -retensjon og satser for lang kontekst separat. Overskriftspriser for input/output beskriver ikke alle agentarbeidsbelastninger.
Data sjekket 8. september 2026. Uavhengige resultater bruker GPT-5.6 Sol på maks innsats og Fable 5.1 med Adaptive Reasoning, Max Effort, Default Fallback. Leverandør-benchmarker og uavhengige benchmarker bruker ulike evalueringsoppsett. Priser er USD per million tokens (MTok), med mindre annet er oppgitt.
GPT-5.6 Sol vs Fable 5.1: rask konklusjon
| Dimension | GPT-5.6 Sol | Claude Fable 5.1 | Bedre valg |
|---|---|---|---|
| Uavhengig Intelligence Index v4.3 (8. sep) | 47 | 53 | Fable 5.1 |
| Uavhengig Terminal-Bench 4.0 (7. sep) | 39.9% | 52.0% | Fable 5.1 |
| Anthropic-kjørt Terminal-Bench 4.0 | 37.3% | 55.8% | Fable 5.1 |
| Kontekstvindu | 1.05M | 1M | Praktisk talt likt |
| Maksimalt utdata | 128K | 128K | Uavgjort |
| Tekst/bilde-input | Yes | Yes | Uavgjort |
| Offisiell inputpris / MTok | $4 | $10 | Sol |
| Offisiell utdatapris / MTok | $20 | $50 | Sol |
| Offisiell cache-lesing / MTok | $0.40 | $0.25 | Fable 5.1 |
| Uavhengig utdatahastighet (8. sep) | 69.8 tok/s | 69.9 tok/s | Praktisk talt likt |
| API-verktøybredde | Svært bred | Sterk | Sol |
| Langvarig autonomt arbeid | Excellent | Kjerneområde | Fable 5.1 |
| Kostnadssensitiv produksjon | Bedre standardvalg | Premium eskalering | Sol |
En nyttig startpolicy er Sol for rutinemessig frontier-arbeid, med Fable 5.1 som eskaleringsvei når en oppgave feiler din kvalitets- eller autonomiterskel. Valider den policyen mot kostnad per vellykket oppgave.
GPT-5.6 Sol eksponerer seks resonnement-innsatsnivåer, fra none til max, med medium som standard. Fable 5.1 bruker alltid-på adaptiv tenkning; innsats styrer resonnementsdyp, og standarden er høy.
De ekstra 50 000 tokenene i GPT-5.6 Sols kontekst vil sannsynligvis ikke avgjøre de fleste arkitekturer. Fakturering og cache-gjenbruk blir mer betydningsfulle når en forespørsel nærmer seg én million tokens; delen om lang kontekst nedenfor viser hvorfor.
Hva er GPT-5.6 Sol?
GPT-5.6 Sol er et høyytelsesnivå i OpenAIs GPT-5.6-familie for krevende koding, forskning, planlegging og agentarbeidsflyter. Hovedappellen i denne sammenligningen er kombinasjonen av resonnementskontroller og det omkringliggende utførelsesmiljøet.
Gjennom Responses API støtter GPT-5.6 Sol en bred portefølje av innebygde verktøy: web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills og tool search. Dette kan redusere antall separate kjøretidskomponenter en applikasjon må integrere.
OpenAI beskriver også programmatic tool calling og multi-agent-utførelse for familien. Disse plattformfunksjonene er viktige når en modell må koordinere arbeid på tvers av verktøy i stedet for å returnere et enkelt svar.
Hva er Claude Fable 5.1?
Claude Fable 5.1 retter seg mot krevende koding, profesjonelt kunnskapsarbeid, forskning og langvarige agenter. Dets direkte benchmark-resultater gjør det til en sterk kandidat for oppgaver der gjenoppretting, utholdenhet og vellykket fullføring betyr mer enn et kort svar.
Anthropic fremhever vedvarende autonom utførelse på tvers av applikasjoner, inkludert planlegging, gjenoppretting fra mislykkede steg og kommunikasjon av fremdrift. Behandle den posisjoneringen som en grunn til å teste lengre oppgaver, ikke en garanti for at hver arbeidsflyt vil fullføre korrekt.
Fable 5.1 skiller seg også fra GPT-5.6 Sol i API-atferd: dets begrensninger for tvunget verktøyvalg betyr noe for arbeidsflyter som krever at modellen kaller et spesifikt verktøy. Sjekk støttede tool_choice-moduser ved migrering av en deterministisk agentløkke.
Integrasjonsspørsmålet er derfor praktisk: kan applikasjonen din tåle en mer autonom resonnementssløyfe, eller krever den finere kontroll over hvert steg? Test den eksakte verktøysatferden før du velger rute.
Benchmark-sammenligning: Fable 5.1 har sterkere direkte bevis
Sammenligninger av benchmarker mellom konkurrerende leverandører er lette å misbruke. OpenAIs opprinnelige GPT-5.6-lanseringsevalueringer er fra før Fable 5.1, mens Anthropics Fable 5.1-utgivelse inneholder nyere direkte sammenligninger med GPT-5.6 Sol.
Den ryddigste måten å lese evidensen på er derfor i tre lag: Anthropics direkte sammenligning, gjeldende uavhengig testing og OpenAIs egen GPT-5.6 Sol-kapasitetsprofil.
Anthropics direkte Fable 5.1 vs GPT-5.6 Sol-resultater
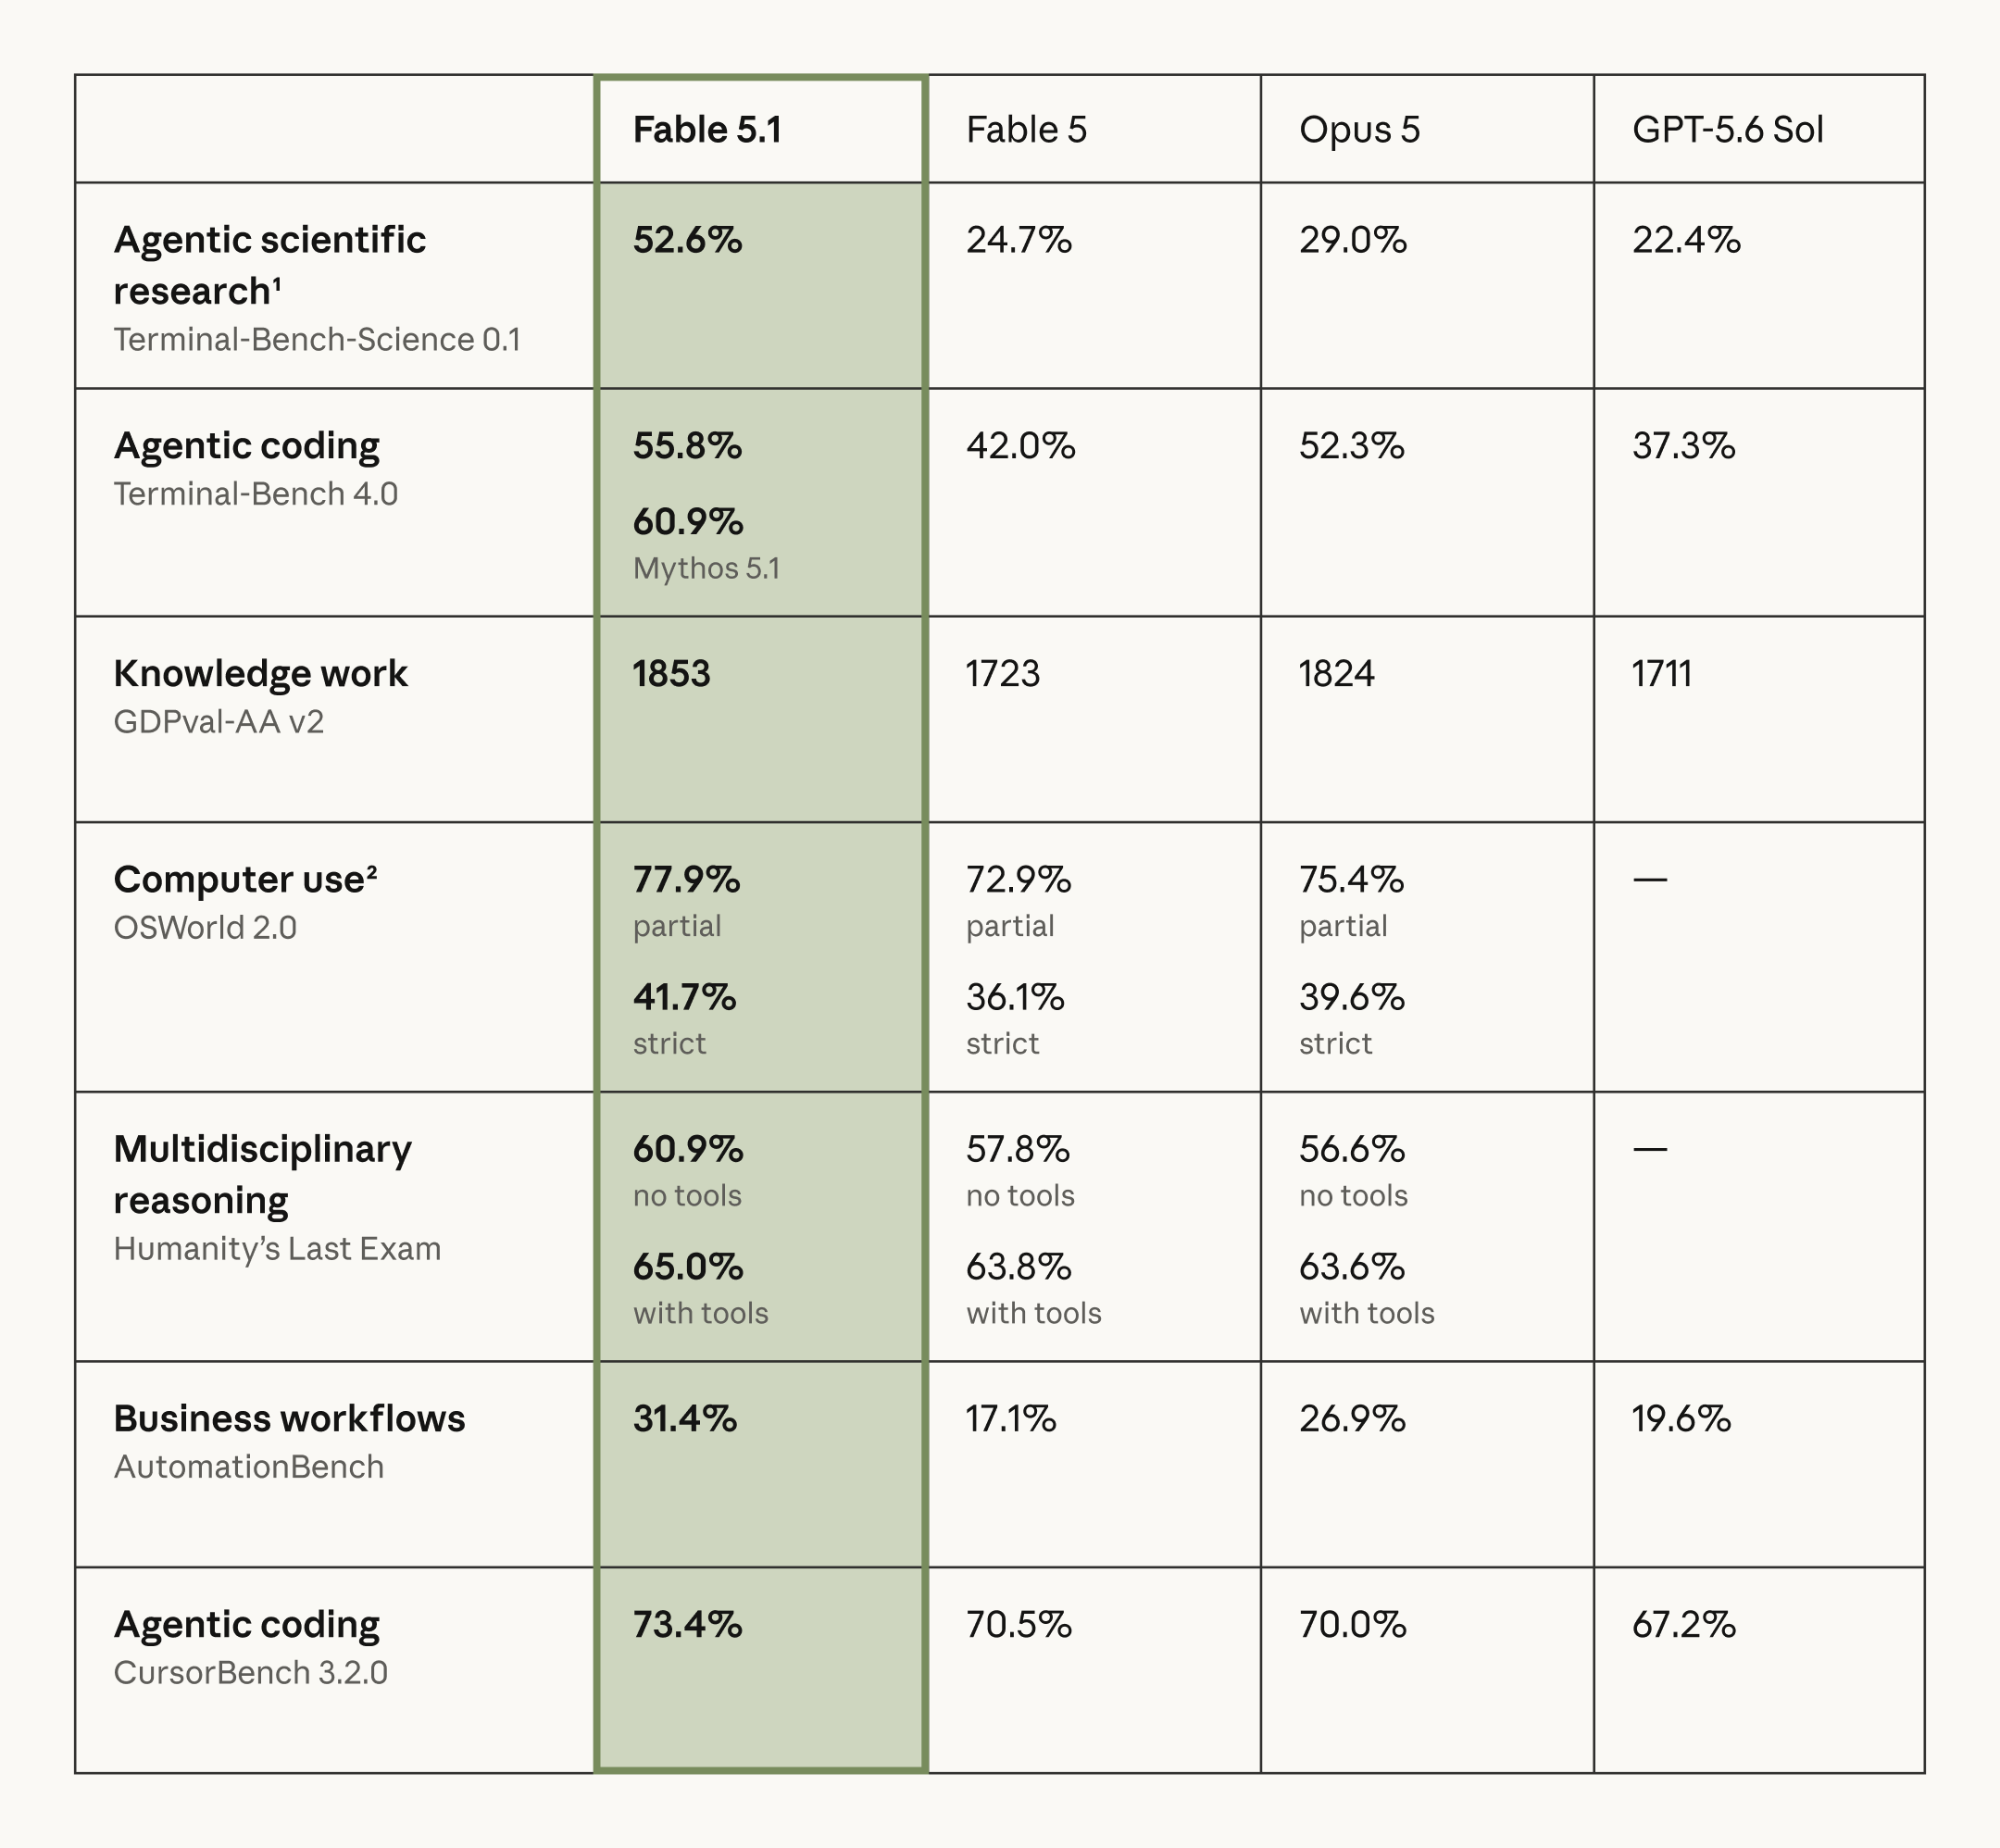
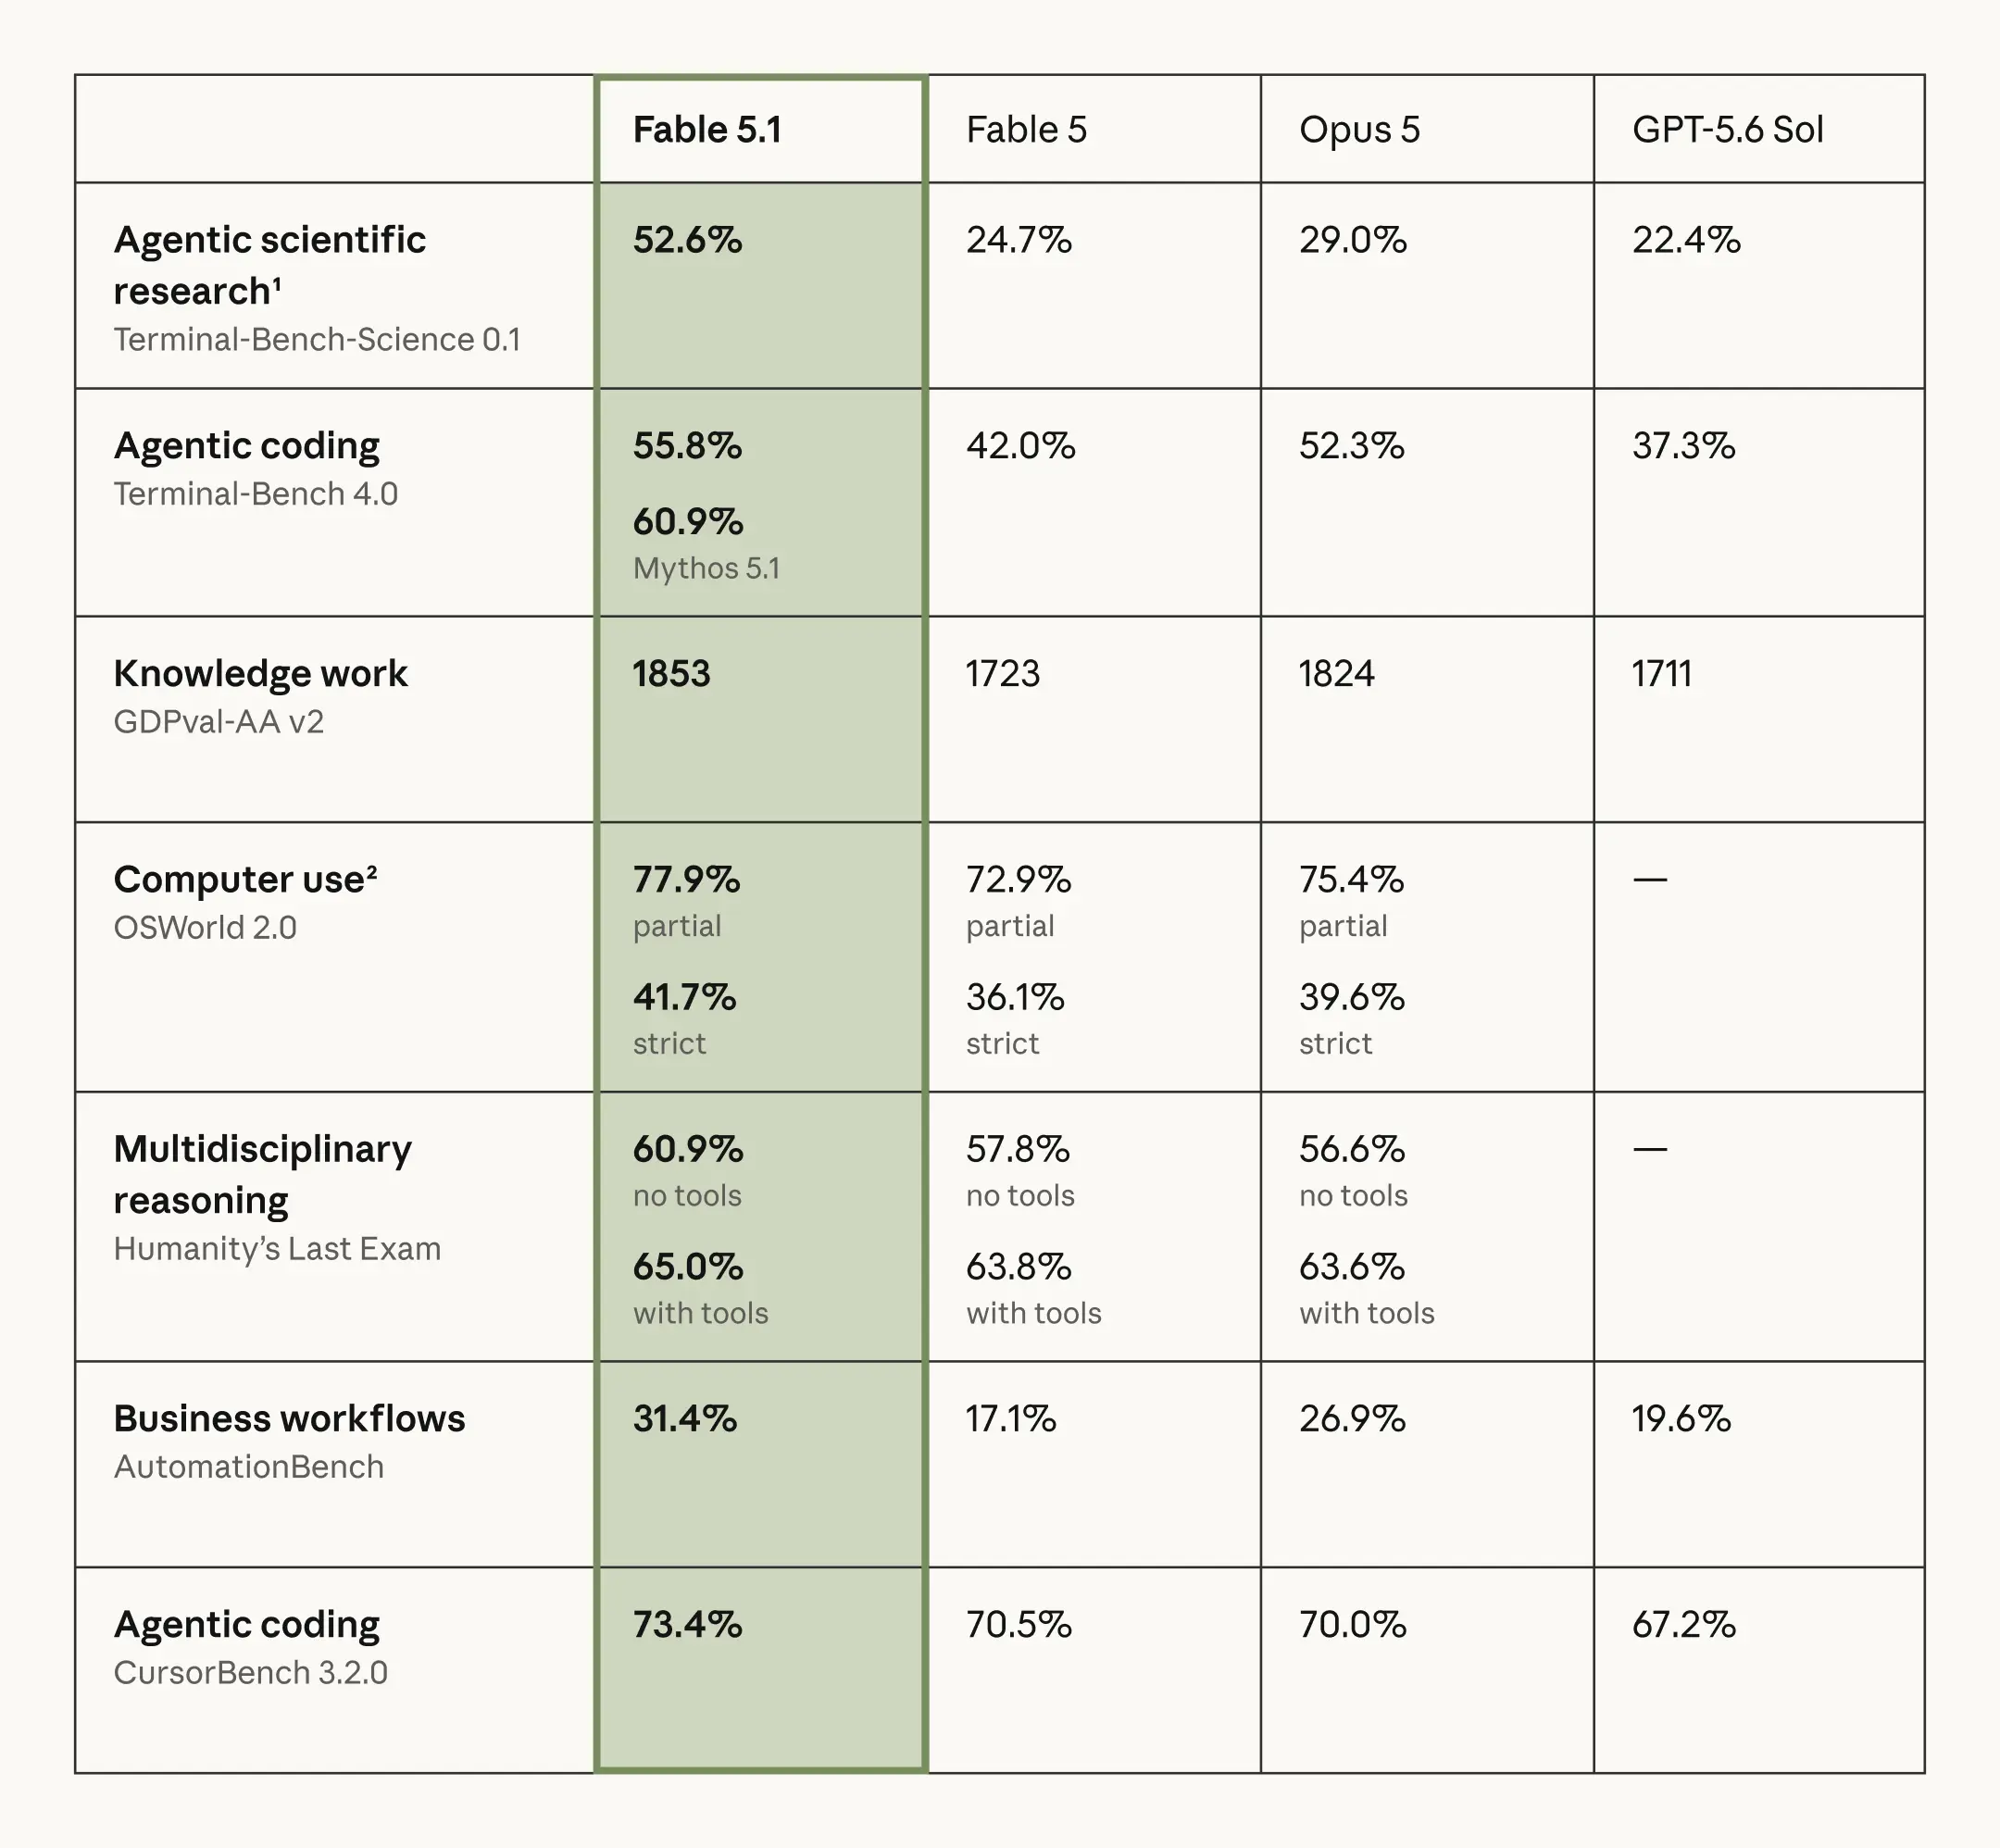
De offisielle benchmark-resultatene inkluderer fem oppgaver med rapporterte poeng for begge modellene. Prosentpoeng- og Elo-forskjeller nedenfor er beregnet fra disse publiserte verdiene.
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Fable 5.1-forsprang |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 pts |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 pts |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 pts |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 pts |
Resultatet er uvanlig konsistent: Fable 5.1 leder GPT-5.6 Sol i hver direkte rad Anthropic publiserte. De største forskjellene vises i agentisk vitenskapelig forskning og terminalbasert koding, snarere enn ordinært kortform-resonnement.
Kilde: Anthropic — original benchmark-grafikk.
Dette er leverandørkjørte evalueringer: Anthropic testet både sin egen modell og konkurrentens modell. De gir direkte sammenlignbar evidens, men er ikke uavhengige tester. Anthropic rapporterer en standardfeil på ±3.5–4.5 prosentpoeng per modell på Terminal-Bench-Science; tabellen over viser punktestimater, ikke konfidensintervaller.
Leverandørresultatene favoriserer Fable 5.1, men det uavhengige beviset trenger egne datoer og konfigurasjoner.
Uavhengige benchmarker: skill daterte resultater fra live-målinger
Artificial Analysis introduserte Intelligence Index v4.3 7. september, erstattet Terminal-Bench 2.1 med Terminal-Bench 4.0 og la til AutomationBench-AA. Utgivelsen rapporterte 53 for Fable 5.1 og 47 for GPT-5.6 Sol, som matcher de avrundede poengene vist i sammenligningen 8. september. Tabellens terminalresultater fra utgivelsen skilles fra det senere ytelsesøyeblikksbildet.
| Uavhengig AA-metrikk / v4.3-utgivelse | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Resultat |
|---|---|---|---|
| Intelligence Index v4.3 (8. sep) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (7. sep-utgivelse) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Utdatahastighet (8. sep) | 69.8 tok/s | 69.9 tok/s | Praktisk talt likt |
| Tid til første token (8. sep) | 132.10 s | 277.47 s | Sol |
| AA normalisert token-miks-pris / MTok | $3.08 | $7.175 | Sol |
Øyeblikksbilde: 8. september 2026, bortsett fra den eksplisitt daterte 7. september Terminal-Bench-raden. Fable 5.1 bruker Adaptive Reasoning, Max Effort, Default Fallback; Sol bruker max. Live-målinger kan endre seg. AAs normaliserte token-miks-pris bruker et 7:2:1-forhold for cache-treff/input/output; det er ikke kostnaden for hver API-forespørsel.
OSWorld 2.0 er den største rapporterte fordelen for Sol i denne sammenligningen: 62.6% mot 41.7% for Fable 5.1, et forsprang på 20.9 poeng. Dette balanserer de sterkere Fable-resultatene på Intelligence Index og Terminal-Bench.
Evidensen støtter en spesifikk avveining: Fable 5.1 har høyere Intelligence Index, mens Sol har lavere tid til første token og en lavere normalisert pris. Utdata-gjennomstrømning er praktisk talt lik. Disse målingene støtter ulike valg for kvalitetssensitive batch-jobber og interaktive applikasjoner.
Den daterte uavhengige Terminal-Bench-sammenligningen peker i samme retning som Anthropics test: 52.0% mot 39.9%, sammenlignet med leverandørens 55.8% mot 37.3%. De to gapene er ikke utskiftbare fordi evalueringsoppsettene er forskjellige.
Hva OpenAIs benchmarker fortsatt forteller oss om GPT-5.6 Sol
OpenAIs lanseringsevalueringer gir ytterligere kontekst for GPT-5.6 Sols kapabiliteter. De er fra før de nyere hode-til-hode-resultatene diskutert over, så de bør ikke brukes som en direkte sammenligning med Fable 5.1.
OpenAI rapporterer 88.8% på Terminal-Bench 2.1 for GPT-5.6 Sol. Det er evidens for sterk agentisk kodekapasitet under lanseringsoppsettet; den eldre benchmark-versjonen bør ikke sammenlignes numerisk med Terminal-Bench 4.0-score.
GPT-5.6 Sol vs Fable 5.1 for koding
For rett-fram kodegenerering er begge modellene overkvalifiserte for mange produksjonsarbeidsbelastninger. Skillet blir tydeligere når koding blir til agentisk programvareingeniørarbeid: inspisere et stort repo, redigere flere filer, kjøre kommandoer, diagnostisere feil, skrive tester og iterere til oppgaven består.
Her har Claude Fable 5.1 det sterkere gjeldende benchmark-grunnlaget. Den leder både leverandørkjørte og uavhengige Terminal-Bench 4.0-sammenligninger, og Anthropics CursorBench-resultat favoriserer den også 73.4% mot 67.2%.
For en praktisk kodeevaluering, inkluder endringer på tvers av repo, tester, gjennomgang og ytelsesarbeid. Et vellykket kort kodesnutt er en svak proxy for å fullføre en oppgave som spenner over flere filer og mislykkede forsøk.
GPT-5.6 Sol er fortsatt overbevisende når det omkringliggende utførelsesmiljøet betyr like mye som rå modellkvalitet. Innebygd støtte for shell-utførelse, apply-patch, code interpreter, file search, computer use og MCP kan redusere mengden orkestreringsinfrastruktur du må bygge selv.
Koding-vurdering: velg Fable 5.1 når dine evalueringssett vektlegger det vanskeligste autonome repo-arbeidet. Velg GPT-5.6 Sol når noe lavere benchmark-kapasitet er akseptabelt i bytte mot lavere kost og en bred integrert utførelsesstack.
Styring av resonnement og utvikleropplevelse
De to API-ene eksponerer intelligens forskjellig.
Sols none-til-max-resonneringsområde lar et team teste kvalitet og forsinkelse på flere innstillinger. Lavere innsats kan redusere resonnement, men riktig innstilling avhenger av oppgavens feil-kostnad.
Fables alltid-på adaptive tenkning gjør innsats-tuning til en annen øvelse. Sammenlign innstillinger som applikasjonen din faktisk vil bruke i stedet for å behandle identiske innsats-etiketter som identiske beregningsbudsjetter.
Det finnes følgelig ingen universelt rettferdig sammenligning mellom «standard Sol» og «standard Fable». Deres standard resonnementskonfigurasjoner er forskjellige. Produksjonsevalueringer bør sammenligne enten like innsatsbudsjetter eller de eksakte innstillingene applikasjonen din faktisk vil bruke.
GPT-5.6 Sol vs Fable 5.1: Hvilken er bedre for AI-agenter?
Valget avhenger av om flaskehalsen er vanskelig resonnement eller kjøremiljøet som omgir det.
Fables forsprang i de siterte terminal-, automasjons- og profesjonelle arbeids-benchmarkene gjør den til et fornuftig kandidat for de hardeste oppgavene. Mål fullføringsrate og gjenoppretting fra mislykkede steg før du generaliserer det forspranget til agenten din.
GPT-5.6 Sols dokumenterte Responses-verktøyportefølje gjør den attraktiv for applikasjoner bygget rundt søk, filer, shell-utførelse og patches. Det er en integrasjonsfordel å evaluere sammen med oppgavenøyaktighet, ikke en erstatning for den.
| Agent-krav | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Hardt resonnement med lang horisont | Excellent | Best fit |
| Terminal-/repo-autonomi | Excellent | Sterkere evidens |
| Innebygd verktøyportefølje | Sterkere | Sterk |
| Tvunget verktøyvalg | Støttet; sjekk valgt API | Begrenset; sjekk tool_choice-moduser |
| Multi-agent plattformintegrasjon | Sterk fordel | Tilgjengelig via agent-arkitektur |
| Fremdriftskommunikasjon under lange jobber | Good | Kjerneatferd |
| Kostnadssensitive høyvolumsagenter | Bedre | Premium |
| Gjentatt massiv cachet kontekst | Good | Potensielt svært attraktiv |
Å bruke begge kan være økonomisk når bare en liten andel av oppgavene trenger eskalering. Mål om de ekstra vellykkede fullføringene oppveier den andre modellens høyere pris og oppstartsforsinkelse.
Lang kontekst: 1.05M vs 1M er ikke den viktige forskjellen
Overskriftstallene ser nesten identiske ut: GPT-5.6 Sol tilbyr 1.05M tokens og Fable tilbyr 1M. En kapasitetsforskjell på 5% vil sjelden avgjøre om du kan analysere et stort repo, et juridisk korpus, et forskningsarkiv eller en fler-times agenthistorikk. Begge er allerede i million-token-klassen.
For GPT-5.6 Sol utløser input over 272K høyere satser for lang kontekst for forespørselen: $8/MTok input, $0.80/MTok cachet input og $30/MTok output. Cache-skrivinger øker også fra $5 til $10/MTok.
Fable 5.1 beholder sine standard 1M-kontekst-satser: $10/MTok input, $50/MTok output og $0.25/MTok cache-lesinger. Det er ingen eget premium over 272K i denne dokumenterte konfigurasjonen.
Vurder en tur med 100K ikke-cachet input, 900K cache-lesinger og 20K totalt fakturerte output-tokens. GPT-5.6 Sol koster 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. Fable 5.1 koster 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
Denne cache-tunge turen lukker nesten prisgapet fordi Fable har billigere cache-lesinger. Resultatet avhenger av arbeidsbelastningens token-miks; det betyr ikke at de to modellene koster det samme for en full agentsesjon.
Kostnadsforutsetninger: prefikset på 900K tokens er allerede cachet, og de 100K ferske inputene faktureres ikke som en ny cache-skriving. Estimatet ekskluderer første cache-skriving og verktøygebyrer. Output-allowansen på 20K inkluderer alle fakturerte utdata, inkludert eventuelle fakturerte resonnementstokens.
Priser: Sol vinner vanlige arbeidsmengder, Fable vinner én viktig cache-metrikk
Ved de sjekkede satsene koster Sol $4 input / $20 output per MTok, med $0.40 cache-lesinger. Fable 5.1 koster $10 input, $50 output og $0.25 cache-lesinger. Tabellene skiller leverandørpriser fra GPT-5.6 Sol API i CometAPI og Claude Fable 5.1 API i CometAPI-satser.
| Priskomponent | GPT-5.6 Sol Offisielle priser | Claude Fable 5.1 Offisielle priser |
|---|---|---|
| Offisiell input / MTok | $4.00 | $10.00 |
| Offisiell output / MTok | $20.00 | $50.00 |
| Offisiell cache-lesing / MTok | $0.40 | $0.25 |
| Offisiell cache-skriving / MTok | $5.00 (30 minutter) | $12.50 (5 minutter) |
| Over 272K input: input / cache-lesing / cache-skriving / output | $8 / $0.80 / $10 / $30 | Samme dokumenterte grunnsatser |
| CometAPI input / MTok | $3.20 | $8.00 |
| CometAPI output / MTok | $16.00 | $40.00 |
Cache-skrivingsvarighet varierer: Sol bruker en standard oppbevaringsperiode på 30 minutter, mens Fable 5.1-satsen vist er for en 5-minutters skriving. Sjekk cache-opprettelse, fornyelse og utløpsatferd for leverandøren og ruten du faktisk bruker.
Ved de sjekkede direkte-leverandør-satsene koster Fable 5.1 2.5× så mye som Sol for både ikke-cachet input ($10 vs $4/MTok) og output ($50 vs $20/MTok). Behandle disse sjekkede satsene som en datert sammenligning, siden leverandørkampanjer og gateway-priser kan endre seg.
En kort-kontekst-forespørsel med 100K input og 10K totalt fakturerte output koster rundt $0.60 med Sol eller $1.50 med Fable til direkte-leverandør-satser. Ved CometAPI-satsene over koster samme miks $0.48 eller $1.20. Disse eksemplene ekskluderer cache-skrivinger og verktøygebyrer.
Fables kort-kontekst cache-lese-sats er 37.5% lavere: ($0.40 − $0.25) ÷ $0.40. Det kan bety noe for agenter som gjenbruker et stort stabilt prefiks, men den totale besparelsen avhenger fortsatt av fersk input, skrivefrekvens og outputvolum.
Prisvurdering: Sol er det billigere utgangspunktet for trafikk med fersk kontekst. Fable blir mer konkurransedyktig når andelen cache-lesing vokser; sammenlign den fulle sesjonskostnaden, inkludert opprettelse og fornyelse av cachen.
Hastighet og latens
Maks-innsats-tester kan bruke betydelig tid på resonnement før første synlige token.
Målingene av gjennomstrømning og latens 8. september viser 69.9 utdata-tokens/s for Fable og 69.8 for Sol. Tid til første token er 277.47 sekunder mot 132.10 sekunder. Utdata-gjennomstrømning er praktisk talt lik; Sol begynner å produsere synlig output tidligere i denne konfigurasjonen.
Dette er maks-innsats-benchmarkmålinger, ikke lovet latens for hver API-kall. Promptlengde, resonnementskonfigurasjon, leverandørbelastning, verktøy og cachestatus kan endre resultatet. Tid til første token og total svartid er forskjellige metrikker.
For interaktivt arbeid kan den lavere observerte oppstartsforsinkelsen favorisere Sol. For asynkron forskning eller nattlig repo-arbeid kan vellykket fullføring bety mer enn å vente på første token. Benchmark begge modellene på innstillingene og konklurrensen du har til hensikt å bruke.
Sikringstiltak er en praktisk forskjell
Begge modellene anvender sterkere sikringstiltak fordi kapabilitetene deres strekker seg inn i sensitive cybersikkerhets- og vitenskapsdomener, men de implementerer dem forskjellig.
OpenAI beskriver lagdelte beskyttelser og overvåking for GPT-5.6-familien. Applikasjoner i sensitive domener bør evaluere relevante sikringstiltak som en del av deres produksjonsatferd.
Anthropics omruting og oppbevaringsvilkår beskriver ruting av enkelte sensitive cybersikkerhets- eller biologi-forespørsler til mindre kapable modeller, uten å belaste Fable-satsen for disse omrutede forespørslene. Standard data-oppbevaringsperiode er 30 dager, med unntak for kvalifiserte bedriftsavtaler.
For ordinær koding og kunnskapsarbeid kan disse forskjellene aldri dukke opp. For sikkerhetsprodukter, regulerte arbeidsbelastninger eller personvern-sensitive utrullinger hører de hjemme på evalueringssjekklisten sammen med benchmark-kvalitet og pris.
Hvilken modell bør du velge?
Den overordnede sammenligningen kan reduseres til arbeidsbelastningens form.
| Arbeidsbelastning | GPT-5.6 Sol | Claude Fable 5.1 | Anbefaling |
|---|---|---|---|
| Vanskelig autonom koding | Excellent | Sterkere gjeldende benchmarks | Fable 5.1 |
| Langsiktig forskning | Excellent | Kjerneområde | Fable 5.1 |
| Høyvolums frontier-API | Mye billigere | Dyr | Sol |
| Interaktiv kodeassistent | Lavere målt maks-innsats TTFT | Høyere målt maks-innsats TTFT | Test distribuerte innstillinger |
| Verktøy-tung API-agent | Bredere innebygd verktøystack | Sterk | Sol |
| Million-token cachet agent | Konkurransedyktig | Svært lav cache-lesepris | Test begge |
| Maksimal resonnementskvalitet | Excellent | Uavhengig ledelse | Fable 5.1 |
| Kostnad per ordinær forespørsel | Klar fordel | Premium | Sol |
| Bilde-/dokumentresonnement | Sterk | Sterk | Test på arbeidsbelastning |
| Én-leverandør OpenAI-stack | Naturlig passform | Krever migrering/gateway | Sol |
| Leverandøruavhengig ruting | Sterk | Sterk | Bruk begge via CometAPI |
En rutingspolicy bør fortjene kompleksiteten sin. Sammenlign en enkelt-modell-baseline med en Sol-først-policy som eskalerer vanskelige oppgaver til Fable 5.1, og behold ruteren bare hvis den forbedrer kostnad per vellykket oppgave på ønsket kvalitetsnivå.
Slik sammenligner du GPT-5.6 Sol og Fable 5.1 via CometAPI
CometAPI integrerer allerede GPT-5.6 Sol og Claude Fable 5.1. Få tilgang til begge modellene med deres native forespørselsformater, send samme evalueringssett og sammenlign returresultatene under matchede innstillinger.
Bruk native-formaterte forespørsler for hver modell og hold prompts, datasett, innsatsinnstillinger, samtidighet og scoringsregler konstante. Gjenta kjøringene; en enkelt sekvensiell forespørsel per modell er ikke nok til å estimere pålitelig latens eller kvalitet.
For en produksjonsevaluering, bruk et fast promptsett, gjenta kjøringer i alternerende rekkefølge, registrer innsatsinnstilling, og mål korrekthet, testpassrate, verktøysuksess, retrier, tokenbruk, forløpt tid og total kostnad per vellykket oppgave. Tuning for hver modell separat etter den felles baselinen.
Endelig konklusjon: GPT-5.6 Sol eller Claude Fable 5.1?
Fable 5.1 har sterkere direkte evidens for de hardeste autonome kodeoppgavene og arbeid med lang horisont. Den leder de fem delte leverandør-benchmark-radene og den daterte uavhengige terminal-sammenligningen. Det gjør den til en sterk eskaleringskandidat, underlagt validering på dine egne oppgaver.
Sol har lavere ordinære tokenpriser, finere resonnementskontroller og en bred innebygd verktøystack. I den sjekkede uavhengige maks-innsats-konfigurasjonen har den også lavere tid til første token; utdata-gjennomstrømningen er praktisk talt lik.
Prioriter Fable 5.1 når de vanskeligste autonome oppgavene bestemmer suksessraten din. Start med Sol for kostnadsbevisst grenseinffering eller verktøy-tunge applikasjoner. For interaktive arbeidsbelastninger, test de distribuerte innsatsinnstillingene for å bekrefte om den observerte oppstartsforsinkelsesfordelen vedvarer.
Velg én modell når den oppfyller kravene dine enkelt. Legg til ruting når evalueringsresultater viser at bytte mellom de to forbedrer kvalitet eller kostnad per vellykket oppgave.
FAQ
Er Claude Fable 5.1 bedre enn GPT-5.6 Sol?
Den har høyere uavhengig Intelligence Index i øyeblikksbildet 8. september: 53, mot 47 for Sol. Den leder også den daterte uavhengige terminaltesten. Det støtter en kvalitetsfordel på disse evalueringene, ikke et krav om at den er bedre for alle arbeidsbelastninger.
Er GPT-5.6 Sol billigere enn Claude Fable 5.1?
For ordinær ikke-cachet API-trafikk, ja: de sjekkede direkte-leverandør input/output-satsene er $4/$20 per MTok for Sol og $10/$50 for Fable 5.1. Cache-tunge arbeidsbelastninger kan snevre inn gapet fordi Fables cache-lesepris er lavere. Inkluder skrive- og utløpsatferd i estimatet.
Hvilken modell er bedre for koding?
Fable 5.1 har sterkere benchmark-evidens for autonom koding i denne sammenligningen. Sol forblir attraktiv for lavkost-arbeidsflyter og sine integrerte utførelsesverktøy. Bruk repo-oppgaver med kjørbare tester for å avgjøre om det målte kapabilitetsgapet betyr noe for din applikasjon.
Hvilken modell har større kontekstvindu?
Sol leder teknisk med 1.05M mot Fable 5.1s 1M tokens, mens begge tillater opptil 128K output. I praksis er Sols >272K-pristerske og Fables rimelige cache-lesinger vanligvis viktigere enn kapasitetsforskjellen på 50K tokens.
Kan jeg få tilgang til begge modellene via CometAPI?
Ja. GPT-5.6 Sol API i CometAPI og Claude Fable 5.1 API i CometAPI støtter et felles utgangspunkt for tekstevalueringer. Sjekk rutespesifikk resonnement, caching og verktøystøtte før du utvider baselinen til en produksjonsagent.