
TLDR 28. juni 2026 kunngjorde Elon Musk at Grok 4.5 — bygget på xAI sin nye V9-basismodell med 1,5 billioner parametere og supplerende treningsdata fra Cursor AI-kodingsplattformen — gikk inn i privat beta hos SpaceX og Tesla. Interne evalueringer hevder ytelse «nær, kanskje over» Anthropics Claude Opus, med pågående RLHF- og Grok Build-forbedringer.
For utviklere og bedrifter som integrerer toppmodeller i dag, tilbyr CometAPI umiddelbar, kostnadseffektiv tilgang til Grok 4.3 (og andre xAI-modeller) via ett OpenAI-kompatibelt endepunkt sammen med 500+ modeller fra Anthropic, OpenAI, Google m.fl. — ofte med 20%+ besparelser kontra direktepriser, uten prompt-logging for personvernsensitive arbeidsflyter.
Viktige punkter
- En sitert linje tilskrevet Elon Musk sier at Grok 4.5 er i privat beta hos SpaceX og Tesla, sirkulert av AshutoshShrivastava.
- TestingCatalog melder at Grok 4.5 bygger på en 1.5T V9-basismodell med Cursor-data lagt til som supplerende trening.
- Det eneste signalet med bevismerking er Mark Kretschmanns skjermbilde fra 28. juni som viser at versjonsnummeret for Grok / Cursor Composer 3 er fjernet fra xAI-menyene.
- Ingen benchmark-poeng, priser, kontekstvindu eller API-tidspunkter er oppgitt i dette signalsettet.
- Historien om Cursor-treningsdata har bygget seg opp siden 16. juni på minst tre kontoer, med Mark Kretschmann som knytter Grok 5 til et par på 6T og 10T parametere i Fable 5-vektklassen.
Grok 4.5 lanseringsdato
Grok 4.5 gikk i privat beta 28. juni 2026, og er planlagt for offentlig lansering 9. juli 2026 (i morgen, per 8. juli).
Den bygger på tidligere versjoner som Grok 4 (lansert rundt juli 2025) og Grok 4.3. Den bør bli tilgjengelig for kvalifiserte brukere (f.eks. SuperGrok/Premium+‑abonnenter) kort tid etter kunngjøringen. For API, CometAPI vil bli integrert med grok 4.5‑API-et umiddelbart etter lansering, og vil tilby en lavere innkjøpspris.
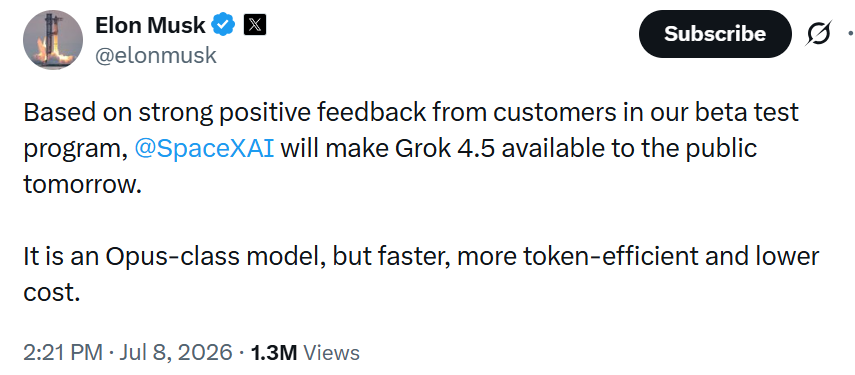
Offentlig lansering: I dag (8. juli 2026) postet Musk at, basert på positiv beta‑tilbakemelding, vil SpaceXAI / xAI gjøre Grok 4.5 tilgjengelig for allmennheten i morgen (9. juli). Den beskrives som en «Opus‑klasse» modell som er raskere, mer token‑effektiv og lavere priset enn sammenlignbare modeller.
Signaler fra arkitekturen til grok 4.5: Hva vi har sett
Hovedkilden er Elon Musks egen X-post 28. juni 2026:
«Grok 4.5, basert på vår 1.5T V9‑basismodell, med Cursor‑data lagt til i supplerende trening, er nå i privat beta hos SpaceX & Tesla. Tidlige evalueringer viser ytelse nær, kanskje over Opus. RL fortsetter å forbedre modellen betydelig, og Grok Build‑harnesset blir bedre hver dag …»
Dette ble forsterket av kontoer som @testingcatalog og @ai_for_success, med arkitekturdetaljer om 1.5T V9 og Cursor‑integrasjon, «Grok 4.5 is based on 1.5T V9 foundation model, with Cursor data added in supplemental training.»
Cursor‑signal: xAI/SpaceX sin bevegelse mot å kjøpe eller gå i dypt partnerskap med Cursor (Anysphere) for ~$60B gir en rik kilde til ekte utvikler‑IDE‑spor, agentiske arbeidsflyter og data for redigering på tvers av flere filer. Denne supplerende treningen (etter pre‑trening) skiller Grok 4.5 for kodeoppgaver, selv om eksperter bemerker at initial pre‑treningsintegrasjon ville vært enda sterkere.

Kilde: @mark_k
Menytilstands‑signalet er smalere, men mer bevislignende. Ifølge Mark Kretschmanns post 28. juni ble versjonsnummeret for Grok 1.5T / Cursor Composer 3‑modellen fjernet fra xAI‑menyer morgenen 28. juni. Han beskriver det som et mønster som kan gå forut for xAI‑lanseringer. Dette er ikke en formell lansering, men det er mer konkret enn en repostet ytelsespåstand fordi det er knyttet til et skjermbilde.
Det senere kanari‑signalet skjøv historien videre. TestingCatalog oppdaget en Grok‑web‑UI‑streng som lød «Unlock the full power of Chat with Grok 4.5.» Slike spor dukker ofte opp før en produktendring, men de kan også bli forlatt, forsinket eller skjult bak en begrenset utrulling.
Hva vi med rimelighet kan forvente av Grok 4.5
Gitt xAI sin bane og lekkasjedetaljene, er dette et nøkternt outlook:
- Forbedret koding og agentisk ytelse: Supplerende Cursor‑data bør styrke SWE‑Bench‑lignende oppgaver, resonnering på tvers av flere filer og reelle utviklerarbeidsflyter. Forvent styrker i teknisk resonnering, feilsøking og engineering i produksjonsskala — områder i tråd med SpaceX/Tesla‑brukstilfeller.
- Skala og effektivitet: Med 1.5T parametere på optimalisert V9 (Blackwell‑æra GPU‑er via Colossus) balanserer den rå kraft med kjøringsmulighet. RL‑forbedringer etter beta kan snevre inn gap i resonnering.
- Rask iterasjon: Musk nevnte månedlige nye modeller fra scratch. Grok 4.5 fungerer som et trinn, med et større 2T+ løp som allerede innlemmer Cursor‑data fra pre‑trening.
- Multimodalt og verktøybruk: Bygger på tidligere Grok‑kapabiliteter (visjon, søk, Grok Build), forvent utvidede agentiske funksjoner.
- Tidslinje for offentlig utrulling: UI‑spor antyder dager til uker for bredere tilgang. Historiske mønstre indikerer 1–2 uker fra teaser til forhåndsvisning.
For produksjonsbruk i dag: Mens du venter, integrer via CometAPI sine Grok‑endepunkter. Deres OpenAI‑kompatible API støtter sømløs switching og tilbyr kostnadsbesparelser (f.eks. Grok 4 til reduserte satser), perfekt for å bygge apper som enkelt kan oppgraderes til Grok 4.5. Se CometAPI Grok‑tilbud for detaljer.
De harde fakta kommer fra offisielle dokumenter, og de er tause om Grok 4.5. xAI sin modellside lister grok-build-0.1 som en kodemodell trent spesielt for agentiske kodearbeidsflyter, med et 256k kontekstvindu og $1.00 / $2.00 per 1M input/output‑tokens i xAI‑prisdokumentene. Den lister grok-4.3 for generell bruk, med et 1M‑token kontekstvindu og $1.25 / $2.50 per 1M input/output‑tokens. xAI‑siden for rate‑grenser inkluderer Grok 4.3 og Grok Build 0.1, og xAI‑dokumentasjonen for funksjonskall forklarer dagens verktøyflate, men ingen av disse sidene lister Grok 4.5.
Det fraværet betyr noe. En modell kan være reell internt og likevel ikke være brukbar via offentlig API. Team bør skille «xAI kan teste dette» fra «utviklere kan ta dette i bruk».
Offentlig diskusjon er fortsatt nyttig for et smalere formål: den forteller oss hva byggere bør teste først.
De oppfølgende spørsmålene er mer nyttige enn hypen:
- Reduserer Cursor‑stil data mislykkede patch‑forsøk?
- Navigerer Grok 4.5 repositorier bedre enn Grok 4.3 eller Grok Build?
- Slår den Claude Opus 4.8 på reelle oppgaver med flere filer?
- Trenger den færre retrys, færre verktøykall eller mindre menneskelig gjennomgang?
- Forblir den konkurransedyktig når ventetid og utgangslengde måles?
- Generaliserer den utenfor Cursor‑lignende arbeidsflyter?
Behandle X‑tråder som signaler, ikke spesifikasjoner. Spesifikasjonene begynner når xAI oppdaterer modelldokumentene eller utgivelsesnotatene.
Grok 4.5 vs Claude Opus: forventet ytelse
Det reelle rutingsspørsmålet er ikke «Er Grok 4.5 spennende?» Det er: Bør en kode‑ eller agent‑arbeidsflyt bruke Grok 4.5 i stedet for Claude Opus 4.8 når Grok 4.5 blir tilgjengelig?
Claude Opus 4.8 er den ryddige baseline fordi Anthropic har offentlig dokumentasjon og benchmark‑data. Anthropics modelloversikt lister Claude Opus 4.8 med et 1M‑token kontekstvindu og 128k maks output. Anthropics Opus 4.8‑kunngjøring posisjonerer den rundt komplekst agentisk arbeid, koding og bedriftsbrukstilfeller, mens prissiden gir den offisielle API‑prisbaselinen.
Opus 4.8‑systemkortet gir faktiske tall. I evalueringsoppsummeringen rapporterer Opus 4.8 88.6 på SWE‑bench Verified, 69.2 på SWE‑bench Pro, 74.6 på Terminal‑Bench 2.1, 83.4 på OSWorld‑Verified og 1890 på GDPval‑AA.
Forventede styrker ved Grok 4.5:
- Kodespesialisering: Cursor‑data gir en unik fordel i reelle utviklerspor som syntetiske benchmarker undervurderer. Tidligere Grok‑modeller var allerede konkurransedyktige på koding; dette kan dytte den foran på agentiske oppgaver.
- Skala og hastighet: 1.5T parametere + Colossus‑infrastruktur kan gi sterk throughput og langkontekst‑håndtering.
- Kostnad/tilgjengelighet: xAI‑modeller prises ofte konkurransedyktig; CometAPI reduserer kostnader ytterligere (f.eks. Grok 4‑serien med betydelige besparelser).
Claude Opus‑styrker (nåværende flaggskip):
- Påviste benchmarker: Høy SWE‑Bench (~80%+ i nyere versjoner), sterk resonnering (GPQA, ARC‑AGI), utmerket instruksjonsfølging og sikkerhet.
- Modent økosystem: Robust verktøybruk, artefakter og bedriftsfunksjoner.
Sammenligningstabell (projisert/resonert basert på tilgjengelige data)
| Aspekt | Grok 4.5 (forventet) | Claude Opus (nåværende) |
|---|---|---|
| Parametere | 1.5T (V9) | Uoppgitt (tett/ekspert‑miks) |
| Koding (SWE‑Bench, estimat) | Konkurransedyktig/ledende (Cursor‑boost) | ~80%+ Verified |
| Generell resonnering (GPQA/MMLU) | Nær/over Opus | Ledende |
| Kontekstvindu | Stort (antatt 200k+) | 200k+ |
| Pris (via API) | Konkurransedyktig (billigere via CometAPI) | Premium |
| Dataspesialisering | Cursor‑IDE‑spor | Bred + kuratert |
| Tilgjengelighet | Privat beta → snart? | Offentlig API |
| Treningskadens | Månedlige modeller fra scratch | Iterativ |
Tabell syntetisert fra lekkasjer, tidligere benchmarker og analyser. Faktiske resultater venter på offentlige evalueringer.
Behandle Opus‑sammenligningen som en benchmark‑målestokk, ikke en konklusjon. Hvis Grok 4.5 virkelig er nær eller over Opus, bør det vises i løste‑oppgave‑rate, færre retrys, lavere redigeringsbehov og bedre gjenoppretting i verktøysløyfer. Hvis den kun vinner demoer, er det ikke nok for produksjonsruting.
Tre ingeniørmessige blindsoner
Migrasjonsrisikoen er ikke bare modellytelse. Tre mindre synlige detaljer kan gjøre en Grok 4.5‑utrulling kostbar eller skjør.
1. Cursor‑formede gevinster kan ikke overføres til din kodestack
Hvis treningssignalet kommer fra Cursor‑arbeidsflyter, kan modellen være sterkest i Cursor‑lignende redigeringsmønstre. Ditt produksjonssystem kan være annerledes: server‑side agenter, CI‑reparasjonsboter, GitHub‑saks‑triage, intern repo‑migrasjon eller lokale utviklerassistenter.
Evalueringssjekkliste:
- Inkluder virkelige repositorier, ikke leketøysprompter.
- Inkluder oppgaver som krever lesing før redigering.
- Inkluder gjenoppretting etter feilede tester.
- Poengsett korrekthet på endelig patch, ikke bare svarkvalitet.
- Sammenlign ren chat‑modus mot agent‑modus.
- Mål om Grok 4.5 reduserer retrys sammenlignet med Opus 4.8 og Grok 4.3.
2. Ytelse i privat beta kan avhenge av interne harness
En modell testet internt i SpaceX eller Tesla kan dra nytte av interne verktøy, kuraterte prompter, private evalueringer eller spesialisert innhenting. En offentlig API‑versjon kan oppføre seg annerledes.
Evalueringssjekkliste:
- Registrer nøyaktig modell‑ID og utgivelsesdato.
- Registrer verktøytilgjengelighet for hver kjøring.
- Skill modellkvalitet fra harness‑kvalitet.
- Spor p50‑ og p95‑latens.
- Spor verktøyfeil og ugyldige verktøykall.
- Unngå å sammenligne en intern agent‑demo med et rått API‑kall.
3. Prising og kontekstgrenser kan viske ut benchmark‑gevinster
Selv om Grok 4.5 er sterkere, er den ikke nødvendigvis billigere. Tokenpris, kontekstvindu, utgangstak, prompt‑caching, rate‑grenser og kostnad for verktøykall betyr alt.
Bruk denne rutingsmetrikken:
Effektiv kostnad per løst oppdrag = (primærmodellkostnad + retry‑kostnad + fallback‑kostnad + kostnad for menneskelig gjennomgang) / vellykkede oppdrag
Hvis Grok 4.5 løser flere oppdrag med færre retrys, kan den være verdt en høyere tokenpris. Hvis den bruker flere tokens, looper lenger eller krever mer gjennomgang, vil lanseringshypen ikke oversettes til lavere arbeidsbelastningskostnad.
Slik evaluerer du Grok 4.5 selv
Bruk lekkasjevinduet til å forberede evalueringen før modellen dukker opp.
1. Bygg et 20‑oppgavers kode‑agent‑sett
Inkluder reelle oppgaver:
- feilfiks i eget repo
- refaktorering på tvers av flere filer
- avhengighetsmigrering
- reparasjon av feilet test
- kodegjennomgang med subtil regresjon
- dokumentasjonsoppdatering knyttet til kode
- UI‑feil fra skjermbilde pluss kilde
- SQL‑ eller datapipeline‑problem
- verktøykall‑arbeidsflyt
- langkontekst spørsmål om repo
2. Kjør de samme oppgavene på tilgjengelige baseliner
Ikke vent på Grok 4.5 for å begynne å måle. Kjør det samme settet på:
- Grok 4.3 for nåværende xAI generell resonnering
- Grok Build 0.1 for den offisielle xAI‑kodemodell‑baselinen der tilgjengelig
- Claude Opus 4.8 for høy‑kapabilitets koding og agentisk arbeid
- Claude Sonnet 5 for lavere kost produksjonsruting
- din nåværende produksjonsmodell
3. Mål kostnad per løst oppdrag
Spor:
- input‑tokens
- output‑tokens
- verktøykall
- retrys
- mislykkede patches
- testrate (bestått)
- latens
- redigeringsbehov fra gjennomleser
- endelig bestått/ikke‑bestått
- kostnad per akseptert patch
Ikke sammenlign enkeltstående utdata. Sammenlign de samme oppgavene, samme instruksjoner, samme verktøy og samme scoringsrubrikk.
4. Legg til Grok 4.5 først etter offentlig tilgjengelighet
Når xAI eller CometAPI eksponerer en stabil Grok 4.5‑modell‑ID, legg den inn i den samme evalueringen. Ikke skriv om evalueringen rundt den nye modellen. Hele poenget er å holde benchmarken stabil nok til at sammenligningen betyr noe.
5. Velg etter arbeidsbelastningsklasse
Bruk vinner‑modellen per oppgavetype, ikke per merke:
- Bruk den billigere modellen når oppgavesuksess er lik.
- Bruk Opus 4.8 når feil er dyre og Grok 4.5 ikke har bevist paritet.
- Bruk Grok 4.5 kun der den slår gjeldende baseliner på dine egne oppgaver.
- Hold en fallback‑rute til feilrater, latens og kostnad er stabile.
Hva vi vet vs. hva vi ennå ikke kan verifisere
Bekreftet / sterkt signalisert:
- 1.5T V9‑foundation + Cursor supplerende trening.
- Privat beta hos SpaceX/Tesla (28. juni 2026).
- Musk‑tilskrevet «nær/over Opus»‑påstand.
- Månedlig ny modell‑roadmap.
- UI‑kanari‑spor.
Uverifisert / åpne spørsmål:
- Eksakte benchmarker (intet systemkort).
- Dato for offentlig lansering og API‑prising.
- Fullt kontekstvindu, multimodale kapabiliteter.
- Presis Cursor‑datamengde, lisens og miksforhold.
- Ytelse vs. spesifikke Opus‑versjoner eller andre toppmodeller (f.eks. GPT‑5.5, Gemini 3.x).
- Grok 4.5 vs. rykteomtalte større Grok 5‑varianter.
Behandle påstandene som leverandør‑retning. Historien viser at interne evalueringer kan avvike fra offentlige; uavhengig verifisering er essensiell.
Hva du bør følge med på videre
Følg fem ting de neste ukene:
- xAI‑modelldokumenter som legger til en Grok 4.5‑modell‑ID.
- xAI‑utgivelsesnotater som bekrefter offentlig eller forhåndstilgang.
- Uavhengige kode‑agent‑benchmarker, spesielt SWE‑bench, Terminal‑Bench og Cursor‑stil kode‑agent‑oppgaver.
- Reelle utviklerrapporter om Cursor‑lignende kodearbeidsflyter.
- CometAPI‑katalog eller dashbord‑oppdateringer for Grok 4.5‑tilgjengelighet.
Det første pålitelige kjøpssignalet vil ikke være en viral X‑post. Det vil være en modell‑ID pluss repeterbare evalueringsresultater.
Fremtidsutsikter: Månedlige modeller og videre
xAI sin takt — nye basismodeller månedlig — kan redefinere iterasjonshastighet. Grok 4.5 er et inkrementelt sprang; Grok 5‑varianter lover mer. Forvent fortsatt vekt på sannhetssøking, humor og nytte i den virkelige verden i tråd med Musks visjon.
Call to Action: Registrer deg for CometAPI i dag for å få rimelig tilgang til kraftige Grok‑modeller og ligge i forkant. Følg x.ai og X for offisielle Grok 4.5‑oppdateringer. AI‑koderevolusjonen akselererer — posisjoner arbeidsflytene dine nå.