
Å kjøre Qwen3.8-Max lokalt er nå mulig, men uttrykket “Qwen 3.8 Max lokalt” trenger en viktig presisering. Alibabas hostede Max-produkt og det nedlastbare sjekkpunktet er nært beslektet, men de er ikke identiske produkter.
Qwen lanserte først den hostede Max-tjenesten tidlig i august 2026 og slapp Qwen3.8-2.4T-A95B som åpne vekter den 12. august 2026. Det sjekkpunktet er modellen du faktisk distribuerer på egen infrastruktur.
Dette er ikke en vanlig “Ollama-på-en-gaming-PC”-veiledning. Det ukvantiserte sjekkpunktet er en Mixture-of-Experts-modell med 2,4 billioner parametere, og den nåværende vLLM-oppskriften estimerer BF16-vektene til 4,45 TiB. Selv produksjonsrettede 4-bits flyttallsvarianter opptar fortsatt omtrent 1,3–1,5 TiB med vekter.
Kort svar: full selvhostet Qwen 3.8 Max-klasse er en datasenterdistribusjon. Et praktisk produksjonsutgangspunkt er et FP4-sjekkpunkt på 8× B300 eller 8× MI355X GPU-er; H200-distribusjoner trenger flere GPU-er. For en normal arbeidsstasjon, bruk Qwen3.8-27B i stedet.
Qwen 3.8 Max vs. den åpne modellen du faktisk distribuerer
Det nedlastbare Qwen3.8-2.4T-A95B-sjekkpunktet beskrives offisielt som en kausal språkmodell med 2,4T parametere og omtrent 95B parametere aktivert per token. Den hostede Max-tjenesten legger til produktlag-funksjoner som ikke finnes i det nåværende åpne sjekkpunktet.
| Spesifikasjon | Qwen3.8-Max hostet tjeneste | Qwen3.8-2.4T-A95B åpent sjekkpunkt |
|---|---|---|
| Totale parametere | 2.4T | 2.4T |
| Aktive parametere | ~95B | ~95B |
| Arkitektur | Sparse MoE | Sparse MoE |
| Inndata | Tekst, bilde, video | Tekst |
| Kontekst | 1M administrert kontekst | 262,144 native; utvidbar til ~1,01M |
| Resonneringsatferd | Administrert “thinking”/ikke-thinking | Thinking påkrevd; resonneringsinnsats konfigurerbar |
| Innebygde verktøy | Tilgjengelig i administrert tjeneste | Applikasjonen må tilby verktøy |
| Selvhostet | Ingen håndtering av vekter nødvendig | Ja; åpent sjekkpunkt |
Det hostede produktet eksponerer tekst-, bilde- og videoinndata med et kontekstvindu på 1 000 000 token. Det åpne sjekkpunktet er derimot kun tekst og har et native kontekstvindu på 262 144 token. Denne forskjellen er viktig hvis applikasjonen din avhenger av multimodal inndata eller administrerte innebygde verktøy.
Qwen 3.8-arkitektur og spesifikasjoner
CometAPI dekker allerede modellbakgrunnen i What is Qwen3.8 Max, så denne distribusjonsveiledningen holder arkitekturdiskusjonen fokusert på detaljer som påvirker minne, parallellisme og serving.
| Distribusjonsrelevant spesifikasjon | Qwen3.8-2.4T-A95B |
|---|---|
| Totale / aktive parametere | 2.4T / ~95B per token |
| Lagoppsett | 92 lag: 69 Gated DeltaNet + 23 full attention |
| MoE-ruting | 512 rutede eksperter; 10 rutede + 1 delt aktiv |
| Full-attention hoder | 64 query / 4 key-value hoder |
| Native kontekst | 262,144 token |
| Utvidet kontekst | Opptil omtrent 1,010,000 token |
| Multi-Token Prediction | Støttet |
| Modalitet for åpent sjekkpunkt | Kun tekst |

Offisiell Qwen hybrid modellarkitektur brukt i SGLang Qwen3.8-distribusjonsveiledningen.
Ikke tolk “95B aktive parametere” som et 95B-modellminnefotavtrykk. Sparse aktivering reduserer beregning per token, men serving-systemet må fortsatt ha tilgang til hele ekspertsvektsettet.
Qwen 3.8 Max benchmark-oversikt
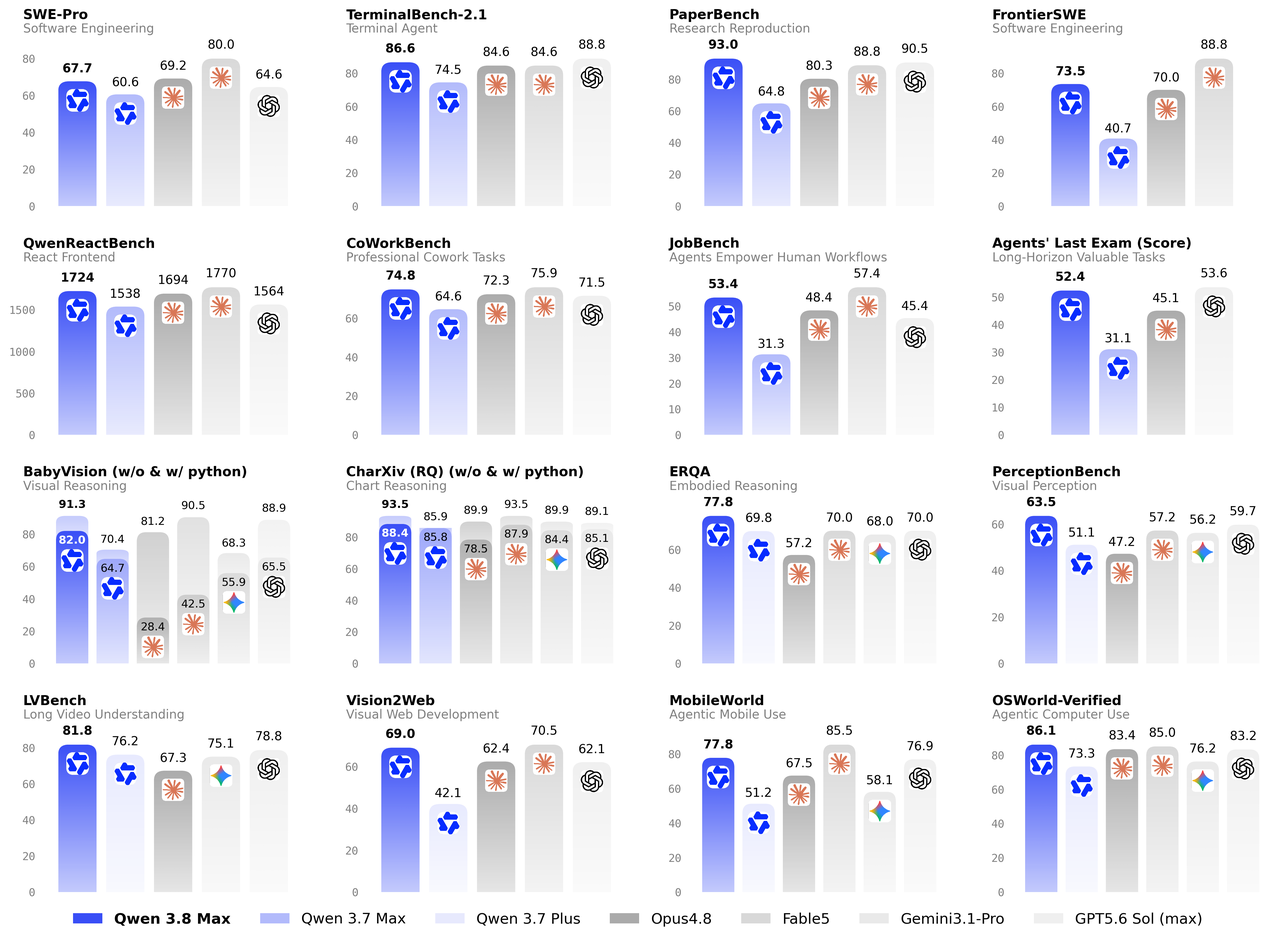
Siden CometAPIs eksisterende Qwen3.8 Max-oversikt allerede diskuterer benchmarks i detalj, bruker denne artikkelen kun et distribusjonsrelevant utdrag fra den offisielle Qwen model-kortets benchmark-tabell.
| Benchmark | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (max) |
|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 74.5 | 88.8 |
| SWE-bench Pro | 67.7 | 60.6 | 64.6 |
| PaperBench | 93.0 | 64.8 | 90.5 |
| FrontierSWE | 73.5 | 40.7 | — |
| CoWorkBench | 74.8 | 64.6 | 71.5 |
| GPQA Diamond | 92.6 | 92.4 | 94.1 |
Offisiell Qwen3.8-ytelsesgrafikk publisert av Qwen-teamet.
De største rapporterte gevinstene over Qwen3.7-Max i dette utdraget er PaperBench og FrontierSWE. Qwen3.8-Max overgår også GPT-5.6 Sol på SWE-bench Pro og PaperBench, mens GPT-5.6 Sol fortsatt ligger foran på Terminal Bench 2.1. For distribusjonsbeslutninger bør disse behandles som kapabilitetskontekst; minne- og serving-gjennomstrømmingsmålingene nedenfor er mer operasjonelt relevante.
Benchmark-tabeller er ikke universelle rangeringer. Rammeverk, tidsavbrudd, kontekstgrenser, verktøytilgang og kvantisering kan endre resultater. Benchmark nøyaktig det sjekkpunktet, den presisjonen, serving-motoren og promptfordelingen du planlegger å bruke.
Hvilket maskinvare trenger Qwen3.8 for lokal distribusjon?
GPU-krav for Qwen3.8-2.4T-A95B
Dette er det viktigste distribusjonsspørsmålet. Den nåværende vLLM Qwen3.8-oppskriften publiserer sjekkpunkt-fotavtrykk og realistiske GPU-antall med kjøretidsmargin, noe som er mer nyttig enn å estimere VRAM kun fra parameterantall.
| Presisjon | Vektfotavtrykk | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Best egnet |
|---|---|---|---|---|---|
| BF16 | 4.45 TiB | 24 GPU-er | 24 GPU-er | 48 GPU-er | Maksimal troskap / forskning |
| FP8 | 2.27 TiB | 16 GPU-er | 16 GPU-er | 32 GPU-er | Høy-troskap produksjon |
| MXFP4 | 1.45 TiB | — | 8 GPU-er | 16 GPU-er | Praktisk AMD-distribusjon |
| NVFP4 W4A4 | 1.32 TiB | 8 GPU-er | — | 16 GPU-er | Praktisk NVIDIA-distribusjon |
For de fleste organisasjoner som genuint trenger selvhostet Qwen3.8, er FP4 det praktiske utgangspunktet. Den fremste NVIDIA-konfigurasjonen er NVFP4 W4A4 på 8× B300; den tilsvarende AMD-ruten er MXFP4 på 8× MI355X.
En 8× H200-server er ikke nok for disse anbefalte fullmodell-distribusjonene. Den offisielle oppskriften dimensjonerer H200 til 16 GPU-er for FP4, 32 for FP8 og 48 for BF16.
VRAM-krav for Qwen3.8-27B
Qwen3.8-27B er det praktiske alternativet for arbeidsstasjoner. Rått vektminne er omtrent 54 GB i BF16, 27 GB i FP8 og 13,5 GB ved 4-bits presisjon. Kjøretidsoverhead og KV-cache øker det faktiske behovet, spesielt ved lange kontekster.
| Presisjon | Omtrentlig vektminne | Praktisk distribusjonsveiledning |
|---|---|---|
| BF16 | ~54 GB | Bruk en 64–80 GB GPU, avhengig av kontekst og serving-overhead. |
| FP8 / INT8 | ~27 GB | En 40–48 GB GPU gir mer praktisk kjøretidsmargin. |
| 4-bit | ~13,5 GB | En 20–24 GB konsument-GPU kan være levedyktig ved moderat kontekst. |
Disse tallene er planleggingsestimater avledet fra parameterantall. Bekreft nøyaktig sjekkpunkt, kvantiseringsformat, serving-motor, kontekstlengde og KV-cache-innstillinger før du dimensjonerer produksjonsmaskinvare.
Kan Qwen3.8 kjøre på forbruker-GPU-er?
Den fulle Qwen3.8-2.4T-A95B-modellen er ikke praktisk på vanlige forbruker-GPU-er, selv ved aggressiv kvantisering. Et community-prosjekt har demonstrert en aggressivt komprimert 397 GB UD-Q1_0-build over fire DGX Spark-systemer, men den ruten er en eksperimentell ekstrem kvantisering snarere enn baseline for kvalitetssensitiv serving.
For en arbeidsstasjon eller hjemmelab er den mer passende modellen Qwen3.8-27B, hvis åpne vekter ble sluppet 14. august 2026. Modellen er flere størrelsesordener enklere å drifte og er riktig valg hvis “lokalt” betyr én arbeidsstasjon snarere enn en GPU-klynge.
Før du installerer Qwen 3.8 Max
Planlegg infrastrukturen før du kjører en installasjonskommando. Du trenger Linux, en kompatibel akseleratorstakk, nok lokal eller delt lagring for sjekkpunktet, høybåndbredde GPU-interconnects, og—ved kryssing av noder—et nettverk designet for distribuert inferens. vLLM-oppskriften anbefaler for øyeblikket vLLM nightly og Transformers 5.4.0 eller nyere.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
Hvordan distribuere Qwen 3.8 FP8 med vLLM
FP8 er et fornuftig valg når du vil ha et Qwen-levert sjekkpunkt og har råd til multinode-infrastruktur. Det offisielle sjekkpunktet er Qwen/Qwen3.8-2.4T-A95B-FP8.
For en to-noders, 16-GPU B300-klasse distribusjon, kjør head-noden med:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Ikke kopier 16-GPU-eksempelet til H200-servere uten å endre topologien. Den samme FP8-varianten er for øyeblikket dimensjonert til 32× H200 i vLLM-oppskriften.
Hvordan kjøre Qwen 3.8 på én 8× B300-server
For NVIDIA Blackwell er den mest praktiske fullmodell-konfigurasjonen NVFP4. vLLM validerer for øyeblikket NVFP4 W4A4 med tensorparallellisme over åtte B300 GPU-er.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Inferact NVFP4-bygget er et kvantisert sjekkpunkt snarere enn det originale BF16 Qwen-artefaktet. Valider modellkvalitet på ditt eget akseptsett før du behandler det som en drop-in-erstatning for BF16 eller FP8.
Hvordan distribuere Qwen 3.8 med SGLang
SGLang la til Dag-0-støtte for Qwen3.8 den 12. august og er spesielt attraktivt for høy-gjennomstrømmings serving, prefiks-caching, ekspertparallellisme, spekulativ dekoding og prefill/decode-disaggregasjon.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
SGLang rapporterer 346 output-token/s ved batch-størrelse 1 på TP8 B300 med MTP, og vesentlig høyere aggregert gjennomstrømning i disaggregerte serving-oppsett. Behandle disse tallene som målinger av serving-stakken, ikke som modellkvalitetsbenchmarks.
Test det lokale OpenAI-kompatible endepunktet
Både vLLM og SGLang eksponerer OpenAI-kompatible API-er, noe som gjør applikasjonsintegrasjon enkel.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
Det offisielle modelkortet anbefaler temperature=1.0, top_p=0.95 og top_k=20 som baseline for samplingparametere. For agentiske arbeidsoppgaver, la det være nok output-budsjett til resonnering i stedet for å dimensjonere max_tokens kun for det endelige synlige svaret.
Aktiver 1M-kontekstvinduet
Det åpne sjekkpunktet Qwen3.8-2.4T-A95B har et native kontekstvindu på 262 144 token og kan utvides til omtrent 1,01M. vLLM-oppskriften dokumenterer følgende mønster:
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
Ikke gjør 1M til standard bare fordi det støttes. Større maksimal kontekst reserverer mer cache-kapasitet og kan kraftig redusere samtidighet. Sett --max-model-len til den reelle arbeidsbelastningen.
Hvordan forbedre Qwen3.8-inferensytelse?
Bruk MTP-3 for å redusere latens for enkeltbruker
Qwen3.8 inkluderer Multi-Token Prediction. I vLLMs publiserte målinger flytter MTP-3 per-bruker-output fra 130 til 307 tok/s for FP8 TP16 og fra 133 til 304 tok/s for NVFP4 TP8.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
Bruk fastsafetensors for raskere oppstart
For modeller i terabyte-skala betyr oppstartstid mye. I én vLLM-måling falt vektinnlasting fra 545 s til 306 s med fastsafetensors og lat innlasting.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Bruk ekspertparallellisme for å øke samtidig gjennomstrømning
For høy samtidighet drar Qwen3.8 fordel av ekspert-parallell oppsett fordi den har 512 rutede eksperter. vLLM rapporterer opptil 3 200 totale tok/s/GPU for FP8 EP og opptil 4 300 totale tok/s/GPU for en optimalisert NVFP4 DEP16-konfigurasjon.
Sett --max-model-len for å balansere VRAM og samtidighet
Sett --max-model-len til den lengste sekvensen arbeidsbelastningen faktisk krever. En større verdi reserverer mer KV-cache-kapasitet, øker minnepresset og kan redusere antallet samtidige forespørsler selv når modellvektene allerede passer.
Start med en representativ produksjonspercentil i stedet for modellens maksimalt annonserte kontekst. Last-test den valgte grensen med samme presisjon, batchmønster og serving-motor som brukes i produksjon, og øk den først når reelle forespørsler trenger mer kontekst.
Qwen 3.8 Max lokal distribusjon vs. API
Åpne vekter gjør ikke automatisk lokal inferens økonomisk. Den riktige beslutningen avhenger av utnyttelse, dataresidens, bemanning, tilgjengelighetsmål og om du faktisk trenger den administrerte modellens multimodale funksjoner.
| Dimensjon | Selvhostet Qwen3.8-2.4T-A95B | Qwen3.8-Max via CometAPI |
|---|---|---|
| Infrastruktur | Multi-GPU-server eller -klynge | Ingen GPU-infrastruktur |
| Inndata | Tekst | Tekst, bilde, video |
| Kontekst | 262K native; ~1,01M utvidet | Administrert 1M |
| Datakontroll | Maksimal | Sky-API |
| Operasjoner | Du eier overvåkning, oppgraderinger og HA | Leverandør-administrert |
| Best egnet | Dataresidens, vedvarende utnyttelse, infrastrukturteam | De fleste applikasjonsteam og variable arbeidslaster |
Hvis du allerede eier egnede akseleratorer og har konsekvent høy utnyttelse, kan selvdrift forsvares. Hvis du ville kjøpt en klynge kun for denne modellen, er Qwen3.8-Max på CometAPI vanligvis den ruten med lavest friksjon. Den eksisterende API-veiledningen dekker hostet integrasjon, mens prisguiden dekker kostnadsmodellering; denne artikkelen forblir derfor fokusert på lokal distribusjon.
Vanlige problemer ved lokal distribusjon av Qwen 3.8
Serveren går tom for GPU-minne under oppstart
Reduser først --max-model-len hvis cache er problemet. Hvis selve vektene ikke passer, vil ikke kontekstreduksjon løse rotårsaken; gå over til et validert lavere-presisjons sjekkpunkt eller legg til GPU-er.
Tensorparallellisme feiler med ugyldig størrelse
Qwen3.8 har 64 attention-hoder i sine full-attention-lag, så vLLM krever at TP deler 64. Enkle TP-størrelser er 1, 2, 4, 8, 16 og 32. Rått aggregert VRAM er derfor ikke nok til å velge en topologi.
Serveren bruker lang tid på å starte
Innlasting av én til flere terabyte med vekter pluss kernel-JIT kan ta minutter. Øk VLLM_ENGINE_READY_TIMEOUT_S og prøv et reelt inferensendepunkt i stedet for å anta et kort oppstartsvindu.
Den lokale modellen kan ikke prosessere et bilde
Det er forventet. The open 2.4T checkpoint is text-only
Qwen3.8-2.4T-A95B åpent sjekkpunkt er kun tekst. Denne begrensningen er spesifikk for Qwen3.8-2.4T-A95B. Qwen3.8-27B støtter visuell inndata når dets separate vision projection-filer lastes.
1M-kontekst reduserer gjennomstrømming dramatisk
Reduser --max-model-len til den lengste sekvensen arbeidsbelastningen faktisk trenger. Det største støttede kontekstvinduet er ikke nødvendigvis den beste produksjonsinnstillingen; velg en kontekstgrense som balanserer arbeidskrav, KV-cache-bruk og samtidighet.
Kan Ollama eller LM Studio kjøre Qwen 3.8 Max?
Økosystemet kan pakke kraftig kvantiserte Qwen3.8-vekter for lama.cpp-stil inferens, men det skal ikke forveksles med en normal skrivebords-Ollama-arbeidsflyt. En kvantisert build som opptar hundrevis av gigabyte krever fortsatt hundrevis av gigabyte tilgjengelig minne og innebærer betydelige kompromisser i kvalitet og ytelse.
For vanlig lokal utvikling er Qwen3.8-27B det passende målet. Den fulle 2,4T-modellen bør behandles som en server/klynge-modell selv når ekstreme community-kvanter gjør den teknisk mulig å starte på uvanlig maskinvare.
Hvilken distribusjonsmetode bør du velge?
For NVIDIA Blackwell er en 8× B300 NVFP4-distribusjon for øyeblikket det reneste fullmodell-utgangspunktet. For AMD er 8× MI355X med MXFP4 den tilsvarende praktiske konfigurasjonen. Bruk FP8 når du prioriterer sjekkpunkt-proveniens og kvalitet over infrastrukturstørrelse, og BF16 kun når maksimal troskap rettferdiggjør minnekrav i flere rack.
For en arbeidsstasjon, bruk Qwen3.8-27B. For applikasjonsteam som trenger Max-kapabiliteter uten GPU-klyngeoperasjoner, bruk den hostede Qwen3.8-Max-modellen på CometAPI.
Konklusjon
Qwen3.8-Max har krysset en viktig terskel siden den første API-lanseringen: Qwen-familien i Max-klassen har nå et åpent 2,4T sjekkpunkt som organisasjoner kan operere helt på egen infrastruktur.
Men åpne vekter betyr ikke forbrukermaskinvare. BF16-fotavtrykket på 4,45 TiB, FP8-sjekkpunktet på 2,27 TiB og FP4-varianter på 1,3–1,5 TiB gjør Qwen3.8-2.4T-A95B til en av de mest infrastrukturintensive åpne modellene som er tilgjengelige. Den praktiske fordelen er at vLLM og SGLang allerede støtter arkitekturen, og FP4 gjør en en-nodes 8× B300 eller 8× MI355X-distribusjon mulig.
Selvhost når datakontroll, vedvarende utnyttelse og eierskap til infrastruktur rettferdiggjør klyngen. Ellers, bruk den administrerte Max-API-en—eller Qwen3.8-27B når det du egentlig vil ha er en sterk Qwen-modell på én arbeidsstasjon.