
TL;DR Googles siste Gemini-utgivelse er ikke den lenge etterlengtede Gemini 3.5 Pro. I stedet lanserte Google tre effektivitetsfokuserte modeller: Gemini 3.6 Flash, Gemini 3.5 Flash-Lite og Gemini 3.5 Flash Cyber. Det praktiske budskapet er klart: Google prioriterer agentøkonomi, latens, token-effektivitet og spesialisert sikkerhetsautomatisering mens flaggskipet Pro-modellen fortsatt testes.
For utviklere er den beste løsningen å ikke vente passivt på Gemini 3.5 Pro. Bruk Gemini 3.6 Flash som standard oppgraderingskandidat for komplekse agenter og kodearbeidsflyter, bruk Gemini 3.5 Flash-Lite for høyt volum av ekstraksjon og ruting, og behold en kryssmodell-tilbakefallsstrategi for avanserte resonnementoppgaver. CometAPI gir enhetlig tilgang til 500+ modeller gjennom én OpenAI-kompatibel API-nøkkel, slik at Gemini kan testes sammen med GPT, Claude, DeepSeek, Kimi, Qwen og andre modeller uten å bygge om integrasjonen.
Hovedpunkter
- Google annonserte Gemini 3.6 Flash, Gemini 3.5 Flash-Lite og Gemini 3.5 Flash Cyber 21. juli 2026. Gemini 3.5 Pro ble ikke lansert her. Google sier den testes med partnere og blir bredt tilgjengelig når den er klar.
- Gemini 3.6 Flash er generelt tilgjengelig i Gemini API, Google AI Studio, Gemini Enterprise Agent Platform, Gemini-appen og Google Antigravity. Gemini 3.5 Flash-Lite er generelt tilgjengelig i Gemini API og er rettet mot arbeidsflyter med høy gjennomstrømning og lav kostnad.
- Gemini 3.5 Flash Cyber har begrenset tilgang, designet for sårbarhetsdeteksjon, validering og patching i CodeMender.
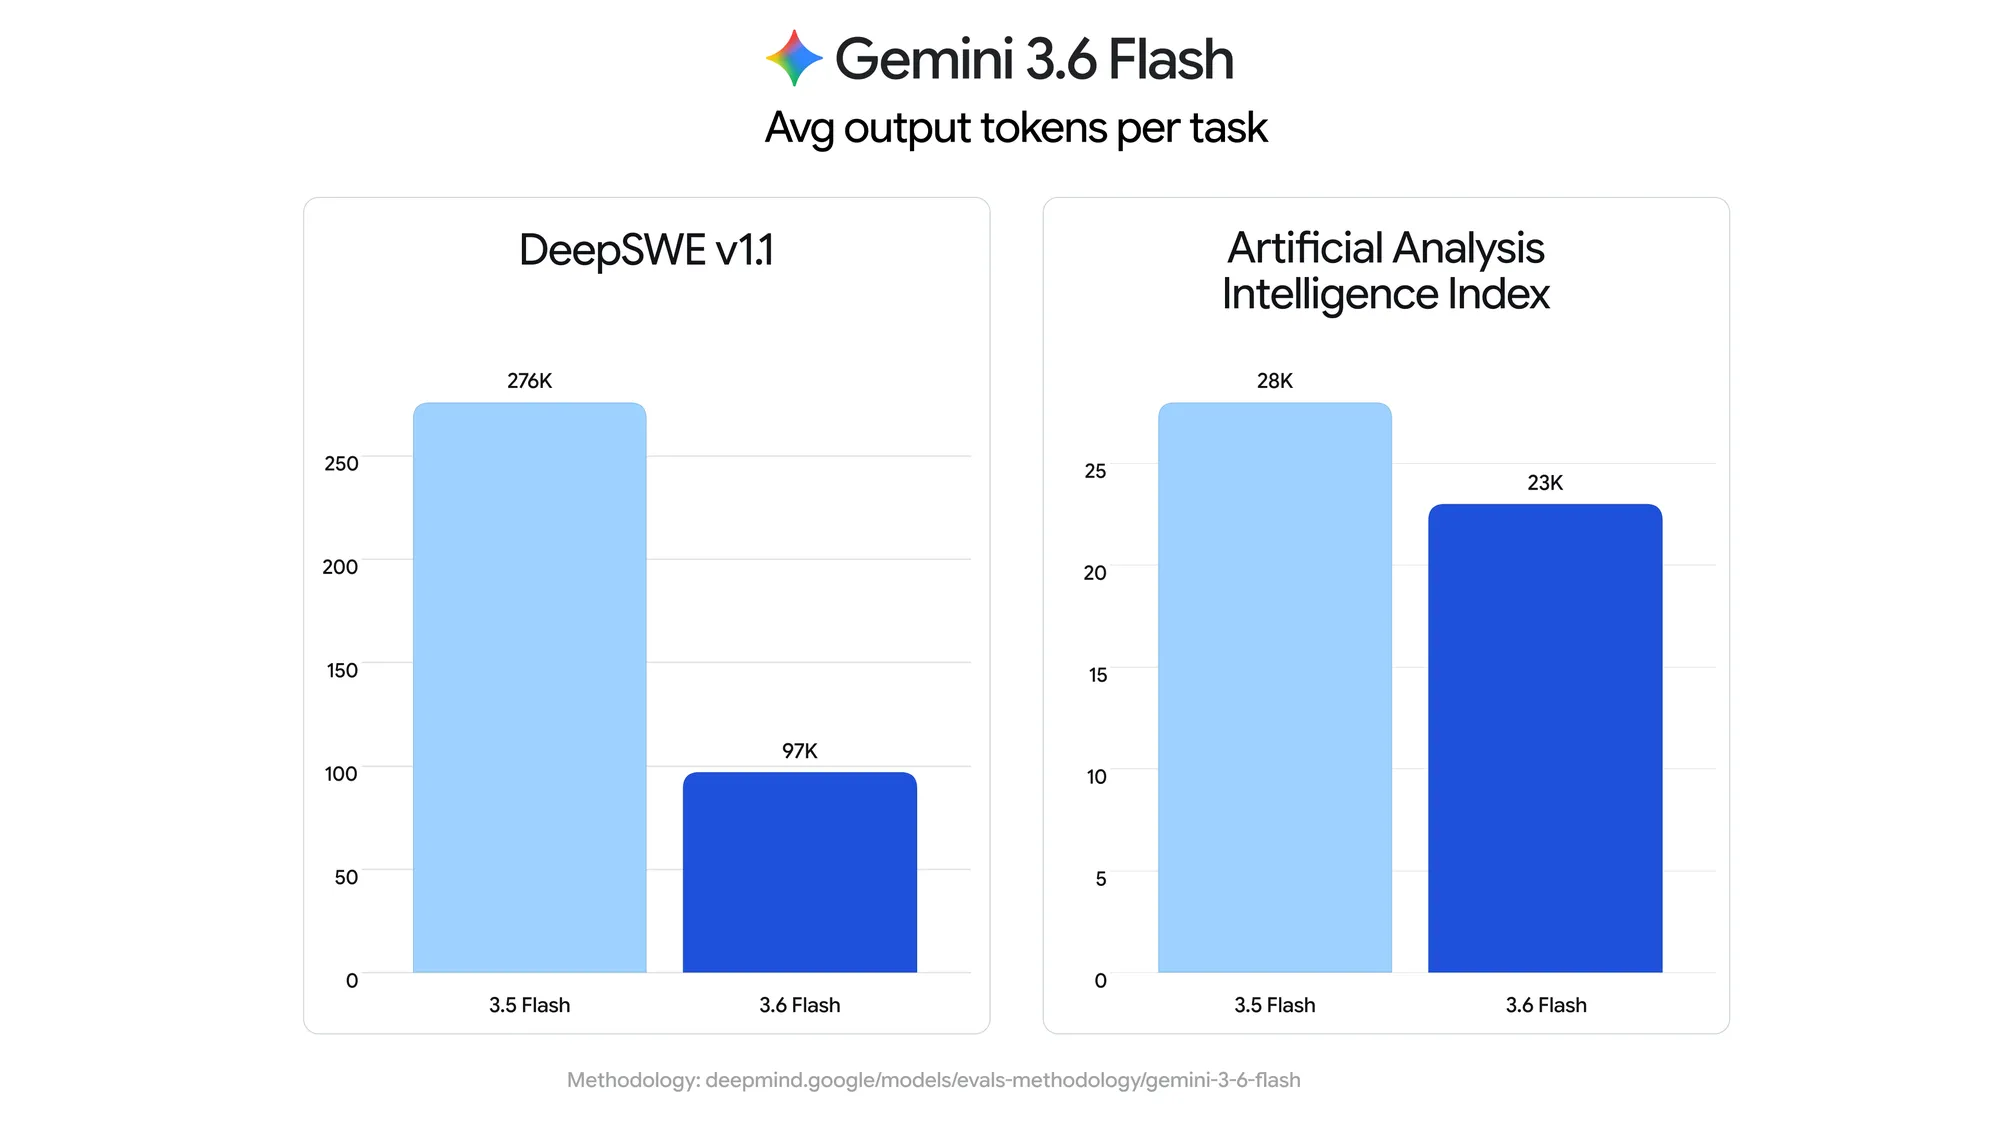
- Google rapporterer at Gemini 3.6 Flash bruker 17 % færre utdata-tokens enn 3.5 Flash på Artificial Analysis og opptil 65 % færre utdata-tokens i tester av DeepSWE-stil.
- Artificial Analysis rapporterer uavhengig Gemini 3.6 Flash med en Intelligence Index-score på 50, 251,3 utdata-tokens/s, og en gjennomsnittlig oppgavekostnad som reduseres fra $0,59 til $0,50 sammenlignet med Gemini 3.5 Flash.
- DeepSWE viser Gemini 3.6 Flash på 49 % pass@1 med $3,53 gjennomsnittlig kostnad per oppgave, sammenlignet med Gemini 3.5 Flash på 37 % pass@1 og $7,34 gjennomsnittlig kostnad per oppgave.
- CometAPI viser for tiden Gemini 3.6 Flash til $1,20/M input og $6,00/M output, og Gemini 3.5 Flash-Lite til $0,24/M input og $2,016/M output. Sjekk live-dashbordet før du publiserer priser i produktgrensesnittet.
Hva lanserte Google?
Gemini 3.6 Flash
Gemini 3.6 Flash er den viktigste modellen i utgivelsen for generelle utviklere. Det er en stabil Flash-tier-modell bygget for produksjonsagenter, koding, multimodale arbeidsflyter, dokumentanalyse, lang kontekst-resonnering og kunnskapsarbeid.
Google beskriver Gemini 3.6 Flash som en arbeidshest-modell som leverer bedre koding, kunnskapsarbeid og multimodal ytelse enn Gemini 3.5 Flash samtidig som token-effektiviteten forbedres. Den offisielle Gemini API-siden sier at modellen er designet for agent-epoken og er spesielt effektiv for rask koding og iterasjonsløkker.
Modellens offentlige ID er:
gemini-3.6-flash
Se kjernespecifikasjoner på Gemini 3.6 Flash-modellsiden.
Gemini 3.5 Flash-Lite
Gemini 3.5 Flash-Lite er effektivitetsmodellen i utgivelsen. Google posisjonerer den som den raskeste og mest kostnadseffektive 3.5-modellen, optimalisert for høy gjennomstrømning, dokumentparsing, oversettelse, klassifisering, ruting og enkel dataekstraksjon.
Modellens offentlige ID er:
gemini-3.5-flash-lite
Se kjernespecifikasjoner på Gemini 3.5 Flash-Lite-modellen sin side.
Den viktigste forskjellen er ikke kontekstvinduet. Flash-Lite beholder samme 1M input og 64K output-profil som 3.6 Flash. Forskjellen er rutingshensikt: Flash-Lite er for gjennomstrømning og kostnadskontroll; 3.6 Flash er for vanskeligere oppgaver der kvalitet og verktøypålitelighet betyr mer.
Gemini 3.5 Flash Cyber
Gemini 3.5 Flash Cyber er en spesialisert cybersikkerhetsmodell bygget på toppen av Gemini 3.5 Flash og finjustert for sårbarhetsfunn, validering og patch-generering.
Dette er ikke en normal offentlig API-modell. Google sier den vil være tilgjengelig for myndigheter og betrodde partnere gjennom CodeMender som en del av et pilotprogram med begrenset tilgang. Den begrensningen betyr noe for utviklere: ikke planlegg en offentlig SaaS-veikart rundt direkte tilgang til Flash Cyber med mindre du er del av pilotprogrammet eller et godkjent defensivt sikkerhetsprogram.
Modellen er fortsatt viktig fordi den viser hvor Google tar Gemini: effektive spesialistmodeller koordinert av agentinfrastruktur. I stedet for å få én frontier-modell til å gjøre alt, bygger Google mindre spesialiserte systemer som kan kjøre gjentatte skanninger, kombinere rapporter og patche kode til lavere kostnad.
Bør du hoppe over Gemini 3.5 Pro?
Det praktiske svaret
For de fleste produksjonsteam: ja, start å evaluere Gemini 3.6 Flash og Gemini 3.5 Flash-Lite nå i stedet for å vente på Gemini 3.5 Pro eller Gemini 4 Pro.
Det betyr ikke at Gemini 3.5 Pro blir uviktig. Det betyr at de siste tilgjengelige modellene allerede dekker en stor andel av AI-arbeidsflyter med høyt volum: kodeagenter, henteagenter, dokumentarbeidsflyter, multimodal parsing, dataekstraksjon, prompt-ruting, UI-automatisering, lang kontekst-gjennomgang og agentsuboppgaver.
Googles egen kunngjøring sier at Gemini 3.5 Pro fortsatt testes med partnere og vil bli sluppet bredt når den er klar. Ingen offentlig gemini-3.5-pro API-modellside, endelig pristabell eller modellkort er nødvendig for å begynne å forbedre produksjonsøkonomien i dag.
Når det fortsatt gir mening å vente på Gemini 3.5 Pro
Du bør fortsatt følge med på Gemini 3.5 Pro eller Gemini 4 Pro hvis arbeidslasten din trenger avansert resonnement mer enn gjennomstrømning. Eksempler inkluderer avansert forskningssyntese, svært kompleks flerfil-ingeniørarbeid, vanskelig matematikk, vitenskapelig resonnement, høyrisiko-foretaksanalyse og oppgaver der en Flash-modell fortsatt feiler etter nøye prompt- og verktøydesign.
Den sterkeste modellstrategien er ikke «vent på Pro» eller «erstatt alt med Flash». Det er nivåbasert ruting:
- Bruk Gemini 3.5 Flash-Lite for rimelige, høyvolums suboppgaver.
- Bruk Gemini 3.6 Flash for koding, multimodal analyse, dokumentgjennomgang, lang kontekst-syntese og agentiske arbeidsflyter.
- Ruter de vanskeligste eller høyest risikable forespørslene til en frontier-resonneringsmodell via CometAPI.
- Legg til Gemini 3.5 Pro i benchmark-suiten når Google og CometAPI gjør den tilgjengelig.
Gemini 3.6 Flash-benchmarks: Hva ble forbedret?
Google DeepMind benchmark-tabell
Gemini 3.6 Flash-siden til Google DeepMind viser følgende sammenligninger mot Gemini 3.5 Flash:
| Benchmark | Hva det måler | Gemini 3.6 Flash | Gemini 3.5 Flash | Endring |
|---|---|---|---|---|
| SWE-Bench Pro | Mangfoldige agentbaserte kodingsoppgaver | 58,7% | 55,1% | +3,6 poeng |
| DeepSWE v1.1 | Langhorisont programvareingeniørarbeid | 49% | 37% | +12 poeng |
| Terminal-Bench 2.1 | Agentbasert terminalkoding | 78,0% | 76,2% | +1,8 poeng |
| MLE-Bench | Maskinlæringsingeniørarbeid | 63,9% | 49,7% | +14,2 poeng |
| GDPval-AA v2 | Elo for kunnskapsarbeid | 1421 | 1349 | +72 Elo |
| OSWorld-Verified | Agentbasert databruk | 83,0% | 78,4% | +4,6 poeng |
| CharXiv-resonnering, uten verktøy | Diagram- og informasjonssyntese | 85,2% | 84,2% | +1,0 poeng |
| CharXiv-resonnering, med verktøy | Diagram- og informasjonssyntese | 89,4% | 84,9% | +4,5 poeng |
| GDM-MRCR v2, 128K gjennomsnitt | Lang kontekst-henting | 91,8% | 77,3% | +14,5 poeng |
| GDM-MRCR v2, 1M punktvis | Lang kontekst-henting | 54,0% | 26,6% | +27,4 poeng |
De største gevinstene er nettopp i områdene som betyr noe for agenter: langhorisont-koding, maskinlæringsingeniørarbeid, lang kontekst-henting og databruk. De mindre gevinstene i Terminal-Bench og CharXiv viser at dette ikke er en uniform «alt ble doblet»-utgivelse. Det er en målrettet forbedring i pålitelighet, token-effektivitet og vanskelig flertrinns utførelse.
Uavhengige data fra Artificial Analysis
Artificial Analysis gir en nyttig motvekt til leverandørenes benchmark-tabeller. Deres skriv fra juli 2026 sier at Gemini 3.6 Flash beholder samme Intelligence Index-score som Gemini 3.5 Flash: 50. Det er viktig fordi det antyder at Gemini 3.6 Flash ikke nødvendigvis er et sprang i rå intelligens.
Den store forbedringen er effektivitet:
| Metrikk | Gemini 3.6 Flash | Gemini 3.5 Flash |
|---|---|---|
| Artificial Analysis Intelligence Index | 50 | 50 |
| Gjennomsnittlig tid per oppgave | 1,3 minutter | 2,7 minutter |
| Gjennomsnittlig kostnad per oppgave | $0,50 | $0,59 |
| Utdatahastighet | 251,3 tokens/s | Ikke i denne tabellen |
| Tid til første token | 14,00s | Ikke i denne tabellen |
Derfor er den beste overskriften ikke «Gemini 3.6 Flash er smartere enn alt». En mer presis overskrift er: Gemini 3.6 Flash gjør agentarbeidslaster billigere og raskere uten å ofre intelligensnivået til Gemini 3.5 Flash.
DeepSWE: Langhorisont-kodingsdata
DeepSWE fra Datacurve er spesielt relevant fordi det fokuserer på originale, langhorisont programvareingeniøroppgaver. Leaderboardet beskriver 113 oppgaver på tvers av 91 repositorier og 5 språk.
På leaderboardet 21. juli 2026:
| Modell | Pass@1 | Gjennomsnittlig kostnad | Utdata-tokens | Agent-trinn |
|---|---|---|---|---|
| Gemini 3.6 Flash high | 49% ±5 | $3,53 | 97K | 108 |
| Gemini 3.5 Flash medium | 37% ±2 | $7,34 | 276K | 86 |
Det mest interessante tallet er ikke bare 12-poengs pass@1-økningen. Det er fallet i utdata-tokens: 97K versus 276K. Det er omtrent 65 % færre utdata-tokens, som samsvarer med Googles lanseringspåstand. For kodeagenter kan færre utdata-tokens bety mindre drift, færre omstendelige reparasjonsløkker, mindre kontekstforurensing og lavere kostnad per fullført sak.
Kilde: Gemini
Gemini 3.5 Flash-Lite-benchmarks: Hvorfor det betyr noe
Flash-Lite er gjennomstrømmingsmodellen
Gemini 3.5 Flash-Lite er designet for høyvolums utførelse. Det er modellen å teste når systemet ditt må behandle tusenvis eller millioner av små eller middels store oppgaver:
- kvitteringsekstraksjon,
- parsing av produktkataloger,
- merking av dokumentbiter,
- oversettelse,
- klassifisering,
- søkresultatsyntese,
- omskriving av spørringer,
- verktøykall-ruting,
- lette kodeoppgaver,
- agentsuboppgaveutførelse,
- multimodal dataekstraksjon.
Google sier at Flash-Lite når 350 utdata-tokens per sekund ifølge Artificial Analysis og er priset til $0,30/M input-tokens og $2,50/M utdata-tokens på standard Gemini API-nivå.
Flash-Lite kontra Gemini 3.1 Flash-Lite
Google DeepMinds modellkort viser store gevinster over Gemini 3.1 Flash-Lite:
| Benchmark | Gemini 3.5 Flash-Lite | Gemini 3.1 Flash-Lite | Endring |
|---|---|---|---|
| SWE-Bench Pro | 54,2% | 38,3% | +15,9 poeng |
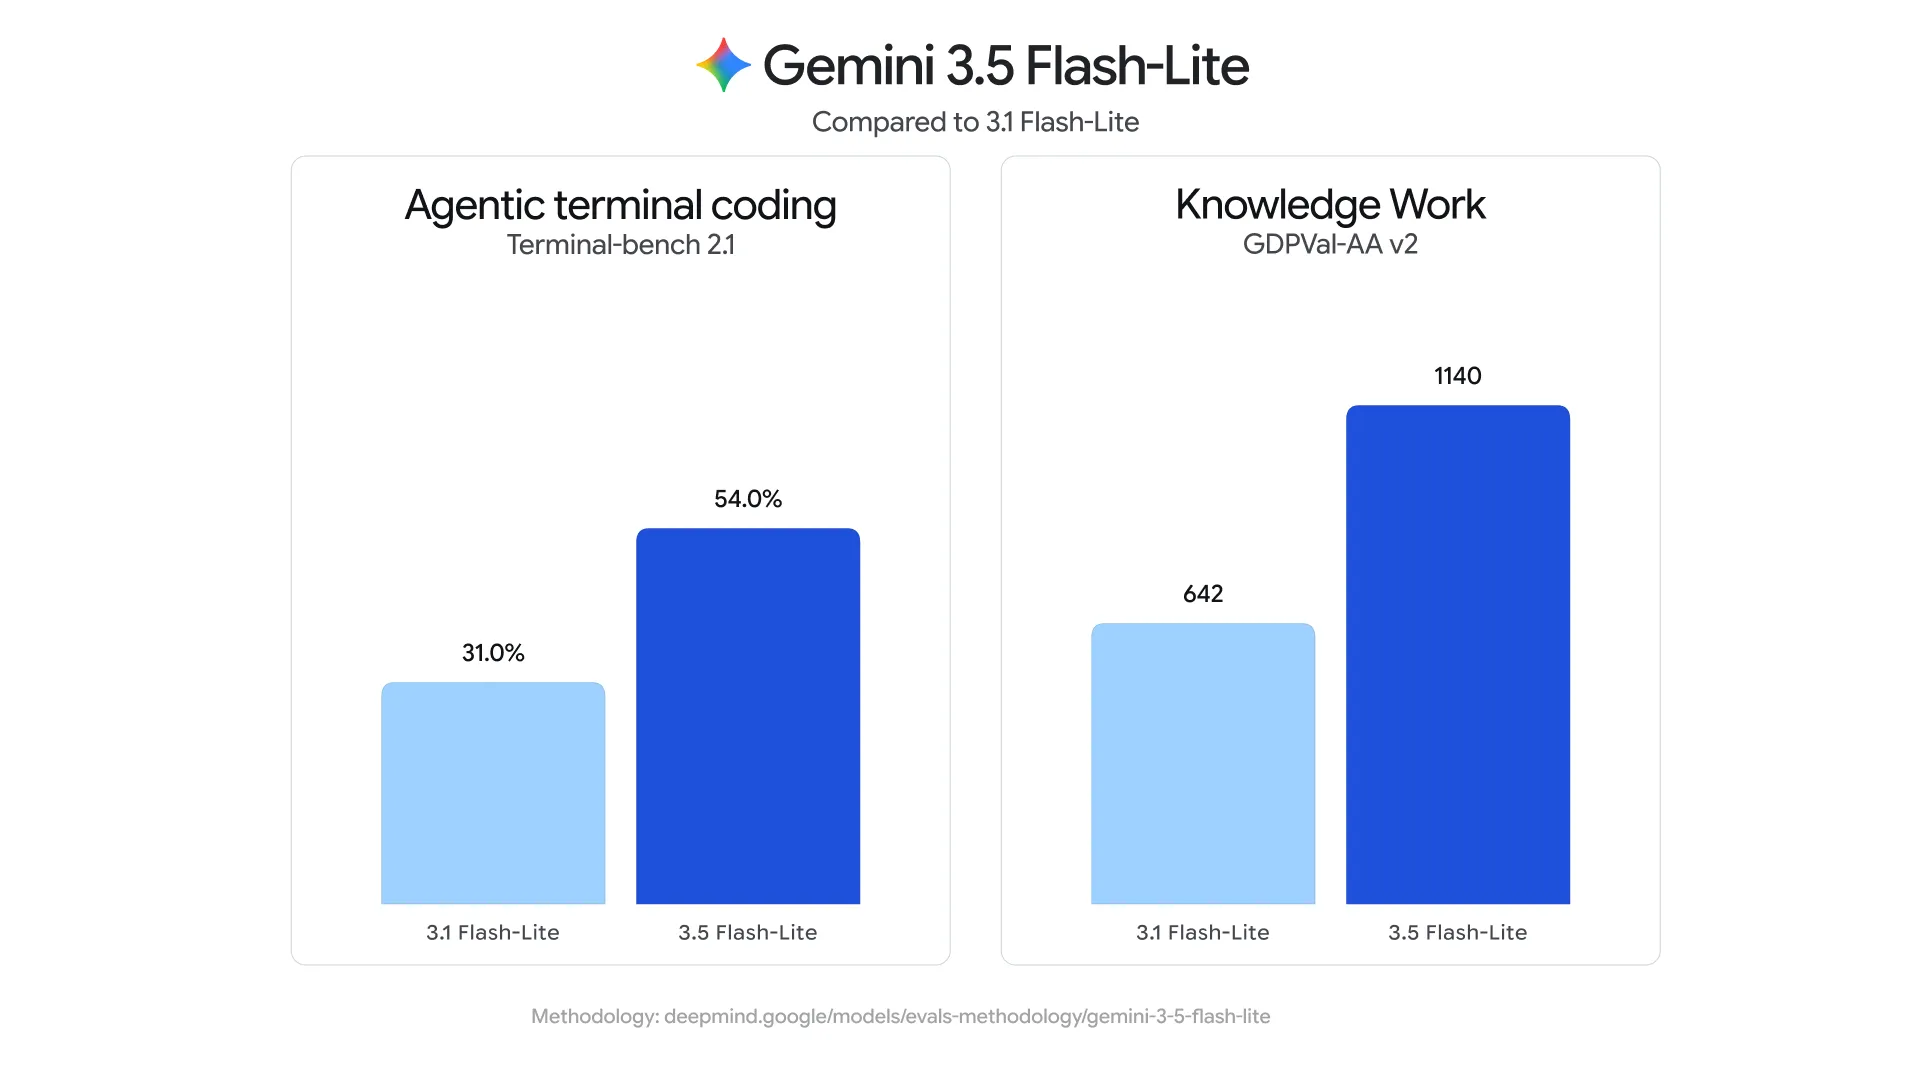
| Terminal-Bench 2.1 | 54,0% | 31,0% | +23,0 poeng |
| MLE-Bench | 39,2% | 22,0% | +17,2 poeng |
| GDPval-AA v2 | 1140 | 642 | +498 Elo |
| OSWorld-Verified | 74,0% | 54,3% | +19,7 poeng |
| CharXiv, uten verktøy | 74,5% | 73,2% | +1,3 poeng |
| CharXiv, med verktøy | 76,5% | 75,6% | +0,9 poeng |
| GDM-MRCR v2, 128K gjennomsnitt | 72,2% | 60,1% | +12,1 poeng |
| GDM-MRCR v2, 1M punktvis | 21,3% | 12,3% | +9,0 poeng |
Artificial Analysis rapporterer også et hopp i Intelligence Index fra 25 for Gemini 3.1 Flash-Lite til 36 for Gemini 3.5 Flash-Lite, mens tid per oppgave faller fra 1,0 minutt til 0,6 minutter. Avveiningen er at kostnad per oppgave økte fra $0,04 til $0,09 i den benchmark-samlingen fordi den nye modellen er priset høyere enn 3.1 Flash-Lite.
Kilde: Gemini
Den avveiningen er akseptabel hvis forbedret kvalitet reduserer nedstrøms omkjøringer, menneskelig gjennomgang eller eskalering til en dyrere modell. Det er mindre attraktivt hvis arbeidslasten din allerede er løst perfekt av Gemini 3.1 Flash-Lite. Test før du migrerer all trafikk.
Betydningen av Gemini-utgivelsen
Det bekrefter skiftet fra «største modell» til «beste arbeidshest»
AI-markedet fokuserer ofte på frontier flaggskipmodeller. Gemini 3.6 Flash peker i en annen retning: produksjons-AI-systemer trenger pålitelige, raske, kostnadseffektive modeller som kan fullføre mange reelle oppgaver uten sløsing.
Derfor vektlegger utgivelsen token-effektivitet, færre verktøykall, lavere latens og færre revisjonsløkker. For utviklere er dette ikke sekundære metrikker. De avgjør om en AI-agent kan kjøre i skala uten å overraske økonomiteamet.
Det gir Google en sterkere produksjonsmodell mens Gemini 3.5 Pro venter
Gemini 3.5 Pro er fortsatt i partner-testing. I stedet for å vente på Pro, lanserte Google en sterkere Flash-modell og en billigere Flash-Lite-modell. Det gir utviklere to umiddelbare alternativer:
- Gemini 3.6 Flash for sterk arbeidshest-intelligens.
- Gemini 3.5 Flash-Lite for billigere, raskere høyvolums utførelse.
Dette er en praktisk produktstrategi. Mange virksomheter trenger ikke den dyreste modellen ved hver forespørsel. De trenger en modellportefølje og rutingslogikk.
Det gjør modellruting viktigere
Gemini 3.6 Flash bør ikke brukes overalt. Det bør heller ikke Flash-Lite. De beste AI-systemene i 2026 vil rute dynamisk:
- Start billig når oppgaven er enkel.
- Bruk Gemini 3.6 Flash når resonnement, multimodal forståelse eller verktøybruk er viktig.
- Eskaler kun når en forespørsel feiler terskler for tillit.
- Cache gjentatt lang kontekst.
- Overvåk kostnad per vellykket oppgave, ikke bare kostnad per token.
Dette er den sterkeste CometAPI-anbefalingen i artikkelen: ikke velg én modell som hele AI-strategien din. Bygg en ruter og la hver modell fortjene trafikken sin.
Vanlige spørsmål
Er Gemini 3.5 Pro tilgjengelig nå?
Ikke som en offentlig, generelt tilgjengelig Gemini API-modell på tidspunktet for skrivingen i juli 2026. Google sier Gemini 3.5 Pro testes med partnere og vil bli sluppet bredt når den er klar.
Er Gemini 3.6 Flash bedre enn Gemini 3.5 Flash?
For mange produksjonsagent- og kodearbeidsflyter, ja. Google rapporterer bedre benchmark-resultater og lavere bruk av utdata-tokens. Artificial Analysis rapporterer tilsvarende Intelligence Index-kvalitet men lavere tid per oppgave og lavere kostnad per oppgave.
Hva er Gemini 3.5 Flash-Lite best for?
Gemini 3.5 Flash-Lite er best for arbeidsflyter med høyt volum, lav latens og kostnadssensitivitet, som ekstraksjon, klassifisering, oversettelse, søk, ruting og subagent-utførelse.
Kan jeg bruke Gemini 3.5 Flash Cyber via den offentlige Gemini API-en?
Google beskriver Gemini 3.5 Flash Cyber som en modell med begrenset tilgang tilgjengelig for myndigheter og betrodde partnere gjennom CodeMender. Den er ikke posisjonert som en standard offentlig API-modell.
Hvor mye koster Gemini 3.6 Flash?
Googles standard Gemini API-prising viser Gemini 3.6 Flash til $1,50 per 1M input-tokens og $7,50 per 1M utdata-tokens. CometAPI viser den for tiden til $1,20/M input og $6,00/M output. Verifiser alltid live-priser før produksjonsutrulling.
Hvor mye koster Gemini 3.5 Flash-Lite?
Googles standard Gemini API-prising viser Gemini 3.5 Flash-Lite til $0,30 per 1M input-tokens og $2,50 per 1M utdata-tokens. CometAPI viser den for tiden til $0,24/M input og $2,016/M output. Verifiser alltid live-priser før produksjonsutrulling.
Bør utviklere vente på Gemini 3.5 Pro?
De fleste team bør ikke vente. Begynn å teste Gemini 3.6 Flash for komplekse arbeidsflyter og Gemini 3.5 Flash-Lite for suboppgaver med høyt volum nå. Legg til Gemini 3.5 Pro i benchmark-suiten når offentlige spesifikasjoner, priser og tilgjengelighet bekreftes.
Endelig konklusjon
Googles Gemini-utgivelse i juli 2026 bør forstås som en effektivitetsslipp, ikke en flaggskip-Pro-slipp. Gemini 3.6 Flash visker ikke ut behovet for en fremtidig Gemini 3.5 Pro, men den gir utviklere noe umiddelbart nyttig: en generelt tilgjengelig modell med sterk koding, multimodal, lang kontekst og agentisk ytelse til lavere kostnad for utdata-tokens enn Gemini 3.5 Flash.
Gemini 3.5 Flash-Lite fyller den andre halvdelen av produksjonsstakken. Det er den billige, raske modellen for suboppgaver som ikke trenger maksimal resonnementdybde. Gemini 3.5 Flash Cyber peker mot en fremtid med spesialist-agenter for defensiv sikkerhet, men den begrensede tilgangen gjør den mer relevant som et strategisk signal enn et generelt utviklerverktøy i dag.