
Qwen3.8-Flash forklart: 1M kontekst, 6B aktive MoE-parametere, koding og multimodale benchmarker, pris/ytelse, sammenligninger og CometAPI-tilgang.
TL;DR Alibaba sin Qwen3.8-Flash er en produksjonsmodell for koding i stor skala, agenter, langkontekst-arbeid og multimodale oppgaver. Den støtter 1M tokens hostet kontekst og kombinerer sterke benchmark-resultater med lav API-prising. En åpenvekt-motpart, Qwen3.8-Flash-Next, er tilgjengelig for lokal evaluering og utrulling.
Viktige punkter
- Produksjon vs. åpenvekter-navngivning: Qwen3.8-Flash er den hostede produksjonsmodellen; Qwen3.8-Flash-Next er åpenvekt-arkitekturversjonen brukt for å publisere modellens detaljer og benchmarker.
- Ekstrem sparsom aktivering: 125B hovedparametere + 51B N-gram-embeddinger, med kun 6B aktive parametere per token.
- Lang kontekst: 262K naturlig kontekst for den åpne modellen, utvidbar til 1M med YaRN; produksjonsruten QwenCloud eksponerer 1M kontekst som standard.
- Sterk agentisk koding: Qwen rapporterer 62,5 på SWE-bench Pro, 73,9 på CoWorkBench, 73,5 på Toolathlon Verified og 91,9 på LiveCodeBench v6.
- Multimodal styrke: Qwen rapporterer 84,5 på AndroidWorld, 88,5 på RealWorldQA og 90,6 på MathVision uten kodeinterpreter.
- Effektivitet: QSA oppnår opptil 7,6x prefill og 4,9x decode-kernel-aksellerasjon ved 1M tokens, og Qwen rapporterer 8,6x høyere prefill-gjennomstrømning ved 1M tokens enn Qwen3.7-Plus under høy prefix-cache-treffrate i serving.
- Prising: Alibaba Cloud lister for tiden US$0,15/M input og US$0,47/M output for internasjonal utrulling; CometAPI lister US$0,12/M input og US$0,376/M output.
Offisiell lanseringsillustrasjon for Qwen3.8-Flash — Alibaba/Qwen-kilde
Hva er Qwen3.8-Flash?
Qwen3.8-Flash er Alibaba Qwen sin effektivitetsorienterte produksjonsmodell for koding, agenter, langkontekst kunnskapsarbeid og multimodale oppgaver. Modellen ble annonsert sammen med en åpenvekt-motpart kalt Qwen3.8-Flash-Next. Alibaba beskriver den som en åpenvekt multimodal MoE-modell optimalisert for kapasitet, latenstid og kostnad, og sier at arkitekturen er en tidlig forhåndsvisning av ideer ment for Qwen4.
“Flash”-merket er viktig. Qwen3.8-Max er det større flaggskipnivået for maks kapasitet, mens Qwen3.8-Flash er bygget for å levere mye av den nyttige kodings- og agentytelsen med dramatisk færre aktive beregninger. Utgivelsen aktiverer 6B parametere per token, sammenlignet med langt større aktive fotavtrykk i flaggskip-MoE-systemer.
Produksjonsmodellen leveres under modell-ID qwen3.8-flash. QwenCloud støtter OpenAI-kompatible Chat Completions og Responses API-er pluss et Anthropic-kompatibelt grensesnitt, noe som gjør modellen enkel å integrere i eksisterende agent- og kodestakker.
Qwen3.8-Flash vs. Qwen3.8-Flash-Next: Hva er forskjellen?
Qwen3.8-Flash-Next er åpenvekt-utgivelsen. Den eksponerer arkitekturen, modellvekter, utrullingsveiledning og benchmark-suite. Vektene er tilgjengelige på Hugging Face og ModelScope. Den åpne modellen støtter 262 144 tokens naturlig kontekst og kan utvides til 1M med YaRN.
Qwen3.8-Flash er API-versjonen for produksjon. I den offisielle utgivelsen sier Alibaba at produksjonsversjonen bruker 1M kontekst som standard og inkluderer offisielle innebygde verktøy. I praksis bør utviklere som evaluerer den hostede modellen bruke Qwen3.8-Flash sin API-atferd og prising, mens Flash-Next-utgivelsen er den beste offentlige kilden til arkitektur- og benchmark-detaljer.
Qwen3.8-Flash spesifikasjoner
| Spesifikasjon | Qwen3.8-Flash / Flash-Next |
|---|---|
| Tilbyder | Alibaba Qwen |
| Produksjonsmodell-ID | qwen3.8-flash |
| Åpenvekt-modell | Qwen3.8-Flash-Next |
| Arkitektur | Multimodal Mixture-of-Experts; GDN + QSA hybrid attention |
| Hovedparametere | 125B |
| Aktiverte parametere | 6B per token |
| N-gram-embeddingparametere | 51B |
| Naturlig åpen-modellkontekst | 262 144 tokens |
| Utvidet / hostet kontekst | Opptil 1 000 000 tokens |
| Produksjons-inngangsmodaliteter | Tekst + bilde dokumentert i offisielle integrasjonseksempler |
| Åpenvekt-modaliteter | Tekst + visjon; utgitt som multimodal |
| Kontroller for resonnering | low / medium / xhigh i QwenCloud-eksempler |
| Parallelle verktøykall | Støttet i offisiell Codex-modellkonfigurasjon |
| Åpne vekter | Ja, for Qwen3.8-Flash-Next |
| Lanseringsdato | Utgivelsesvindu 26.–27. august 2026 |
Det viktigste effektivitets-tallet er 6B aktiverte parametere per token. De ekstra 51B N-gram-embedding-parametrene er oppslagsbasert kapasitet; Qwen påpeker at de ikke inngår i per-token matrise-multiplikasjonsbudsjettet på samme måte som transformer-vekter.
Hva er nytt i Qwen3.8-Flash-arkitekturen?
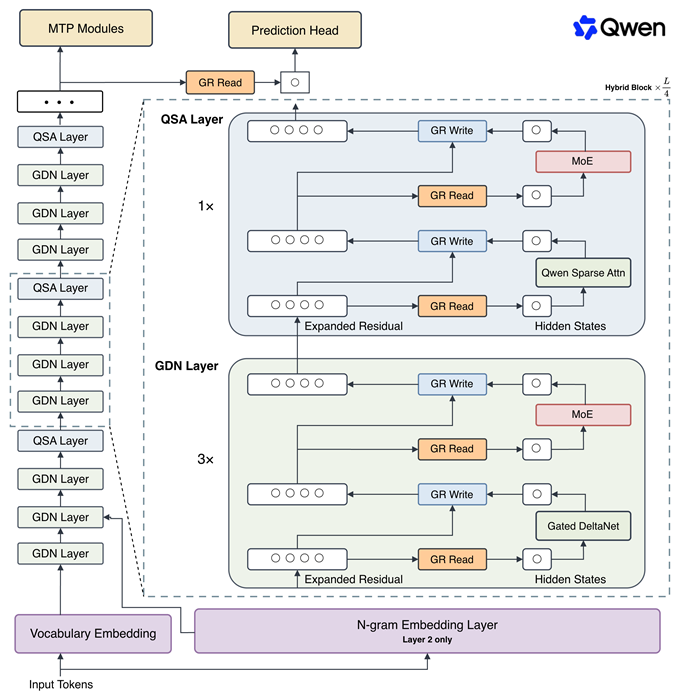
Offisielt Qwen-arkitekturdiagram — Qwen3.8-Flash-Next
1. GDN + Qwen Sparse Attention (QSA)
Modellen blander to mekanismer. Tre av fire lag bruker Gated DeltaNet (GDN) for å komprimere historisk informasjon til en tilstand av fast størrelse, mens det gjenværende laget bruker global oppmerksomhet for presis gjenfinning. Det globale oppmerksomhetslaget bruker deretter Qwen Sparse Attention for å redusere mengden kontekst som må prosesseres direkte.
Det praktiske målet er enkelt: GDN håndterer billig minne, mens QSA bruker full oppmerksomhet bare der gjenfinning betyr noe. Dette er spesielt verdifullt for langkontekst-applikasjoner hvor vanlig full oppmerksomhet blir dyrt både i beregninger og KV-cache-trafikk.
2. Gated Residual med fire informasjonsbaner
Gated Residual utvider residualstrømmen til fire parallelle grener. En dynamisk elementvis port kontrollerer hvor mye informasjon som leses fra og skrives til hver gren. Dette gir tidlig informasjon flere måter å overleve dype nettverk på i stedet for å bli gjentatte ganger blandet i én strøm. Qwen sier også at residualtilstanden kan lagres i FP8 for å redusere minnetrafikk.
3. N-gram-embeddinger gir kapasitet uten proporsjonal beregning
Qwen legger til 51B N-gram-embedding-parametere som adresseres ved hjelp av lokal token-kontekst. I motsetning til normale transformer-vekter hentes disse parameterne via oppslagsoperasjoner og kan lastes ut til vertsmaskinminne med asynkron forhåndshenting. Designet utvider modellkapasiteten samtidig som per-token aritmetikk holdes lav.
4. Muon-optimizer og samskapt trening
Qwen trener modellen med Muon-optimizer for kjerne-2D lineære kart-vekter, samtidig som AdamW beholdes for embeddinger, rutere og utvalgte lavrang-parametere. Teamet tilpasset også skaleringsloven for den nye arkitekturen og rapporterer at batch-størrelse-oppvarming var unødvendig, noe som unngikk 18,8 % ekstra optimizer-trinn i deres eksperimenter.
5. Ultra-sparsom MoE og multi-token prediksjon
Modellen beholder en stor ekspertpool, men ruter kun et lite antall eksperter per token. Den bruker også multi-token prediksjon, som hjelper spekulativ dekoding ved å øke aksept-rater samtidig som den forbedrer ryggraden under trening. Til sammen forsterker disse valgene samme designmål: mer kapasitet og gjennomstrømning uten å betale flaggskip-modellens beregningskost per token.
Qwen3.8-Flash benchmark-ytelse
Kodingsbenchmarker
Alibaba publiserer benchmark-suiten under Qwen3.8-Flash-Next, åpenvekt-motparten til produksjonsmodellen Qwen3.8-Flash. Følgende tabeller bruker Qwen sine rapporterte lanseringspoeng og fokuserer på jevnaldrende som også er tilgjengelige via CometAPI.
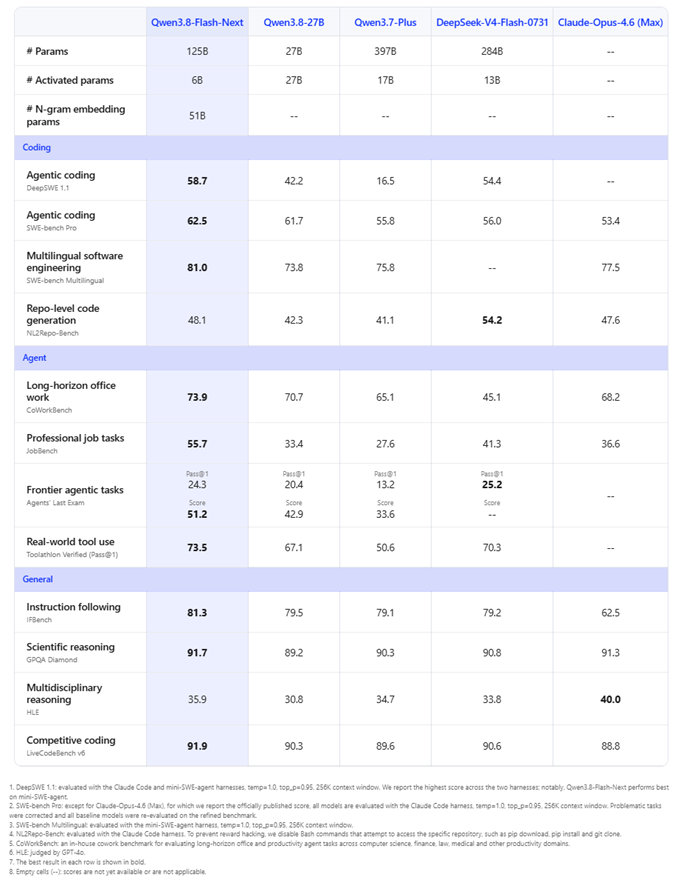
Offisiell Qwen språkbenchmark-graf
| Benchmark | Qwen3.8-Flash | DeepSeek V4 Flash | Claude Opus 4.6 |
|---|---|---|---|
| DeepSWE 1.1 | 58,7 | 54,4 | — |
| SWE-bench Pro | 62,5 | 56,0 | 53,4 |
| SWE-bench Multilingual | 81,0 | — | 77,5 |
| NL2Repo-Bench | 48,1 | 54,2 | 47,6 |
| CoWorkBench | 73,9 | 45,1 | 68,2 |
| JobBench | 55,7 | 41,3 | 36,6 |
| Toolathlon Verified | 73,5 | 70,3 | — |
| IFBench | 81,3 | 79,2 | 62,5 |
| GPQA Diamond | 91,7 | 90,8 | 91,3 |
| HLE | 35,9 | 33,8 | 40,0 |
| LiveCodeBench v6 | 91,9 | 90,6 | 88,8 |
Resultat for koding: Qwen3.8-Flash leder de utvalgte jevnaldrende på SWE-bench Pro (62,5), SWE-bench Multilingual (81,0) og LiveCodeBench v6 (91,9). Det store unntaket er NL2Repo-Bench, hvor DeepSeek V4 Flash scorer 54,2 mot 48,1.
Resultat for agenter: Qwen3.8-Flash leverer 73,9 på CoWorkBench og 55,7 på JobBench, materielt over de valgte jevnaldrende i Qwen sin utgivelsestabell. Den slår også så vidt DeepSeek V4 Flash på Toolathlon Verified, 73,5 mot 70,3.
Resultat for resonnering: Feltet er tettere. Qwen3.8-Flash scorer 91,7 på GPQA Diamond, nær Claude Opus 4.6 på 91,3 og DeepSeek V4 Flash på 90,8. På HLE leder Claude Opus 4.6 med 40,0 mot Qwen sin 35,9.
Multimodale benchmarker
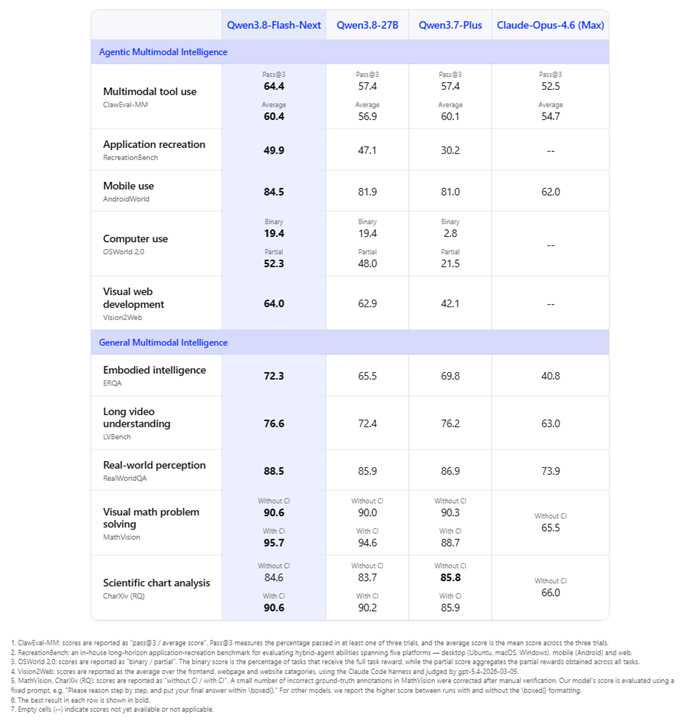
Offisiell Qwen visjon-språk benchmark-graf
| Benchmark | Qwen3.8-Flash | Claude Opus 4.6 |
|---|---|---|
| ClawEval-MM (Pass@3 / Snitt) | 64,4 / 60,4 | 52,5 / 54,7 |
| AndroidWorld | 84,5 | 62,0 |
| ERQA | 72,3 | 40,8 |
| LVBench | 76,6 | 63,0 |
| RealWorldQA | 88,5 | 73,9 |
| MathVision (uten CI / med CI) | 90,6 / 95,7 | 65,5 / — |
| CharXiv RQ (uten CI / med CI) | 84,6 / 90,6 | 66,0 / — |
De multimodale lanseringsresultatene er et av de sterkeste argumentene for Qwen3.8-Flash. Qwen rapporterer 84,5 på AndroidWorld, 88,5 på RealWorldQA og 90,6 på MathVision uten kodeinterpreter. Disse poengene antyder at modellen er ment for agenter som må lese skjermer, forstå visuell tilstand og fortsette å handle, ikke bare besvare bildeforspørsler.
Merk om benchmark: Dette er leverandørrapporterte lanseringsresultater, ikke en nøytral hode-til-hode labtest. Flere benchmarker bruker ulike rammeverk eller verktøykonfigurasjoner, og noen er interne. Behandle tallene som retningstall, og valider deretter modellen på dine egne prompt, verktøy, latenstidsmål og akseptkriterier.
Hvorfor Qwen3.8-Flash er rask og kostnadseffektiv
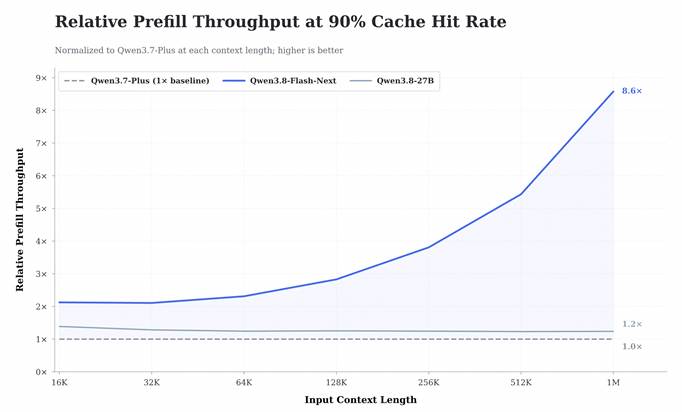
Offisiell Qwen-effektivitetsgraf for lang kontekst
Ved 1M-tokens kontekst rapporterer Qwen opptil 7,6x raskere prefill og 4,9x raskere dekoding for QSA-oppmerksomhetskjernen. I et serving-eksperiment med 90 % prefix-cache-treffrate oppnådde Qwen3.8-Flash-Next 8,6x prefill-gjennomstrømningen til Qwen3.7-Plus.
Den større systemfortellingen er aktiv beregning. En hovedmodell på 125B høres normalt stor ut, men kun 6B parametere aktiveres per token. Det aktive fotavtrykket er mindre enn halvparten av de 13B aktiverte parameterne rapportert for DeepSeek V4 Flash og langt under de omtrent 95B aktive parameterne rapportert for Qwen3.8-Max. Parameterantall oversettes ikke lineært til hastighet, men designet gir Qwen3.8-Flash et klart effektivitetsmål.
Alibaba rapporterer også at trening krevde omtrent en niendedel av ressursene til Qwen3.7-Plus samtidig som ytelsen på koding og kontoroppgaver ble forbedret. Separat rapporteres det at QwenWork Standard-modus drevet av modellen reduserer token-forbruk per oppgave med 75 % og omtrent dobler genereringshastigheten sammenlignet med forrige modus. Disse produktnivåtallene bør ikke behandles som universelle API-latensgarantier, men de viser hvordan Alibaba forventer at modellen skal brukes.
Qwen3.8-Flash prising
Alibabas lanseringskunngjøring lister QwenCloud-priser på $0,16 per million input-tokens og $0,47 per million output-tokens. Priser kan variere etter region, produktsurface, caching eller senere oppdateringer, så produksjonsteam bør alltid sjekke leverandørens live-side før de estimerer en stor arbeidsmengde.
På tidspunktet denne artikkelen ble utarbeidet, lister CometAPI Qwen3.8-Flash til $0,12 per million input-tokens og omtrent $0,376 per million output-tokens. CometAPI-modellsiden merker dette som 20 % rabatt relativt til oppgitt referansepris.
| Rute | Input / 1M tokens | Output / 1M tokens | Eksempel: 10M input + 2M output |
|---|---|---|---|
| QwenCloud lanseringspris | $0,16 | $0,47 | $2,54 |
| CometAPI oppført pris | $0,12 | ~$0,376 | ~$1,95 |
For en arbeidsmengde med 10 millioner input-tokens og 2 millioner output-tokens, er lanseringsarimetikken omtrent $2,54 på QwenCloud versus omtrent $1,95 til den nåværende oppførte CometAPI-prisen. Reelle agentregninger kan være høyere fordi verktøykall, retrier, lang resonnering, gjentatt kontekst og eksterne tjenester legger til kostnad. Sammenlign kostnad per akseptert resultat fremfor kun tokenpris.
Qwen3.8-Flash vs. Qwen3.8-Max vs DeepSeek V4 Flash
| Dimensjon | Qwen3.8-Flash | Qwen3.8-Max | Gemini 3.7 Flash | DeepSeek V4 Flash |
|---|---|---|---|---|
| Posisjonering | Effektivitets-first Qwen-produksjonsmodell | Flaggskip-Qwen-modell | Google arbeidshest Flash-modell | Effektivitets-first tekst-MoE |
| Totale / aktive parametere | 125B + 51B oppslag / 6B | 2,4T / ~95B | Ikke oppgitt | 284B / 13B |
| Kontekst | 1M hostet | 1M | 1 048 576 | 1M |
| Multimodal | Tekst + visjon dokumentert | Tekst + bilde + video | Tekst + bilde + video + lyd + PDF | Tekst-fokusert |
| Kontroller for resonnering | low / medium / xhigh | Avansert resonnering / raske modus | low / medium / high | Non-think / Think / Think Max |
| CometAPI inputpris | US$0,12/M | US$1,60/M | US$0,60/M | US$0,176/M |
| Offisiell tilbyderpris (input / output) | US$0,15 / US$0,47 (Alibaba Cloud internasjonal) | US$2 / US$6 (Alibaba Cloud internasjonal) | US$0,75 / US$3,75 til 31. des. 2026 | Topp: US$0,44 / US$1,32; lavlast: US$0,22 / US$0,66 |
| Best egnet | Koding i stor skala, agenter, samhandling | De hardeste Qwen-oppgavene, langhorisonter | Google-verktøyøkosystem, bred multimodal agent | Høy gjennomstrømning for tekstreasoning og koding |
Hvor Qwen3.8-Flash vinner
- Aktiv-beregnings-effektivitet: 6B aktiverte parametere er usedvanlig lite for en modell som leverer sterke agentiske kode- og multimodale poeng.
- Verdi i Qwen-økosystemet: Qwen3.8-Flash er dramatisk billigere enn Qwen3.8-Max for arbeidsmengder som ikke trenger flaggskipnivået.
- Balanse agent + kontor: Utgivelsen er uvanlig sterk på CoWorkBench, JobBench, Toolathlon, SWE-bench Pro og multimodale agentoppgaver snarere enn bare akademisk QA.
- Åpenvekt-løp: Qwen3.8-Flash-Next tilbyr vekter for team som trenger lokal utrulling, uavhengig evaluering eller finjustering.
Når en annen modell kan være bedre
- Bruk Qwen3.8-Max for maksimal Qwen-kapasitet. Max-nivået har et mye større aktivt beregningsbudsjett og er designet for de vanskeligste langhorisont-oppgavene.
- Bruk Gemini 3.7 Flash når bred inputmodalitetsstøtte er viktig. Google sin Flash-modell dekker eksplisitt lyd, video, PDF og dype Google-verktøyintegrasjoner.
- Bruk DeepSeek V4 Flash når tekst-først-effektivitet er prioritet. Den vinner NL2Repo-Bench i Qwen sin sammenligning og forblir et sterkt kostnadsfokusert kodealternativ.
- Bruk Claude Opus 4.6 når premium resonnering og modenhet i bedriftsarbeidsflyt rettferdiggjør prisen. I Qwen sin utgivelsestabell leder den fortsatt HLE og er svært konkurransedyktig på GPQA.
Beste brukstilfeller for Qwen3.8-Flash
Kodingsagenter og repositorie-arbeid
Qwen3.8-Flash passer godt for feilretting, refaktorering, kodegjennomgang, repo-navigasjon, testgenerering, debugging og verktøydrevne kodingssløyfer. De høye resultatene på LiveCodeBench og SWE-bench Pro antyder at det ikke bare er en lav-latens chat-modell; den er designet for flertrinns programvarearbeid.
Langkontekst kunnskapsarbeid i virksomheter
En produksjonskontekst på 1M tokens kan romme store dokumentkolleksjoner, kodebaser, logger, møtereferater eller langvarig agenthistorikk. Resultatene på CoWorkBench og JobBench gjør modellen spesielt interessant for dokumentsyntese, regneark-/lysbildeflyter, forskningsstøtte, etterlevelsesgjennomgang og operasjonell analyse.
Multimodale agenter
Poengene på AndroidWorld, RealWorldQA, ERQA og MathVision peker mot agenter som må forstå skjermbilder, visuelle dokumenter, grensesnitt, diagrammer og virkelige bilder som del av en arbeidsflyt. Dette gjør modellen relevant for nettleseragenter, UI-testing, visuell QA, dokumentagenter og skjermbevisst automasjon.
Rutting i stor skala
Fordi Qwen3.8-Flash er mye billigere enn flaggskipmodeller, er en praktisk arkitektur å rute mesteparten av produksjonstrafikken til Flash og kun eskalere tvetydige, høyrisiko- eller spesielt vanskelige forespørsler til Qwen3.8-Max eller en annen premiummodell. Samlede gateways som CometAPI gjør dette ruttmønsteret enklere fordi applikasjonen kan bytte leverandører bak én API-kontrakt.
Begrensninger og forbehold
- Benchmarkene er egenrapporterte. Noen bruker Qwen-utvalgte rammeverk, interne oppgaver eller verktøyaktiverte oppsett. Uavhengig verifikasjon er fortsatt viktig.
- Ikke hver benchmark er en seier. DeepSeek V4 Flash leder NL2Repo-Bench i den offisielle sammenligningen, og Claude Opus 4.6 leder HLE.
- Datamaskinbruk er fortsatt vanskelig i absolutte termer. Utgivelsen rapporterer en OSWorld 2.0 binær score på 19,4 selv om delkreditt-ytelsen er mye høyere.
- Hostet og åpenvekt-atferd kan avvike. Systemprompter, verktøy, konteksthåndtering, kvantisering, serving-stakk og leverandøroppdateringer kan flytte virkelige resultater bort fra det publiserte Flash-Next-benchmark-oppsettet.
- Prising er dynamisk. Lanseringskunngjøringen og nåværende aggregator-sider kan vise litt ulike referansepriser. Bruk live endepunktpris ved budsjettering.
Slik bruker du Qwen3.8-Flash API med CometAPI
CometAPI eksponerer Qwen3.8-Flash via et OpenAI-kompatibelt endepunkt, så eksisterende OpenAI SDK-integrasjoner kan typisk bytte ved å endre API-nøkkel, base-URL og modell-ID.
Hvorfor bruke CometAPI for Qwen3.8-Flash?
CometAPI gir utviklere et samlet API-endepunkt for å teste Qwen3.8-Flash sammen med andre modeller uten å vedlikeholde separate leverandørintegrasjoner. Dette er spesielt nyttig for benchmark-sammenligninger, fallback-ruting og kostnadsbasert modellvalg.
- Opprett en CometAPI API-nøkkel. Generer en nøkkel i CometAPI-dashbordet og lagre den i en miljøvariabel i stedet for i kildekode.
- Bruk samlet base-URL. Sett SDK-base-URL til
https://api.cometapi.com/v1. - Velg modellen. Bruk qwen3.8-flash som modell-ID.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="qwen3.8-flash",
    messages=[
        {"role": "system", "content": "You are a precise coding assistant."},
        {"role": "user", "content": "Review this API design and identify reliability risks."},
    ],
)

print(response.choices[0].message.content)
cURL
curl "https://api.cometapi.com/v1/chat/completions" \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.8-flash",
    "messages": [
      {"role": "user", "content": "Summarize the main risks in this migration plan."}
    ]
  }'
For production, add timeout handling, retry policy, token limits, structured output validation, and model-routing telemetry. If your workflow is agentic, track tool-call failures and accepted-task rate in addition to raw model latency.
Vanlige spørsmål
Er Qwen3.8-Flash åpen kildekode?
Produksjonsruten Qwen3.8-Flash er et hostet API. Dens åpenvekt-motpart, Qwen3.8-Flash-Next, har vekter publisert på Hugging Face og ModelScope. “Åpenvekt” er det mer presise begrepet fordi bruksrettigheter avhenger av modellens lisens.
Hva er Qwen3.8-Flash sin kontekstvindu?
Den åpne modellen støtter 262 144 tokens naturlig og kan utvides til 1 000 000 tokens med YaRN. Alibaba sier at produksjonstjenesten Qwen3.8-Flash bruker 1M tokens kontekst som standard.
Hvor mange parametere har Qwen3.8-Flash?
I utgivelsen har den en hovedmodell med 125B parametere, 51B N-gram-embedding-parametere og 6B aktiverte parametere per token. Det lave antallet aktiverte parametere er sentralt for effektivitetsdesignet.
Støtter Qwen3.8-Flash bilder?
Ja. Utgivelsen er multimodal, den åpne utrullingsstakken støtter tekst og visjon, og offisielle integrasjonseksempler lister tekst- og bildeinput for den hostede modellen. Leverandørspesifikke surfaces kan eksponere ulike modalkombinasjoner, så sjekk gjeldende API-kapasitetsside før utrulling.
Er Qwen3.8-Flash bedre enn Qwen3.8-Max?
Ikke universelt. Qwen3.8-Flash er det bedre valget når latenstid, aktiv beregning og pris betyr noe. Qwen3.8-Max er flaggskipvalget for de vanskeligste langhorisont- og høyverdige oppgavene. Et rutesystem kan bruke begge.
Hvor mye koster Qwen3.8-Flash?
Alibaba annonserte $0,16/M input og $0,47/M output-tokens for QwenCloud ved lansering. CometAPI lister for tiden omtrent ~$0,12/M input og ~$0,376/M output. Sjekk live priser fordi tilbyder- og aggregatorrater kan endres.
Konklusjon
Qwen3.8-Flash er et av de tydeligste eksemplene på skiftet fra “større modell” til “bedre systemøkonomi”. Ryggraden på 125B ser stor ut på papiret, men modellen aktiverer kun 6B parametere per token og legger til kapasitet gjennom oppslagsstil N-gram-embeddinger. QSA, Gated Residual, ultra-sparsom MoE-ruting og et serveringsdesign orientert mot lang kontekst trekker alle i samme retning: levere agentisk koding og multimodal kapasitet uten flaggskip-nivå inferenskost.
Utgivelsesresultatene er særlig overbevisende for programvareutvikling, kontoragenter, verktøybruk og visuelle arbeidsflyter. Samtidig er ikke modellen overlegen overalt: DeepSeek V4 Flash vinner minst én repo-genereringsbenchmark i Qwen sin egen tabell, Claude Opus 4.6 er fortsatt sterkere på HLE, og Qwen3.8-Max er fortsatt Qwen-nivået med høyest kapasitet.
For utviklere er det mest praktiske neste steget å evaluere Qwen3.8-Flash på reelle oppgaver og sammenligne akseptert-resultat-kostnad mot Gemini 3.7 Flash, DeepSeek V4 Flash og premiummodellene i din rutingsstakk. CometAPI tilbyr ett OpenAI-kompatibelt grensesnitt for denne typen multi-modell testing og utrulling.