
TLDR Alibabas Qwen-team lanserte offisielt Qwen3.8-Max 3. august 2026 — en sparsom Mixture-of-Experts-modell med 2.4 trillion totale parametere (95 milliarder aktive), et kontekstvindu på 1 million tokens og innebygd multimodal støtte (tekst + bilde + video).
Dette er den første Max-klassem Qwen-modellen som er planlagt for åpne vekter (forventet uken etter). Med en aggressiv pris på $2 per million input-tokens og $6 per million output-tokens leverer den sterke resultater på langhorisont-agentoppgaver, autonom programvareutvikling (inkludert et dokumentert 16-dagers selvevolusjonerende kodeprosjekt), reproduksjon av forskning og multimodale benchmarks. Den konkurrerer tett med modeller som Kimi K3 og ligger over lettere alternativer som DeepSeek V4 Flash i kapasitet, samtidig som den er langt mer kostnadseffektiv enn vestlige toppmodeller på arbeidslaster med mye output. Utviklere kan få tilgang i dag via QwenCloud / Alibaba Cloud Model Studio og gjennom samlede plattformer som CometAPI.
Viktige punkter
- Scale and efficiency: 2.4T total / 95B active MoE architecture bygget på Qwen 3.5 gir ytelse på frontnivå til praktisk inferenskost.
- Long-horizon strength: Demonstrert flerdagers autonom koding (265 commits, 127 PR-er over ~16 dager uten menneskelig inngripen), reproduksjon + forbedring av forskningsartikler, og ett år lange simulerte e-handelsoperasjoner.
- Benchmark highlights: PaperBench 93.0 (ledende), Terminal Bench 2.1 86.6, sterke multimodale og dokumentpoeng; konkurransedyktig men ikke dominerende på alle rene kodeagent-ledertavler mot Claude Fable 5 eller GPT-5.6 Sol.
- Pricing advantage: Flat $2 / $6 per 1M tokens over hele 1M-konteksten (cachet input ~$0.25), underpriser Kimi K3 på output og mange vestlige modeller.
- Availability: Live på QwenCloud og Alibaba Cloud Model Studio (OpenAI- og Anthropic-kompatible API-er); åpne vekter planlagt; allerede oppført på CometAPI som
qwen3.8-maxfor samlet tilgang sammen med 500+ andre modeller. Åpne vekter kommer straks; mindre Qwen3.8-27B-variant planlagt for praktisk lokal/edge-distribusjon. - Practical edge: Utmerker seg i produksjon av ende-til-ende-leveranser fremfor enkeltsvar — ideelt for kodeagenter, forskningspipelines, kontorarbeidsflyter og vedvarende agentløkker.
Hva er Qwen3.8-Max?
Qwen3.8-Max er Alibabas nyeste og mest kapable flaggskipsmodell i Qwen-serien, offisielt lansert 3. august 2026 (etter en forhåndsvisning i midten av juli på World AI Conference i Shanghai). Den representerer et bevisst skifte mot modeller som kan fullføre komplekse, flerdagers oppgaver ende-til-ende med minimal oppfølging og levere produksjonsklare resultater.
Arkitektonisk er den en sparsom Mixture-of-Experts (MoE)-modell som skalerer til 2.4 trillion totale parametere, hvorav kun omtrent 95 milliarder aktiveres per token. Dette designet, bygget på Qwen 3.5, balanserer massiv kapasitet med inferenseffektivitet. Modellen støtter et kontekstvindu på 1 million tokens (dokumentert maks input rundt 991K tokens og maks output rundt 131K tokens), native multimodale inndata (tekst, bilder og video) og tekstutdata. Den inkluderer kontroller for resonnement-innsats (xhigh / medium / low) og støtter både OpenAI Chat Completions og Anthropic-kompatible protokoller, noe som gjør den drop-in-kompatibel med populære agentrammeverk som Claude Code, Codex, Qoder CLI, Qwen Code og OpenClaw.
I motsetning til tidligere Max-klassemodeller som forble lukkede, har Alibaba forpliktet seg til å slippe vektene til Qwen3.8-Max (og en mindre Qwen3.8-27B-variant) uken etter lansering via Hugging Face og ModelScope — første gang en Max-tier Qwen-modell blir åpent tilgjengelig.
Modellen er posisjonert for kodeagenter, profesjonelt arbeid i den virkelige verden (“cowork”), forskning, planlegging over lang horisont og multimodale agentløkker. Offisielle demoer fremhever selvevolusjonerende atferd: modellen oppretter issues, tildeler dem til seg selv, skriver og tester kode, itererer på tilbakemeldinger og forbedrer egne verktøy over lengre perioder.
Kilder: Official Qwen blog og Alibaba Cloud announcements (august 2026); Artificial Analysis model card; uavhengige anmeldelser som oppsummerer GA-utgivelsen.
Hva er nytt i Qwen3.8-Max?
Sammenlignet med forgjengeren Qwen3.7-Max leverer 3.8-generasjonen betydelige løft i agentisk koding, pålitelighet over lang horisont, multimodalt resonnement og dokument/kontorytelse. Viktige nyvinninger inkluderer:
Ekte langtidsautonomi:
Modellen kan opprettholde lukket sløyfe-adaptiv læring over hundrevis av turer eller flere dager. Dokumenterte eksempler inkluderer et 16-dagers autonomt programvareprosjekt som produserte et selvevolusjonerende CLI-verktøy (oh-my-cli) med 265 commits, 127 pull requests og 151 issues helt uten menneskelig inngripen; reproduksjon og forbedring av metodikken i en forskningsartikkel (inkludert GPU-treningssløyfer og målbare benchmark-gevinster); og et helt simulert år med e-handelsdrift som slo baseline-vesentlig.
Multimodalt som en kontinuerlig tilbakemeldingssløyfe:
Syn er ikke bare en inndatamodalitet. Modellen bruker visuell forståelse til planlegging, eksekveringsovervåking og selvkorreksjon — som muliggjør oppgaver som skjermbilde-til-kode-rekreasjon, interaktiv spill-/animasjonsgenerering og 2D-til-3D-visualisering.
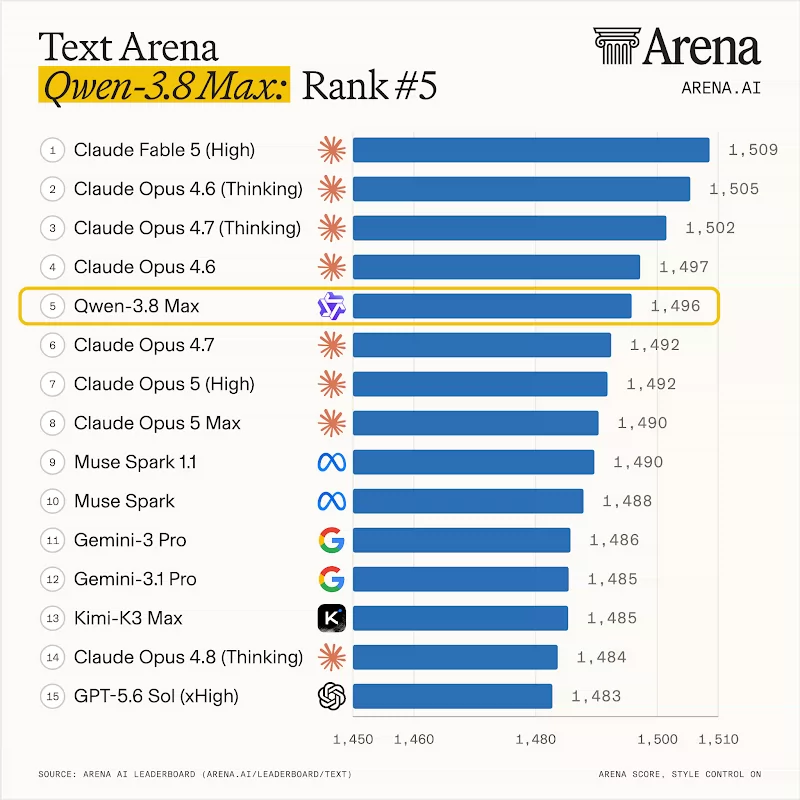
Modellen rangerer høyt på Text Arena (rapportert femte) og Vision Arena (rapportert andre) i early post-release data.

Fokus på ende-til-ende-leveranser:
Vekt på produksjonsklare resultater på tvers av hundrevis av profesjoner fremfor isolerte svar.
Thinking og hurtiginferens-moduser
To moduser: thinking-modus og hurtiginferens-modus. Thinking-modus er for dypere resonnement og kompleks planlegging. Hurtigmodus er for svar med lavere latens når oppgaven er enkel. Alibaba Cloud's OpenCode-dokumentasjonen viser thinking aktivert for Qwen3.8-rutene og lister resonnementskontroller for forhåndsvisningsruten, inkludert xhigh, medium og low.
Dette skillet er verdifullt i produktdesign. Team bør ikke bruke den tyngste resonnementmodusen for hver forespørsel. En supportbot kan klassifisere en enkel henvendelse rimelig, oppsummere med en raskere modell, og eskalere til Qwen3.8-Max thinking-modus kun når brukeren ber om en komplisert beslutning om policy, rotårsaksanalyse, kontraktsgjennomgang eller kode-migreringsplan.
Disse evnene ble validert gjennom interne langvarige eksperimenter og en omfattende benchmarksuite som dekker kodeagenter, generelle agenter, multimodalt resonnement, dokumentforståelse og persepsjon/grounding-oppgaver.
Benchmarking: ytelse for datakvantisering
Alibaba publiserte en omfattende intern benchmarksuite ved GA. Uavhengig verifisering (Artificial Analysis Intelligence Index, LMArena, osv.) var fortsatt i innhentingsfasen i dagene rett etter utgivelsen; tidlige data fra Artificial Analysis plasserte Qwen3.8-Max på en Intelligence Index på 53 (rang ~16/186 i datasettet), med høy verbositet og relativt lavere hastighet som noterte trekk.
Utvalgte offisielle/rapporterte poeng (Qwen3.8-Max vs utvalgte jevnaldrende):
| Benchmark | Qwen3.8-Max | Claude Fable 5 / Opus 4.8 | GPT-5.6 Sol (max) | Qwen3.7-Max |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 86.6 | 84.6 | 88.8 | 74.5 |
| PaperBench | 93.0 | 88.8 / 80.3 | 90.5 | 64.8 |
| SWE-bench Pro | 67.7 | 80.0 / 69.2 | 64.6 | 60.6 |
| FrontierSWE | 73.5 | 88.8 | — | 40.7 |
| DeepSWE 1.1 | 56.6 | 70.0 | 73.0 | 21.6 |
| IFBench | 82.8 | ~63.5 | — | 79.1 |
| GPQA Diamond | 92.6 | 92.6 | 94.1 | 92.4 |
| OmniDocBench 1.5 | 92.1 | — | — | — |
| OSWorld-Verified | 86.1 | — | — | — |
Qwen3.8-Max leder ofte eller ligger nær toppen på multimodalt resonnement, dokument/kontor-oppgaver og enkelte agentisk koding/forskningsmetrikker, mens den ligger bak de sterkeste lukkede modellene på noen rene programvare-ingeniøragent-tester. Generasjonsløftet på FrontierSWE og DeepSWE er spesielt bemerkelsesverdig. Behandle leverandørtall som retningsgivende; uavhengige kjøringer og arbeidslastspesifikk evaluering forblir essensielt.
API-priser for Qwen3.8-Max
Offisielle priser i Alibaba Cloud Model Studio / QwenCloud for Qwen3.8-Max (GA-satser per tidlig august 2026):
- Input: $2.00 per 1 million tokens
- Output: $6.00 per 1 million tokens (inkluderer thinking/resonnement-tokens)
- Cachet input: omtrent $0.25 per 1 million tokens (betydelige besparelser for gjentatte lange kontekster)
Prisingen er flat over hele 1M-token-kontekstvinduet — en merkbar fordel sammenlignet med mange konkurrenter som legger påslag for lang kontekst. Batch- og andre rabatter kan gjelde avhengig av region og plan.
Sammenligningskontekst (omtrentlig listepris i samme periode):
- Kimi K3: ~$3 / $15
- Høyere-end Claude / GPT frontmodeller: ofte $5+ / $15–25+
- DeepSeek V4 Flash-varianter: betydelig lavere (ofte under $0.50 samlet for mange brukstilfeller)
For team som allerede bruker flere tilbydere, tilbyr samlende gateways som CometAPI typisk ~20 % rabatt relativt til offisielle satser, ett OpenAI-kompatibelt endepunkt, samlet fakturering og enkel modellbytte eller failover. Dette gjør utprøving av Qwen3.8-Max (og samtidig sammenligning mot DeepSeek V4 Flash, Kimi-modeller eller andre) operasjonelt enklere og ofte billigere. Sjekk aktuelle CometAPI-prissider og gratiskreditt-tilbud for siste effektive satser.
Hvordan Qwen3.8-Max står seg mot Kimi K3 og DeepSeek V4 Flash
| Dimension | Qwen3.8-Max | Kimi K3 | DeepSeek V4 Flash |
|---|---|---|---|
| Total / Active params | 2.4T / ~95B | ~2.8T / ~104B | 284B / 13B |
| Context | 1M | 1M | 1M |
| Multimodal | Text + Image + Video | Text + Image + Video | Text only |
| Pricing (in/out) | $2 / $6 | $3 / $15 | ~$0.14 / $0.28 (much cheaper) |
| Open weights | Planned (next week) | Already released | MIT, available |
| Strengths | Long-horizon autonomy, multimodal, PaperBench, pricing on output | Strong independent scores, frontend coding Arena leadership | Extreme cost-efficiency, solid agentic coding for size |
| Relative standing | Competitive / leading on several agent & multimodal benches | Slight edge on some audited intelligence indices | Excellent value; lower absolute capability |
Qwen3.8-Max matcher eller overgår generelt Kimi K3 på kostnadseffektivitet for output-tunge jobber og multimodale oppgaver, mens DeepSeek V4 Flash forblir budsjettkongen for tekstvolum der maksimal kapasitet er sekundær. Mange team vil bruke alle tre via en samlet gateway, rute enkel trafikk til Flash-klassem modeller og komplekse agentsesjoner til Qwen3.8-Max eller Kimi K3.
Matcher Qwen3.8-Max Kimi K3?
På noen måter, ja. Den matcher 1M-kontekstnivået, har sterk multimodal posisjonering og er billigere på standard offisiell input/output-prising. Den matcher ikke Kimi K3s 2.8T totale parameterantall, og Kimis offentlige dokumentasjon gir for øyeblikket spesielt detaljerte retningslinjer for verktøy, kontekst-caching, strukturert output og visjon.
Matcher Qwen3.8-Max DeepSeek V4 Flash?
Den konkurrerer på 1M-kontekst og MoE-arkitektur, men produktene sikter mot ulike jobber. DeepSeek V4 Flash er den økonomiske, raske ruten. Qwen3.8-Max er den større, høy-kapasitetsruten for arbeid der multimodal forståelse, avansert resonnement og bedriftsproduktivitet betyr mer enn lavest mulig tokenpris.
Hva kan Qwen3.8-Max gjøre?
Koding og programvareutvikling
Qwen3.8-Max er et sterkt valg for fullstack-utvikling, kodegjennomgang, repository-forståelse, migreringsplanlegging, API-design, debugging, testresonnement og programvarearkitektur. Den lange konteksten hjelper når modellen må holde mange filer, logger og krav i synsfeltet. Bruk den til vanskelige kodeoppgaver, ikke til hver autoutfylling eller enkel lint-forklaring.
Kontor- og kunnskapsarbeid
Modellens “Cowork”-posisjonering er viktig. Ansatte gjør ikke bare chatteforespørsler. De sammenligner PDF-er, oppsummerer møter, vurderer lysbilder, tolker regneark, sjekker kontrakter, skriver rapporter og forbereder beslutninger fra uordnet evidens. Qwen3.8-Max sin multimodale og langkontekst-design gjør den egnet for kontorarbeidsflyter der tekst, dokumenter, skjermbilder og strukturert data må resonnere om samlet.
Agentarbeidsflyter
Qwen3.8-Max er nyttig for agentplanlegging: bryte et mål ned i steg, bestemme hvilket verktøy som skal kalles, evaluere resultater og revidere planen. I CometAPI blir dette mer praktisk fordi samme applikasjon kan rute enkle steg til billigere modeller og reservere Qwen3.8-Max for planlegging eller verifikasjon.
Kom i gang og tips for CometAPI-integrasjon
- Direct access: Bruk QwenCloud eller Alibaba Cloud Model Studio med modell-ID
qwen3.8-max. Både OpenAI-kompatible og Anthropic-kompatible endepunkter støttes. - Unified access via CometAPI: Registrer deg på CometAPI.com, hent en API-nøkkel, sett
base_urltilhttps://api.cometapi.com/v1, og kallmodel="qwen3.8-max". Den samme nøkkelen fungerer for DeepSeek V4 Flash, Kimi K3, Claude, GPT og hundrevis av andre modeller — ideelt for eksperimentering, kostnadskontroll og produksjonsruting. CometAPI vektlegger konkurransedyktige priser, lav latens og rask innføring av nye modeller (Qwen3.8-Max ble listet kort tid etter lansering). - Agent frameworks: Koble direkte inn i Claude Code, OpenClaw eller egne rammeverk. Aktiver høyere resonnement-innsats for komplekse jobber over lang horisont.
- Open weights: Følg med på Hugging Face / ModelScope for den kommende utgivelsen hvis du trenger on-prem eller finjusterte utrullinger.