
TL;DR
MiMo-V2.6 er Xiaomis nye åpen-vekt, naturlig multimodal, agent-orientert resonneringsmodellfamilie. MiMo-V2.6-Pro bruker et sparse MoE-design med 1,02 billioner totale parametere og omtrent 42 milliarder aktiverte parametere per token, mens MiMo-V2.6-Flash bruker 309 milliarder totale parametere og omtrent 15 milliarder aktiverte. Begge støtter et 1M-token kontekstvindu og multimodale input inkludert tekst, bilder, video og lyd.
Viktige poenger
- MiMo-V2.6-Pro er en sparse MoE-modell med 1,02T parametere og ca. 42B aktiverte per token; Flash har 309B totalt og ca. 15B aktiverte parametere.
- Begge modellene støtter et 1M-token kontekstvindu, multimodal input og opptil 128K utdata-tokens via Xiaomis API.
- Familien er designet for resonnering, verktøykalling, nettsøk, strukturert utdata og langhorisont-agentarbeidsflyter.
- Xiaomi trente V2.6 med blandet forsterkningslæring på tvers av koding, generelle agenter, visuelle oppgaver og cybersikkerhetsmiljøer.
- Offisielle resultater posisjonerer Pro som alternativet med høyest kapasitet og Flash som det rimeligere, høyvolumsalternativet; oppgavespesifikk evaluering er fortsatt nødvendig.
Hva er Xiaomi MiMo-V2.6?
MiMo-V2.6 er den nyeste generasjonen av Xiaomis MiMo-modellfamilie. Vekten ligger ikke bare på å generere bedre svar, men på å utføre lange sekvenser av handlinger: inspisere et miljø, kalle verktøy, observere resultater, korrigere feil og fortsette til et mål er nådd. Xiaomi rammer inn lanseringen rundt Recursive Self-Improvement (RSI), altså en RL-treningssløyfe der modellen gjentatte ganger utforsker miljøer, mottar rikere belønningssignaler, sammenligner trajektorier og lærer mer effektive strategier. Dette skal ikke tolkes som at modellen autonomt skriver om og trener sin egen etterfølger.
Pro vs Flash vs UltraSpeed: Hva er forskjellen
| Funksjon | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Posisjonering | Flagship-resonnering | Høyvolum / verdi | Lav-latens flagship |
| Totale parametere | 1.02T | 309B | Samme Pro-modell |
| Aktive parametere | 42B | 15B | Samme Pro-kapasitet |
| Arkitektur | Sparse MoE | Sparse MoE | Pro-serving-modus |
| Kontekst | 1M | 1M | 1M |
| Maks utdata | 128K | 128K | 128K |
| Tekst / bilde / video / lyd-input | Ja | Ja | Ja |
| Dyp resonnering / verktøykalling | Ja | Ja | Ja |
| Strukturert utdata / kontekstkaching | Ja | Ja | Ja |
| Hovedfordel | Maksimal kapasitet | Kostnadseffektivitet | Opptil 20x raskere serving |
MiMo-V2.6-Pro eller Flash: Hvilken bør du bruke?
Praktisk valg: velg MiMo-V2.6-Pro for vanskelig langhorisont-ingeniørarbeid, forskning, cybersikkerhet og høyst verdiagentarbeid; velg MiMo-V2.6-Flash for høyvolumsautomatisering, dokument- og multimodal prosessering og kostnadssensitive gjentatte kall; velg MiMo-V2.6-Pro-UltraSpeed når Pro-nivå resonnering kreves, men latens dominerer. UltraSpeed er et serving-nivå snarere enn en modell med annen kapasitet og er annonsert med opptil 20× utdatahastigheten til standard Pro.
Hvordan fungerer Xiaomi MiMo-V2.6?
Sparse Mixture-of-Experts-arkitektur
MiMo-V2.6 aktiverer ikke hele parametersettet for hvert token. Flagship Pro-sjekkpunktet inneholder 1,02 billioner totale parametere, men bare omtrent 42 milliarder er aktive for hvert token. Xiaomis modelkort beskriver 70 Transformer-lag, 384 ruterte eksperter og åtte eksperter aktivert om gangen. Flash er vesentlig mindre med 309B totalt / 15B aktive, med 48 Transformer-lag og 256 ruterte eksperter.
| Arkitekturspesifikasjon | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| Totale parametere | 1.02T | 309B |
| Aktiverte parametere | 42B | 15B |
| Transformer-lag | 70 | 48 |
| Hidden size | 6,144 | 4,096 |
| Ruterte eksperter | 384 | 256 |
| Aktiverte eksperter | 8 | 8 |
| Maksimal kontekst | 1M | 1M |
| MiMo ViT | 681M parametere | 681M parametere |
| AudioTokenizer | 308M parametere | 308M parametere |
| Audio patch encoder | 127M parametere | 127M parametere |
| Spekulativ dekoder | 5 lag | 5 lag |
Arkitekturen kombinerer skyvevindu-oppmerksomhet med global-oppmerksomhetslag og inkluderer en fem-lags flertokensprediksjon, spekulativ dekoder. Den praktiske implikasjonen er at den overskriftsmessige parameterstørrelsen og per-token-beregningen er svært forskjellige størrelser: sparsom ruting lar Xiaomi opprettholde en stor ekspertpool uten å utføre tett inferens over alle vekter for hvert token.
Naturlig multimodal forståelse
MiMo-V2.6 bruker Xiaomis 681M-parameters MiMo ViT for visuell koding sammen med dedikerte lydkomponenter. Dette gir samme agent evnen til å prosessere tekstinstruksjoner, skjermbilder, fotografier, video og lyd. For databruksagenter er naturlig multimodalitet viktig fordi persepsjon og beslutningstaking kan skje innenfor samme resonneringssløyfe i stedet for å være skilt i atskilte brukerrettede modeller.
Hvorfor er forsterkningslæring så viktig for MiMo-V2.6?
Xiaomi rapporterer at både Flash og Pro gjennomgikk omtrent 30 RL-trinn og rundt 750 000 trajektorier i et seks dagers offentlig treningseksperiment. De rapporterte treningskostnadene var omtrent $850 000 for Flash og $2,62 millioner for Pro. Hver oppdatering brukte 1 568 treningsprøver, med individuelle treningssteg som nådde omtrent 3,5–3,7 milliarder tokens. Oppgavemiksen dekket kode, generelle agenter, visuelle oppgaver, cybersikkerhet og flere agent-harness.
Under denne RL-prosessen rapporterer Xiaomi at out-of-sample DeepSWE v1.1-scoren steg fra 48,8 til 65,7 for Flash og fra 58,4 til 72,6 for Pro. Disse tallene beskriver det levende RL-eksperimentet og bør ikke forveksles med hver endelig benchmarkscore for de utgitte sjekkpunktene, fordi evalueringsoppsettet kan avvike.
Gruppevis agentvurdering
For agenttrening kan en binær bestått/ikke bestått-belønning skjule meningsfulle forskjeller mellom to vellykkede trajektorier. En løsning kan bli ferdig raskt med få verktøykall, mens en annen kan sløse bort dusinvis av steg. Xiaomi beskriver derfor Groupwise Reward Synthesis og Groupwise Advantage Redistribution som mekanismer for å sammenligne trajektorier innenfor en gruppe og redistribuere læringssignal mot renere løsninger. Målet er å forbedre ikke bare oppgavefullføring, men også effektiviteten i veien som tas.
Hvor god er Xiaomi MiMo-V2.6 på agent-benchmarker?
Den sterkeste offentlige evidensen for V2.6 er konsentrert i agentiske benchmarker snarere enn konvensjonelle flervalgsprøver. Xiaomis offisielle diagram sammenligner Pro og Flash med MiMo-V2.5-Pro, Claude Opus 5, GPT-5.6 Sol og Fable 5 på tvers av kode, generelle agenter, cybersikkerhet og visuelle agentoppgaver.
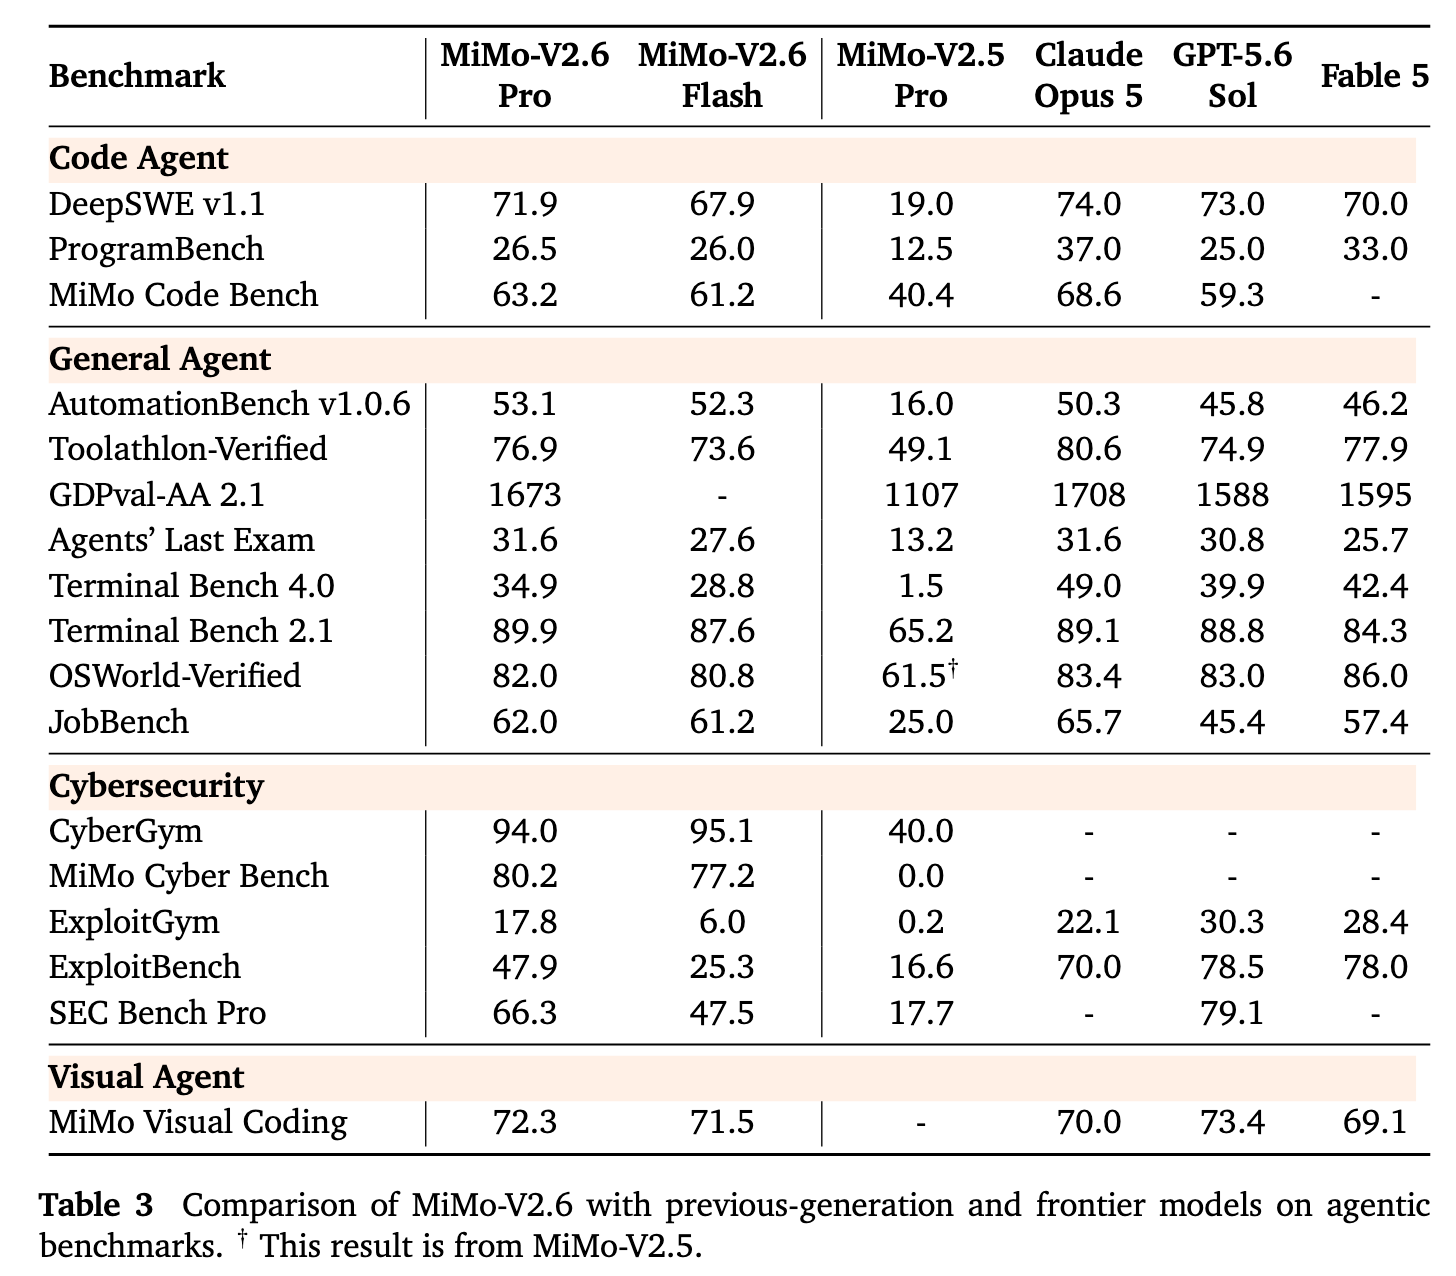
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 26.0 | 37.0 | 25.0 |
| MiMo Code Bench | 63.2 | 61.2 | 68.6 | 59.3 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 |
| Toolathlon-Verified | 76.9 | 73.6 | 80.6 | 74.9 |
| Agents' Last Exam | 31.6 | 27.6 | 31.6 | 30.8 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 89.1 | 88.8 |
| OSWorld-Verified | 82.0 | 80.8 | 83.4 | 83.0 |
| JobBench | 62.0 | 61.2 | 65.7 | 45.4 |
| MiMo Visual Coding | 72.3 | 71.5 | 70.0 | 73.4 |
Fremskritt i koding
Fremskrittene i koding er klarest i langhorisont-utførelse. Under den levende RL-kjøringen rapporterer Xiaomi at out-of-sample DeepSWE v1.1 forbedret seg fra 48,8 til 65,7 for Flash og fra 58,4 til 72,6 for Pro. I den utgitte tverrmodell-tabellen når Pro 71,9 på DeepSWE v1.1 og 63,2 på MiMo Code Bench, mens Flash når 67,9 og 61,2. Pro vinner ikke hver kodetest—Claude Opus 5 ligger fortsatt foran på DeepSWE, ProgramBench og MiMo Code Bench—men V2.6 kombinerer konkurransedyktig ytelse på repositorienivå med åpne vekter og vesentlig lavere API-priser.
Resonnering og agentiske fremskritt
Resonneringsfremskrittet forstås best som forbedret planlegging, verktøykall og gjenoppretting, snarere enn som en enkelt abstrakt intelligensscore. Pro registrerer 89,9 på Terminal Bench 2.1, 53,1 på AutomationBench og 76,9 på Toolathlon-Verified; Flash registrerer 87,6, 52,3 og 73,6. Pro ligger litt over de oppførte resultatene for Claude Opus 5 og GPT-5.6 Sol på Terminal Bench 2.1, mens begge V2.6-modellene leder disse sammenligningene på AutomationBench. Xiaomi tilskriver forbedringen gruppevis trajektorisammenligning, rikere vurderere, multi-harness-trening og belønningssignaler som favoriserer kortere, renere løsningsveier.
Kunnskap og forskningsfremskritt
Kunnskapsintensive fremskritt støttes mer av agent-evalueringer og demonstrasjoner enn av en konvensjonell kunnskapseksamenssuite. Pro matcher Claude Opus 5 på 31,6 på Agents' Last Exam og når 62,0 på JobBench. Xiaomi rapporterer også materialforskningsarbeidsflyter som involverer litteratur- og patentsøk, hypotesegenerering og beregningsverktøy, pluss et Lean 4-formaliseringsprosjekt som overstiger 6 000 verifiserte linjer. Disse eksemplene antyder sterkere gjenfinning, syntese, formell resonnering og verktøyforankret kunnskapsarbeid, men de bør ikke behandles som uavhengig bevis på universell kunnskapsoverlegenhet.
Oppsummert: V2.6s fremskritt er brede, men ujevne. Den er sterkest som evidens for forbedret langhorisont-koding og agentutførelse, mens påstander om generell resonnering og kunnskap bør forbli knyttet til spesifikk benchmark, harness og demonstrasjon.
Benchmark-merknad: Med mindre annet er angitt, er tverrmodellresultatene nedenfor rapportert av Xiaomi i MiMo-V2.6-modelkortet. Poeng kan avhenge av benchmarkversjoner, agent-harness, verktøykonfigurasjoner, inferensbudsjetter og evalueringsprotokoller, så de bør ikke tolkes som en uavhengig reprodusert rangering.
MiMo-V2.6 vs MiMo-V2.5: Hva endret seg?
| Dimensjon | MiMo-V2.5-generasjon | MiMo-V2.6-gjennombrudd |
|---|---|---|
| Treningsfokus | Sterke multimodale agenter, lang kontekst og token-effektivitet | Mye større blandet RL-program på tvers av kode, generelle agenter, visjon, cybersikkerhet og flere harness |
| Agentkapabilitet | V2.5-Pro rettet mot vanskelig langhorisont-arbeid | Xiaomi rapporterer at V2.6-Flash gjennomgående overgår V2.5-Pro på sin agent-benchmarksuite |
| Læringseffektivitet | Forrige produksjonssjekkpunkt | Omtrent 750 000 trajektorier over 30 RL-trinn; holdt av DeepSWE-gevinst på ca. 17 poeng for Flash og 14 poeng for Pro under trening |
| Åpenhet | Åpne vekter og økosystemstøtte | Legger til full RL-kode, 7 000+ oppgavemiljøer, treningsrammeverk, lette harness og et 9B destillasjonssjekkpunkt |
| Økonomi | Eksisterende V2.5 API-prisnivå | Høyere rapportert intelligens til samme offisielle API-priser, som flytter kapasitet-kost-fronten utover |
Koding og agentutførelse
Sammenlignet med V2.5 er den tydeligste endringen en sterkere agentpolicy snarere enn et lengre kontekstvindu. Xiaomi rapporterer at V2.6-Flash overgår V2.5-Pro på tvers av sin agent-benchmarksuite. Under V2.6-treningskjøringen forbedret holdout DeepSWE v1.1 seg fra 48,8 til 65,7 for Flash og fra 58,4 til 72,6 for Pro; disse treningsløpspoengene er ikke direkte utskiftbare med den utgitte benchmarktabellen over.
Resonnering, kunnskap og treningsbredde
V2.6 utvider forsterkningslæring på tvers av koding, generelle agenter, visjon, cybersikkerhet og flere harness. Xiaomi rapporterer omtrent 750 000 trajektorier over rundt 30 RL-trinn. Dette støtter bredere planlegging, verktøykall og gjenoppretting, men etablerer i seg selv ikke en universell gevinst på hver kunnskaps- eller resonneringsbenchmark; sammenlign matchede oppgaver og evalueringsoppsett.
Migrering og åpenhet
Lanseringen legger også til RL-kode, mer enn 7 000 oppgavemiljøer, treningsinfrastruktur og et 9B destillasjonssjekkpunkt. 1M-token kontekst og multimodal input er kontinuiteter fra V2.5, ikke nye V2.6-gjennombrudd.
Den praktiske endringen er derfor ikke en ny kontekstkapsling—1M kontekst og full multimodalitet fantes allerede i V2.5—men en sterkere agentpolicy trent med vesentlig mer forsterkningslæringscompute og bredere verifiserbare miljøer. Xiaomi har annonsert at V2.5- og V2.5-Pro-modellnavnene vil slutte å fungere 21. oktober 2026, så nye utrullinger bør sikte på V2.6 og eksisterende utrullinger bør planlegge migreringstester.
Hvordan V2.6 sammenlignes med andre frontmodellene
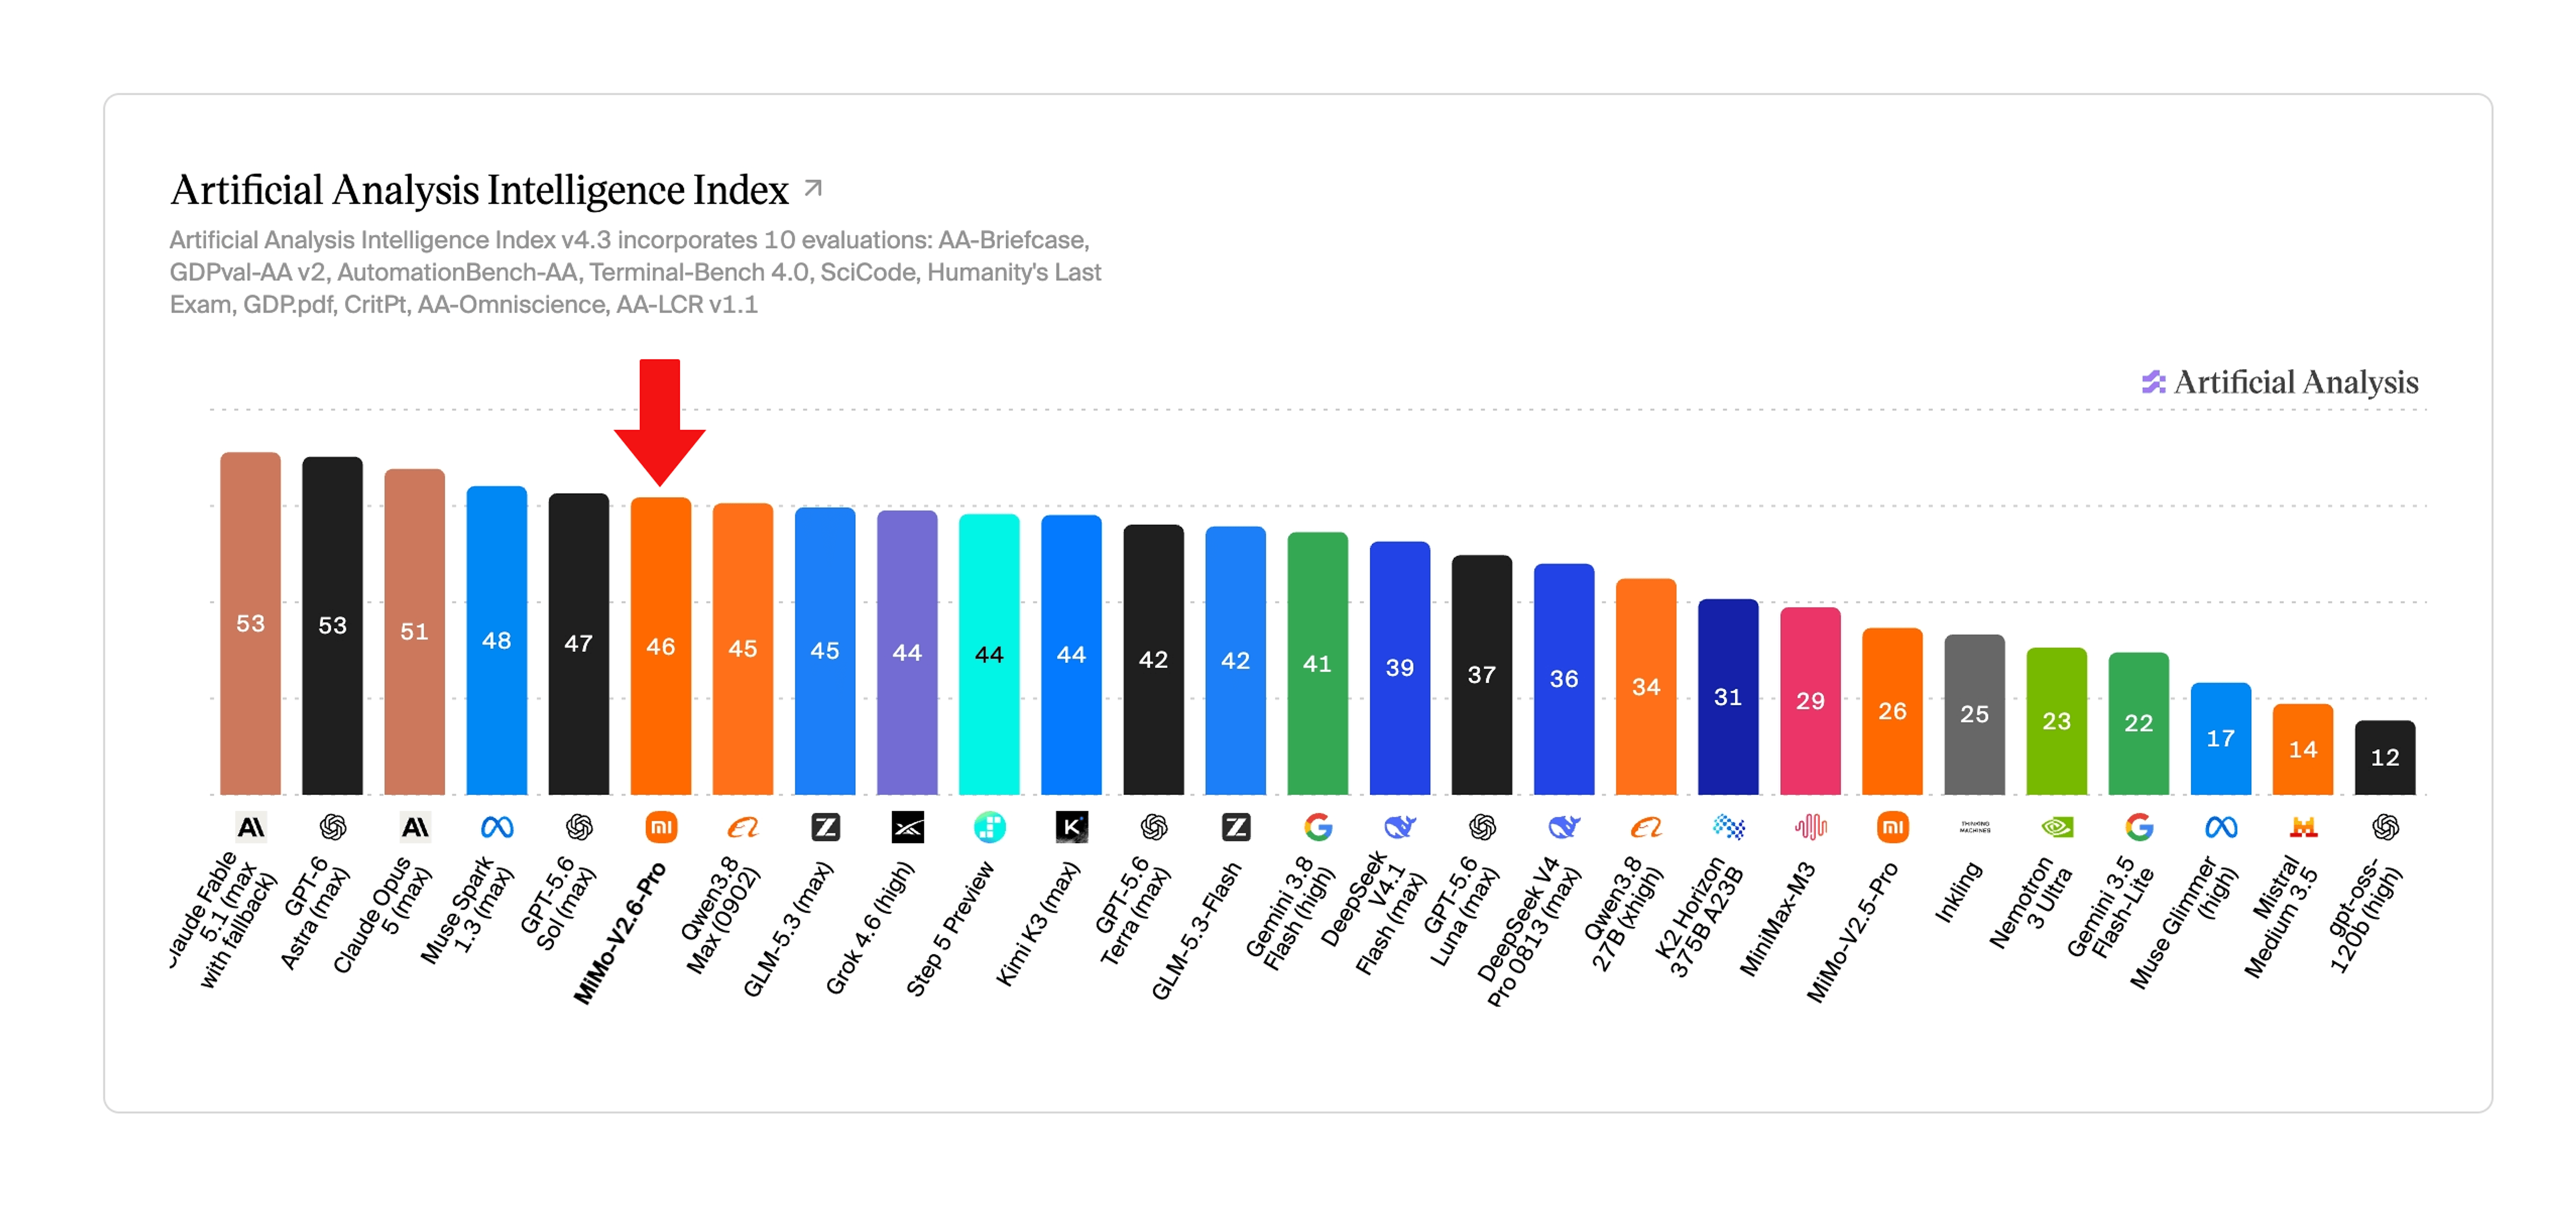
| Dimensjon | MiMo-V2.6-Pro | Lukkede frontmodeller | Andre åpne vektmodeller |
|---|---|---|---|
| Vekter | Åpne vekter | Vanligvis lukkede | Modellavhengig |
| Verifisert MiMo-kontekst | 1M tokens | Sjekk hver offisielle modelside | Sjekk hvert offisielle modelkort |
| Verifiserte MiMo-modaliteter | Tekst, bilde, video, lyd | Leverandøravhengig | Modellavhengig |
| Agentfokusert RL | Sterk lanseringsvekt | Modell- og systemavhengig | Modell- og sjekkpunktavhengig |
| Selvhosting | Ja, med betydelig infrastruktur | Generelt nei | Ofte mulig for åpne sjekkpunkter |
| Primær MiMo-fordel | Åpne vekter, naturlig multimodalitet, lav API-kost | Leverandørøkosystem og administrert verktøy | Varierer etter lisens, størrelse og driftsstakk |
For et aktuelt sammenligningssett, evaluer MiMo-V2.6 mot Claude Opus 5.5 for langvarig agentisk koding, Claude Fable 5.1 for det vanskeligste autonome arbeidet, GPT-6 Sol og Gemini 4 Pro. Modellers tilgjengelighet og priser er dynamiske, så produksjonssammenligninger bør bruke den levende katalogen og matchede prompt, verktøy, innsatsbudsjetter og akseptkriterier.
Hva kan Xiaomi MiMo-V2.6 faktisk gjøre?
Koding og programvare-ingeniøragenter
MiMo-V2.6 er designet for lange programvare-ingeniørtrajektorier: inspisere repositorier, endre kode, bruke terminalverktøy, kjøre tester, diagnostisere feil og fortsette til et mål er oppfylt. Dens DeepSWE-, Terminal Bench-, AutomationBench- og Toolathlon-resultater indikerer at Xiaomi optimaliserer for utførelse snarere enn bare kodekomplettering. Praktiske arbeidslaster inkluderer kodeagenter, automatisert debugging, refaktorering av repositorier, løsning av CI-problemer og multiverktøy-ingeniørarbeidsflyter.
Databruk
Xiaomi demonstrerer eksplisitt en Computer Use Agent (CUA). Modellen kan tolke grafiske grensesnitt, hente informasjon, redigere innhold, prosessere data, inspisere resultater, diagnostisere problemer og endre påfølgende handlinger basert på visuell tilbakemelding. I denne arbeidsflyten er modellutdata ofte ikke det endelige produktet; den kan i stedet bestemme neste programvare- eller nettleserhandling.
3D-verdener og Blender-arbeidsflyter
Under "Vibe World"-konseptet kan MiMo-V2.6 ta tekst-, bilde- eller videoreferanser og bryte ned en 3D-forespørsel i scenekonstruksjon, interaksjonsprogrammering og visuell verifikasjon. Xiaomi demonstrerer også at modellen kontrollerer Blender for å lage 3D-objekter og scener fra beskrivelser eller referansebilder. Dette utvider vibe-koding utover applikasjonskode til interaktive miljøer.
Robotikk og embodiere agenter
Xiaomi demonstrerer MiMo-V2.6 i et legemliggjort simuleringsmiljø med multivisningskameraer og en Franka Panda-robotarm. Eksempeloppgaver inkluderer å gripe objekter, fargematching og presis plassering. Dette etablerer ikke V2.6 som en universell robotikkgrunnlagsmodell, men det viser hvordan naturlig visjon og langhorisont-beslutningstaking kan kobles til legemliggjorte kontrollsløyfer.
Vitenskapelig forskning og formell resonnering
Xiaomi rapporterer et materialvitenskapstilfelle der MiMo-V2.6-Pro hjalp forskere med metall-organiske rammeverk for PFAS-adsorpsjon, inkludert litteratur- og patentsøk, kandidatformulering og beregningsverktøy-kall. I et annet eksperiment hjalp modellen til med å formalisere hovedteoremet fra "Period Three Implies Chaos" i Lean 4. Xiaomi rapporterer et fullført prosjekt som overstiger 6 000 linjer Lean-kode, verifisert av Lean-kjernen uten ubeviste plassholdere. Disse eksemplene tolkes best som demonstrasjoner av agentiske forskningsarbeidsflyter, ikke som bevis på autonom vitenskapelig oppdagelse.
Nettsteder, presentasjoner, video og musikk
MiMo-V2.6 kan koordinere front-end-koding, designarbeidsflyter, lysbilder, SVG-aktiva, videopipelines og musikkproduksjonsverktøy. Xiaomi demonstrerer orkestrering med spesialiserte mediasystemer, inkludert fortelling via MiMo-V2.5-TTS, snarere enn å hevde at V2.6 i seg selv erstatter hver bilde-, video- eller lydgenerator. Modellen passer derfor naturlig som en kreativ produksjonsorkestrator.
Bruksområdene i denne seksjonen er Xiaomi-demonstrasjoner, ikke uavhengige bevis på at hver utrulling vil reprodusere de samme resultatene. Produksjonsteam bør teste modellen med egne verktøy, tillatelser, feilgjenoppretting og evalueringskriterier.
Hvor mye koster Xiaomi MiMo-V2.6?
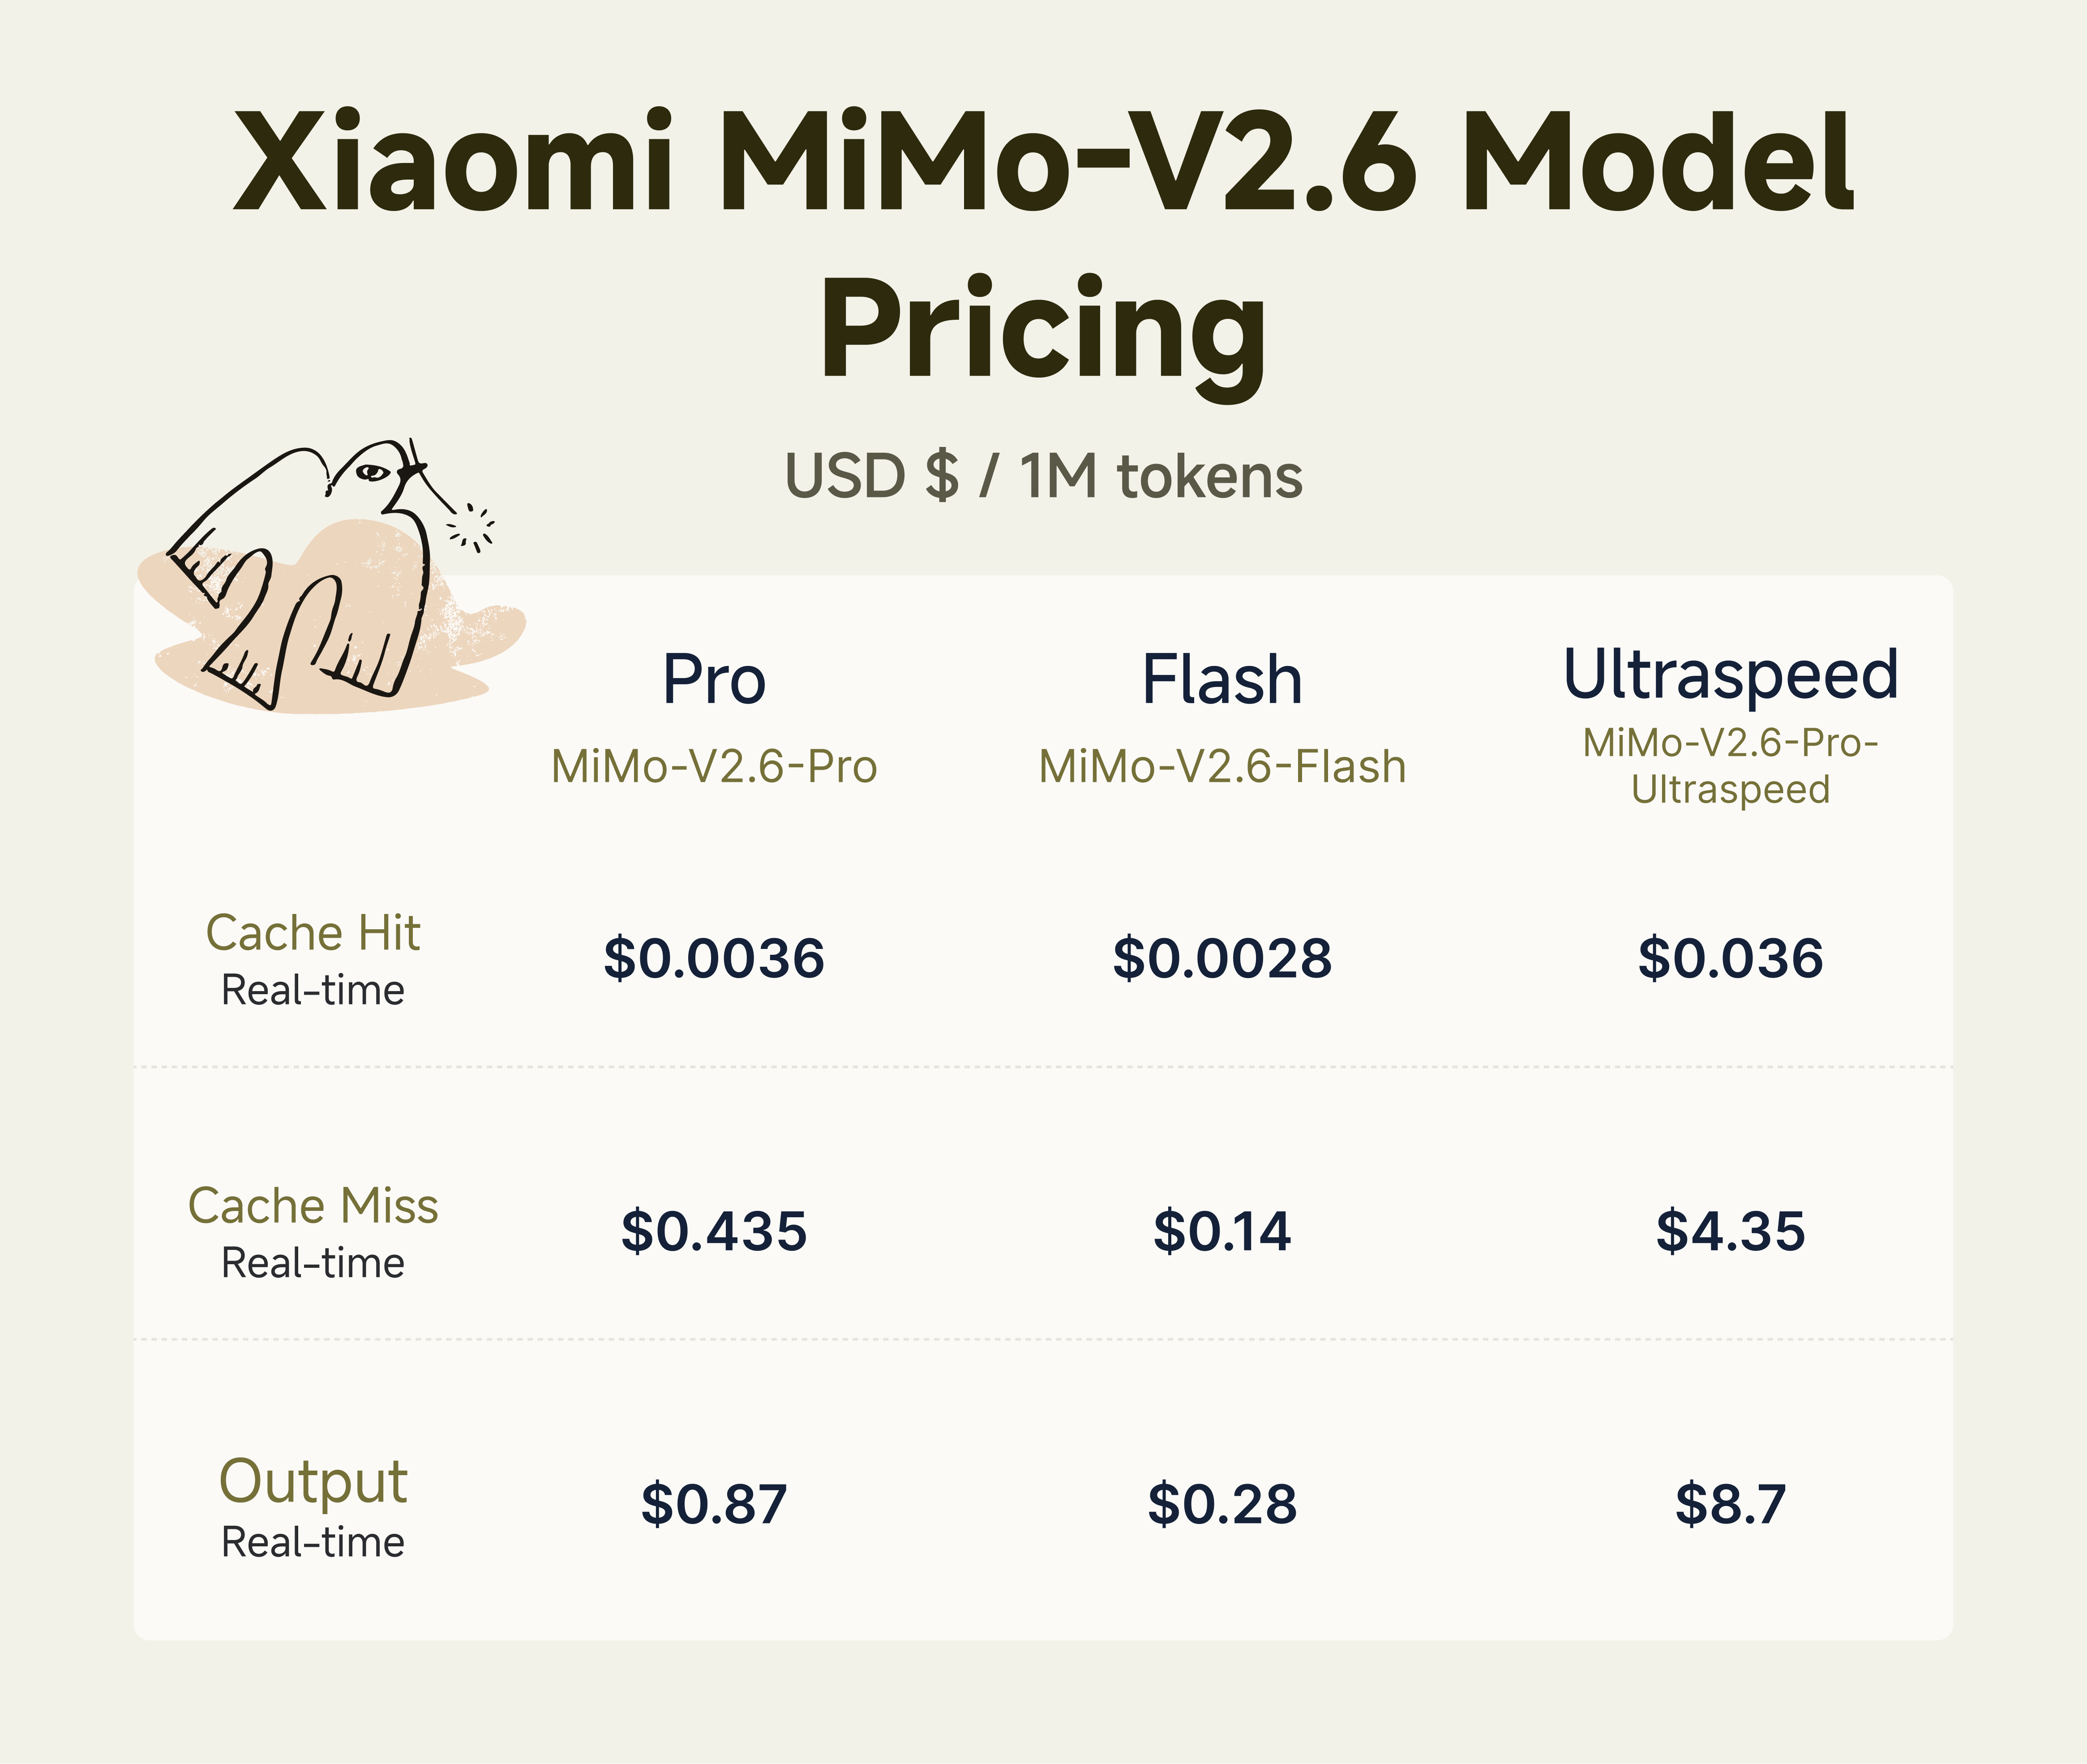
| Priser | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Pro UltraSpeed |
|---|---|---|---|
| Bufret inndata / 1M tokens | $0.0036 | $0.0028 | $0.036 |
| Ubufret inndata / 1M tokens | $0.435 | $0.14 | $4.35 |
| Utdata / 1M tokens | $0.87 | $0.28 | $8.70 |
Xiaomi holder V2.6 API-prising på samme brede nivå som V2.5-generasjonen. Flash er spesielt bemerkelsesverdig for høyvolumsarbeidslaster: den offisielle Xiaomi-prislisten viser $0,14 per million ubufrede inndata-tokens og $0,28 per million utdata-tokens.
CometAPI-priser og tilgjengelighet
| CometAPI-rute | Inndata / 1M | Utdata / 1M | Katalogstatus |
|---|---|---|---|
| mimo-v2.6-pro-ultraspeed | $3.48 | $6.96 | Tilgjengelig; 20% under de oppførte offisielle ubufrede satser |
| mimo-v2.6-pro | $0.348 | $0.6960 | Tilgjengelig; 20% under de oppførte offisielle ubufrede satser |
| mimo-v2.6-flash | $0.112 | $0.2240 | Tilgjengelig; 20% under de oppførte offisielle ubufrede satser |
Hvordan kan utviklere få tilgang til Xiaomi MiMo-V2.6?
Xiaomi eksponerer modellene via et OpenAI-kompatibelt API og dokumenterer kompatibilitet med Anthropic-protokollen på sine offisielle modelsider. De offisielle identifikatorene er mimo-v2.6-pro, mimo-v2.6-flash og mimo-v2.6-pro-ultraspeed. Xiaomi dokumenterer verktøykalling, strukturert utdata, streaming, resonneringskontroller, kontekstkaching og nettsøk. Det OpenAI-kompatible grensesnittet bruker thinking.type-verdier som enabled eller disabled, med deep thinking aktivert som standard for V2.6-modeller.
Utviklere har tre praktiske tilgangsveier. For det første, last ned Pro- eller Flash-åpen-vekt-sjekkpunktet for en selvhostet integrasjon, underlagt betydelige serving-krav. For det andre, bruk Xiaomis administrerte API med en Xiaomi-nøkkel og det dokumenterte endepunktet. For det tredje, bruk en støttet CometAPI-rute med en CometAPI-nøkkel og base-URL; dette kan forenkle multi-modell-evaluering og fakturering. Kodeassistenter som Claude Code kan bruke en Anthropic-kompatibel rute når den ruten og modellen støttes, men kompatibilitet må testes snarere enn antas.
Tilgang til MiMo-V2.6 via CometAPI
CometAPI tilbyr et samlet endepunkt og fakturalag for støttede modeller. Den viktigste operative fordelen er migreringsenkelhet: team kan beholde et kjent SDK, endre base-URL og modell-ID, sammenligne MiMo med andre frontmodeller i samme konto og sentralisere bruk, priser og tilgjengelighetssjekker. Dette er nyttig for multi-modell-ruting, fallback-strategier, konsoliderte fakturaer og evalueringer som trenger identiske prompt på tvers av leverandører.
CometAPI dokumenterer tre tekstforespørselsformater på plattformnivå: OpenAI Chat Completions, Anthropic Messages og OpenAI Responses. For et kompatibelt SDK betyr migrering vanligvis å endre base-URL, API-nøkkel og modell-ID i stedet for å skrive om hele applikasjonen. Endepunkt- og parameterstøtte kan variere etter modell, så test den eksakte MiMo-V2.6-varianten og forespørselsformatet før du hevder at alle tre rutene fungerer for den.
Per 23. september 2026 har MiMo-V2.6-Pro-UltraSpeed en tilgjengelig katalogrute med oppførte inndata- og utdata-priser. De dedikerte Pro- og Flash-sidene viser Coming soon i katalogsnapshots selv om deres API-helsepaneler sier Available. Behandle dette som et inkonsistent sidesignal, ikke bekreftet produksjonstilgjengelighet eller prising. Sjekk den live katalogen, dashbordet og en testforespørsel før utrulling.
Følgende eksempel følger CometAPIs publiserte Anthropic-SDK-mønster og kaller den nåværende oppførte UltraSpeed-ruten. Lagre API-nøkkelen i en miljøvariabel.
import Anthropic from '@anthropic-ai/sdk';

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: 'https://api.cometapi.com',
});

const message = await client.messages.create({
  model: 'mimo-v2.6-pro-ultraspeed',
  max_tokens: 4096,
  messages: [{ role: 'user', content: 'Analyze this project and propose the next implementation steps.' }],
});
Er Xiaomi MiMo-V2.6 åpen kildekode?
Xiaomi har offentliggjort modellvekter, teknisk materiale, RL-ressurser, treningsmiljøer og relatert infrastruktur. Utgivelsen inkluderer mer enn 7 000 RL-oppgavemiljøer som spenner over programvare-ingeniørfag, sårbarhetsreproduksjon, kunnskapsintensivt arbeid og webdesign/-utvikling. Xiaomi ga også ut MiMo-V2.6-Distill-Qwen-9B slik at forskere kan studere RL-pipelinen i mye mindre skala.
Offisielle modelkort: MiMo-V2.6-Pro-RL | MiMo-V2.6-Flash-RL
Hva er begrensningene til Xiaomi MiMo-V2.6?
Den billion-parameter store overskriften bør ikke behandles som bevis på at V2.6 er universelt sterkere enn lukkede frontsystemer. Xiaomis egen benchmarktabell viser et blandet bilde: Claude Opus 5 ligger fortsatt foran på noen kode-, verktøybruk- og OS-benchmarker, mens GPT-5.6 Sol også leder på utvalgte tester. Oppgavespesifikk evaluering er derfor mer meningsfull enn en generell vinneretikett.
Selvhosting av det fulle Pro-sjekkpunktet er også en infrastruktur-tung oppgave. Åpne vekter betyr ikke enkel arbeidsstasjonsutrulling. I tillegg avhenger flere overskriftsdemonstrasjoner—forskning, legemliggjort kontroll, 3D-verdener og videoproduksjon—av eksterne verktøy og agent-harness. MiMo-V2.6 bør evalueres som en modell i et system, ikke bare som en frittstående chatmodell.
Hvorfor er Xiaomi MiMo-V2.6 viktig?
MiMo-V2.6 kombinerer tre viktige retninger: svært store sparse MoE-modeller, naturlig multimodalitet og forsterkningslæring over reelle agentmiljøer. 1,02T-parameterfiguren tiltrekker oppmerksomhet, men det mer konsekvensielle designvalget er Xiaomis investering i gjentatt miljøinteraksjon, trajektorivurdering, verktøykall og selvkorreksjon.
Hvis denne tilnærmingen fortsetter å skalere, kan åpne modeller i økende grad differensieres ikke bare etter hvor mye statisk kunnskap de inneholder, men etter hvor effektivt de handler, evaluerer, gjenoppretter og fullfører lange oppgaver. MiMo-V2.6 forstås derfor best som en åpen, agent-orientert grunnlagsmodell snarere enn bare enda en billion-parameter chatbot.
Konklusjon
MiMo-V2.6 er en betydelig åpen-vekt-utgivelse fordi den kombinerer naturlig tekst-, bilde-, video- og lydinput med lang kontekst, sparse MoE-inferens og forsterkningslæring over reelle agentmiljøer. Pro passer bedre for vanskelige langhorisont-oppgaver, Flash retter seg mot høyvolums- og kostnadssensitive arbeidslaster, og UltraSpeed bytter til en betydelig høyere API-pris for lavere latens.
Modellfamilien er konkurransedyktig på flere leverandørrapporterte agent-benchmarker, men den leder ikke hver evaluering og bør ikke behandles som en universell erstatning for lukkede frontmodeller. Den mest pålitelige adopsjonsveien er å teste MiMo-V2.6 mot de eksakte verktøyene, latensmålene, feilmodusene og kostnadsprofilen til den tiltenkte produksjonsarbeidsflyten.
FAQ
Hva bør team teste før de flytter MiMo-V2.6 i produksjon?
Test hele systemet i stedet for bare modellen. Mål oppgavefullføring, verktøykall-presisjon, gjenoppretting fra mislykkede handlinger, latens, tokenforbruk, kontekststyring og tillatelsesgrenser. Agent-benchmarker gir orientering, men interne evalueringer bør speile det faktiske repositoriet, nettleseren, dokumentet eller forskningsarbeidsflyten.
Hvorfor kan selvhosting av MiMo-V2.6-Pro være vanskelig til tross for den sparsomme arkitekturen?
Sparsom aktivering reduserer per-token-beregning relativt til en tett billion-parameter-modell, men det fulle sjekkpunktet har fortsatt et svært stort minne- og distribuert serving-avtrykk. Produksjonsutrulling kan kreve multi-node inferens, ekspertparallellisme, spesialiserte kjerner og nøye kapasitetsplanlegging.
Hvordan bør utviklere tolke Xiaomis tverrmodell-benchmarktabell?
Behandle den som leverandørrapportert evidens, ikke en uavhengig reprodusert universell rangering. Resultater kan endres med agent-harness, inferensbudsjett, verktøy, miljøbilde, utvalgsmetode og benchmarkversjon. Sammenlign trender på tvers av flere oppgaver og reproduser de mest relevante arbeidslastene internt.
Når er MiMo-V2.6-Flash et bedre valg enn Pro?
Flash er det sterkere standardvalget når kallevolum og kostnad dominerer, spesielt for dokumentprosessering, multimodalanalyse og gjentatte agentsteg. Pro er mer hensiktsmessig når vanskelig resonnering eller langhorisont-utførelse gir nok forretningsverdi til å rettferdiggjøre den høyere prisen.
Eliminerer et 1M-token kontekstvindu behovet for gjenfinning eller prompt-styring?
Nei. Et større vindu øker kapasiteten, men å sende unødvendig historikk kan øke latens og kostnad og kan fortynne relevant evidens. Gjenfinning, oppsummering, strukturert minne og kontekstbeskjæring forblir viktige for pålitelige produksjonsagenter.