Specyfikacja techniczna MiniMax M3.1-Flash
| Pozycja | MiniMax M3.1-Flash |
|---|---|
| ID modelu | MiniMax-M3.1-Flash |
| Rodzina modelu | Seria MiniMax M3.1, model do kodowania |
| Status wydania | 27 września 2026 |
| Główne przeznaczenie | Codzienny rozwój oprogramowania — od poprawek błędów po pełną realizację funkcji |
| Okno kontekstu | 1 000 000 tokenów |
| Modalności wejściowe | Tekst, obraz i wideo |
| Modalność wyjściowa | Tekst |
| Sterowanie rozumowaniem | reasoning_effort: low, medium, high, xhigh, max |
| Sposób rozumowania | Wymagane jest adaptacyjne myślenie; przeglądnięta publiczna dokumentacja nie wspiera wyłączenia myślenia |
| Maksymalna długość wyjścia | Nie opublikowano osobno w przeglądniętych materiałach publicznych |
| Liczba parametrów | Nie ujawniono publicznie |
| Otwarte wagi | Nie zidentyfikowano publicznego checkpointu/repozytorium modelu |
MiniMax ogłosił M3.1-Flash dla MiniMax Code 27 września 2026 r., pozycjonując go pod kątem codziennych zadań rozwojowych, takich jak naprawa błędów i dostarczanie pełnych funkcjonalności. Obecne publiczne materiały zgodnie wskazują okno kontekstu 1M tokenów oraz regulowany nakład rozumowania, przy jednoczesnym zaznaczeniu, że nie opublikowano oddzielnej tabeli benchmarków ani ceny za token.
Czym jest MiniMax M3.1-Flash?
MiniMax M3.1-Flash to tekstowy model ukierunkowany na kodowanie, zaprojektowany do iteracyjnych przepływów pracy w rozwoju oprogramowania, a nie wyłącznie do generowania kodu. MiniMax opisuje workflow jako obejmujący zrozumienie wymagań, lokalizację problemu, implementację, testy regresyjne oraz weryfikację zmian względem istniejącej funkcjonalności.
Jego wyróżniającymi, udokumentowanymi mechanizmami sterującymi są długie okno kontekstu oraz pięciopoziomowa drabinka nakładu rozumowania. Dostępne poziomy to low, medium, high, xhigh i max, co pozwala deweloperom równoważyć głębokość rozumowania i opóźnienie w zależności od złożoności zadania.
Najważniejsze cechy MiniMax M3.1-Flash
- 1M-tokenowe okno kontekstu: Opis modelu podaje milion-tokenowe okno kontekstu, co czyni go odpowiednim dla dużych repozytoriów, długich specyfikacji i wydłużonych sesji agentów kodujących.
- Natywne wejście multimodalne: Publiczne opisy modelu wymieniają tekst, obraz i wideo jako wejścia, przy czym model zwraca tekst.
- Pięć poziomów nakładu rozumowania:
low,medium,high,xhighimaxdają bardziej precyzyjną kontrolę nad głębokością rozumowania niż proste przełączanie myślenia. - Kompleksowy (end-to-end) workflow programistyczny: MiniMax pozycjonuje model do lokalizacji błędów, implementacji, obsługi przypadków brzegowych, uzupełniania testów regresyjnych i walidacji zmian.
- Ukierunkowane wdrożenie: Wstępne publiczne udostępnienie odbywa się poprzez MiniMax Code i Token Plan, a nie w pełni udokumentowaną, samodzielną ofertę w modelu pay-as-you-go.
- Dopasowanie do agentów programistycznych: Model jest przeznaczony do powtarzalnych interakcji rozwojowych, w których kontekst repozytorium, dane z narzędzi, testy i iteracyjne poprawki mają większe znaczenie niż jednorazowe generowanie kodu.
MiniMax M3.1-Flash vs inne modele programistyczne MiniMax
| Model | Przeznaczenie | Kontekst | Publiczne dane benchmarkowe | Dostęp/status |
|---|---|---|---|---|
| M3.1-Flash | Codzienne programowanie, iteracyjny rozwój | 1M | Jeszcze nie opublikowano | MiniMax Code / Token Plan |
| M3 | Zaawansowane programowanie + praca agentowa, natywna multimodalność | Do 1M | Opublikowane przez MiniMax | API, Token Plan, MiniMax Code |
| M2.7 | Inżynieria oprogramowania + szerokie zadania agentowe/produktywnościowe | Nie używany tutaj jako skopiowana specyfikacja M3.1 | Opublikowane przez MiniMax | API, Token Plan, Agent |
M3 to bardziej szczegółowo udokumentowany punkt odniesienia: MiniMax publikuje jego architekturę, metodologię ewaluacji kodowania/agentów oraz dostępność API. M2.7 również ma publiczny rekord benchmarków i integrację z API. M3.1-Flash jest nowszy i obecnie ma węższy zakres publicznej dokumentacji, więc porównania powinny koncentrować się na udokumentowanym pozycjonowaniu zamiast wskazywania zwycięzcy benchmarków. 4
Reprezentatywne przypadki użycia
- Naprawa błędów w skali repozytorium: Przekaż modelowi dużą bazę kodu, opis problemu, logi i testy oraz wykorzystaj długie okno kontekstu do zachowania istotnego kontekstu projektu.
- Implementacja funkcjonalności: Użyj modelu, aby przejść od wymagania w języku naturalnym przez zmiany w kodzie i testy regresyjne.
- Przegląd kodu i naprawy: Poproś o identyfikację przypadków brzegowych, zaproponowanie poprawek i weryfikację, że zmiany nie psują istniejącego zachowania.
- Debugowanie multimodalne: Dostarczaj zrzuty ekranu, diagramy lub wideo obok wymagań tekstowych, gdy kontekst wizualny jest częścią problemu inżynieryjnego.
- Długotrwałe sesje agentów programistycznych: Wykorzystaj duże okno kontekstu dla specyfikacji, plików repozytorium, wyników terminala i iteracyjnych rezultatów testów.
- Zadania rozwojowe wymagające szybkości: Wybierz niższy poziom nakładu rozumowania dla rutynowych edycji i zwiększ nakład dla bardziej złożonych, wieloetapowych zmian.
Jak uzyskać dostęp do API MiniMax M3.1-Flash
Krok 1: Zarejestruj się po klucz API
Zaloguj się na cometapi.com. Jeśli nie jesteś jeszcze naszym użytkownikiem, zarejestruj się najpierw. Zaloguj się do swojej konsoli CometAPI. Uzyskaj poświadczenie dostępu — klucz API interfejsu. Kliknij „Add Token” w sekcji tokenu API w centrum osobistym, pobierz klucz tokenu: sk-xxxxx i zatwierdź.
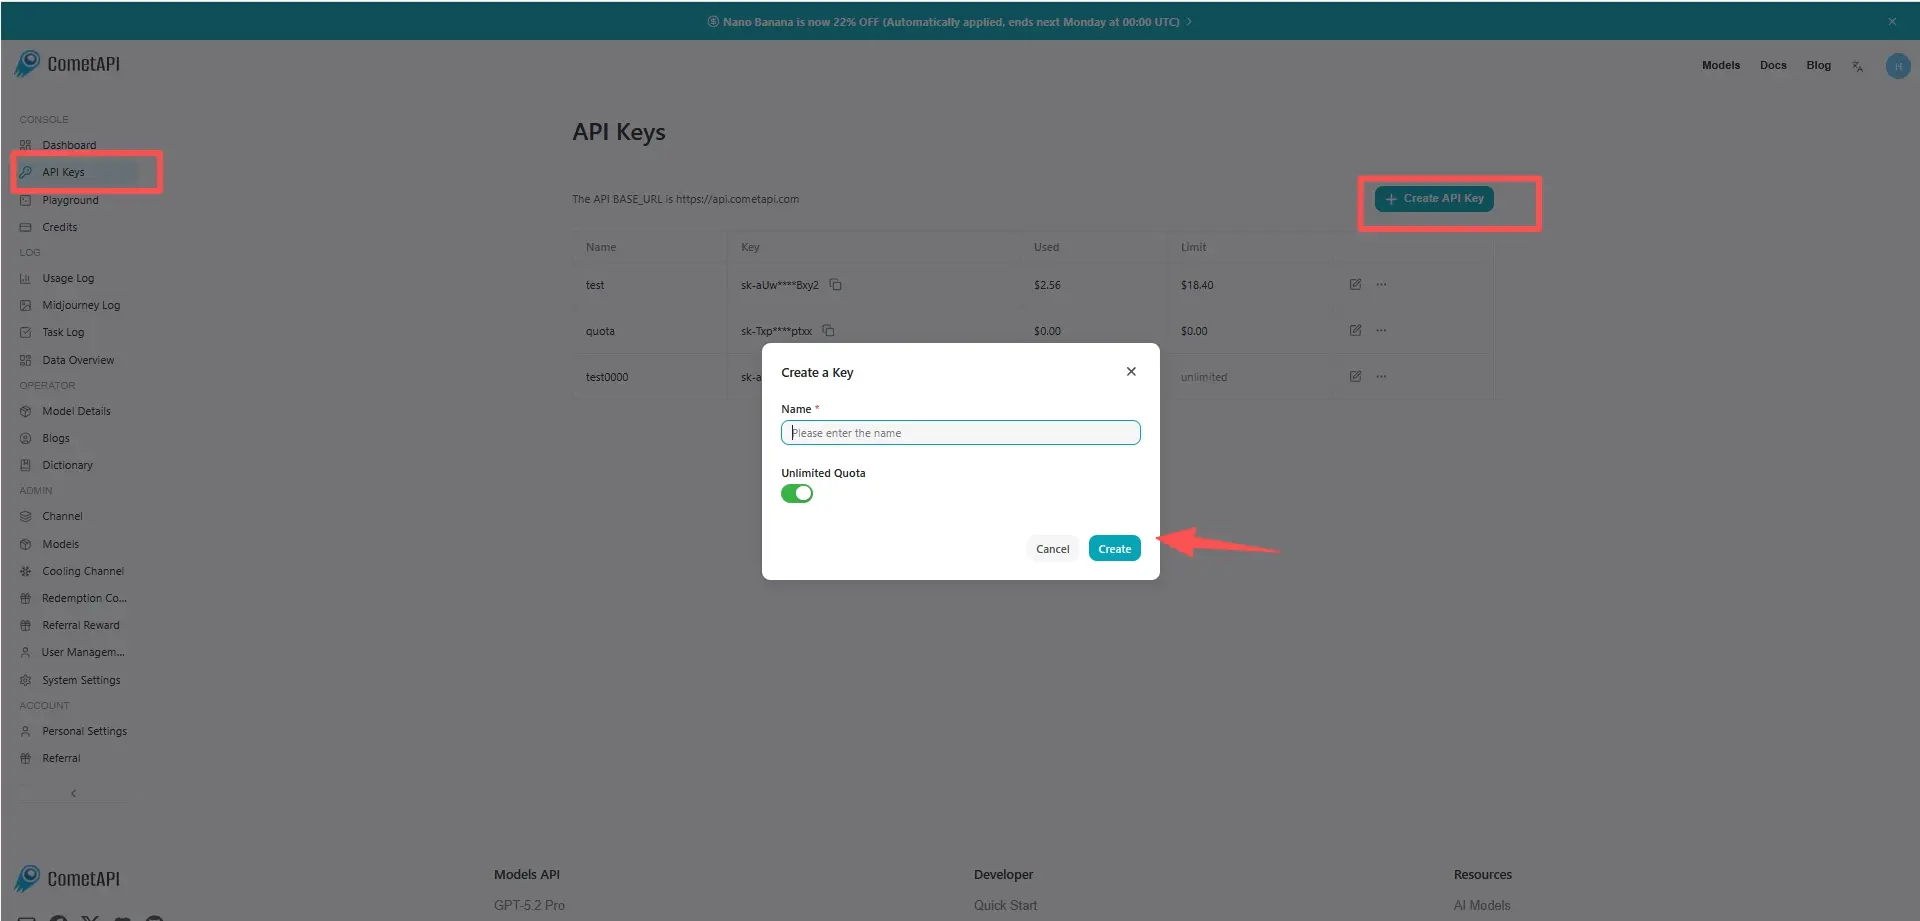
Krok 2: Wysyłanie żądań do API MiniMax M3.1-Flash
Wybierz endpoint „minimax-m3.1-flash”, aby wysłać żądanie do API i ustaw body żądania. Metoda żądania i body żądania są dostępne w naszej dokumentacji API na stronie. Nasza strona udostępnia również test w Apifox dla wygody. Zamień <YOUR_API_KEY> na swój rzeczywisty klucz CometAPI z konta. Bazowy URL to Chat Completions.
Wstaw swoje pytanie lub prośbę w pole content — na to model odpowie. Przetwórz odpowiedź API, aby uzyskać wygenerowaną odpowiedź.
Krok 3: Pobieranie i weryfikacja wyników
Przetwórz odpowiedź API, aby uzyskać wygenerowaną odpowiedź. Po przetworzeniu API zwraca status zadania oraz dane wyjściowe.