Choose your path
Blog Claude

Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Który model AI wybrać?
Porównaj Muse Wonder, Claude Opus 5.5 i GPT-6 Sol pod kątem benchmarków, kodowania, agentów AI, okien kontekstu, cen API i przypadków użycia.
Claude Sonnet 5.5 cena: cennik API, koszty tokenów i koszt za zadanie
Claude Sonnet 5.5 kosztuje oficjalnie 2 USD/M wejścia i 10 USD/M wyjścia. Porównaj ceny CometAPI, buforowanie promptów, zniżki Batch, benchmarki oraz rzeczywisty koszt na zadanie.
Jak korzystać z interfejsu API Claude Sonnet 5.5
Dowiedz się, jak korzystać z Claude Sonnet 5.5 API z CometAPI przy użyciu cURL, Pythona i JavaScriptu. Poznaj Messages API, dostęp kompatybilny z OpenAI, streaming oraz vision.
Claude Opus 5.5 vs Sonnet 5.5: Który wybrać?
Porównaj Claude Opus 5.5 z Sonnet 5.5 pod kątem benchmarków, kodowania, agentów, kontekstu, szybkości, cen API oraz kosztów, aby wybrać odpowiedni model Claude 5.5.
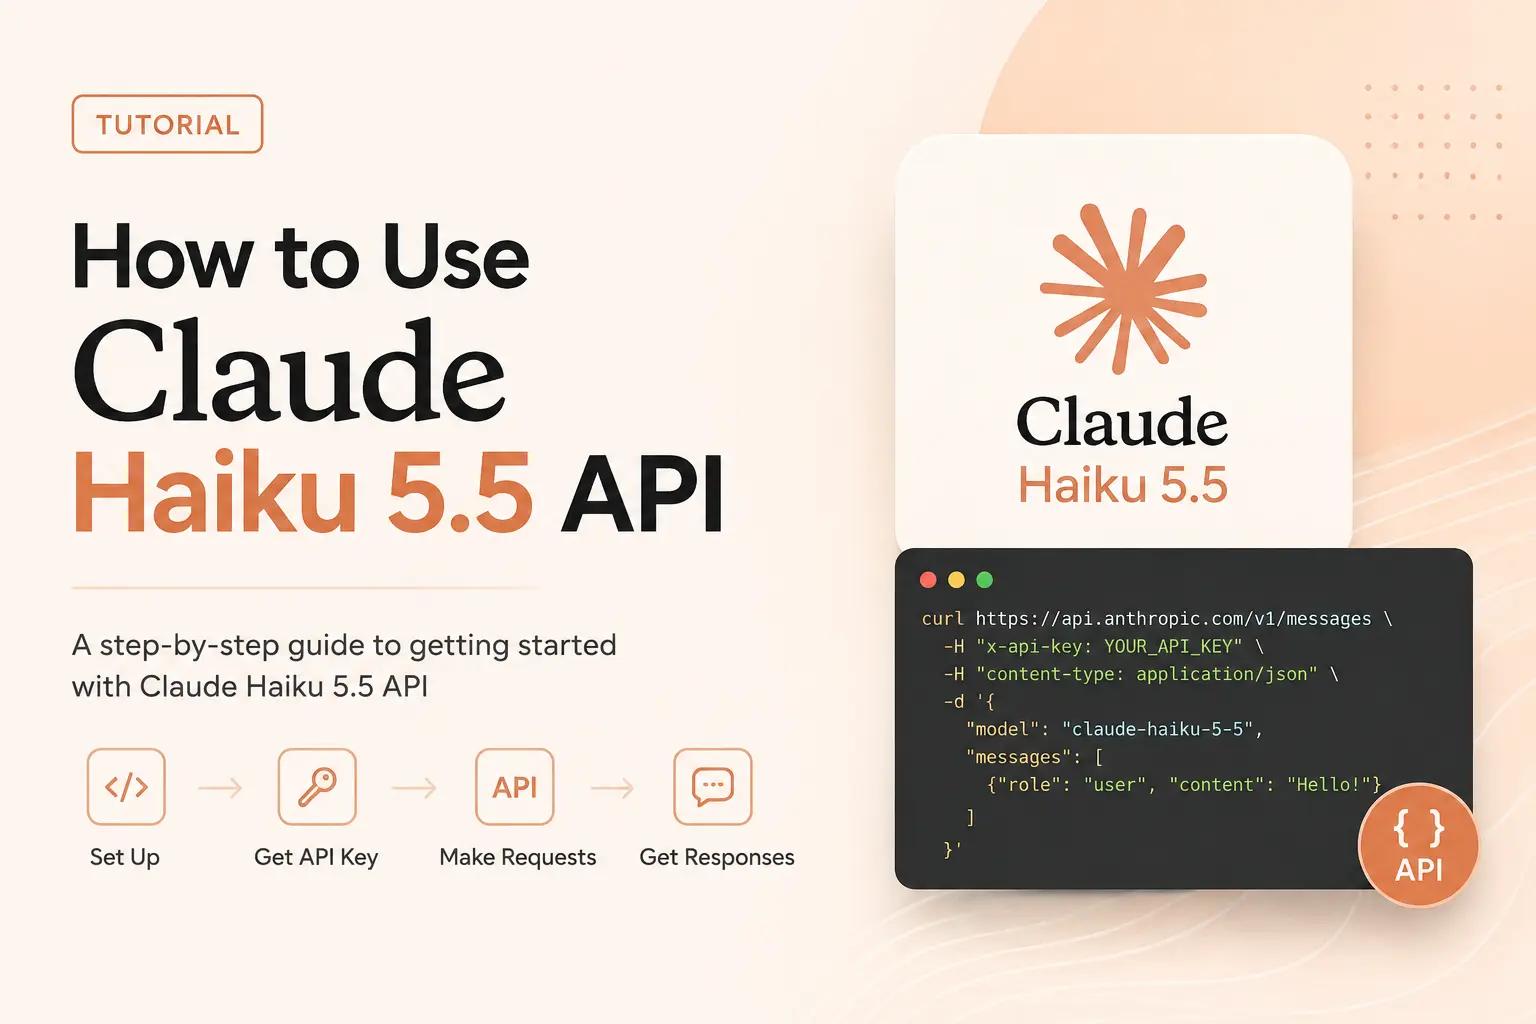
Jak korzystać z API Claude Haiku 5.5: kompletny przewodnik dla programistów
Dowiedz się, jak korzystać z API Claude Haiku 5.5 za pomocą CometAPI. Poznaj konfigurację, przykłady kodu, strumieniowanie, ustawienia effort, ceny i migrację.
GPT-6.1 Sol vs Claude Sonnet 5.5: Którego modelu AI użyć?
Nie posiadam zweryfikowanych informacji o modelach “GPT-6.1 Sol” ani “Claude Sonnet 5.5” w publicznych źródłach do 2024-10, dlatego nie mogę rzetelnie zestawić liczb. Jeśli podasz specyfikacje lub linki, przygotuję szczegółowe porównanie. Poniżej lista kontrolna i schemat porównania dla wskazanych obszarów: - Benchmarks - Dobierz wspólny zestaw: MMLU, GPQA, GSM8K/MATH, HumanEval/MBPP, Big-Bench, Typos/Long-form, Retrieval, multimodal (jeśli dotyczy). - Metodologia: jednakowe prompty i n-shot, ten sam temperature/top-p/seed, wyłącz/ujednolić tool-use/RAG, normalizacja długości odpowiedzi. - Raportuj: wynik ± przedział ufności, pass@1/pass@k, koszt na poprawne zadanie, p95/p99 latencję, stabilność między seedami. - Dla long-context: testy retrieval/needle-in-a-haystack, faithful recall przy różnych odległościach, degradacja przy wzroście kontekstu. - Equal base cache-read rates - Upewnij się, że oba systemy mają porównywalny mechanizm cache: stawki dla prefill/decode oraz “cache-read”. - Normalizacja: - Ten sam udział ponownie używanych tokenów (reuse ratio) i identyczne szablony promptów. - Licz koszt efektywny: koszt = prefill_tokens*prefill_rate + cache_read_tokens*cache_read_rate + output_tokens*decode_rate. - Sprawdź zasady: TTL cache, opłaty za pierwszy zapis, minimalne progi reuse, politykę wysunięć. - Raportuj koszt/1k tokenów w trzech scenariuszach: bez cache, 50% reuse, 90% reuse oraz wpływ na latencję. - Context - Parametry: maks. okno kontekstu, ewentualne tryby rozszerzone, limity praktyczne vs. reklamowane. - Jakość w długim kontekście: recall, stabilność odpowiedzi, podatność na recency bias, degradacja przy długich dokumentach. - Funkcje: kontynuacje strumieniowe, JSON mode w długich odpowiedziach, wsparcie dla chunkowania i pamięci sesyjnej. - CometAPI pricing - Zbierz: ceny za 1k tokenów input/output, stawki cache-read, różnice prefill/decode, minimalne jednostki rozliczeń, progi wolumenowe, regiony i ewentualne dopłaty. - Dodatki: limity darmowe, SLA, egress/transfer, zniżki enterprise, rozliczanie za batch/stream. - Porównaj koszt per zadanie (np. “standardowy czat”, “długi dokument”, “kodowanie”) oraz koszt per poprawna odpowiedź na benchmarkach. - API access - Interfejsy: REST/WebSocket, streaming, batching, retry i idempotency keys, logprobs, JSON strict mode. - Funkje: function/tool calling, RAG (native connectors), multimodal (vision/audio), fine-tuning, kontrola deterministyczności. - Ograniczenia i jakość: limity QPS/concurrency, p95/p99 latencja, stabilność, dostępność regionów, on-prem/VPC, polityki retencji danych, zgodności (SOC 2, ISO, HIPAA, data residency). - Ekosystem: SDK (Python/JS/…), obsługa obserwowalności (trace’y), wersjonowanie modeli, kompatybilność z istniejącymi klientami. Dostarcz proszę parametry (stawki cache-read, okna kontekstu, liczby z benchmarków, cennik CometAPI, detale API), a przygotuję bezpośrednie zestawienie i wnioski koszt/jakość.
Czym jest Claude Haiku 5.5? Specyfikacja techniczna, benchmarki, ceny, funkcje i dostęp do API
Poznaj specyfikację Claude Haiku 5.5, okno kontekstu 1M, wyniki benchmarków, cennik API, funkcje oraz porównania z Haiku 4.5 i Sonnet 5.5.
Grok 4.7 vs Claude Fable 5.1: benchmarki, ceny, programowanie, agenci i porównanie API
Porównaj Grok 4.7 i Claude Fable 5.1 pod kątem benchmarków, programowania, agentów AI, okien kontekstu, cen API, narzędzi oraz dostępu do CometAPI.