

TL;DR: Qual provedor é mais barato?
Para solicitações interativas normais do GPT-6 Astra, a API do GPT-6 Astra na CometAPI tem a menor tarifa Standard de contexto curto claramente publicada nesta comparação: $8 por milhão de tokens de entrada e $40 por milhão de tokens de saída. O OpenAI Standard é $10/$50.
Para trabalhos tolerantes a atraso, a economia muda: a OpenAI precifica Batch e Flex em 50% do Standard, o que resulta em $5/M de entrada e $25/M de saída para solicitações Astra de contexto curto. A OpenRouter também expõe uma rota Batch a $5/$25. Essas rotas são mais baratas do que a inferência Standard interativa, mas não são substitutas diretas para aplicações sensíveis à latência.
Para testar antes de pagar, a CometAPI afirma que novas contas recebem créditos de cadastro gratuitos sem necessidade de cartão. A Azure oferece a novos clientes elegíveis $200 em crédito por 30 dias, enquanto a AWS oferece a novos clientes até $200 em créditos no seu programa Free Tier. A elegibilidade de crédito e o acesso ao modelo devem ser verificados na conta antes de presumir que o uso do Astra está coberto.
Nota sobre elegibilidade: créditos promocionais e acesso ao GPT-6 Astra variam por conta, região e programa. Verifique tanto a elegibilidade do crédito quanto o acesso ao modelo antes de estimar um teste gratuito.
Principais pontos
- Tarifa interativa mais barata verificada aqui: CometAPI Standard a $8/M de entrada e $40/M de saída, 20% abaixo do OpenAI Standard.
- Rota mais barata para trabalhos tolerantes a atraso: OpenAI Batch/Flex ou OpenRouter Batch a $5/M de entrada e $25/M de saída.
- A OpenAI não possui camada Free da API para o Astra; a tabela oficial de limite de taxa marca Free como não suportada.
- A CometAPI é o teste com menor fricção nesta comparação porque oferece créditos de cadastro sem exigir cartão; o valor atual do crédito é intencionalmente não fixado.
- O limite de 272K na entrada importa: acima dele, o Astra passa para a precificação de contexto longo para toda a solicitação.
- Não compare apenas os preços por token. Cache, ferramentas, tentativas, latência, crescimento de contexto e sucesso de tarefas aceitas podem dominar o custo total.
O que é o GPT-6 Astra e por que sua API tem preço premium?
O GPT-6 Astra é o modelo principal da OpenAI para trabalhos complexos de ponta a ponta, em vez de chat de baixo custo e alto volume. A OpenAI o posiciona para raciocínio complexo, engenharia de software, pesquisa, uso de computador, fluxos de trabalho profissionais e agentes de longa duração.
A especificação oficial do modelo fornece ao Astra uma janela de contexto de 1,050,000 tokens, uma saída máxima de 128,000 tokens, um corte de conhecimento em 30 de abril de 2026, entrada de texto e imagem e saída de texto. Ele oferece cinco configurações de esforço de raciocínio: low, medium, high, xhigh e max.
| Especificação do GPT-6 Astra | Valor |
|---|---|
| Desenvolvedor | OpenAI |
| ID do modelo | gpt-6-astra |
| Janela de contexto | 1,050,000 tokens |
| Saída máxima | 128,000 tokens |
| Corte de conhecimento | 30 de abril de 2026 |
| Entrada | Texto, imagens |
| Saída | Texto |
| Esforço de raciocínio | Low, Medium, High, XHigh, Max |
| Chamadas de função | Compatível |
| Saídas estruturadas | Compatível |
| Uso de computador | Compatível |
| Pesquisa na Web/arquivos | Compatível |
| Fine-tuning | Não compatível |
| Preço Standard de contexto curto | $10/M entrada; $50/M saída |
| Entrada em cache | $1/M |
| Gravação de cache | $12.50/M |
| Limite para contexto longo | Mais de 272K tokens de entrada |
O limite de contexto também é um limite de preço. Para prompts acima de 272K tokens de entrada, a OpenAI aplica preço 2× para entrada/cache e 1,5× para saída em toda a solicitação. Assim, uma solicitação que cresce apenas um pouco além de 272K pode aumentar significativamente o custo total.
O Astra também introduz capacidades orientadas a agentes, como chamadas assíncronas de ferramentas e direcionamento no meio da interação. Por isso, uma comparação útil de provedores precisa considerar ferramentas, cache, camada de processamento e conclusão de tarefas — não apenas o preço de entrada em destaque.
Quão bom é o GPT-6 Astra? Desempenho oficial em benchmarks
A tabela oficial de benchmarks registra resultados fortes em uso de computador, automação profissional, contexto longo, ciência, programação e cibersegurança. Ela relata 97.6% no FrontierMath Tier 4 (v2), 99.9% no ARC-AGI-3 e 100% no ExploitBench. São resultados de avaliação publicados pelo fornecedor e devem ser interpretados conforme a metodologia declarada.
| Benchmark | GPT-6 Astra | Comparação / significado |
|---|---|---|
| FrontierMath Tier 4 (v2) | 97.6% | Matemática em nível de pesquisa |
| ARC-AGI-3 | 99.9% | Raciocínio/Adaptação inéditos |
| ExploitBench | 100.0% | Capacidade de exploração em segurança cibernética |
| OSWorld 2.0 | 72.6% | Tarefas de uso de computador |
| ScreenSpot-Pro | 92.7% | Compreensão visual da interface |
| AutomationBench | 41.4% | Automação de fluxos de trabalho profissionais |
| BenchCAD | 95.9% | Tarefas de CAD/projeto profissional |
| BrowseComp | 91.5% | Recuperação de informação baseada em navegador |
| MRCR v2, 512K–1M | 96.3% | Recuperação de contexto muito longo |
| Terminal-Bench Science 0.1 | 64.6% | Fluxos de trabalho científicos de agentes |
Para avaliação de custo, os resultados OSWorld 2.0 da OpenAI registram 72.6% em aproximadamente 40 minutos por tarefa para o Astra, contra 65.7% em cerca de 75 minutos para o GPT-5.6 Sol. Isso apoia avaliar o custo por tarefa concluída em vez de tratar o preço por token como o modelo de custo inteiro.
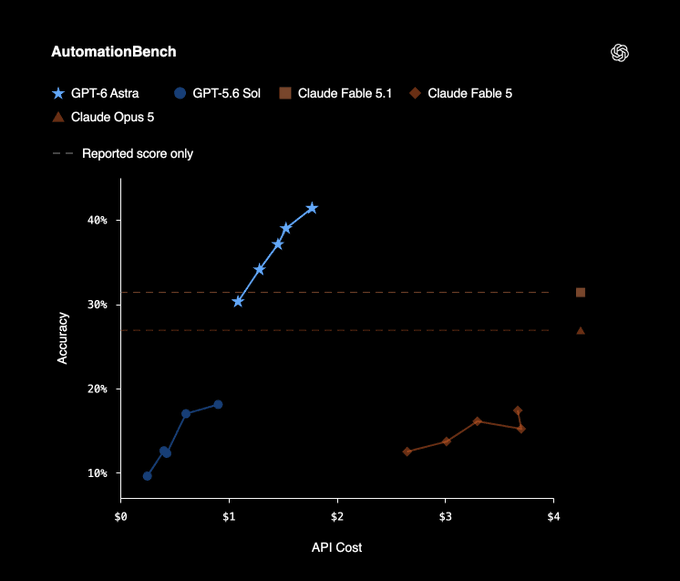
Gráfico oficial do benchmark AutomationBench da OpenAI.
Qual provedor de API do GPT-6 Astra é mais barato em 2026?
A tabela abaixo compara preços por token publicamente verificáveis para o mesmo modelo GPT-6 Astra. Ela exclui cotações de relay incomumente baratas quando a procedência do modelo, limites de contexto, privacidade ou comportamento do serviço não podem ser verificados de forma independente. A precificação ao vivo de modelos da CometAPI mostra $8/M de entrada e $40/M de saída para acesso Standard de contexto curto.
| Provedor / rota | Entrada / 1M | Saída / 1M | Teste / crédito | Melhor ajuste |
|---|---|---|---|---|
| CometAPI Standard | $8 | $40 | Créditos de cadastro | Menor tarifa interativa verificada aqui |
| OpenAI Standard | $10 | $50 | Sem camada Free da API para Astra | Acesso direto de primeira parte |
| OpenAI Batch / Flex | $5 | $25 | Mesma conta da API | Menor tarifa de primeira parte para trabalhos tolerantes a atraso |
| OpenRouter Standard | $10 | $50 | Nenhum teste específico do Astra verificado | Roteamento multi-provedor |
| OpenRouter Batch | $5 | $25 | Nenhum teste específico do Astra verificado | Roteamento assíncrono de baixo custo |
| Azure Global | $10 | $50 | $200 / 30 dias para novos usuários elegíveis | Cargas de trabalho na nuvem Microsoft |
| Azure US Data Zone | $11 | $55 | Crédito Azure sujeito à elegibilidade | Requisitos de zona de dados |
| AWS Global CRIS | $10 | $50 | Até $200 em créditos gerais da AWS | Cargas de trabalho nativas da AWS |
| AWS In-Region | $11 | $55 | Créditos AWS sujeitos à elegibilidade | Implantação regional |
A tabela publicada do Astra na Azure confirma $10/$50 para Standard Global e $11/$55 para US Data Zone. Os detalhes de preços do Microsoft Foundry também mostram as faixas correspondentes de contexto longo. A AWS publica $10/$50 para Global CRIS e $11/$55 para In-Region/Geo CRIS. A precificação do Amazon Bedrock afirma que essas são tarifas do nível Standard.
Portanto, existem duas respostas “mais baratas” diferentes. Para inferência Standard interativa, a CometAPI é a líder de preço neste conjunto verificado. Para cargas de trabalho assíncronas ou flexíveis, Batch/Flex a $5/$25 tem a menor tarifa por token.
Nota sobre preços: tarifas dos provedores e créditos promocionais podem mudar. Verifique a documentação vinculada dos provedores imediatamente antes de publicar ou de fazer orçamento de produção.
Quão mais barata é a API do GPT-6 Astra na CometAPI?
| Categoria de token | OpenAI Standard | CometAPI | Diferença |
|---|---|---|---|
| Entrada | $10.00/M | $8.00/M | 20% menor |
| Entrada em cache | $1.00/M | $0.80/M | 20% menor |
| Gravação de cache | $12.50/M | $10.00/M | 20% menor |
| Saída | $50.00/M | $40.00/M | 20% menor |
| Entrada de contexto longo | $20.00/M | $16.00/M | 20% menor |
| Saída de contexto longo | $75.00/M | $60.00/M | 20% menor |
A implicação prática é simples: se sua aplicação precisa de inferência interativa estilo Standard em vez de Batch/Flex, as tarifas publicadas do Astra na CometAPI reduzem o componente de token em 20% nas categorias correspondentes.
Qual provedor de API do GPT-6 Astra tem o melhor teste gratuito?
“API gratuita do GPT-6 Astra” pode significar uma camada gratuita permanente do modelo ou créditos promocionais temporários. Essas não são a mesma coisa. A tabela oficial de limites de taxa da OpenAI marca a camada Free da API como não suportada.
CometAPI: o caminho de teste mais simples, sem cartão
O guia rápido da CometAPI afirma que novas contas recebem créditos de cadastro e que não é necessário cartão para começar. Como o montante promocional pode mudar, a tela de cadastro ou de preços ao vivo deve ser tratada como a fonte da verdade, em vez de fixar um valor em dólares.
Azure: o teste em nuvem de valor fixo mais claro
Novos clientes elegíveis da Azure podem receber $200 em crédito Azure por 30 dias. Se o GPT-6 Astra estiver habilitado para a conta e região, esse crédito pode tornar a Azure útil para testes de prova de conceito antes da cobrança normal.
AWS: uma janela de créditos geral mais longa
A AWS oferece a novos clientes $100 em créditos no cadastro e oportunidades de ganhar mais $100 — até $200 ao longo de seis meses. Como o plano Free da AWS não expõe todos os serviços e recursos da AWS, verifique a elegibilidade do plano da conta e o acesso aos modelos do Bedrock antes de tratar o crédito como um teste garantido do Astra.
Quando o OpenAI Batch é mais barato para o GPT-6 Astra?
O maior erro de custo é comparar apenas provedores ignorando a camada de processamento. A OpenAI afirma que Batch e Flex custam 50% do Standard, enquanto o modo Fast custa 2× a tarifa aplicável. Para solicitações Astra de contexto curto, a faixa é, portanto, $5/$25 em Batch/Flex, $10/$50 em Standard e $20/$100 em Fast.
| Opção de processamento | Entrada / 1M | Saída / 1M | Em relação ao OpenAI Standard |
|---|---|---|---|
| Batch | $5 | $25 | 50% |
| Flex | $5 | $25 | 50% |
| CometAPI Standard | $8 | $40 | 80% do OpenAI Standard |
| OpenAI Standard | $10 | $50 | 100% |
| OpenAI Fast | $20 | $100 | 200% |
Batch/Flex deve ser avaliado primeiro para análises noturnas, revisão de código offline, enriquecimento de datasets, rodadas de avaliação e pesquisas não urgentes. Para aplicações em que um usuário está esperando ativamente, a comparação Standard continua mais relevante.
Quanto o GPT-6 Astra realmente vai custar?
Considere uma solicitação de agente de contexto curto usando 100,000 tokens de entrada e 10,000 tokens de saída. Ignorando custos de cache e ferramentas, o custo simplificado é tokens de entrada × tarifa de entrada + tokens de saída × tarifa de saída.
| Provedor / rota | Custo por solicitação | Custo para 1,000 solicitações equivalentes |
|---|---|---|
| OpenAI Batch/Flex | $0.75 | $750 |
| CometAPI Standard | $1.20 | $1,200 |
| OpenAI Standard | $1.50 | $1,500 |
| OpenRouter Standard | $1.50 | $1,500 |
| Azure Global | $1.50 | $1,500 |
| AWS Global CRIS | $1.50 | $1,500 |
| AWS In-Region | $1.65 | $1,650 |
A diferença de $0.30 entre CometAPI Standard e OpenAI Standard parece pequena em uma solicitação. Em 10,000 solicitações equivalentes, ela se torna cerca de $3,000 antes dos custos de ferramentas ou tentativas.
Contexto longo muda a matemática novamente. Em 300K de entrada e 20K de saída, o OpenAI Standard fica em cerca de $7.50 na tarifa publicada para contexto longo, enquanto as tarifas correspondentes da CometAPI resultam em cerca de $6.00. É por isso que o limiar de 272K deve ser explicitamente monitorado na telemetria de produção.
Como reduzir os custos da API do GPT-6 Astra sem mudar de provedor?
O cache de prompt é um grande alavancador porque a tarifa Standard do Astra para entrada em cache é um décimo da entrada nova. Instruções de sistema estáveis, definições de ferramentas, material de referência reutilizável e prefixos comuns de prompt são fortes candidatos para um design ciente de cache.
Controle de contexto é a segunda alavanca. Uma janela de 1.05M tokens é um teto de capacidade, não uma meta. Permanecer abaixo do limite de preço de 272K quando histórico extra é desnecessário pode ter um efeito maior do que compressões menores de prompt.
A camada de processamento é a terceira alavanca: Batch/Flex para trabalhos tolerantes a atraso, Standard para produção interativa comum e Fast apenas onde a menor latência tem valor de negócio mensurável. Por fim, meça o custo por tarefa aceita — não apenas o custo por token — porque tentativas, chamadas de ferramentas e correção humana podem reverter uma comparação simples de tabela de preços.
Qual provedor de API do GPT-6 Astra você deve escolher?
| Sua prioridade | Melhor opção inicial | Por quê |
|---|---|---|
| Menor preço por token interativo | CometAPI | $8/$40 na tarifa Standard de contexto curto |
| Menor preço para tarefas tolerantes a atraso | OpenAI Batch/Flex ou OpenRouter Batch | $5/$25 |
| Teste sem cartão | CometAPI | Créditos de cadastro; sem cartão necessário |
| Maior teste em nuvem de valor fixo de curto prazo | Azure | $200 por 30 dias para novos usuários elegíveis |
| Janela mais longa de créditos em nuvem | AWS | Até $200; verifique elegibilidade Astra/Bedrock |
| Acesso nativo de primeira parte à OpenAI | OpenAI | API direta e recursos nativos mais recentes |
| Arquitetura de nuvem Microsoft existente | Azure Foundry | Governança e aquisição Microsoft |
| Arquitetura AWS existente | Amazon Bedrock | Segurança, cobrança e controles regionais da AWS |
| Roteamento entre múltiplos provedores | OpenRouter | Uma camada de roteamento entre provedores |
Para um desenvolvedor independente ou equipe sensível a custos que precisa de inferência interativa do Astra, a CometAPI é o ponto de partida mais forte orientado a preço nesta comparação. Para grandes trabalhos offline, Batch/Flex deve ser avaliado antes de mudar de provedor porque seu desconto de 50% na camada de processamento é maior que a diferença de 20% na tarifa Standard.
Para equipes corporativas, a menor tarifa por token pode não produzir o menor custo total. Azure ou AWS ainda podem ser a melhor escolha econômica quando a equipe já depende de gasto contratado em nuvem, rede privada, aquisição centralizada ou controles de segurança e conformidade integrados. Avalie essas economias operacionais separadamente do preço por token do modelo.
Como chamar a API do GPT-6 Astra via CometAPI?
A CometAPI usa um padrão de integração compatível com OpenAI. Crie uma chave de API da CometAPI, aponte o SDK da OpenAI para a base URL da CometAPI e chame o modelo gpt-6-astra. A documentação do modelo Astra na CometAPI publica endpoints de Chat Completions e de Responses.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.responses.create(
    model="gpt-6-astra",
    reasoning={"effort": "medium"},
    input="Analise esta arquitetura de software e identifique os três gargalos de maior risco.",
)

print(response.output_text)
Para novos agentes com uso intenso de ferramentas, a Responses API é a interface mais importante porque as capacidades orientadas a agentes do Astra são projetadas em torno desse fluxo.
Um relay ultrabarato do GPT-6 Astra é realmente mais barato?
Agregadores de preço às vezes mostram relays que cotam o Astra muito abaixo das tarifas principais. Essas ofertas não devem ser automaticamente tratadas como equivalentes. Confirme a procedência do modelo, suporte completo de contexto, comportamento de ferramentas, termos de privacidade, política de logs, uptime, limites de taxa e como o provedor sustenta um preço abaixo da economia normal de upstream.
Nota de risco de relay: para agentes de produção, código-fonte, documentos corporativos, dados de clientes ou cargas de trabalho sensíveis à segurança, a procedência do modelo e o tratamento de dados fazem parte do preço efetivo. Verifique suporte de contexto, comportamento de ferramentas, termos de privacidade, logging, uptime e limites de taxa antes de usar um relay de baixo custo.
FAQ da API do GPT-6 Astra: preços, testes gratuitos e provedores
Qual é o provedor de API do GPT-6 Astra mais barato?
Para inferência interativa Standard entre os provedores verificados aqui, a CometAPI é a mais barata a $8/M de entrada e $40/M de saída. Para cargas de trabalho tolerantes a atraso, OpenAI Batch/Flex e OpenRouter Batch são mais baratos a $5/$25.
Existe uma API gratuita do GPT-6 Astra?
Não há uma camada Free permanente da API da OpenAI para o Astra. Créditos promocionais da CometAPI, Azure ou AWS podem reduzir ou cobrir temporariamente os custos de testes, sujeitos às regras de elegibilidade e acesso ao modelo de cada programa.
A CometAPI oferece um teste gratuito do GPT-6 Astra?
A CometAPI afirma que novas contas recebem créditos de cadastro e que não é necessário cartão para começar. Como promoções mudam, verifique o valor atual do crédito no cadastro.
Quanto custa o GPT-6 Astra pela OpenAI?
A precificação Standard de contexto curto da OpenAI é $10/M de entrada, $1/M de entrada em cache, $12.50/M de gravação de cache e $50/M de saída. Acima de 272K tokens de entrada, as tarifas Standard tornam-se $20/M de entrada, $2/M de entrada em cache, $25/M de gravação de cache e $75/M de saída para toda a solicitação.
Por que o Batch do GPT-6 Astra pode ser mais barato que a CometAPI?
Batch/Flex é uma camada de processamento diferente, não apenas um provedor diferente. A OpenAI o precifica em metade do Standard, ou $5/M de entrada e $25/M de saída para solicitações Astra de contexto curto. A tarifa de $8/$40 da CometAPI é do estilo Standard interativo.
A Azure é mais barata que a OpenAI para o GPT-6 Astra?
A Azure Standard Global se alinha ao OpenAI Standard em $10/M de entrada e $50/M de saída. A Azure ainda pode ser atraente economicamente por causa de crédito para novos usuários, acordos corporativos, governança Microsoft e gasto já contratado.
A AWS Bedrock é mais barata que a OpenAI para o GPT-6 Astra?
A AWS Global CRIS é $10/$50, enquanto In-Region e Geo CRIS são $11/$55 para contexto curto. A AWS ainda pode ser preferível para equipes que valorizam cobrança na nuvem existente, controles regionais e integração de infraestrutura.
A OpenRouter é mais barata para o GPT-6 Astra?
A OpenRouter Standard é $10/$50, portanto não supera a OpenAI na tarifa Standard por token. Sua rota Batch é $5/$25; sua vantagem mais ampla é o roteamento multi-provedor.
Qual é o maior custo oculto da API do GPT-6 Astra?
O limite de 272K na entrada é um dos limites de custo ocultos mais importantes. Chamadas de ferramentas, pesquisa na web/arquivos, tentativas, falhas de cache e trajetórias de agente desnecessariamente longas também podem elevar materialmente o custo total da tarefa.
Devo escolher um provedor apenas pelo preço por token?
Não. Compare o custo por tarefa bem-sucedida, latência, uptime, suporte de contexto, compatibilidade de ferramentas, comportamento de cache, política de dados, limites de conta e limites de taxa. O token mais barato só é útil se a rota entregar de forma confiável a carga de trabalho de que você precisa.