DeepSeek V4.1 Flash vs V4 Pro: Desempenho, Preços e Guia de Migração
Para confirmar: você se refere ao Gemini 1.5 Flash vs Gemini 1.5 Pro? Pergunto porque não há referência oficial a “DeepSeek V4.1 Flash” ou “V4 Pro”. Se for Gemini, posso comparar por arquitetura, benchmarks oficiais, preços de API, visão, concorrência e opções de migração. Se for DeepSeek, indique os modelos exatos (por exemplo, DeepSeek-V3 vs DeepSeek-R1 ou DeepSeek-VL) para eu elaborar a comparação.
Deon GoodwinEquipe de pesquisa de modelos e API de IA
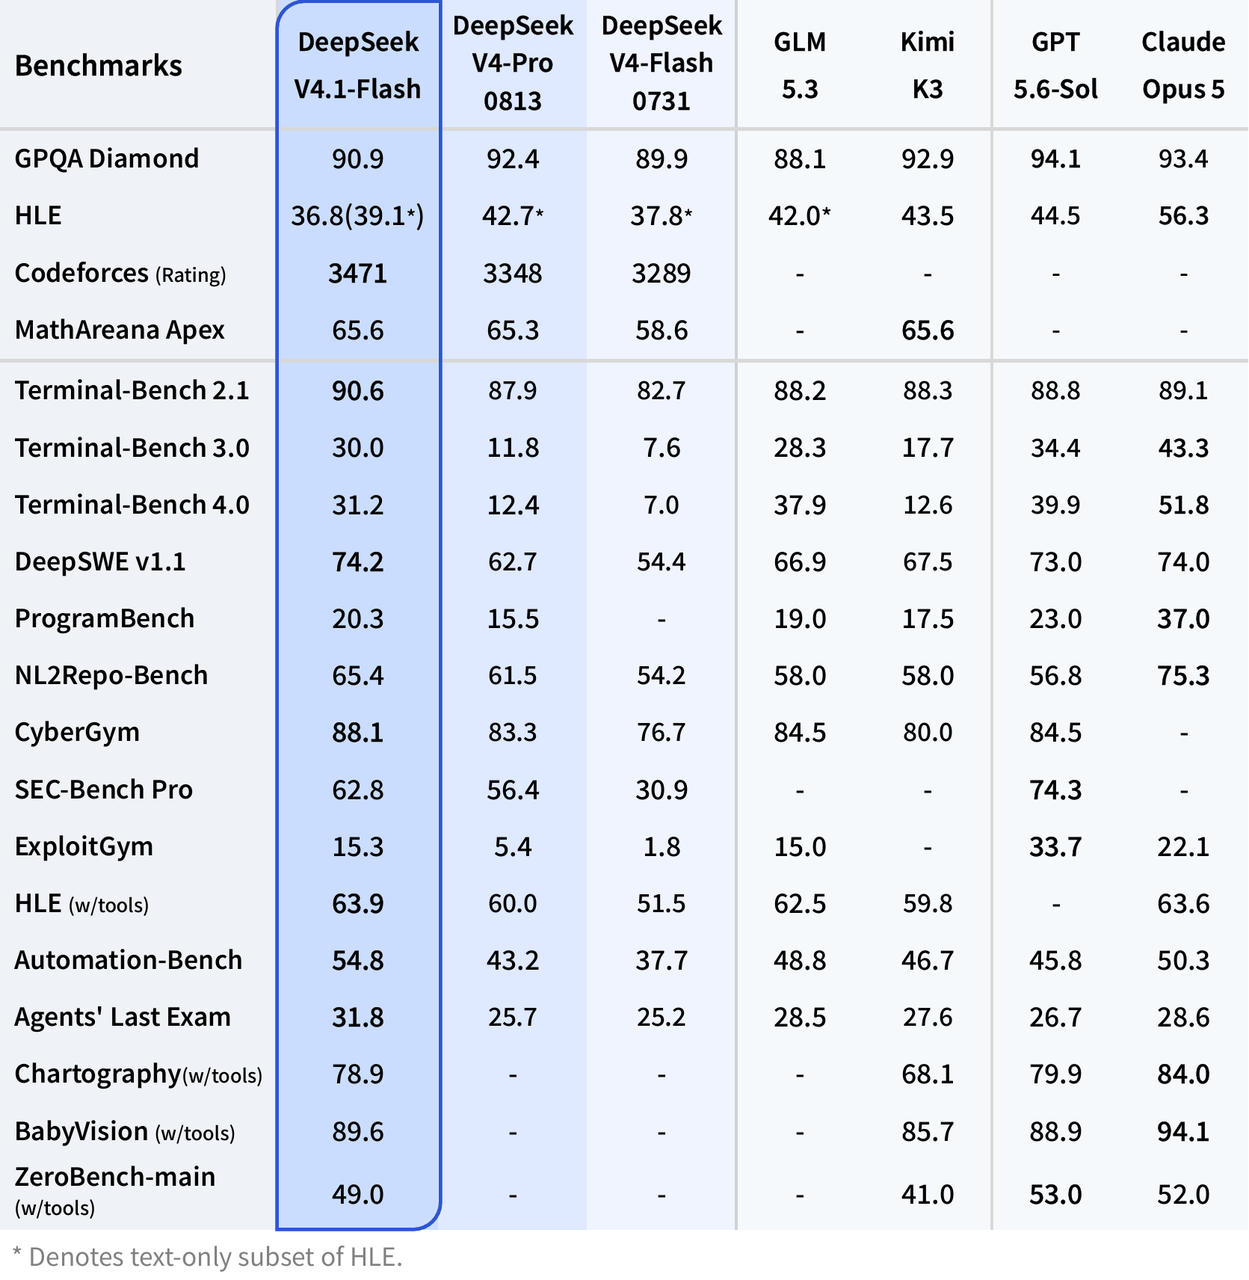
O DeepSeek V4.1 Flash substitui a geração V4 Flash anterior por um modelo MoE causal encoder–decoder com 552B parâmetros, compreensão nativa de imagens, uma janela de contexto de 1M tokens e um custo de serviço substancialmente menor. Na comparação oficial da DeepSeek, ele melhora a maioria dos benchmarks de codificação, terminal, segurança e agentes em relação ao V4 Pro 0813, enquanto o V4 Pro mantém vantagem no GPQA Diamond e no HLE sem ferramentas.
A página atual de preços da API da DeepSeek volta a listar deepseek-flash e deepseek-v4-pro como rotas separadas, atendendo V4.1 Flash e V4-Pro-0813, respectivamente. Elas têm preços, limites de concorrência e suporte a visão diferentes. Portanto, novas integrações devem selecionar o ID do modelo que corresponda à carga de trabalho pretendida, em vez de depender do comportamento histórico de aliases.
Key Takeaways
V4.1 Flash e V4 Pro são atualmente opções oficiais distintas na API: use para V4.1 Flash e para V4-Pro-0813.
Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
Os maiores ganhos comparáveis aparecem em tarefas de terminal, agentes de codificação, automação e execução orientada à segurança — não em todo benchmark de raciocínio closed-book.
O V4.1 Flash é materialmente mais barato do que a rota V4 Pro atualmente listada em tokens de entrada com cache-hit, entrada com cache-miss e saída.
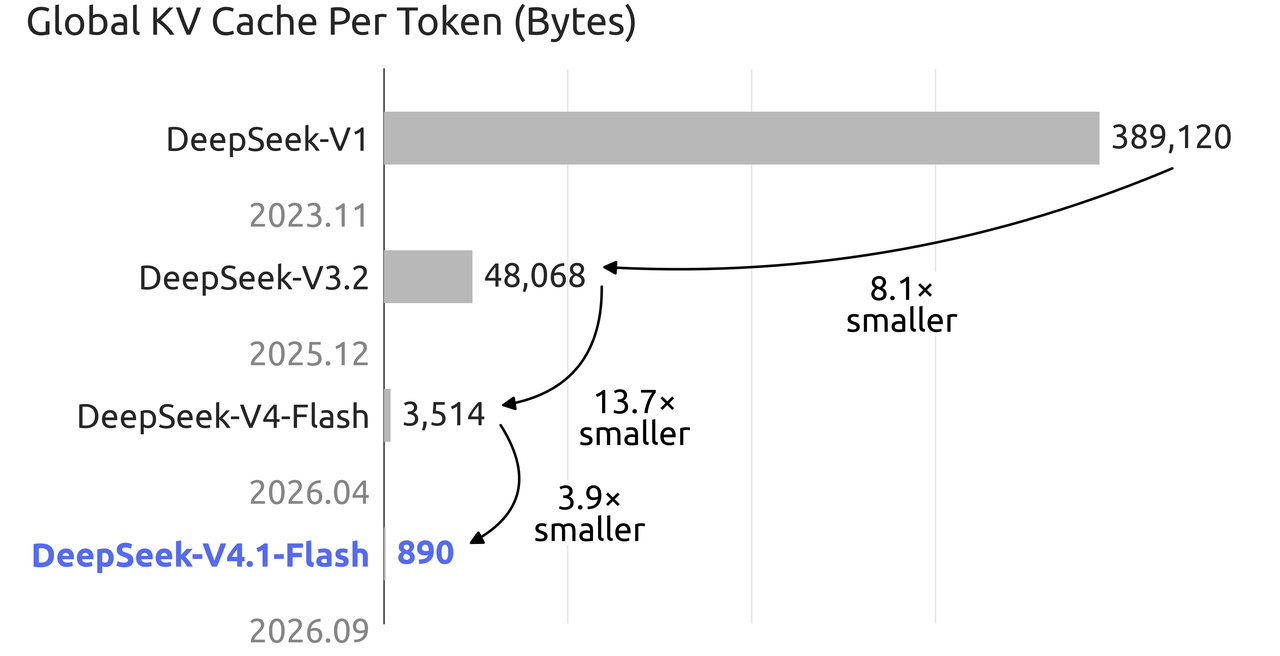
O V4.1 Flash adiciona visão nativa, eleva a concorrência documentada de 500 para 2.500 e reduz o armazenamento global do KV-cache para 890 bytes por token.
A migração deve ser explícita mesmo que os aliases funcionem: atualize os IDs de modelo, valide o comportamento com e sem pensamento, reteste chamadas de ferramentas e entradas de imagem e monitore o uso de tokens e a latência.
Nota de roteamento atual: a página oficial de preços identifica deepseek-v4-pro como V4-Pro-0813, separado do V4.1 Flash.
How Do DeepSeek V4.1 Flash and V4 Pro Specifications Compare?
A arquitetura mudou de um design Sparse MoE muito grande no V4 Pro para um design assimétrico causal encoder–decoder no V4.1 Flash. O modelo mais novo ativa menos parâmetros para o processamento de entrada do que para a geração de saída, o que ajuda a reduzir o custo de prefill enquanto preserva uma capacidade de geração mais forte.
Specification
DeepSeek V4.1 Flash
DeepSeek V4 Pro 0813
Architecture
Causal encoder–decoder MoE
Sparse MoE
Total parameters
Backbone parameters / repository weight count
552B parâmetros do backbone; o Hugging Face lista tamanho de modelo de 763B
1,6T parâmetros do backbone; o Hugging Face lista cerca de 1,7T de tamanho de modelo
Active parameters
8B para entrada; 16B para saída
49B por token
Context window
1M tokens
1M tokens
Maximum output
384K tokens
384K tokens
Thinking and non-thinking modes
Suportado
Suportado
Native image understanding
Suportado
Não suportado
Documented concurrency
2,500
500 na configuração atual
Current official API status
Ativo como deepseek-flash
Ativo como deepseek-v4-pro (V4-Pro-0813)
Parâmetros — esclarecimento: o card do modelo do V4.1 Flash descreve 552B parâmetros do backbone, enquanto o repositório do Hugging Face reporta um tamanho de modelo de 763B. Essas cifras descrevem escopos de contagem diferentes e não devem ser apresentadas como totais intercambiáveis.
Comprimento de saída — esclarecimento: o card do modelo do V4.1 Flash recomenda max_tokens ≥ 256K para inferência local, enquanto a página atual de preços da API da DeepSeek declara explicitamente um máximo de saída de 384K para ambos os modelos de API. Uma configuração recomendada de inferência não é o mesmo que um máximo imposto pela API.
Where Does DeepSeek V4.1 Flash Improve on V4 Pro?
A tabela oficial de benchmarks da DeepSeek mostra as melhorias mais claras em workloads com muita execução. A coluna de porcentagens abaixo é calculada a partir das pontuações publicadas; comparações percentuais são omitidas onde a métrica é uma avaliação ou onde uma porcentagem simples seria enganosa.
Benchmark
V4.1 Flash
V4 Pro 0813
Diferença
Interpretação
Terminal-Bench 2.1
90.6
87.9
+2.7 pontos; +3.1%
Execução em terminal mais confiável
Terminal-Bench 3.0
30.0
11.8
+18.2 pontos; +154.2%
Grande ganho em tarefas de terminal mais difíceis
Terminal-Bench 4.0
31.2
12.4
+18.8 pontos; +151.6%
Grande ganho em tarefas de terminal mais novas
DeepSWE v1.1
74.2
62.7
+11.5 pontos; +18.3%
Trabalho mais forte em nível de repositório
ProgramBench
20.3
15.5
+4.8 pontos; +31.0%
Síntese de programas aprimorada
NL2Repo-Bench
64.0
61.5
+2.5 pontos; +4.1%
Melhor NL-para-repositório
CyberGym
88.1
83.3
+4.8 pontos; +5.8%
Execução mais forte em tarefas de cibersegurança
HLE with tools
63.9
60.0
+3.9 pontos; +6.5%
Melhor raciocínio com ferramentas
Automation-Bench
O resultado é multidimensional: o V4.1 Flash é decisivamente melhor para agentes de codificação, operação em terminal, automação, tarefas de segurança, uso de ferramentas, visão, concorrência e custo. A vantagem restante do V4 Pro se concentra em testes de raciocínio puro selecionados. Assim, as cargas de trabalho devem ser julgadas pela mistura de tarefas, e não por uma única alegação agregada.
Why Is DeepSeek V4.1 Flash More Efficient Than V4 Pro?
Computação assimétrica de entrada e saída
O V4.1 Flash ativa 8B parâmetros durante o processamento de entrada e 16B durante a geração de saída. Esse design assimétrico direciona as diferentes necessidades de computação de prefill e decodificação, reduzindo custo sem forçar ambos os estágios pelo mesmo orçamento de parâmetros ativos.
Pegada menor de KV-cache
A DeepSeek relata que o V4.1 Flash usa um quarto da HBM e um oitavo da capacidade de SSD exigidas pelo KV-cache da geração anterior. O gráfico publicado coloca o cache KV global em 890 bytes por token, comparado a 3.514 bytes para o V4 Flash.
Entrada multimodal nativa e maior concorrência
O V4.1 Flash pode interpretar imagens nativamente e expõe um limite de concorrência documentado de 2.500, cinco vezes a cifra atual do V4 Pro de 500. Essas mudanças importam para agentes baseados em capturas de tela, extração de documentos, solução de problemas visuais e filas de produção de alto volume.
What Does DeepSeek V4.1 Flash Cost Compared with V4 Pro?
A tabela atual oficial de preços precifica as duas rotas separadamente. Por 1M tokens, o V4.1 Flash custa $0.003/$0.006 para entrada com cache-hit, $0.15/$0.30 para entrada com cache-miss e $0.60/$1.20 para saída (fora do pico/pico). O V4 Pro custa $0.022/$0.044, $0.66/$1.32 e $1.98/$3.96, respectivamente. Os preços podem mudar, portanto orçamentos de produção devem referenciar a página de preços ao vivo.
How Should You Migrate from DeepSeek V4 Pro or V4 Flash to V4.1 Flash?
Use o ID de modelo explícito em produção
Use deepseek-flash quando quiser o V4.1 Flash. Os nomes antigos deepseek-v4-flash e deepseek-v4-flash-vision-exp ainda resolvem para o V4.1 Flash, mas a nomeação explícita facilita o monitoramento e futuros rollbacks. Use deepseek-v4-pro quando você intencionalmente quiser o backend V4-Pro-0813 atualmente listado.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # or "deepseek-v4-pro"
    messages=[{"role": "user", "content": "Review this migration plan."}],
)

print(response.choices[0].message.content)
Reteste o comportamento, não apenas a compatibilidade do endpoint
Execute prompts representativos nos modos com e sem pensamento; compare sucesso da tarefa, contagem de tokens e latência.
Reteste esquemas de ferramentas, saída JSON, comportamento da Responses API, completação por prefixo e FIM quando usados.
Adicione testes de entrada de imagem se o produto for usar a nova capacidade visual nativa.
Recalibre os orçamentos usando tarifas de pico e fora de pico, em vez de carregar adiante suposições do V4 Pro.
Acompanhe a taxa de acerto do prompt-cache, pois ela pode dominar o custo de entrada em escala.
Escolha explicitamente o backend pretendido
A rota atual deepseek-v4-pro seleciona o V4-Pro-0813. As equipes devem registrar a versão do modelo resolvida, a data de avaliação, o conjunto de prompts e a janela de preços para que as comparações permaneçam reproduzíveis caso o roteamento mude novamente.
Which Workloads Fit DeepSeek V4.1 Flash Best?
Workload
Recommended choice
Reason
Coding agents and repository maintenance
V4.1 Flash
Pontuações mais altas em DeepSWE, ProgramBench, NL2Repo e terminal
Tool-driven automation
V4.1 Flash
Pontuações mais altas em Automation-Bench, HLE com ferramentas e agentes
Image-aware assistants
V4.1 Flash
Compreensão nativa de imagens
High-throughput or cost-sensitive serving
V4.1 Flash
Maior concorrência e preços de tokens muito mais baixos
Historical V4 Pro reproductionCurrent V4 Pro access and evaluation
V4 Pro
A rota oficial atualmente identifica V4-Pro-0813
Pure closed-book reasoning
Validate on domain data
O V4 Pro permanece mais alto em GPQA Diamond e HLE sem ferramentas
DeepSeek V4.1 Flash vs V4 Pro FAQ
Is DeepSeek V4.1 Flash better than V4 Pro?
Para a maioria das dimensões de produção — agentes de codificação, tarefas de terminal, automação, uso de ferramentas, visão, throughput e preço — sim. O V4 Pro ainda tem pontuações publicadas mais fortes em GPQA Diamond e HLE sem ferramentas, portanto workloads de raciocínio puro devem ser testados com prompts específicos do domínio.
Can I still call deepseek-v4-pro?
Sim. A página oficial atual da API lista deepseek-v4-pro como V4-Pro-0813, com seu próprio preço e limite de concorrência.
What model ID should a new integration use?
Use deepseek-flash para V4.1 Flash, ou deepseek-v4-pro para V4-Pro-0813. Não trate os dois IDs como aliases.
Do old V4 Flash model IDs still work?
A DeepSeek afirma que solicitações deepseek-v4-flash e deepseek-v4-flash-vision-exp são automaticamente roteadas para o V4.1 Flash e faturadas no novo preço do Flash. Atualizar o ID de modelo configurado ainda é recomendado para clareza.
Does DeepSeek V4.1 Flash support images?
Sim. A compreensão nativa de imagens faz parte do V4.1 Flash; a API histórica do V4 Pro não fornecia essa capacidade.
Is DeepSeek V4.1 Flash cheaper than the current V4 Pro?
Sim. A tabela oficial atual lista preços mais baixos de entrada com cache-hit, entrada com cache-miss e saída para o V4.1 Flash do que para o V4 Pro.
Should I expect identical outputs after migration?
Não. A compatibilidade de endpoint não garante caminhos de raciocínio, seleção de ferramentas, uso de tokens ou formatação idênticos. Reexecute as avaliações de produção antes de confiar em limites anteriores.