Especificações técnicas do MiniMax M3.1-Flash-Preview
| Item | MiniMax M3.1-Flash-Preview |
|---|---|
| Model ID | MiniMax-M3.1-Flash-Preview |
| Model family | Série MiniMax M3.1, modelo de codificação Preview |
| Release status | Preview; anunciado em 27 de setembro de 2026 |
| Primary focus | Desenvolvimento de software do dia a dia, de correções de bugs a entregas completas de recursos |
| Context window | 1.000.000 de tokens |
| Input modalities | Texto, imagem e vídeo |
| Output modality | Texto |
| Reasoning control | reasoning_effort: low, medium, high, xhigh, max |
| Thinking behavior | Pensamento adaptativo é necessário; a documentação pública revisada não suporta desativar o pensamento |
| Maximum output | Não publicado separadamente nos materiais públicos revisados |
| Parameter count | Não divulgado publicamente |
| Open weights | Nenhum checkpoint/repositório de modelo público identificado |
A MiniMax anunciou o M3.1-Flash-Preview para o MiniMax Code em 27 de setembro de 2026, posicionando-o para tarefas cotidianas de desenvolvimento, como correção de bugs e entrega completa de funcionalidades. As coberturas públicas atuais consistentemente indicam uma janela de contexto de 1M tokens e um esforço de raciocínio ajustável, observando que uma tabela de benchmarks independente e o preço por token não foram publicados.
O que é o MiniMax M3.1-Flash?
O MiniMax M3.1-Flash-Preview é um modelo de texto orientado à codificação em Preview, projetado para fluxos de trabalho iterativos de desenvolvimento de software, e não apenas para geração de código. A MiniMax descreve o fluxo de trabalho como abrangendo entendimento de requisitos, localização de problemas, implementação, testes de regressão e verificação das mudanças em relação à funcionalidade existente.
Seus controles distintivos documentados são o longo contexto e a escada de esforço de raciocínio em cinco níveis. Os níveis disponíveis são low, medium, high, xhigh e max, permitindo que os desenvolvedores equilibrem profundidade de raciocínio e latência conforme a complexidade da tarefa.
Principais recursos do MiniMax M3.1-Flash-Preview
- Contexto de 1M tokens: A descrição publicada do modelo atribui ao modelo Preview uma janela de contexto de um milhão de tokens, tornando-o adequado para grandes repositórios, especificações longas e sessões estendidas de agentes de codificação.
- Entrada multimodal nativa: As descrições públicas do modelo listam texto, imagem e vídeo como entradas, enquanto o modelo retorna texto.
- Cinco níveis de esforço de raciocínio:
low,medium,high,xhighemaxfornecem controle mais fino sobre a profundidade do raciocínio do que um simples interruptor liga/desliga. - Fluxo de trabalho de codificação ponta a ponta: A MiniMax posiciona especificamente o modelo para localização de bugs, implementação, tratamento de casos limite, conclusão de testes de regressão e validação de mudanças.
- Implantação orientada a Preview: A disponibilização pública inicial é por meio do MiniMax Code e do Token Plan, em vez de uma oferta standalone totalmente documentada no modelo pay-as-you-go.
- Ajuste para agentes de codificação: O modelo é destinado a interações de desenvolvimento repetidas, nas quais o contexto do repositório, a saída de ferramentas, os testes e as correções iterativas importam mais do que a geração de código em uma única vez.
MiniMax M3.1-Flash-Preview vs outros modelos de codificação da MiniMax
| Modelo | Foco | Contexto | Dados públicos de benchmark | Acesso/status |
|---|---|---|---|---|
| M3.1-Flash-Preview | Codificação do dia a dia, desenvolvimento iterativo | 1M | Ainda não publicado | Preview; MiniMax Code / Token Plan |
| M3 | Codificação de fronteira + trabalho agentizado, multimodalidade nativa | Até 1M | Publicado pela MiniMax | API, Token Plan, MiniMax Code |
| M2.7 | Engenharia de software + trabalho amplo de agente/produtividade | Não utilizado aqui como uma especificação copiada do M3.1 | Publicado pela MiniMax | API, Token Plan, Agent |
M3 é o ponto de referência mais bem documentado: a MiniMax publica sua arquitetura, metodologia de avaliação de codificação/agentes e disponibilidade de API. M2.7 também possui registro público de benchmarks e integração com API. M3.1-Flash-Preview é mais novo e atualmente possui uma documentação pública mais estreita, portanto, as comparações devem se concentrar no posicionamento documentado em vez de declarar um vencedor de benchmark. 4
Casos de uso representativos
- Correção de bugs em escala de repositório: Forneça ao modelo um grande codebase, descrição do problema, logs e testes e use seu longo contexto para preservar o contexto relevante do projeto.
- Implementação de recursos: Use o modelo para evoluir de um requisito em linguagem natural para mudanças de código e testes de regressão.
- Revisão e remediação de código: Peça para identificar casos limite, propor patches e verificar que as mudanças não quebram o comportamento existente.
- Depuração multimodal: Forneça capturas de tela, diagramas ou vídeo juntamente com requisitos textuais quando o contexto visual fizer parte do problema de engenharia.
- Sessões de agentes de codificação de longa duração: Use a grande janela de contexto para especificações, arquivos do repositório, saída de terminal e resultados de testes iterativos.
- Desenvolvimento sensível à velocidade: Selecione um nível menor de esforço de raciocínio para edições rotineiras e aumente o esforço para mudanças multietapas mais complexas.
Como acessar a API do MiniMax M3.1-Flash-Preview
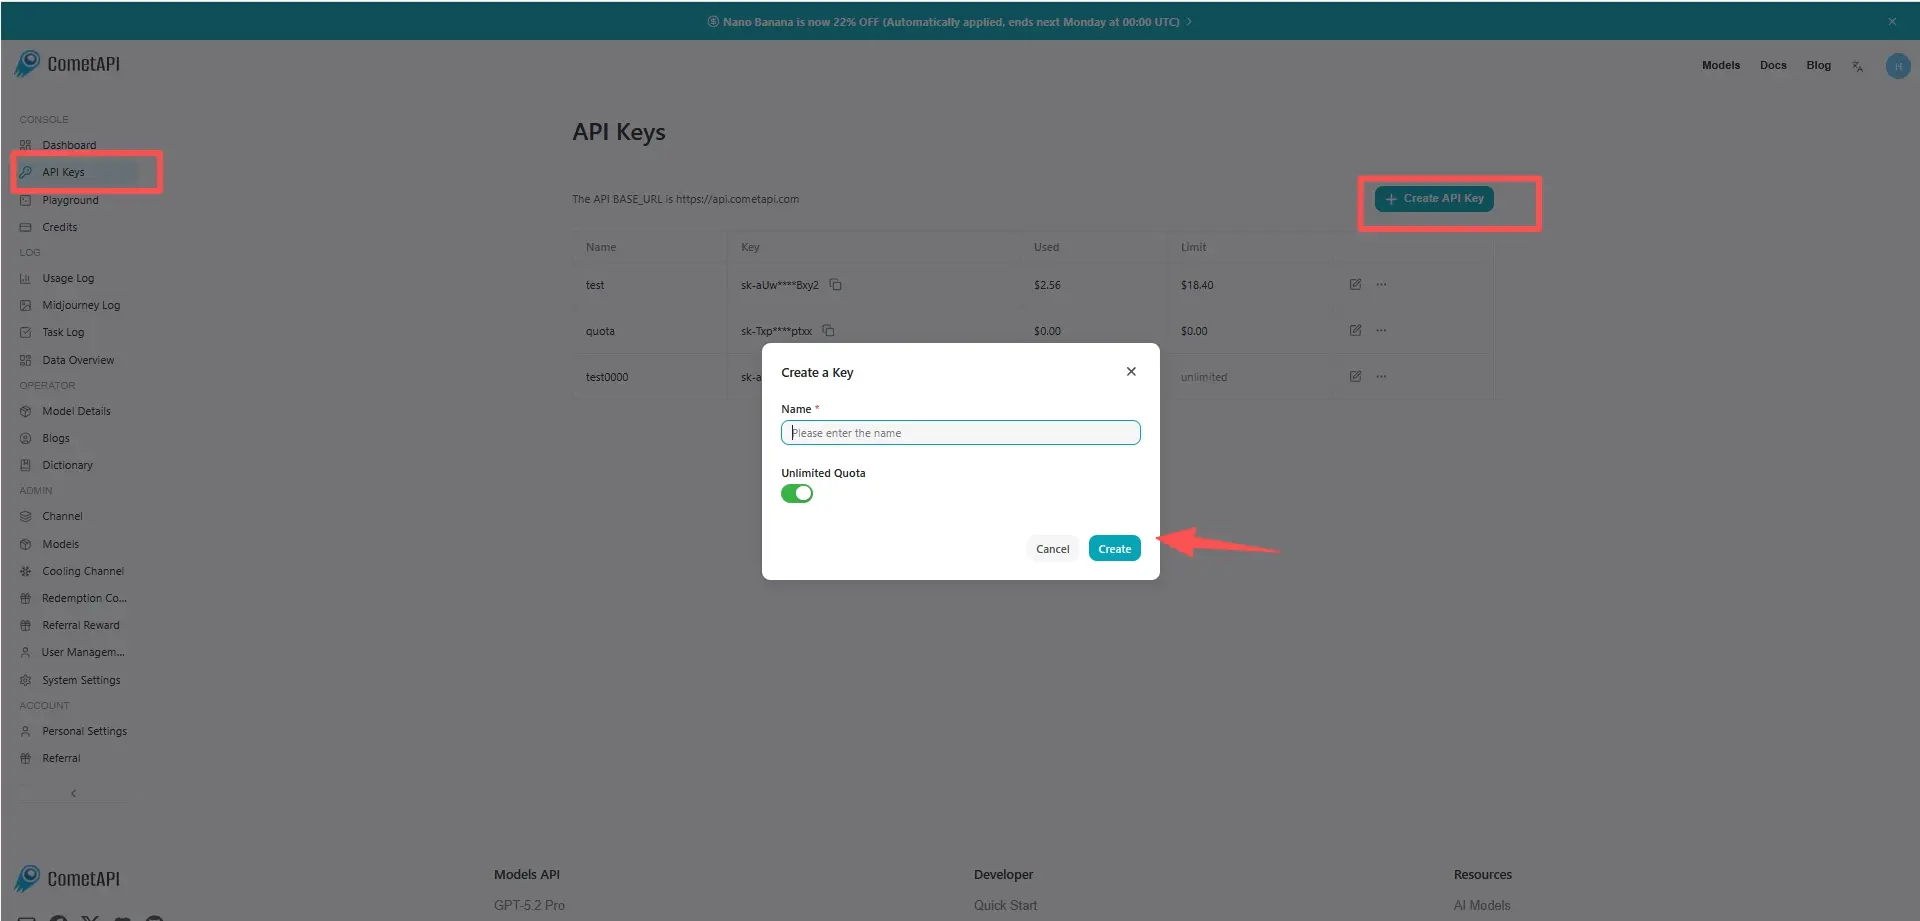
Etapa 1: Cadastre-se para obter a chave da API
Faça login em cometapi.com. Se você ainda não é nosso usuário, registre-se primeiro. Acesse o seu console do CometAPI. Obtenha a chave de credenciais de acesso da API. Clique em “Add Token” no token da API no centro pessoal, obtenha a chave do token: sk-xxxxx e envie.
Etapa 2: Envie solicitações para a API do MiniMax M3.1-Flash-Preview
Selecione o endpoint “minimax-m3.1-flash-preview” para enviar a solicitação de API e defina o corpo da requisição. O método e o corpo da requisição são obtidos na nossa documentação da API do site. Nosso site também fornece teste no Apifox para sua conveniência. Substitua <YOUR_API_KEY> pela sua chave real do CometAPI da sua conta. A URL base é Chat Completions.
Insira sua pergunta ou solicitação no campo de conteúdo — é isso que o modelo responderá. Processe a resposta da API para obter a resposta gerada.
Etapa 3: Recupere e verifique os resultados
Processe a resposta da API para obter a resposta gerada. Após o processamento, a API responde com o status da tarefa e os dados de saída.