
TL;DR
Comece com o GPT-6.1 Sol quando você já usa as ferramentas Responses da OpenAI ou precisa da sua escada explícita de esforço de raciocínio; teste o Claude Sonnet 5.5 para iteração de código bem definida e entregáveis profissionais orientados por templates. Estas são prioridades de avaliação, não um ranking comprovado de qualidade. Ambos começam em $2/M de entrada e $10/M de saída e cobram $0.10/M por leituras de cache base. Com cerca de 1M de contexto e 128K de saída máxima padrão, as diferenças práticas são integração, comportamento da tarefa, retenção de cache e cobrança para contexto longo, e não um desconto na leitura de cache base.
A principal compensação está no comportamento da tarefa e nas condições de cobrança. O GPT-6.1 Sol usa cinco níveis de esforço e requer Responses para chamadas de ferramentas; o Sonnet 5.5 usa pensamento adaptativo. Acima de 272K tokens de entrada, o GPT-6.1 Sol aplica taxas mais altas a toda a solicitação. As fontes revisadas aqui não estabelecem um vencedor em benchmark pareado e de versão exata, portanto selecione o modelo que atenda aos seus critérios de aceitação com o menor custo total do fluxo de trabalho.
Principais conclusões
- Preços base iguais: ambos os modelos cobram $2/M de entrada, $10/M de saída e $0.10/M por leituras de cache base. Compare gravações de cache, retenção, camadas de contexto longo e uso efetivamente faturado.
- Contexto é próximo: 1,05M versus 1M tokens; ambos suportam 128K de saída máxima padrão.
- Integração difere: o GPT-6.1 Sol requer Responses para chamadas de ferramenta e não aceita esforço none ou minimal; o Sonnet 5.5 usa pensamento adaptativo e restrições de ferramenta específicas do modelo.
- Mantenha as evidências específicas por versão: pontuações do GPT-6 Sol não podem ser reclassificadas como resultados do GPT-6.1 Sol.
- Escolha pelo trabalho concluído: meça qualidade, latência, novas tentativas, gravações e leituras de cache, tarifas de ferramentas e correção humana.
GPT-6.1 Sol vs Claude Sonnet 5.5 de relance
| Fator de decisão / especificação | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Provedor | OpenAI | Anthropic |
| Data de lançamento | 29 de setembro de 2026 | 28 de setembro de 2026 |
| ID do modelo | gpt-6.1-sol | claude-sonnet-5-5 |
| Contexto / saída máxima padrão | 1.050.000 / 128.000 tokens | 1.000.000 / 128.000 tokens |
| Entrada → saída | Texto e imagens → texto | Texto e imagens → texto |
| Controles de raciocínio | low, medium, high, xhigh, max; medium como padrão | Pensamento adaptativo; high como padrão na Claude Platform |
| Esforço padrão | medium | high na Claude Platform |
| Corte de conhecimento | 30 de abril de 2026 | junho de 2026 |
| Entrada/saída base oficial por 1M tokens | $2 / $10; Solicitações Standard com até 272K de tokens de entrada | $2 / $10 |
| Leituras de cache base oficiais por 1M | $0.10 | $0.10 |
| Gravações de cache base oficiais por 1M | $2.50 | $2.50 por 5 minutos; $4.00 por 1 hora |
| Cobrança de contexto longo | Acima de 272K de entrada: $4 entrada, $0.20 leitura de cache, $5 gravação de cache, $15 saída por 1M; aplica à Standard inteira | Nenhuma sobretaxa equivalente declarada na visão geral citada |
| Posicionamento principal | Codificação complexa, uso de computador e trabalho profissional | Iteração rápida de código e fluxos de trabalho profissionais |
| Teste primeiro quando | Você já usa ferramentas Responses ou precisa de controles de esforço explícitos | Seu trabalho se centra em código, documentos, slides ou planilhas |
| Limite de evidência e decisão | Capacidades documentadas; nenhum vencedor numérico pareado e de versão exata estabelecido aqui | Resultados publicados de codificação e trabalho do conhecimento; não é uma vitória controlada sobre o GPT-6.1 Sol |
Visão geral do GPT-6.1 Sol
O GPT-6.1 Sol é o lançamento Sol de 29 de setembro de 2026 da OpenAI para codificação complexa, uso de computador e trabalho profissional. A OpenAI o descreve como desempenho próximo ao Astra a um custo menor; esse posicionamento deve ser validado nas suas tarefas. Seu contexto amplo e raciocínio ajustável o tornam um candidato para agentes de repositório e fluxos de trabalho profissionais em múltiplas etapas.
Suas restrições operacionais importam tanto quanto seu posicionamento: medium é o esforço padrão, low é o nível mais baixo suportado e chamadas de ferramenta requerem Responses. Um fluxo de trabalho construído em torno de um caminho sem raciocínio ou de ferramentas do Chat Completions precisa de migração antes de usar este modelo de forma confiável.
Visão geral do Claude Sonnet 5.5
O Claude Sonnet 5.5 é o lançamento de 28 de setembro de 2026 da Anthropic para codificação cotidiana bem delimitada, agentes e trabalho profissional. Sua visão geral do modelo documenta pensamento adaptativo, esforço padrão high na Claude Platform, entrada de texto e imagem e 128K de saída máxima padrão. A Anthropic enfatiza correção de bugs, documentos claros, slides polidos e iteração eficiente.
Para uma equipe de desenvolvimento, isso torna o Sonnet um candidato útil para ciclos repetidos de implementação e revisão. Para um fluxo de trabalho de escritório, avalie sua qualidade de primeiro rascunho e aderência a templates. A alegação de velocidade do provedor compara o Sonnet 5.5 com o Sonnet 5; ela não estabelece vantagem de velocidade sobre o GPT-6.1 Sol.
GPT-6.1 Sol vs Claude Sonnet 5.5: Desempenho
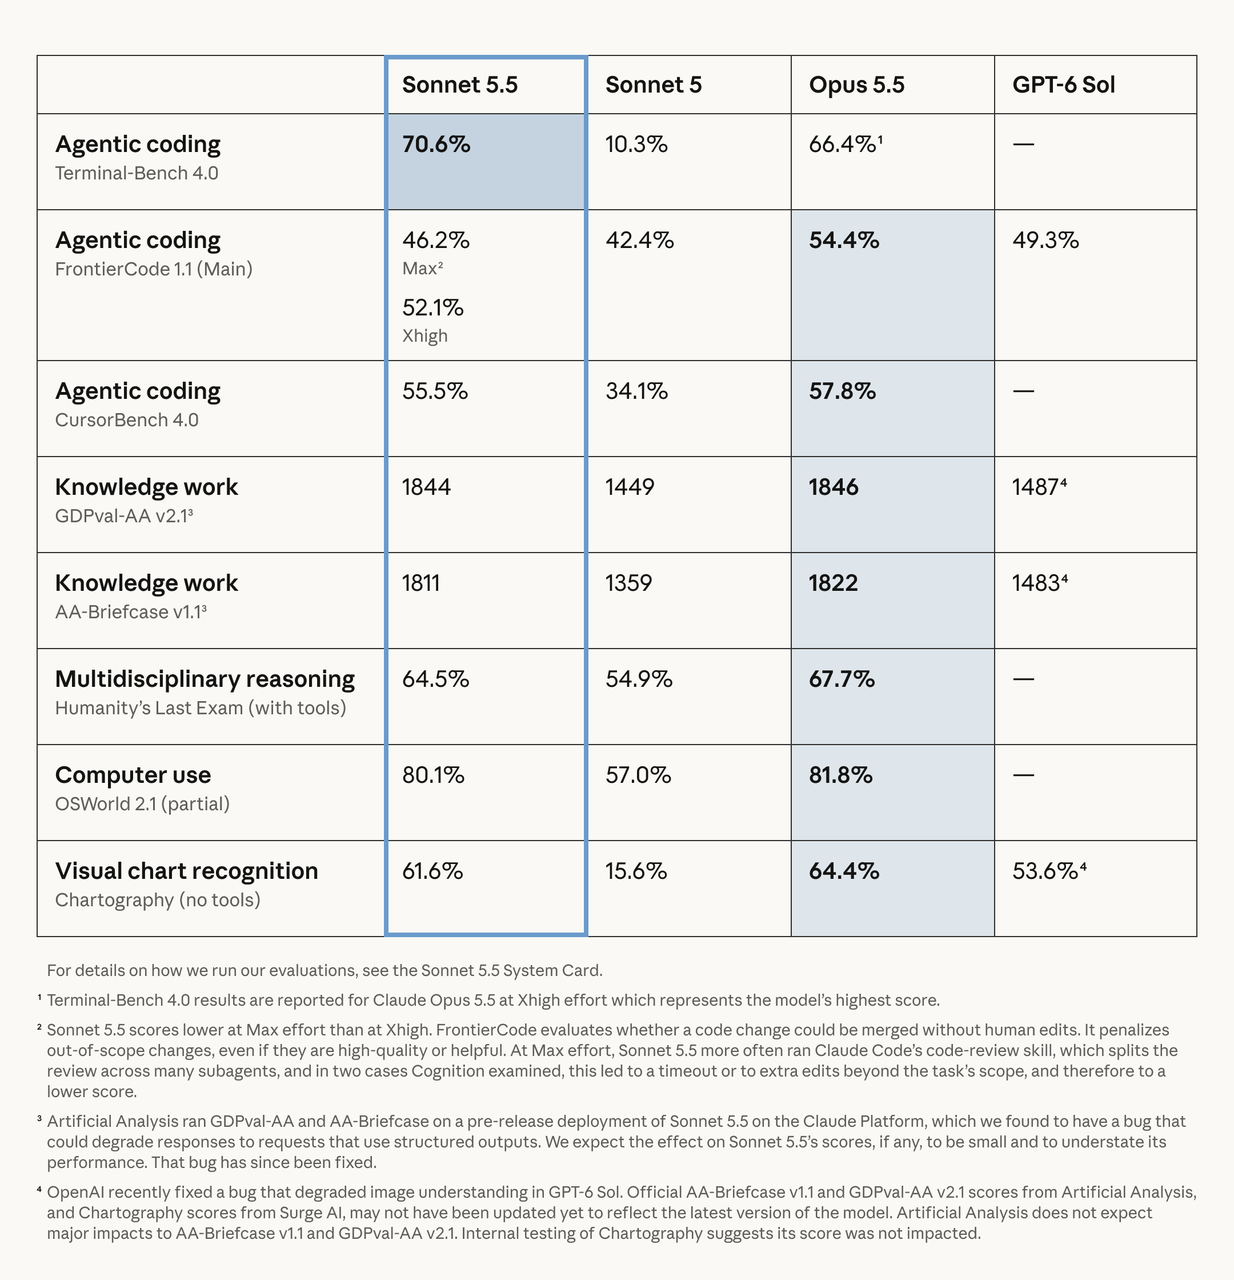
Os resultados de lançamento do Sonnet 5.5 da Anthropic fornecem um conjunto útil de sinais de carga de trabalho. Sua comparação inclui o mais antigo GPT-6 Sol, portanto esses valores na coluna da OpenAI são excluídos da tabela do modelo atual abaixo. “Não estabelecido” significa que as fontes citadas não suportam uma pontuação de versão exata para esta comparação; não significa desempenho zero.
| Benchmark / condições | GPT-6.1 Sol | Claude Sonnet 5.5 | O que mede |
|---|---|---|---|
| Terminal-Bench 4.0 | Não estabelecido aqui | 70,6% | Tarefas de codificação em terminal |
| FrontierCode 1.1 Main | Não estabelecido aqui | 52,1% Xhigh; 46,2% Max | Mudanças mescláveis em repositório |
| CursorBench 4.0 | Não estabelecido aqui | 55,5% | Desenvolvimento agentic no Cursor |
| GDPval-AA v2.1 | Não estabelecido aqui | 1844 | Trabalho profissional de conhecimento |
| AA-Briefcase v1.1 | Não estabelecido aqui | 1811 | Trabalho de conhecimento de longo prazo |
| Humanity’s Last Exam, tools | Não estabelecido aqui | 64,5% | Raciocínio multidisciplinar |
| OSWorld 2.1, parcial | Não estabelecido aqui | 80,1% | Recompensa parcial de uso de computador |
| Chartography, sem ferramentas | Não estabelecido aqui | 61,6% | Reconhecimento visual de gráficos |
Condições de teste: esforço e o arcabouço de agentes afetam os resultados de codificação. GDPval-AA e AA-Briefcase são avaliações da Artificial Analysis, enquanto os resultados de Chartography vêm da Surge AI. A Anthropic observa um bug de saída estruturada, posteriormente corrigido, no deployment pré-lançamento do Sonnet que pode ter subestimado ligeiramente seus resultados de trabalho profissional. Use o link do System Card do anúncio para ambientes de teste e metodologia completa; não combine métricas diferentes em um único ranking geral.
A imagem original da Anthropic abaixo inclui suas notas de rodapé de avaliação. Sua coluna de GPT-6 Sol é apenas contexto histórico e não relata desempenho do GPT-6.1 Sol.
Codificação agentic e engenharia de software
O Sonnet 5.5 tem evidências relatadas em codificação no terminal, mudanças mescláveis de código e tarefas agent em estilo IDE. O GPT-6.1 Sol é documentado para codificação complexa e integra-se ao ecossistema de ferramentas da OpenAI. Nem o posicionamento do produto nem a pontuação de um predecessor estabelecem um vencedor atual em codificação. Para uma avaliação útil, escolha mudanças reais com testes de regressão e peça aos revisores que avaliem escopo, manutenibilidade e prontidão para merge.
Trabalho do conhecimento, raciocínio, matemática e ciência
Os resultados do Sonnet em GDPval-AA e AA-Briefcase tornam relatórios, análises e entregáveis de escritório alvos sensatos de avaliação. O GPT-6.1 Sol também mira trabalho profissional, mas as fontes usadas aqui não fornecem uma comparação pareada entre esses modelos. Use seus próprios templates de documentos, planilhas e apresentações. Alegações de matemática avançada e ciência exigem evidências específicas à tarefa, em vez de extrapolação de controles gerais de raciocínio.
Uso de computador, automação de navegador e fluxos multimodais
Ambos os modelos aceitam imagens, o que suporta depuração por captura de tela e análise visual. Os resultados de OSWorld e Chartography do Sonnet são evidência para essas avaliações específicas. O GPT-6.1 Sol documenta uso de computador via ferramentas do Responses. Teste o fluxo completo: precisão de navegação, recuperação após uma chamada de ferramenta falha, correção da saída e tempo até a conclusão. Entrada de texto e imagem por si só não garante integração de uso de computador idêntica.
Avaliação independente e qualidade da evidência
Uma tabela publicada por um provedor pode conter resultados de terceiros sem se tornar um único experimento controlado. Para qualquer comparação independente, registre os IDs de modelo exatos, datas de deployment, esforço, ferramentas, salvaguardas, timeout, política de nova tentativa e regras de parada. Um índice agregado de inteligência, uma taxa de sucesso em codificação e uma pontuação de recompensa parcial de uso de computador respondem a perguntas diferentes. As fontes revisadas não estabelecem um conjunto completo de resultados independentes pareados para este par exato.
GPT-6.1 Sol vs Claude Sonnet 5.5: Custo
Preços oficiais de API
| Métrica de preço | Tarifas oficiais do GPT-6.1 Sol | Tarifas oficiais do Claude Sonnet 5.5 |
|---|---|---|
| Entrada / 1M tokens, Standard base | $2.00 | $2.00 |
| Saída / 1M tokens, Standard base | $10.00 | $10.00 |
| Leitura de cache / 1M tokens, base | $0.10 | $0.10 |
| Gravação de cache / 1M tokens, base | $2.50 | $2.50 por 5m; $4.00 por 1h |
| Processamento em lote | 50% abaixo do Standard | Desconto de 50% em entrada/saída |
| Entrada acima de 272K, solicitação Standard completa | $4 entrada / $0.20 leitura de cache / $5 gravação de cache / $15 saída | Nenhuma sobretaxa equivalente declarada na visão geral citada |
Todas as tarifas são em USD por milhão de tokens. Leituras de cache base do GPT-6.1 Sol custam $0.10/M e leituras de cache do Sonnet 5.5 também custam $0.10/M. A condição do Sol acima de 272K de entrada eleva as tarifas para toda a solicitação Standard, não apenas para os tokens excedentes. Compare gravações de cache, retenção, camadas de contexto longo, processamento regional e camadas de serviço; o preço de leitura base sozinho não dá vantagem a nenhum modelo.
Custo por tarefa concluída
Custo por resultado aceito = custo total em todas as tarefas tentadas / número de resultados aceitos. O custo total inclui entrada nova faturada, leituras e gravações de cache, saída (incluindo tokens de raciocínio faturados quando aplicável), chamadas de ferramenta pagas e revisão ou correção humana. Custos de novas tentativas são contabilizados pelo uso real, não adicionados novamente como cobrança duplicada.
Para um milhão de tokens de leitura de cache faturados inteiramente na tarifa base, qualquer modelo custa $0.10; a diferença de preço de leitura base é $0.00. Isto é uma ilustração de tarifa, não uma solicitação Sol de um milhão de tokens de entrada precificada na camada base. O custo real da sessão também inclui entrada nova, gravações de cache, saída, ferramentas e novas tentativas. Compare sessões frias e quentes sob a camada de contexto aplicável e relate a taxa de resultados aceitos junto com o uso faturado.
Preços CometAPI
| Camada publicada da CometAPI | API do GPT-6.1 Sol na CometAPI | API do Claude Sonnet 5.5 na CometAPI |
|---|---|---|
| Entrada/saída base por 1M | $1.60 / $8.00 | $1.60 / $8.00 |
| Desconto base vs provedor | 20% | 20% |
| Entrada/saída de contexto longo GPT | $3.20 / $12.00 | Verifique os termos específicos da rota atual |
| Leituras de cache GPT, base/longa | $0.08 / $0.16 | Não especificado na tabela básica citada |
Estes são os preços publicados por rota de modelo verificados para esta revisão, separados das tarifas do provedor. A precificação do GPT-6.1 Sol na CometAPI distingue contexto curto e longo. A tabela básica citada do Sonnet lista entrada e saída, portanto não justifica assumir uma política de cache de gateway idêntica. Verifique os termos de cobrança atuais da rota selecionada antes de estimar uma sessão de produção.
Como se comparam janelas de contexto, velocidade e especificações técnicas?
O GPT-6.1 Sol suporta 1,05M tokens, enquanto o Claude Sonnet 5.5 suporta 1M tokens. A diferença nominal é de cerca de 5%, portanto a capacidade de contexto por si só dificilmente decidirá a maioria dos deployments.
A escada de esforço do GPT-6.1 Sol é low, medium, high, xhigh e max; medium é o padrão. O Sonnet 5.5 usa pensamento adaptativo com high como padrão na Claude Platform. Esses nomes não implicam orçamentos de raciocínio iguais. Com requisitos de qualidade iguais, meça separadamente o tempo até o primeiro token, a taxa de geração de saída, a latência do loop de ferramentas e a conclusão de ponta a ponta.
A Anthropic relata mais de 30% de geração de saída mais rápida para o Sonnet 5.5 do que para o Sonnet 5. Trate isso como comparação com o predecessor. As evidências deste artigo não estabelecem um número universal de latência para o GPT-6.1 Sol nem um vencedor direto de velocidade entre os modelos atuais. Para cargas de trabalho interativas, teste configurações de esforço mais baixas contra o mesmo critério de aceitação em vez de assumir que max é a melhor configuração de deployment.
O que importa para segurança, alinhamento e implantação?
Decisões de implantação devem distinguir o comportamento documentado do modelo dos controles da aplicação. Uma comparação de modelos sozinha não pode estabelecer qual implantação atende às exigências de manuseio de dados ou acesso da sua organização. Avalie o provedor ou gateway que você realmente usa, incluindo registro de solicitações, residência de dados, permissões de ferramentas e tratamento de falhas.
- Migração de raciocínio: o GPT-6.1 Sol não suporta none ou minimal. A orientação de migração da OpenAI direciona fluxos de trabalho com chamadas de ferramenta para Responses.
- Comportamento de ferramentas do Claude: as mudanças documentadas de compatibilidade do Sonnet 5.5 incluem modos de ferramenta forçada não suportados e blocos de pensamento vinculados à conversa. Teste esses caminhos antes do rollout.
- Controles operacionais: dê aos agentes apenas as ferramentas necessárias para a tarefa, registre chamadas falhas e mantenha revisão humana para ações externas consequentes. Estas são escolhas de design de aplicação, não vantagens medidas de nenhum dos modelos.
GPT-6.1 Sol vs Claude Sonnet 5.5: Qual escolher?
Teste primeiro o GPT-6.1 Sol quando você já usa ferramentas Responses ou precisa de uma escada de esforço previsível. Teste o Sonnet 5.5 para iteração de código bem delimitada, slides, planilhas e fluxos de documentos onde suas evidências relatadas correspondam às suas tarefas. Para sessões com prefixos em cache, teste ambos: suas tarifas base de leitura de cache são iguais, enquanto custos de gravação, retenção, camadas de contexto longo e sucesso da tarefa podem alterar a conta total. Direcione o trabalho apenas depois que avaliações representativas estabelecerem uma diferença útil em qualidade, custo ou latência.
Seleção baseada na carga de trabalho
| Carga de trabalho | Ponto de partida | O que verificar |
|---|---|---|
| Agente OpenAI Responses existente | GPT-6.1 Sol | Compatibilidade de ferramentas e mudanças de esforço |
| Iteração de código / correção de bugs | Sonnet 5.5, depois compare Sol | Prontidão para merge, latência e novas tentativas |
| Slides / planilhas / relatórios | Sonnet 5.5, depois compare Sol | Aderência a templates e tempo de edição humana |
| Sessões estáveis com prefixo em cache | Ambos; tarifas iguais de leitura de cache base | Taxa de acerto, gravações, camada de contexto e qualidade aceita |
| Solicitações completas acima de 272K de entrada | Ambos | Conta real de contexto longo e qualidade de recuperação |
| Automação de computador / navegador | Ambos | Recuperação, conclusão da tarefa e permissões |
| Análise matemática / científica | Ambos em testes específicos | Correção com respostas verificáveis |
| Produção sensível a custo | Ambos | Custo total por resultado aceito |
Uma comparação de produção deve manter constante o sistema ao redor. Use os mesmos prompts, repositórios ou documentos, permissões de ferramentas, timeout, política de novas tentativas e critério de aceitação da saída.
Registre entrada nova, gravações e leituras de cache, uso de saída, chamadas de ferramenta pagas, novas tentativas, tempo de revisão humana, sucesso da tarefa e latência de ponta a ponta. Uma resposta inicial mais barata ainda pode produzir um resultado aceito mais caro.
Como acessar o GPT-6.1 Sol e o Claude Sonnet 5.5?
Desenvolvedores podem acessar a API do GPT-6.1 Sol na CometAPI e a API do Claude Sonnet 5.5 na CometAPI pelas rotas de modelo documentadas. Crie uma chave de API, armazene-a com segurança e verifique acesso ao modelo e cobrança específica da rota antes de produção.
Acesso ao GPT-6.1 Sol
Para o Sol, use a rota Responses documentada quando chamadas de ferramenta forem necessárias. Selecione gpt-6.1-sol e um nível de esforço suportado, com medium como padrão. Passe a entrada da tarefa, configure apenas as ferramentas necessárias e valide texto retornado, chamadas de ferramenta, erros e uso. Confirme suporte do gateway para recursos específicos do provedor em vez de assumir que toda opção da OpenAI está disponível.
Acesso ao Claude Sonnet 5.5
Para o Sonnet, selecione claude-sonnet-5-5 em uma interface compatível documentada e envie a tarefa como mensagens de conversa com um orçamento de saída apropriado. Confirme como essa rota trata pensamento nativo e parâmetros de ferramentas; campos de raciocínio da OpenAI não são automaticamente intercambiáveis com opções do Claude. Valide continuação de conversa e tratamento de erros antes do deployment de agentes.
Um check de endpoint verifica conectividade, não desempenho comparativo. Para avaliação, alinhe prompts, orçamentos efetivos de saída e raciocínio, ferramentas, novas tentativas, timeouts e critérios de aceitação, depois compare trabalho aceito, latência e custo total faturado.
Conclusão
GPT-6.1 Sol e Claude Sonnet 5.5 compartilham as mesmas tarifas base de entrada, saída e leitura de cache, com capacidade de contexto similar. O Sol é um candidato natural para agentes Responses existentes e controles de esforço explícitos. O pensamento adaptativo do Sonnet e seus resultados relatados em codificação e trabalho profissional o tornam um candidato útil para entregáveis do dia a dia. Workflows intensivos em cache exigem comparação de sessão completa: tarifas iguais de leitura base não garantem custos iguais de gravação, retenção, contexto longo ou tarefa concluída.
Escolha o modelo que conclui seu trabalho real dentro dos requisitos de qualidade, latência e custo. Mantenha separadas as pontuações de predecessores das evidências de modelos atuais, precifique a camada de contexto que sua carga usa e compare ambas as rotas antes de adotar um padrão.
Perguntas frequentes
GPT-6.1 Sol e Sonnet 5.5 podem compartilhar um único schema de ferramenta?
Uma definição de ferramenta JSON comum pode ser um ponto de partida, mas suporte de endpoint, comportamento de ferramenta forçada, blocos de pensamento e tratamento de resposta diferem. Valide as chamadas de ferramenta de cada modelo com testes de contrato para argumentos, caminhos de falha e continuação de conversa. Mantenha adaptadores específicos de modelo para opções não suportadas, em vez de assumir que uma solicitação de texto bem-sucedida prova compatibilidade de agente.
Como igualar o esforço de raciocínio entre ambos os modelos?
Não trate configurações com nomes idênticos como orçamentos de compute iguais. Defina um critério de aceitação e um limite de custo ou meta de latência, então varra as configurações de esforço para cada modelo. Compare a melhor configuração que atende à mesma restrição operacional, incluindo novas tentativas e correção humana, em vez de comparar apenas as configurações mais altas de ambos.
Quando um workflow com contexto de 1M deve usar retrieval?
Use retrieval quando uma tarefa precisar de uma parte pequena e identificável de um corpus grande e seus testes de retrieval mostrarem que material relevante é recuperado de forma consistente. Teste solicitações de contexto completo quando a evidência estiver distribuída ou relações entre arquivos forem importantes. Compare correção da resposta, cobertura de citações, custo de entrada e latência; um limite grande de contexto por si só não estabelece que preencher toda a janela seja econômico ou confiável.
Como equipes evitam uma comparação enganosa de custo de cache?
Meça separadamente execuções com cache frio e quente, registre gravações de cache bem como leituras e aplique a janela correta de retenção e a camada de contexto longo. Mantenha prefixos compartilhados estáveis e compare sessões realistas repetidas, não apenas uma solicitação com desconto. Relate a taxa de acerto e o uso total faturado para que uma economia aparente possa ser reproduzida.
O que deve disparar uma nova avaliação GPT-6.1 Sol vs Sonnet 5.5?
Reexecute a suíte de tarefas afetada após uma atualização de deployment, correção de bug do provedor, mudança de roteamento, mudança de ferramenta ou prompt, ou uma revisão material de preços. Registre data da avaliação, ID do modelo, endpoint, esforço e versão do arcabouço. Preserve a execução anterior como baseline para que mudanças de qualidade ou latência não sejam confundidas com mudanças no sistema ao redor.