TL;DR
GPT-6.1 Sol não é um substituto com contexto maior nem mais caro para o GPT-6 Sol. Mantém a mesma janela de contexto de 1,05 milhão de tokens, saída máxima de 128K e preços padrão da API de $2/$10, enquanto melhora em codificação, uso de computador, fluxos de trabalho profissionais, confiabilidade factual e comportamento de agente. A mudança de preço mais clara é no cache de prompt: a entrada em cache cai de $0.20 para $0.10 por milhão de tokens.
O resultado prático é que o GPT-6.1 Sol tem menos a ver com mudar o formato da API e mais com obter substancialmente mais trabalho útil com aproximadamente o mesmo orçamento de tokens.
Principais pontos
- GPT-6.1 Sol é uma atualização de capacidade do GPT-6 Sol, com a mesma janela de contexto de 1.050.000 tokens e teto de saída de 128.000 tokens.
- Os preços padrão de entrada e saída da API permanecem em $2/M e $10/M; a entrada em cache cai de $0.20/M para $0.10/M.
- Avaliações oficiais mostram melhor desempenho em codificação, uso de computador, automação de negócios e fluxos de trabalho científicos; os resultados dependem do benchmark e da configuração de raciocínio.
- A migração requer verificar tanto o esforço de raciocínio quanto a compatibilidade do endpoint da API: GPT-6.1 Sol não remove nada e exige Responses API para chamadas de ferramentas.
- Valide sucesso de tarefa, latência, acertos reais de cache e custo ponta a ponta antes de substituir uma implantação estável do GPT-6 Sol.
O que é o GPT-6.1 Sol e por que chegou tão pouco tempo após o GPT-6 Sol?
A OpenAI apresentou o GPT-6 Sol em 22 de setembro de 2026. Uma semana depois, seu adendo ao system card de 29 de setembro anunciou o GPT-6.1 Sol. A OpenAI apresenta o novo lançamento como uma atualização do GPT-6 Sol e não como uma faixa de preço separada.
O curto intervalo de lançamento importa porque o GPT-6.1 Sol não é posicionado como um novo nível de produto. A OpenAI manteve a faixa de preço Sol e concentrou a atualização em capacidade para tarefas difíceis, eficiência de custo e confiabilidade de agentes.
A OpenAI posiciona o GPT-6.1 Sol em torno de codificação agentic, uso de computador e trabalho profissional. A comparação importante é o sucesso de tarefa a um determinado custo, e não apenas o nome do modelo. O resumo de benchmarks oficial abaixo separa ganhos de capacidade de especificações de API inalteradas.
Isso torna a comparação incomumente direta: o GPT-6.1 Sol é principalmente uma atualização de capacidade e eficiência, e não de janela de contexto ou preço base.
GPT-6.1 Sol vs. GPT-6 Sol: o que permanece igual?
Ambos os modelos mantêm a mesma capacidade principal, modalidades de entrada/saída suportadas e preços padrão de entrada/saída. A tabela também registra diferenças em datas de corte, opções de raciocínio, chamadas de ferramentas e taxas de entrada em cache; essas diferenças não devem ser confundidas com especificações compartilhadas.
Especificações compartilhadas e diferenças de compatibilidade
| Especificação | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Release date | Sep. 29, 2026 | Sep. 22, 2026 |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Maximum output | 128,000 tokens | 128,000 tokens |
| Knowledge cutoff | Apr. 30, 2026 | Apr. 20, 2026 |
| Text input / output | Yes / Yes | Yes / Yes |
| Image input | Yes | Yes |
| Standard input price | $2.00 / 1M | $2.00 / 1M |
| Cached input | $0.10 / 1M | $0.20 / 1M |
| Cache write | $2.50 / 1M | $2.50 / 1M |
| Output price | $10.00 / 1M | $10.00 / 1M |
| Reasoning effort | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Structured outputs | Yes | Yes |
| Function calling | Yes through Responses API; unavailable through Chat Completions | Yes through Responses API; Chat Completions only with reasoning_effort=none |
| Fine-tuning | No | No |
| Audio / video input | Not supported | Not supported |
| Native image output | Not supported; image generation is a separate tool | Not supported; image generation is a separate tool |
As duas colunas oficiais acima documentam os mesmos limites de contexto e saída. Esses números descrevem capacidade; eles não estabelecem precisão de recuperação ou latência iguais em todas as cargas de trabalho de longo contexto.
A knowledge cutoff avança levemente, de 20 de abril para 30 de abril de 2026. Mais importante, o GPT-6.1 Sol não suporta mais reasoning.effort="none"; suas configurações de raciocínio disponíveis começam em low.
Para desenvolvedores que dependem de comportamento com latência mínima, esse detalhe de compatibilidade vale testes porque o GPT-6 Sol ainda suporta reasoning effort none.
Arquitetura: o que permanece não divulgado
Nenhuma das páginas dos modelos usadas para esta comparação fornece contagem de parâmetros ou um detalhamento de arquitetura. O adendo ao system card oficial diz que o GPT-6.1 Sol usa os mesmos tipos de dados e treinamento que o Astra; essa afirmação não prova que Sol e Astra tenham arquiteturas idênticas. Diferenças de arquitetura e de escala de parâmetros permanecem, portanto, não divulgadas no material citado.
Preço base inalterado; leituras de cache mais baratas
Para tokens não em cache, não. As tarifas padrão de entrada e saída permanecem inalteradas. A principal melhoria de preço é a entrada em cache.
| Preços oficiais da API — USD por 1M de tokens | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M tokens | $2.00 | $2.00 |
| Cached input / 1M | $0.10 | $0.20 |
| Cache write / 1M | $2.50 | $2.50 |
| Output / 1M tokens | $10.00 | $10.00 |
O GPT-6.1 Sol reduz a entrada em cache para $0.10 por milhão de tokens, ou 5% da tarifa de entrada não em cache.
Por exemplo, reutilizar 100 milhões de tokens de entrada em cache custa cerca de $10 no GPT-6.1 Sol versus $20 no GPT-6 Sol. Essa diferença é modesta para prompts pontuais, mas mais significativa para agentes de alto volume com prefixes de prompt estáveis.
As condições oficiais de preços mostradas na documentação do modelo também se aplicam: solicitações acima de 272K tokens de entrada usam tarifas 2x de entrada e cache e 1.5x de saída para a solicitação inteira. Fast mode é 2x o Standard; Batch e Flex ficam 50% abaixo do Standard. O processamento regional adiciona um acréscimo de 10% onde disponível, e Fast mode é indisponível com EU data residency. Encargos de ferramentas separados podem se aplicar. Faça o orçamento considerando o modo de processamento selecionado, região e acertos reais de cache.
O que melhorou no GPT-6.1 Sol?
A atualização é melhor avaliada em codificação, fluxos de trabalho com agentes, documentos profissionais, ciência, factualidade e recuperação de falhas. As seções abaixo agrupam essas melhorias preservando as condições e limitações originais de benchmark.
Visão geral dos benchmarks: ganhos relatados e condições de avaliação
O argumento mais forte para o GPT-6.1 Sol vem do desempenho em nível de tarefa, e não de especificações brutas. A OpenAI reporta melhorias em engenharia de software, automação de negócios, interação com computador, fluxos de trabalho científicos, factualidade e alinhamento de agentes.
| Resultados oficiais de benchmark / avaliação | GPT-6.1 Sol vs. GPT-6 Sol | O que a mudança significa |
|---|---|---|
| DeepSWE v1.1 | +6,4 pontos percentuais sobre o melhor resultado do GPT-6 Sol, com menor esforço de raciocínio e custo de tarefa; não é comparação pareada por esforço | Engenharia de software de longo horizonte mais forte |
| AutomationBench 1.0.6 | +4,8 pontos em medium para ambos os modelos Sol; +2,2 pontos sobre o Opus 5.5 em medium | Melhor execução de agentes de negócios multi-etapas |
| OSWorld 2.0 offline | +7 pontos em esforço máximo; recompensa parcial no conjunto offline, release v2026.08.08; menos da metade do custo por tarefa | Melhores fluxos de trabalho de uso de computador |
| Terminal-Bench Science 0.1 | Mais que 2x a pontuação do GPT-6 Sol em esforço máximo, com menos da metade do custo por tarefa | Grande ganho em fluxos de trabalho científicos |
| Avaliação de factualidade difícil | Em low, respostas com erro caem de 11,4% para 7,7%; avaliação selecionada de prompts difíceis | Menos erros factuais em prompts difíceis |
| Teste de alinhamento com busca quebrada | Em esforço máximo, falha em divulgar busca quebrada cai de 4,9% para 2,1%; tarefas deliberadamente adversariais | Melhor reconhecimento de falhas de ferramentas |
Estes são resultados reportados pela OpenAI, não medições independentes da CometAPI. A OpenAI avaliou seus modelos em seu ambiente de pesquisa ou por meio de sua API; o comportamento em produção pode diferir com prompts de sistema e ferramentas disponíveis. Números de concorrentes vêm de relatórios públicos. O custo por tarefa reflete a configuração testada e não é o mesmo que o preço do token. Detalhes não relatados, como orçamentos por execução ou scaffolds, não devem ser inferidos.
O resultado oficial na tabela de benchmark compara o GPT-6.1 Sol com menor esforço de raciocínio à melhor pontuação do GPT-6 Sol. Não deve ser descrito como uma comparação controlada de velocidade com esforço igual. O DeepSWE v1.1 avalia tarefas originais de engenharia de software de longo horizonte em bases de código reais.
Para contexto, o lançamento original do GPT-6 Sol reportou 68,8% em esforço máximo no DeepSWE v1.1.
Codificação: engenharia de software de longo horizonte mais forte
Codificação é possivelmente a atualização mais clara. O DeepSWE v1.1 avalia agentes em tarefas originais de engenharia de software em bases de código reais que exigem trabalho sustentado e multi-etapas.
A melhoria no DeepSWE resumida acima é relevante quando um agente precisa inspecionar um repositório, planejar mudanças, usar ferramentas e reparar falhas ao longo de muitos passos. Desenvolvedores podem comparar essa atualização com a API GPT-6 Astra na CometAPI ao decidir se as tarefas mais difíceis justificam um modelo de custo mais alto.
Isso importa mais do que um benchmark curto de codificação porque agentes de codificação de longa duração acumulam custo por raciocínio repetido, chamadas de ferramentas, leituras de arquivos, patches e reutilização de contexto. O GPT-6.1 Sol melhora tanto a conclusão de tarefas quanto a economia de contexto repetido sem elevar a tarifa padrão de tokens $2/$10.
A API do GPT-6 Sol na CometAPI continua útil para implantações existentes e fornece um caminho compatível com a OpenAI para cargas de trabalho de codificação e agentes.
Agentes de IA e fluxos de trabalho de negócios: automação e uso de computador
Sim, e a melhoria vai além da codificação. O AutomationBench avalia se um agente consegue completar fluxos de trabalho ponta a ponta usando muitas ferramentas em vendas, marketing, operações, suporte, finanças e RH.
O resultado em medium correspondente no AutomationBench no resumo de benchmarks é relevante para fluxos de trabalho de negócios intensivos em ferramentas. Continua sendo um benchmark e não uma garantia de sucesso no stack de ferramentas de uma empresa. A comparação também inclui a Claude Opus 5.5 API na CometAPI; avalie todos os candidatos com as mesmas ferramentas e critérios de sucesso antes de selecionar um.
Para uso de computador, o resultado do OSWorld acima usa o conjunto offline e recompensa parcial. Uma pontuação maior de recompensa parcial não significa necessariamente que toda tarefa foi concluída de ponta a ponta. Estado do navegador, permissões, comportamento de recuperação e qualidade da integração de ferramentas ainda afetam os resultados em produção.
Documentos profissionais e ciência: capacidade mais ampla para tarefas complexas
O GPT-6.1 Sol também empurra a faixa Sol mais fundo no trabalho de conhecimento profissional. A OpenAI avalia entendimento de documentos complexos com o GDP.pdf, onde modelos respondem perguntas realistas com base em PDFs contendo tabelas, gráficos, diagramas, formatação densa e detalhes em letras miúdas em áreas como finanças, saúde e direito.
O GDP.pdf adiciona evidência para análise profissional de PDFs além de perguntas e respostas apenas de texto. Trate seu resultado no anúncio de lançamento como uma avaliação de entendimento de documentos, não como garantia de que todo gráfico, rodapé ou página escaneada será interpretado corretamente.
O resultado do Terminal-Bench Science no resumo oficial de benchmarks cobre fluxos como análise de dados, simulação e demonstração de teoremas. Uma avaliação local útil deve pontuar correção e reprodutibilidade do resultado final, enquanto mede o custo total de ferramentas e modelo.
Isso não significa que o GPT-6.1 Sol substitui universalmente o Astra. A OpenAI continua posicionando o Astra como seu modelo de maior capacidade para o trabalho ponta a ponta mais difícil. A mudança importante é que a lacuna de desempenho entre Sol e Astra se estreita enquanto a diferença de preço por token entre eles permanece grande.
Factualidade e confiabilidade de agentes: menos erros e melhor tratamento de falhas
Os dados de factualidade da OpenAI apontam nessa direção, embora a avaliação não deva ser interpretada como uma taxa universal de alucinação.
O anúncio oficial reporta diretamente uma melhoria de factualidade em low effort: respostas contendo erros caem de 11,4% com o GPT-6 Sol para 7,7% com o GPT-6.1 Sol, uma queda de 3,7 pontos percentuais, ou aproximadamente 32% de redução relativa. Essas conversas selecionadas anteriormente desencadeavam erros; os números não são uma taxa universal de alucinação.
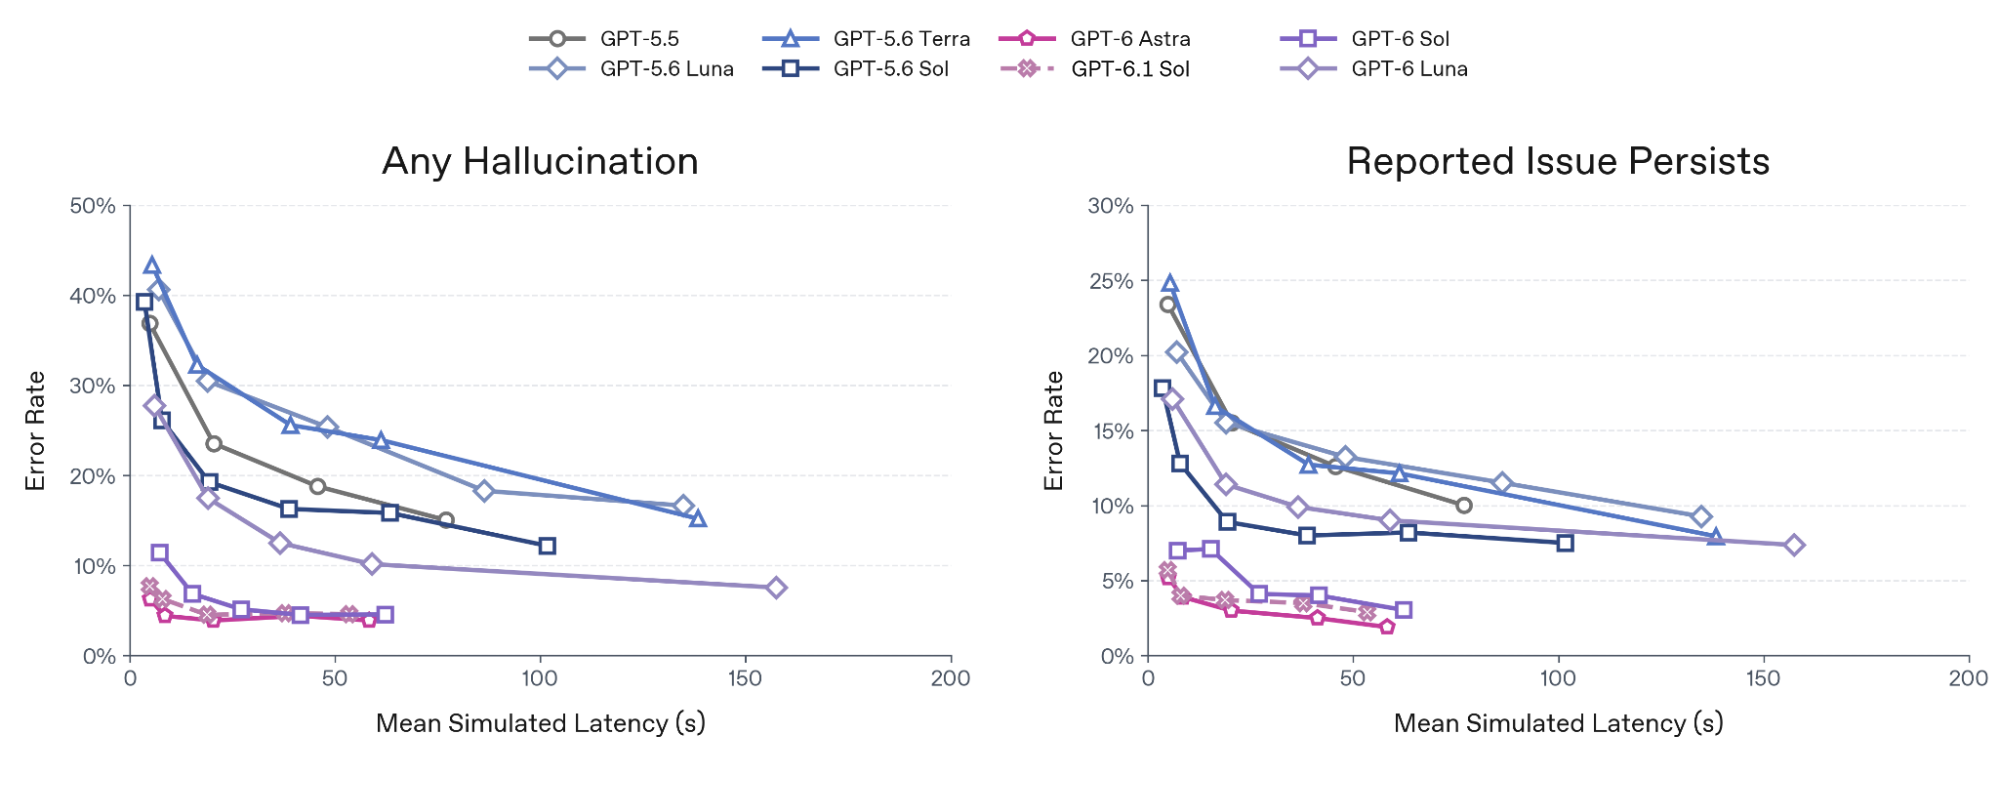
O gráfico original acima é extraído diretamente do PDF do system card da OpenAI sem redesenho. Ele traça avaliações de conversas difíceis selecionadas contra latência simulada; os dois painéis medem qualquer alucinação e a persistência do problema relatado. Não deve ser lido como uma estimativa de erro em produção ampla.
| Modelo | Taxa de falha em busca quebrada — esforço máximo |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
A API GPT-6 Luna na CometAPI é outra opção orientada a custo, mas seu resultado em busca quebrada aqui ilustra por que um agente deve ser testado tanto em tratamento de falhas quanto em execução bem-sucedida de ferramentas.
Essas são avaliações deliberadamente adversariais e não taxas representativas de falhas em produção. Elas são úteis como evidência de que o GPT-6.1 Sol é melhor em reconhecer quando ferramentas estão indisponíveis ou quebradas, em vez de continuar confiantemente com afirmações sem suporte.
GPT-6.1 Sol vs. GPT-6 Sol: você deve atualizar?
Para um novo fluxo de trabalho complexo, o GPT-6.1 Sol é um forte candidato à avaliação. Para uma implantação estável do GPT-6 Sol, atualize apenas quando ganhos mensurados justificarem a migração. O limite de contexto compartilhado e os preços base por token tornam possível uma comparação justa, mas benchmarks públicos não podem decidir se sua própria aplicação ficará mais rápida, mais confiável ou mais barata.
Quando vale a pena testar a atualização
Priorize um teste quando codificação em escala de repositório, automação de negócios multi-etapas, uso de computador ou análise difícil de documentos representarem uma fatia substancial da sua carga de trabalho. As melhorias reportadas na seção anterior são relevantes para esses casos de uso. Trate-as como motivos para testar, e não como garantia de que sua taxa de sucesso em produção aumentará na mesma proporção.
Aplicações com contexto repetido são outro caso útil. A taxa menor de leitura de cache pode reduzir a parte de entrada da conta quando as solicitações realmente reutilizam um prefixo estável. Se a maior parte do gasto vem de tokens gerados, ferramentas ou tentativas com falha, um desconto de cache sozinho pode ter pouco efeito. Compare o custo total por resultado aceito, incluindo novas tentativas e tempo de revisão.
Quando manter o GPT-6 Sol é razoável
Mantenha o GPT-6 Sol quando ele já atende seus objetivos de qualidade, latência e orçamento e o modelo mais novo não produz benefício material em uma avaliação representativa. Uma integração funcionando também tem valor: evite substituir uma rota estável apenas porque o nome do modelo é mais novo.
Compatibilidade pode ser decisiva. O GPT-6 Sol suporta none em raciocínio; o GPT-6.1 Sol começa em low. Uma aplicação usando chamadas de função do Chat Completions do Sol em none deve mover seu loop de ferramentas para Responses para usar o 6.1 Sol. Também audite parâmetros de amostragem e parsing de respostas. Essas são mudanças de migração, não apenas uma troca de Model ID. Consulte a orientação de migração da OpenAI.
Como tomar a decisão de atualizar
Crie um conjunto de avaliação fixo com tarefas rotineiras, casos difíceis e falhas de ferramentas do seu fluxo de trabalho pretendido. Mantenha definições de tarefa, permissões de ferramentas e critérios de aceitação consistentes. Compare uma linha de base Sol validada com uma configuração 6.1 Sol válida; registre as configurações de raciocínio explicitamente em vez de fingir que none e low são equivalentes.
- Qualidade: meça conclusões aceitas, correções factuais, chamadas de ferramentas inválidas e esforço de revisão humana.
- Velocidade: compare latência p50/p95 ponta a ponta, incluindo novas tentativas e esperas por ferramentas.
- Custo: registre entrada não em cache, leituras de cache, gravações de cache, tokens de saída/raciocínio, encargos de ferramentas e esforço de engenharia.
- Implantação: comece com uma pequena fatia de tráfego, preserve um fallback Sol e expanda apenas quando os limites pré-definidos forem atendidos.
Recomendação prática: escolha o GPT-6.1 Sol quando o teste oferecer melhor economia por tarefa aceita ou um ganho de capacidade necessário sem regressões inaceitáveis. Mantenha o GPT-6 Sol para rotas onde compatibilidade e resultados comprovados superam o benefício mensurado. Uma implantação mista é razoável quando apenas algumas classes de tarefas melhoram. Estas são recomendações baseadas na carga de trabalho, não uma afirmação de que qualquer modelo vence universalmente.
Como migrar do GPT-6 Sol para o GPT-6.1 Sol?
No nível mais simples, o identificador do modelo muda de gpt-6-sol para gpt-6.1-sol.
Uma solicitação via Responses API pode ser assim:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analise este repositório e identifique a causa dos testes com falha."
)

print(response.output_text)
Trocar o identificador do modelo é só o primeiro passo. O GPT-6.1 Sol suporta low, medium, high, xhigh e max, enquanto o GPT-6 Sol também suporta none. Remova qualquer configuração explícita de none e escolha um esforço permitido. Aplicações que usam ferramentas também precisam de Responses API: o Chat Completions do GPT-6.1 Sol não suporta chamadas de ferramentas, enquanto o Chat Completions do GPT-6 Sol suporta chamadas de função apenas com none. As colunas oficiais do modelo na tabela de especificações documentam essas restrições de endpoint.
As equipes devem retestar fluxos sensíveis à latência, chamadas de ferramentas, cache de prompt, comportamento de longo contexto e qualquer lógica que envie explicitamente reasoning.effort="none".
Este exemplo mira diretamente a OpenAI usando OPENAI_API_KEY; não é um exemplo verificado de endpoint da CometAPI. Mantenha sua rota GPT-6 Sol disponível durante um rollout escalonado, registre sucesso de tarefa e latência p95 e faça rollback se os critérios de aceitação da sua aplicação não forem atendidos.
Quais cargas de trabalho do GPT-6.1 Sol mais se beneficiam da atualização?
| Carga de trabalho | Vantagem do GPT-6.1 Sol |
|---|---|
| Agentes de codificação | Maior desempenho no DeepSWE |
| Depuração em escala de repo | Melhor engenharia de software de longo horizonte |
| Agentes de navegador/PC | +7 pontos no OSWorld 2.0 |
| Automação empresarial | Maior desempenho no AutomationBench |
| Agentes com contexto repetido | Entrada em cache 50% mais barata |
| Análise complexa de PDFs | Desempenho em documentos profissionais próximo ao Astra |
| Fluxos científicos | Mais de 2x a pontuação do GPT-6 Sol na avaliação Terminal-Bench Science da OpenAI |
| Fluxos sensíveis a fatos | Menor taxa de erro factual em prompts difíceis |
| Agentes intensivos em ferramentas | Melhor comportamento quando ferramentas falham |
O GPT-6 Sol permanece útil onde integrações existentes já são estáveis ou onde desenvolvedores precisam especificamente da configuração none de raciocínio. Para novas implantações centradas em agentes, codificação, uso de computador ou fluxos de trabalho com contexto repetido, o GPT-6.1 Sol muda a equação de custo-desempenho sem mudar o preço normal de tokens de entrada/saída.
Como a CometAPI pode ajudar você a atualizar do GPT-6 Sol para o GPT-6.1 Sol?
Para desenvolvedores que já usam a API GPT-6 Sol na CometAPI, atualizar para o GPT-6.1 Sol pode ser tratado como uma migração relativamente pequena, e não uma reescrita completa da integração.
O GPT-6.1 Sol já está disponível por meio da CometAPI com o identificador de modelo gpt-6.1-sol. A CometAPI atualmente mostra um preço inicial de entrada em contexto curto de $1.60 por milhão de tokens, comparado à tarifa oficial de $2.00 da OpenAI, enquanto o preço de saída começa em $8.00 por milhão de tokens. Isso mantém o modelo Sol mais novo na mesma estrutura de preços com desconto do GPT-6 Sol, ao mesmo tempo em que dá aos desenvolvedores acesso ao seu desempenho mais forte em codificação, agentes e uso de computador.
Como a CometAPI fornece uma interface compatível com a OpenAI, aplicações existentes do GPT-6 Sol geralmente podem manter a mesma estrutura de SDK e fluxo de solicitações ao trocar o ID do modelo para gpt-6.1-sol. A CometAPI também oferece ferramentas para comparar modelos, testar prompts, estimar custos de carga de trabalho e inspecionar o comportamento de migração antes do rollout em produção.
Um processo de atualização mais seguro é executar primeiro os mesmos prompts representativos contra GPT-6 Sol e GPT-6.1 Sol, e então comparar qualidade de saída, latência, comportamento de ferramentas e custo total. Isso é especialmente importante para aplicações que dependem de configurações de raciocínio, saídas estruturadas, chamadas de ferramentas ou agentes de longa duração, porque compatibilidade de modelo não garante comportamento idêntico em toda carga de trabalho.
Para equipes que executam cargas com contexto repetido ou pesadas em agentes, a rota mais nova também pode melhorar a economia. A CometAPI atualmente precifica leituras de cache em contexto curto do GPT-6.1 Sol em $0.08 por milhão de tokens, contra $0.10 oficiais da OpenAI, enquanto as tarifas de entrada e saída em contexto curto estão 20% abaixo do preço oficial.
Na prática, a CometAPI pode tornar a transição GPT-6 Sol → GPT-6.1 Sol um processo em três etapas:
- Substitua
gpt-6-solporgpt-6.1-sol. - Faça benchmark dos mesmos prompts de produção e fluxos de trabalho de agentes antes de mudar o tráfego.
- Migre gradualmente as cargas quando qualidade de saída, comportamento de ferramentas, latência e custo atenderem aos seus requisitos.
Essa abordagem permite adotar o GPT-6.1 Sol sem reconstruir seu aplicativo em torno de uma nova pilha de API, ao mesmo tempo em que valida as diferenças de comportamento introduzidas pelo modelo mais novo.
Conclusão
O GPT-6 Sol não está tecnicamente obsoleto. Ele mantém a mesma janela de contexto de 1,05M, teto de saída de 128K, saídas estruturadas, entrada de imagem e preços Standard de $2/$10. Sua opção none de raciocínio também pode ser relevante para integrações existentes. A decisão de atualização deve se basear em resultados de tarefa mensurados e compatibilidade, não apenas no número da versão.
No entanto, a documentação do GPT-6 Sol da OpenAI agora aponta desenvolvedores para o GPT-6.1 Sol como o modelo Sol mais novo.
Para a maioria das cargas de trabalho complexas, a questão-chave não é se o GPT-6.1 Sol tem uma janela de contexto maior ou uma tarifa de token mais alta — não tem. A questão é se maior sucesso de tarefa, leituras de cache mais baratas, factualidade aprimorada e comportamento de agente mais robusto justificam trocar o identificador do modelo e retestar a carga de trabalho.
FAQ
Como migrar do GPT-6 Sol para o GPT-6.1 Sol com chamadas de ferramentas?
Não. Primeiro audite o endpoint e os campos da solicitação, depois mova o loop de ferramentas para a Responses API e teste o parsing das chamadas de ferramentas, validação de argumentos, novas tentativas e tratamento de erros. Rode um canário em tarefas representativas antes de aumentar o tráfego; uma solicitação apenas de texto bem-sucedida não verifica um loop de ferramentas funcional.
O GPT-6.1 Sol é mais barato em cargas reais?
Registre tokens de entrada em cache e não em cache, gravações de cache, tokens de raciocínio e saída, modo de processamento e encargos de ferramentas. Compare o custo por tarefa aceita em vez do preço de token em cache isoladamente. Prefixos estáveis ajudam apenas quando as solicitações realmente acertam o cache, e loops de ferramentas mais longos ou tentativas com falha podem compensar as economias de cache.
Como testar o GPT-6.1 Sol antes de trocar do GPT-6 Sol?
Use um conjunto fixo de tarefas semelhantes às de produção e registre conclusão bem-sucedida, correções factuais, chamadas de ferramentas inválidas, latência p50/p95 e custo total. Defina limites aceitáveis antes de testar. Mantenha um caminho de rollback de roteamento de modelo e expanda o tráfego apenas depois que a nova configuração atender a esses limites.
Como testar o GPT-6.1 Sol com PDFs?
Construa um pequeno corpus com tabelas densas, rodapés, gráficos e páginas escaneadas representativas do fluxo de trabalho pretendido. Faça perguntas com respostas verificáveis e exija evidências de página ou tabela. Pontue separadamente precisão de cálculos, avisos ausentes e respostas sem suporte; mantenha revisão humana para saídas cujos erros tenham consequências materiais.