
Executar o Qwen3.8-Max localmente agora é possível, mas a expressão “Qwen 3.8 Max localmente” requer uma importante ressalva. O produto Max hospedado pela Alibaba e o checkpoint baixável são estreitamente relacionados, porém não são produtos idênticos.
O Qwen lançou primeiro o serviço Max hospedado no início de agosto de 2026 e disponibilizou o Qwen3.8-2.4T-A95B como pesos abertos em 12 de agosto de 2026. Esse checkpoint é o modelo que você de fato implanta em sua própria infraestrutura.
Este não é um tutorial normal de Ollama em um PC gamer. O checkpoint não quantizado é um modelo Mixture-of-Experts com 2,4 trilhões de parâmetros, e a receita atual do vLLM dimensiona seus pesos em BF16 em 4,45 TiB. Mesmo variantes orientadas a produção em ponto flutuante de 4 bits ainda ocupam aproximadamente 1,3–1,5 TiB de pesos.
Resposta rápida: autohospedagem completa de classe Qwen 3.8 Max é uma implantação de datacenter. Um ponto de partida prático em produção é um checkpoint em FP4 em 8× GPUs B300 ou 8× MI355X; implantações em H200 precisam de mais GPUs. Para uma estação de trabalho normal, use Qwen3.8-27B.
Qwen 3.8 Max vs. o Modelo Aberto que Você de Fato Implanta
O checkpoint baixável Qwen3.8-2.4T-A95B é oficialmente descrito como um modelo de linguagem causal com 2,4T de parâmetros, com cerca de 95B de parâmetros ativados por token. O serviço Max hospedado adiciona capacidades na camada de produto que não estão presentes no checkpoint aberto atual.
| Especificação | Serviço hospedado Qwen3.8-Max | Checkpoint aberto Qwen3.8-2.4T-A95B |
|---|---|---|
| Parâmetros totais | 2,4T | 2,4T |
| Parâmetros ativos | ~95B | ~95B |
| Arquitetura | MoE esparso | MoE esparso |
| Entrada | Texto, imagem, vídeo | Texto |
| Contexto | 1M de contexto gerenciado | 262.144 nativo; extensível até ~1,01M |
| Comportamento de pensamento | Pensamento gerenciado / opções sem pensamento | Pensamento obrigatório; esforço de raciocínio configurável |
| Ferramentas integradas | Disponíveis no serviço gerenciado | Aplicação deve fornecer ferramentas |
| Autohospedagem | Sem gestão de pesos | Sim; checkpoint aberto |
O produto hospedado expõe entrada de texto, imagem e vídeo com um contexto de 1.000.000 tokens. Já o checkpoint aberto é apenas texto e possui um contexto nativo de 262.144 tokens. Essa diferença é relevante se sua aplicação depende de entrada multimodal ou de ferramentas integradas gerenciadas.
Arquitetura e Especificações do Qwen 3.8
A CometAPI já cobre o histórico do modelo em What is Qwen3.8 Max, então este guia de implantação mantém a discussão de arquitetura focada nos detalhes que afetam memória, paralelismo e serving.
| Especificação relevante para implantação | Qwen3.8-2.4T-A95B |
|---|---|
| Parâmetros totais / ativados | 2,4T / ~95B por token |
| Layout de camadas | 92 camadas: 69 Gated DeltaNet + 23 full attention |
| Roteamento MoE | 512 experts roteados; 10 roteados + 1 compartilhado ativos |
| Heads de full attention | 64 query / 4 key-value heads |
| Contexto nativo | 262.144 tokens |
| Contexto estendido | Até aproximadamente 1.010.000 tokens |
| Multi-Token Prediction | Suportado |
| Modalidade do checkpoint aberto | Apenas texto |

Arquitetura híbrida oficial do Qwen usada no guia de implantação do Qwen3.8 no SGLang.
Não interprete “95B de parâmetros ativos” como um footprint de memória de um modelo de 95B. A ativação esparsa reduz o compute por token, mas o sistema de serving ainda precisa de acesso ao conjunto completo de pesos dos experts.
Instantâneo de Benchmarks do Qwen 3.8 Max
Como a visão geral existente do Qwen3.8 Max na CometAPI já discute benchmarks em detalhes, este artigo utiliza apenas um subconjunto relevante para implantação extraído da tabela de benchmarks do card oficial do modelo Qwen.
| Benchmark | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (máx) |
|---|---|---|---|
| Terminal Bench 2.1 | 86,6 | 74,5 | 88,8 |
| SWE-bench Pro | 67,7 | 60,6 | 64,6 |
| PaperBench | 93,0 | 64,8 | 90,5 |
| FrontierSWE | 73,5 | 40,7 | — |
| CoWorkBench | 74,8 | 64,6 | 71,5 |
| GPQA Diamond | 92,6 | 92,4 | 94,1 |
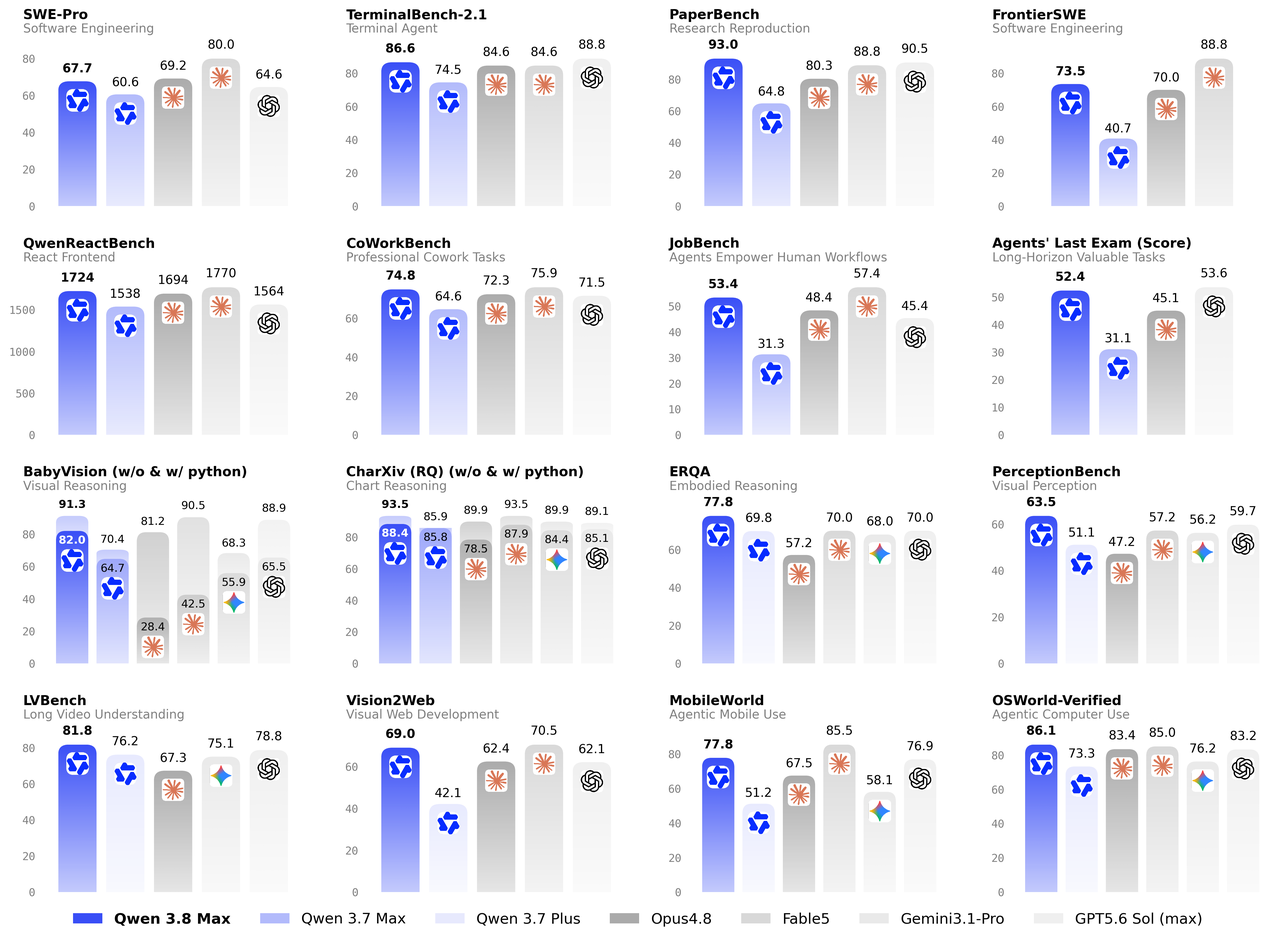
Gráfico oficial de desempenho do Qwen3.8 publicado pela equipe Qwen.
Os maiores ganhos relatados em relação ao Qwen3.7-Max neste subconjunto são no PaperBench e no FrontierSWE. O Qwen3.8-Max também supera o GPT-5.6 Sol no SWE-bench Pro e no PaperBench, enquanto o GPT-5.6 Sol permanece à frente no Terminal Bench 2.1. Para decisões de implantação, trate esses resultados como contexto de capacidade; as medições de memória e throughput de serving abaixo são mais relevantes operacionalmente.
Tabelas de benchmark não são rankings universais. Harnesses, timeouts, limites de contexto, acesso a ferramentas e quantização podem alterar os resultados. Faça benchmark exatamente do checkpoint, precisão, engine de serving e distribuição de prompts que você planeja usar.
Que Hardware o Qwen3.8 Precisa para Implantação Local?
Requisitos de GPU para o Qwen3.8-2.4T-A95B
Esta é a questão-chave de implantação. A receita atual do vLLM para Qwen3.8 publica footprints de checkpoint e contagens realistas de GPUs com folga de runtime, o que é mais útil do que estimar VRAM apenas a partir da contagem de parâmetros.
| Precisão | Footprint dos pesos | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Melhor ajuste |
|---|---|---|---|---|---|
| BF16 | 4,45 TiB | 24 GPUs | 24 GPUs | 48 GPUs | Fidelidade máxima / pesquisa |
| FP8 | 2,27 TiB | 16 GPUs | 16 GPUs | 32 GPUs | Produção de alta fidelidade |
| MXFP4 | 1,45 TiB | — | 8 GPUs | 16 GPUs | Implantação prática em AMD |
| NVFP4 W4A4 | 1,32 TiB | 8 GPUs | — | 16 GPUs | Implantação prática em NVIDIA |
Para a maioria das organizações que realmente precisam de Qwen3.8 autohospedado, FP4 é o ponto de partida prático. A configuração de destaque em NVIDIA é NVFP4 W4A4 em 8× B300; a rota correspondente em AMD é MXFP4 em 8× MI355X.
Um servidor com 8× H200 não é suficiente para essas implantações recomendadas do modelo completo. A receita oficial dimensiona a H200 em 16 GPUs para FP4, 32 para FP8 e 48 para BF16.
Requisitos de VRAM para o Qwen3.8-27B
Qwen3.8-27B é a alternativa prática para classe de estação de trabalho. A memória bruta de pesos é aproximadamente 54 GB em BF16, 27 GB em FP8 e 13,5 GB em precisão de 4 bits. A sobrecarga de runtime e o KV cache aumentam a exigência real, especialmente em comprimentos longos de contexto.
| Precisão | Memória aproximada dos pesos | Orientação prática de implantação |
|---|---|---|
| BF16 | ~54 GB | Use uma GPU de 64–80 GB, dependendo do contexto e da sobrecarga de serving. |
| FP8 / INT8 | ~27 GB | Uma GPU de 40–48 GB fornece mais folga prática de runtime. |
| 4 bits | ~13,5 GB | Uma GPU de consumidor de 20–24 GB pode ser viável em contextos moderados. |
Esses valores são estimativas de planejamento derivadas da contagem de parâmetros. Confirme o checkpoint exato, formato de quantização, engine de serving, comprimento de contexto e configurações de KV cache antes de dimensionar o hardware de produção.
O Qwen3.8 Pode Rodar em GPUs de Consumidor?
O modelo completo Qwen3.8-2.4T-A95B não é prático em GPUs comuns de consumidor, mesmo com quantização agressiva. Um projeto da comunidade demonstrou uma build UD-Q1_0 agressivamente comprimida de 397 GB em quatro sistemas DGX Spark, mas essa rota é uma quantização extrema experimental em vez da linha de base para serving sensível à qualidade.
Para uma estação de trabalho ou home lab, o modelo mais apropriado é o Qwen3.8-27B, cujos pesos abertos foram lançados em 14 de agosto de 2026. O modelo é ordens de magnitude mais fácil de hospedar e é a opção correta se “local” significa uma única estação de trabalho e não um cluster de GPUs.
Antes de Instalar o Qwen 3.8 Max
Planeje a infraestrutura antes de rodar um comando de instalação. Você precisa de Linux, uma stack de aceleradores compatível, armazenamento local ou compartilhado suficiente para o checkpoint, interconexões de GPU de alta largura de banda e—ao cruzar nós—uma rede desenhada para inferência distribuída. A receita do vLLM atualmente recomenda vLLM nightly e Transformers 5.4.0 ou mais recente.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
Como Implantar Qwen 3.8 FP8 com vLLM
FP8 é uma escolha sensata quando você quer um checkpoint fornecido pelo Qwen e pode arcar com infraestrutura multi-nó. O checkpoint oficial é Qwen/Qwen3.8-2.4T-A95B-FP8.
Para uma implantação B300-class de dois nós e 16 GPUs, execute o nó principal com:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Não copie o exemplo de 16 GPUs em servidores H200 sem redimensionar a topologia. A mesma variante FP8 está atualmente dimensionada em 32× H200 na receita do vLLM.
Como Rodar o Qwen 3.8 em um Servidor Único com 8× B300
Para NVIDIA Blackwell, a configuração mais prática de modelo completo é NVFP4. O vLLM atualmente valida NVFP4 W4A4 com paralelismo de tensores em oito GPUs B300.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
A build NVFP4 da Inferact é um checkpoint quantizado em vez do artefato Qwen BF16 original. Valide a qualidade do modelo no seu próprio conjunto de aceitação antes de tratá-lo como substituto drop-in de BF16 ou FP8.
Como Implantar Qwen 3.8 com SGLang
O SGLang adicionou suporte Day-0 para Qwen3.8 em 12 de agosto e é especialmente atrativo para serving de alta vazão, cache de prefixo, paralelismo de experts, decodificação especulativa e desagregação de prefill/decode.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
O SGLang reporta 346 tokens de saída/s em batch size 1 em TP8 B300 com MTP, e vazões agregadas substancialmente maiores em layouts de serving desagregados. Trate esses números como medições da stack de serving, não como benchmarks de qualidade do modelo.
Teste o Endpoint Local Compatível com OpenAI
Tanto o vLLM quanto o SGLang expõem APIs compatíveis com OpenAI, o que torna a integração de aplicações direta.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
O card oficial do modelo recomenda temperature=1.0, top_p=0,95 e top_k=20 como parâmetros de amostragem de base. Para trabalho agentic, deixe orçamento de saída suficiente para raciocínio em vez de dimensionar max_tokens apenas para a resposta visível final.
Habilite a Janela de Contexto de 1M
O checkpoint aberto Qwen3.8-2.4T-A95B tem um contexto nativo de 262.144 tokens e pode ser estendido para cerca de 1,01M. A receita do vLLM documenta o seguinte padrão:
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
Não defina 1M como padrão apenas porque é suportado. Máximos de contexto maiores reservam mais capacidade de cache e podem reduzir fortemente a concorrência. Dimensione --max-model-len para a carga real.
Como Melhorar a Performance de Inferência do Qwen3.8?
Use MTP-3 para Reduzir Latência de Usuário Único
Qwen3.8 inclui Multi-Token Prediction. Nas medições publicadas do vLLM, MTP-3 move a saída por usuário de 130 para 307 tok/s em FP8 TP16 e de 133 para 304 tok/s em NVFP4 TP8.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
Use fastsafetensors para Inicialização Mais Rápida
Para modelos de escala terabyte, o tempo de startup importa. Em uma medição do vLLM, o carregamento de pesos caiu de 545 s para 306 s com fastsafetensors e carregamento lazy.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Use Expert Parallelism para Aumentar a Vazão Concorrente
Para alta concorrência, o Qwen3.8 se beneficia de layouts com paralelismo de experts porque possui 512 experts roteados. O vLLM reporta até 3.200 tok/s/GPU totais para FP8 EP e até 4.300 tok/s/GPU totais para uma configuração NVFP4 DEP16 otimizada.
Defina --max-model-len para Equilibrar VRAM e Concorrência
Defina --max-model-len para a sequência mais longa que a carga realmente exige. Um valor maior reserva mais capacidade de KV cache, aumenta a pressão de memória e pode reduzir o número de requisições concorrentes mesmo quando os pesos do modelo já cabem.
Comece com um percentil representativo de produção em vez do máximo de contexto divulgado do modelo. Faça testes de carga no limite escolhido com a mesma precisão, padrão de batching e engine de serving usados em produção, depois aumente apenas quando requisições reais precisarem de mais contexto.
Qwen 3.8 Max: Implantação Local vs. API
Pesos abertos não tornam automaticamente a inferência local econômica. A decisão correta depende de utilização, residência de dados, equipe, metas de disponibilidade e se você realmente precisa dos recursos multimodais do modelo gerenciado.
| Dimensão | Qwen3.8-2.4T-A95B autohospedado | Qwen3.8-Max via CometAPI |
|---|---|---|
| Infraestrutura | Servidor multi-GPU ou cluster | Sem infraestrutura de GPU |
| Modalidade de entrada | Texto | Texto, imagem, vídeo |
| Contexto | 262K nativo; ~1,01M estendido | 1M gerenciado |
| Controle de dados | Máximo | API em nuvem |
| Operações | Você cuida de monitoramento, upgrades e HA | Gerenciado pelo provedor |
| Melhor ajuste | Residência de dados, utilização sustentada, equipe de infraestrutura | A maioria das equipes de aplicação e cargas variáveis |
Se você já possui aceleradores adequados e tem utilização consistentemente alta, a autohospedagem pode ser justificada. Se você compraria um cluster apenas para este modelo, o Qwen3.8-Max na CometAPI geralmente é a rota de menor fricção. O guia de API existente cobre a integração hospedada, enquanto o guia de preços cobre modelagem de custos; portanto, este artigo permanece focado na implantação local.
Problemas Comuns na Implantação Local do Qwen 3.8
O Servidor Fica sem Memória de GPU Durante a Inicialização
Primeiro reduza --max-model-len se o cache for o problema. Se os próprios pesos não cabem, a redução de contexto não resolverá a causa raiz; migre para um checkpoint validado de menor precisão ou adicione GPUs.
Falha no Paralelismo de Tensores com Tamanho Inválido
Qwen3.8 tem 64 heads de attention em suas camadas de full attention, então o vLLM exige que TP divida 64. Tamanhos diretos de TP são 1, 2, 4, 8, 16 e 32. VRAM agregada bruta, portanto, não é suficiente para escolher uma topologia.
O Servidor Demora para Iniciar
Carregar de um a vários terabytes de pesos mais JIT de kernels pode levar minutos. Aumente VLLM_ENGINE_READY_TIMEOUT_S e sonde um endpoint real de inferência em vez de assumir uma janela curta de startup.
O Modelo Local Não Consegue Processar uma Imagem
Isso é esperado. O checkpoint aberto Qwen3.8-2.4T-A95B é apenas texto. Essa limitação é específica ao Qwen3.8-2.4T-A95B. O Qwen3.8-27B suporta entrada visual quando seus arquivos separados de projeção de visão são carregados.
1M de Contexto Reduz Fortemente o Throughput
Reduza --max-model-len para a sequência mais longa que sua carga realmente precisa. A maior janela de contexto suportada não é necessariamente a melhor configuração de produção; escolha um limite de contexto que equilibre requisitos de carga, uso de KV cache e concorrência.
O Ollama ou o LM Studio Podem Rodar o Qwen 3.8 Max?
O ecossistema pode empacotar pesos Qwen3.8 fortemente quantizados para inferência estilo llama.cpp, mas isso não deve ser confundido com um fluxo normal de desktop com Ollama. Uma build quantizada que ocupa centenas de gigabytes ainda requer centenas de gigabytes de memória acessível e envolve trade-offs significativos em qualidade e desempenho.
Para desenvolvimento local comum, Qwen3.8-27B é o alvo apropriado. O modelo completo de 2,4T deve ser tratado como um modelo para servidor/cluster mesmo quando quantizações extremas da comunidade o tornam tecnicamente inicializável em hardware incomum.
Qual Método de Implantação Você Deve Escolher?
Para NVIDIA Blackwell, uma implantação NVFP4 em 8× B300 é atualmente o ponto de partida mais simples para o modelo completo. Para AMD, 8× MI355X com MXFP4 é a configuração prática correspondente. Use FP8 quando você prioriza a proveniência do checkpoint e qualidade em vez do tamanho da infraestrutura, e BF16 apenas quando a fidelidade máxima justificar requisitos de memória em escala multi-rack.
Para uma estação de trabalho, use Qwen3.8-27B. Para equipes de aplicação que precisam das capacidades do Max sem operações de cluster de GPUs, use o modelo Qwen3.8-Max hospedado na CometAPI.
Conclusão
O Qwen3.8-Max cruzou uma fronteira importante desde seu lançamento inicial via API: a família Qwen de classe Max agora tem um checkpoint aberto de 2,4T que as organizações podem operar inteiramente em sua própria infraestrutura.
Mas pesos abertos não significam hardware de consumidor. O footprint de 4,45 TiB em BF16, o checkpoint de 2,27 TiB em FP8 e as variantes de 1,3–1,5 TiB em FP4 tornam o Qwen3.8-2.4T-A95B um dos modelos abertos mais intensivos em infraestrutura disponíveis. O lado prático é que vLLM e SGLang já suportam a arquitetura, e FP4 torna viável uma implantação de um nó único com 8× B300 ou 8× MI355X.
Autohospede quando controle de dados, utilização sustentada e propriedade de infraestrutura justificarem o cluster. Caso contrário, use a API Max gerenciada—ou Qwen3.8-27B quando o que você realmente quer é um modelo Qwen forte em uma única estação de trabalho.