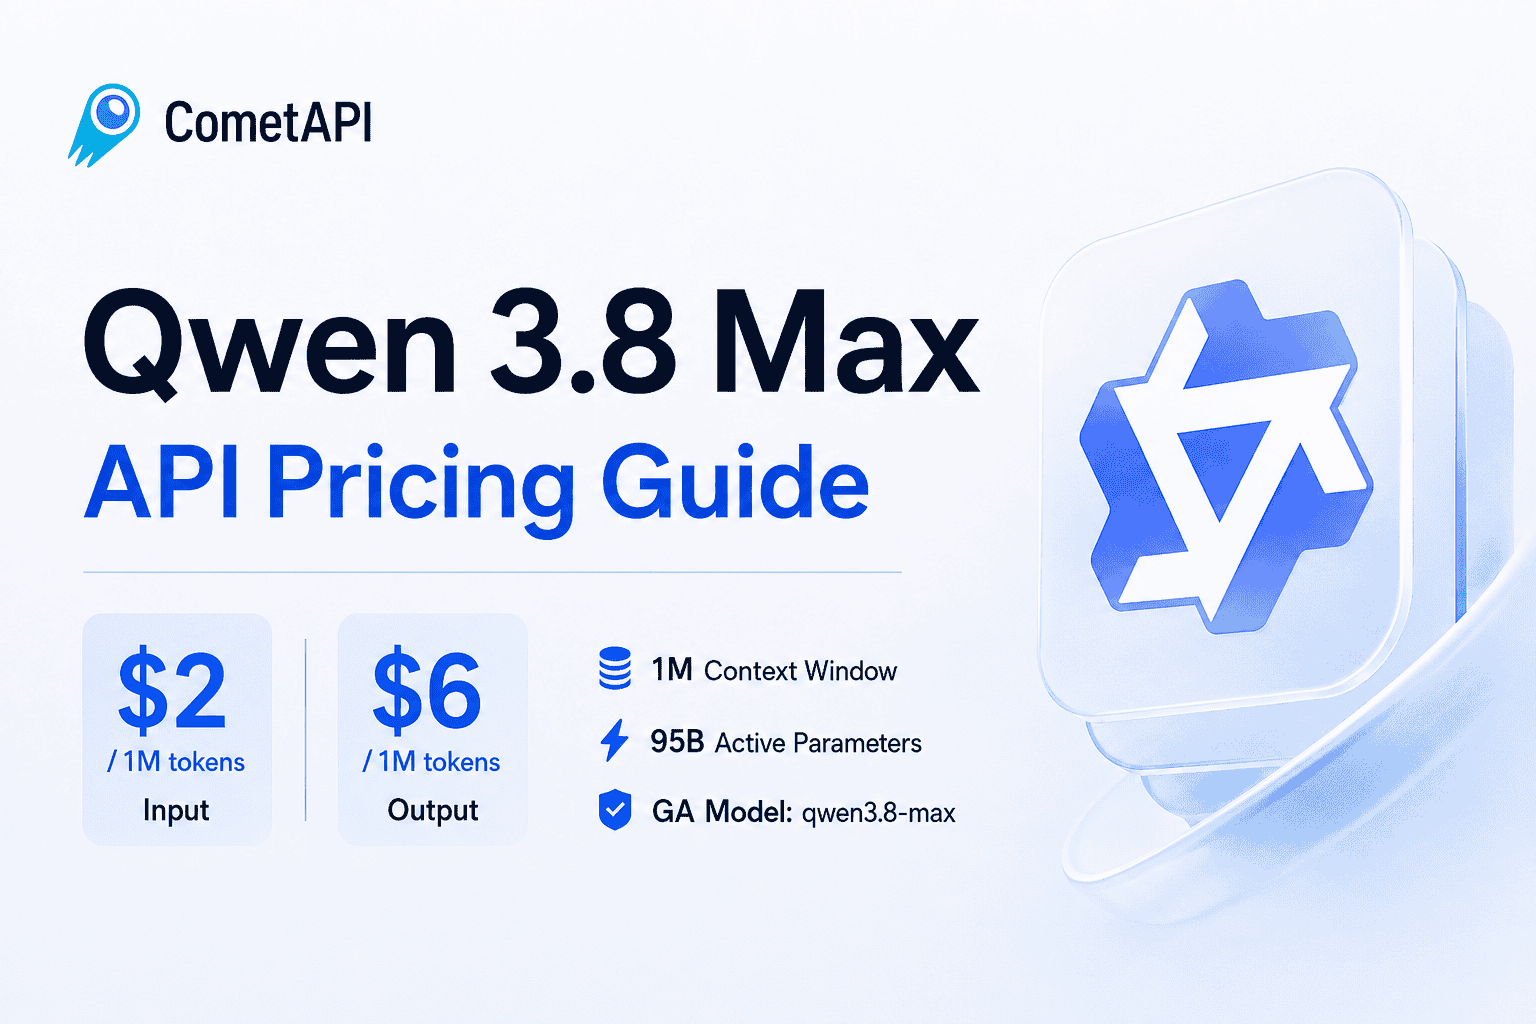
Preços da API Qwen 3.8 Max: $2 entrada, $6 saída, 1M de contexto
- Preço base do Qwen 3.8 Max
- Entrada: $2 por 1M tokens ($0,002 por 1k).
- Saída: $6 por 1M tokens ($0,006 por 1k).
- Cache: como pensar custos e economias
- Tipos comuns:
- Cache do provedor (prompt/prefix caching): reutiliza prefixos/trechos estáticos do prompt/histórico.
- Cache no cliente/aplicação: deduplicação de prompts, memoização de respostas, RAG com store de embeddings.
- Cobrança (varia por provedor; confirme na documentação do Qwen/DashScope):
- Em geral no mercado, gravação do cache é cobrada à tarifa normal de entrada; leituras podem ser cobradas entre 0% e ~25% da tarifa de entrada. Trate os números abaixo como exemplo hipotético para planejamento.
- Boas práticas para maximizar economia:
- Separar prefixos estáveis (instruções, guias de estilo, schema de funções) do conteúdo variável.
- Versionar prompts e configurar TTL de cache para evitar invalidações acidentais.
- Manter prefixos concisos; comprimir descrições longas; evitar JSON/schema verboso.
- Em RAG, use cache de resultados de retrieval e de respostas para perguntas repetidas.
- Exemplo de cálculo (hipotético):
- Prefixo estático: 800 tokens; parte variável por chamada: 200 tokens; saída média: 200 tokens; 1.000 chamadas.
- Sem cache: por chamada = 1.000 in ($0,002) + 200 out ($0,0012) = $0,0032; 1.000 chamadas = $3,20.
- Com cache do provedor (leitura a 25% do preço de entrada):
- 1ª chamada (gravação do cache): 800 in ($0,0016) + 200 in ($0,0004) + 200 out ($0,0012) = $0,0032.
- Demais 999 chamadas: leitura cache 800 in a 25% ($0,0004) + 200 in ($0,0004) + 200 out ($0,0012) = $0,002 cada → ~$1,998.
- Total ≈ $2,00 (economia ~37,5%). Ajuste conforme a política real de cache.
- Ferramentas (function calling, tool use) e custos
- Em geral, não há tarifa separada por “ativar” ferramentas; o custo vem dos tokens adicionais:
- Schema/descrição de função enviado ao modelo (entrada).
- Mensagens de chamada de função geradas (saída).
- Respostas das ferramentas devolvidas ao modelo (entrada).
- APIs externas (busca, bancos, scraping, execução de código) têm cobrança própria fora do modelo.
- Otimização de custo:
- Mantenha schemas compactos (nomes curtos, descrições objetivas).
- Evite listar enumerações longas no prompt; valide no runtime.
- Trunque/compacte payloads de retorno das ferramentas antes de reenviá-los ao modelo.
- Exemplo de sobrecarga de tokens:
- Schema + retorno de tool adicionam 2.000 tokens de entrada → 2.000 × $0,002/1k = $0,004.
- Mensagem de chamada de função com 120 tokens de saída → 120 × $0,006/1k ≈ $0,00072.
- Total extra ≈ $0,00472 nessa rodada.
- Exemplos numéricos de custo (com as tarifas fornecidas)
- Chat curto: 700 in + 300 out → 0,7k×$0,002 + 0,3k×$0,006 = $0,0014 + $0,0018 = $0,0032 por chamada.
- RAG moderado: 4.000 in + 800 out → 4k×$0,002 + 0,8k×$0,006 = $0,008 + $0,0048 = $0,0128 por chamada.
- Batch com alto reaproveitamento (hipotético, como no cenário de cache acima): 1.000 chamadas idênticas → sem cache ~$3,20; com cache (25% leitura) ≈ $2,00.
- Limites: pontos a verificar e como contornar
- Janela de contexto (máx. tokens por requisição): verifique o limite do Qwen 3.8 Max; ajuste truncamento e sumarização de histórico.
- Máx. de tokens de saída: defina max_output_tokens para controlar custo e evitar cortes abruptos.
- Rate limits (RPM/TPM) e concorrência: projete filas/backoff; use lote e streaming quando fizer sentido.
- Tamanhos de payload e anexos multimodais: entradas de imagem/áudio podem ter regras/pricing próprios; valide antes de enviar grandes anexos ao modelo.
- Comprimento de ferramentas (schema/retornos): pode “estourar” contexto; normalize e compacte.
- Práticas de mitigação:
- Janela deslizante do chat com sumarização.
- RAG com top_k enxuto e respostas citadas.
- Checagens de comprimento no cliente e abort/continue automático.
- Migração do Qwen 3.7 para 3.8: guia rápido
- Compatibilidade de API/SDK:
- Atualize nomes de modelo/endpoints e versões do SDK; verifique mudanças em parâmetros (p. ex., temperature, top_p, max_tokens).
- Confirme diferenças de tokenizer e contagem de tokens (impacta custo e limites).
- Comportamento de geração:
- Avalie aderência a JSON/“modo estruturado” e tool calling (formato dos argumentos, escaping).
- Revise prompts de sistema; modelos mais novos podem interpretar instruções com nuances diferentes.
- Ajuste temperaturas/penalidades para manter estilo e variação esperados.
- Ferramentas e agentes:
- Revalide schemas de função (tipos, campos obrigatórios, limites de tamanho).
- Teste mensagens de tool result longas; imponha truncamentos.
- Segurança e filtros:
- Compare saídas em categorias sensíveis; atualize políticas/“guardrails” conforme necessário.
- Desempenho e custo:
- Reexecute benchmarks com seus dados: latência, tokens médios in/out, taxa de erro de ferramenta.
- Monitore custos por rota; verifique se 3.8 mantém ou reduz tokens gerados vs 3.7.
- Confiabilidade e rollout:
- Testes de regressão com seeds/templatização para comparabilidade.
- Canary release + shadow traffic; fallback automático para 3.7 em casos críticos.
- Observabilidade: registre prompts/saídas (com redação), contadores de tokens e motivos de erro.
- Checklist final:
- Troca do nome do modelo aplicada.
- Limites ajustados (contexto, max_output_tokens).
- Prompts e schemas revisados/compactados.
- Alertas de custo e de latência configurados.
- Plano de rollback validado.
Observação
- Para cache e limites específicos do Qwen 3.8 Max, consulte a documentação oficial do provedor que você usa (p. ex., DashScope/Alibaba Cloud), pois políticas de cache, janelas de contexto e rate limits podem variar por região/versão.