Especificações Técnicas do GLM-5.3-Flash
| Especificação | GLM-5.3-Flash |
|---|---|
| Provedor | Z.ai (Zhipu AI) |
| Família do modelo | GLM-5 |
| Tipo de modelo | Modelo Mixture-of-Experts nativamente multimodal |
| Parâmetros totais | 320B |
| Parâmetros ativos | 18B |
| Arquitetura | Atenção híbrida esparsa + linear |
| Janela de contexto | 1,048,576 tokens (1M) |
| Saída máxima | 131,072 tokens |
| Modalidades de entrada | Texto, imagens, vídeo |
| Modalidade de saída | Texto |
| Raciocínio | Suportado |
| Visão | Suportado |
| Chamada de função | Suportado |
| Uso de ferramentas | Suportado |
| Pesquisa na web | Suportada por integrações de API suportadas |
| Pesos abertos | Sim |
| Licença | MIT |
| Lançamento | 26 de agosto de 2026 |
A Z.ai descreve o GLM-5.3-Flash como o primeiro modelo nativamente multimodal da família GLM-5. Ele contém 320B de parâmetros totais, mas ativa apenas 18B de parâmetros por etapa de inferência. O modelo introduz uma arquitetura híbrida que combina atenção esparsa e linear e usa mHC para melhorar a eficiência de escalonamento.
O que é o GLM-5.3-Flash?
O GLM-5.3-Flash é o membro orientado à eficiência da geração GLM-5 da Z.ai, projetado para combinar raciocínio de nível de fronteira e capacidades de codificação orientadas a agentes com custo de inferência substancialmente menor.
Sua distinção mais importante em relação a um modelo “Flash” convencional é que Flash não significa um modelo pequeno. O GLM-5.3-Flash contém 320B de parâmetros totais, mas sua arquitetura MoE ativa apenas 18B de parâmetros por token. Isso permite que a Z.ai busque uma computação de inferência muito menor, mantendo um grande pool de parâmetros para capacidade do modelo.
Ele também é o primeiro modelo GLM-5 com capacidade multimodal nativa. O modelo suporta entradas visuais além de texto e é posicionado para codificação, interação com navegador, compreensão de documentos, codificação visual e fluxos de trabalho orientados a agentes.
A Z.ai afirma que o GLM-5.3-Flash foi treinado a partir de um modelo base recém-treinado, em vez de ser uma versão comprimida simples do GLM-5.2. Seu treinamento usa um corpus de pré-treinamento multimodal de 30 trilhões de tokens, enquanto a arquitetura foi redesenhada em torno de capacidade e eficiência de inferência.
Principais Recursos do GLM-5.3-Flash
- MoE de 320B com 18B de parâmetros ativos: O GLM-5.3-Flash combina uma capacidade total de parâmetros muito grande com uma pegada de parâmetros ativos relativamente pequena, tornando o modelo substancialmente mais eficiente de servir do que um modelo denso de 320B.
- Compreensão multimodal nativa: Diferente dos modelos GLM-5 anteriores, o GLM-5.3-Flash processa entradas visuais de forma nativa. Seu model card fornece exemplos de compreensão de imagens e identifica o modelo como multimodal.
- Contexto de 1M de tokens: O modelo é projetado para aplicações de longo contexto envolvendo grandes repositórios, documentos extensos, longas trajetórias de agentes e fluxos de trabalho complexos de múltiplas etapas. Cloudflare e Vercel listam uma janela de contexto de 1,048,576 tokens.
- Atenção híbrida esparsa + linear: O GLM-5.3-Flash é o primeiro modelo GLM a combinar atenção esparsa e atenção linear. A Z.ai afirma que essa arquitetura reduz os custos de serviço em longo contexto enquanto preserva capacidades precisas de longo contexto.
- Codificação orientada a agentes e uso de ferramentas: O modelo é otimizado para engenharia de software, tarefas de terminal, interação com navegador e fluxos de trabalho dirigidos por ferramentas. Seu Terminal-Bench 2.1 reportado é 84.3.
- Implantação com pesos abertos: Os pesos sob licença MIT podem ser implantados com Transformers, vLLM, SGLang, TokenSpeed e KTransformers, oferecendo aos desenvolvedores opções para auto-hospedagem e otimização de inferência.
Desempenho em Benchmarks do GLM-5.3-Flash
O GLM-5.3-Flash apresenta um perfil particularmente forte em benchmarks de codificação e orientados a agentes.
| Benchmark | GLM-5.3-Flash | GLM-5.2 | Observações |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 81.0 | Terminal / codificação orientada a agentes |
| DeepSWE v1.1 | 63.4 | 46.2 | Engenharia de software |
| AutomationBench | 48.8 | 26.2 | Automação de uso de computador |
| Toolathlon-Verified | 78.4 | 59.9 | Capacidade de uso de ferramentas |
| NL2Repo-Bench | 56.3 | 48.9 | Codificação de linguagem natural para repositório |
| Agent's Last Exam | 26.3 | 20.4 | Raciocínio orientado a agentes |
| Humanity's Last Exam | 55.3 | — | Com ferramentas |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | Produtividade / trabalho do conhecimento |
| OfficeQA-Pro | 62.4 | — | Produtividade multimodal |
| CharXiv RQ | 89.4 | — | Raciocínio multimodal |
A seção de avaliação oficial no Hugging Face lista 84.3 no Terminal-Bench 2.1, 63.4 no DeepSWE e 55.3 no HLE. Os materiais de lançamento da Z.ai reportam resultados adicionais incluindo AutomationBench, Toolathlon, NL2Repo e GDPval.
A Independent Artificial Analysis atualmente atribui ao GLM-5.3-Flash um Índice de Inteligência de 57, colocando-o em #3 entre 108 modelos em seu conjunto de comparação atual.
Esses números ainda devem ser interpretados com ressalvas específicas de benchmark: vários resultados são reportados pelo fornecedor, os harnesses de avaliação diferem e pontuações de benchmark não devem ser tratadas como um ranking universal de qualidade de modelo.
GLM-5.3-Flash vs GLM-5.3 vs GLM-5.2
| Recurso | GLM-5.3-Flash | GLM-5.3 | GLM-5.2 |
|---|---|---|---|
| Geração do modelo | GLM-5 | GLM-5 | GLM-5 |
| Posicionamento | Modelo multimodal/agentic eficiente | Modelo de raciocínio geral de alto nível | Modelo de geração anterior de uso geral |
| Visão nativa | Sim | Não | Dependente do modelo |
| Parâmetros totais | 320B | Configuração principal maior | Modelo em larga escala |
| Parâmetros ativos | 18B | — | — |
| Contexto | 1M | Implantação na classe de 200K | Implantação na classe de 200K |
| Atenção esparsa/linear híbrida | Sim | Não | Não |
| Codificação orientada a agentes | Excelente | Excelente | Forte |
| Pesos abertos | Sim | Depende da implantação | Depende da implantação |
| Principal vantagem | Capacidade por unidade de computação de inferência | Máxima capacidade de raciocínio do GLM-5 | Geração GLM madura e de menor custo |
A principal distinção é que GLM-5.3-Flash não é simplesmente o GLM-5.3 em tamanho menor. A Z.ai afirma que ele parte de um modelo base recém-treinado e introduz uma arquitetura de atenção híbrida redesenhada, mHC e pré-treinamento multimodal.
GLM-5.3-Flash vs DeepSeek V4 Flash — Resumo da Comparação
| Dimensão | GLM-5.3-Flash (Z.ai / Zhipu) | DeepSeek V4 Flash (DeepSeek) | Vantagem |
|---|---|---|---|
| Data de lançamento | 26 de agosto de 2026 | Prévia em abril de 2026; checkpoint principal (0731) em 31 de julho de 2026 | — |
| Parâmetros totais / ativos | 320B / 18B | 284B / 13B | GLM ligeiramente maior |
| Janela de contexto | 1M tokens | 1M tokens | Empate |
| Saída máxima | ~131K tokens | Até 384K tokens | DeepSeek |
| Modalidades | Multimodal nativo (entrada de texto + imagem + vídeo) | Principalmente texto (variantes de visão experimentais disponíveis) | GLM |
| Destaques de arquitetura | Atenção híbrida esparsa + linear (~3× menos computação de atenção, ~4,4× menor cache de KV vs GLM-5.3 completo) | Compressed Sparse Attention (CSA) + Heavily Compressed Attention (HCA) | Cada um com pontos fortes |
| Licença | MIT (pesos no Hugging Face) | MIT (pesos disponíveis) | Empate |
| Preço padrão de API ($ / 1M tokens) | Entrada $0.15 / Saída $0.50 (entrada em cache ~$0.03) | Faixa comum $0.14–$0.44 entrada / $0.28–$1.32 saída (pico/fora de pico varia) | GLM mais barato |
| Preço promocional de lançamento | ~$0.075 entrada / $0.25 saída (tempo limitado, ~início de set. 2026) | Sem promoção equivalente | GLM |
| AA Intelligence Index | 57 (informado pelo fornecedor) | ~50 (medições independentes) | GLM |
| Terminal-Bench 2.1 | 84.3 | 82.7 | GLM |
| DeepSWE | 63.4 | 54.4 | GLM |
| SWE-bench Verified | Poucos dados independentes até o momento | ~79% (fortes resultados independentes) | DeepSeek |
| Principais pontos fortes | Preço menor, multimodal nativo, liderança em vários scores de agentes/codificação, longo contexto eficiente | Validação independente mais madura, excelente histórico em agentes de codificação, design de longo contexto altamente eficiente, ecossistema forte | — |
| Principais fraquezas | Lançamento mais recente (alguns scores ainda reportados pelo fornecedor); velocidade média | Suporte multimodal mais fraco; precificação efetiva mais alta em muitas rotas | — |
| Melhor para | Uso geral, workloads multimodais, projetos sensíveis a custo, capacidades de agentes equilibradas | Agentes de codificação puros, raciocínio de texto de longo contexto, cenários que exigem benchmarks independentes comprovados | — |
Resumo em uma frase:
No fim de agosto de 2026, o GLM-5.3-Flash lidera em preço, capacidade multimodal e vários benchmarks sobrepostos, oferecendo melhor valor geral. O DeepSeek V4 Flash continua sendo uma opção altamente confiável para agentes focados em codificação, graças à validação independente mais forte e à eficiência em longo contexto. Teste ambos nos seus workloads específicos antes de decidir.
Casos de Uso do GLM-5.3-Flash
1. Engenharia de software orientada a agentes
O GLM-5.3-Flash é particularmente adequado para agentes de codificação que precisam inspecionar repositórios, modificar múltiplos arquivos, executar comandos de terminal, rodar testes e iterar sobre implementações.
Sua pontuação de 84.3 no Terminal-Bench 2.1 e 63.4 no DeepSWE demonstram que engenharia de software é uma de suas áreas de aplicação mais fortes.
2. Codificação visual
Como o GLM-5.3-Flash é nativamente multimodal, desenvolvedores podem fornecer capturas de tela, diagramas e outras entradas visuais junto com instruções de codificação. Isso é útil para implementação de UI, depuração visual e fluxos de trabalho de design-para-código.
3. Análise de documentos de longo contexto
A janela de contexto de 1M tokens torna o modelo adequado para grandes conjuntos de documentação técnica, repositórios, relatórios longos e históricos de agentes em múltiplas etapas.
4. Agentes de navegador e uso de computador
As capacidades de uso de ferramentas e multimodais do modelo o tornam adequado para fluxos de trabalho envolvendo navegadores, interfaces gráficas e ferramentas externas.
5. Trabalho de conhecimento empresarial
O GLM-5.3-Flash pode processar grandes volumes de informações estruturadas e não estruturadas enquanto usa ferramentas para executar tarefas de múltiplas etapas, tornando-o adequado para análise de documentos, assistência à pesquisa e automação de fluxos de trabalho.
6. Infraestrutura de IA auto-hospedada
A licença MIT e os pesos publicamente disponíveis tornam o GLM-5.3-Flash atraente para organizações que exigem controle sobre implantação, processamento de dados e infraestrutura de inferência.
Parâmetros da API do GLM-5.3-Flash
| Parâmetro | Descrição |
|---|---|
| model | Identificador de modelo específico do provedor |
| messages | Entrada de conversa estruturada |
| prompt | Entrada de prompt única em APIs suportadas |
| max_tokens / max_completion_tokens | Limite de tokens de saída |
| temperature | Controla a aleatoriedade da amostragem |
| tools | Definições de ferramentas/funções |
| stream | Habilita saída em streaming |
| reasoning | Controla o esforço de raciocínio em gateways suportados |
| Image content | Suportado |
| Function calling | Suportado |
| Context | Até 1M tokens |
O Vercel AI Gateway atualmente documenta um máximo de 131,000 tokens de saída, com tokens de raciocínio contabilizados no limite de saída.
Como Usar a API do GLM-5.3-Flash no CometAPI
Etapa 1: Obter Acesso à API
Faça login no cometAPI. Se você ainda não é nosso usuário, registre-se primeiro. Acesse seu console do CometAPI. Obtenha a credencial de acesso (API key) da interface. Clique em “Add Token” no token da API no centro pessoal, obtenha a chave do token: sk-xxxxx e envie.
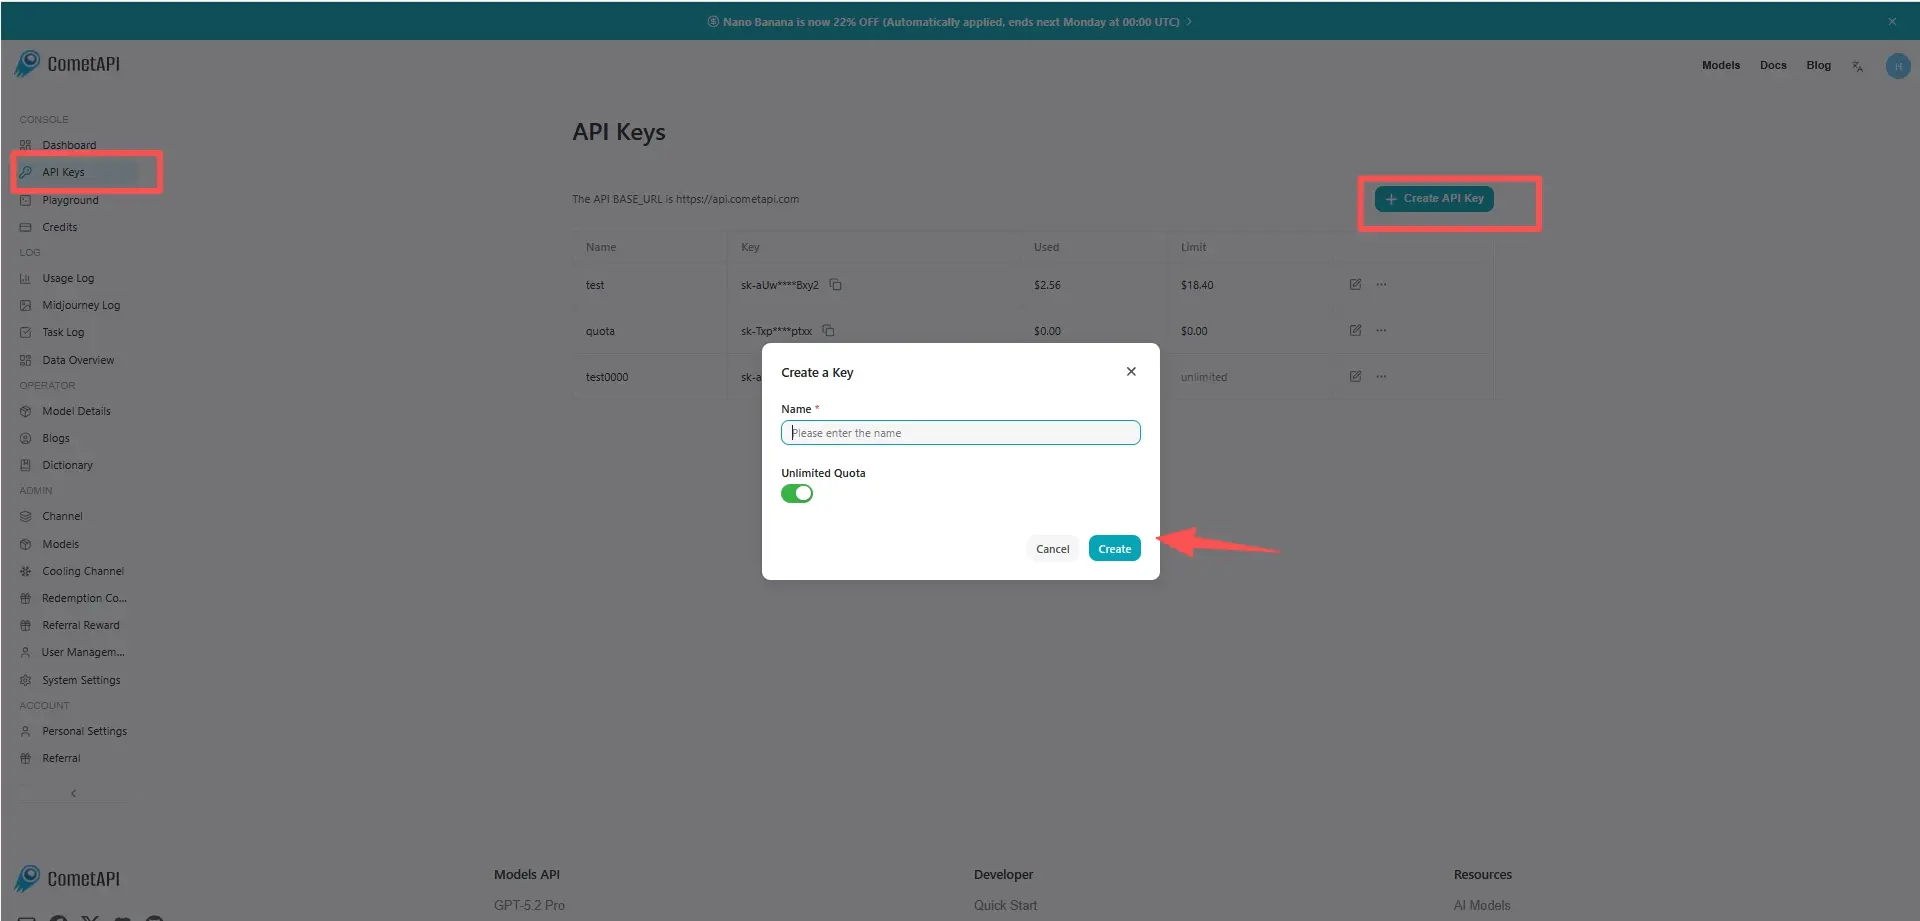
Etapa 2: Enviar Requisições para a API do GLM-5.3-Flash
Selecione o endpoint “GLM-5.3-Flash” para enviar a requisição à API e configure o corpo da requisição. O método e o corpo da requisição são obtidos na nossa documentação de API no site. Nosso site também fornece teste via Apifox para sua conveniência. Substitua <YOUR_API_KEY> pela sua chave real do CometAPI da sua conta.
Insira sua pergunta ou solicitação no campo content — é isso que o modelo responderá. Processe a resposta da API para obter a resposta gerada.
Etapa 3: Processar Respostas
A API retorna respostas candidatas estruturadas incluindo texto gerado, citações, metadados de segurança e saídas opcionais de ferramentas. Para requisições multimodais, o conteúdo da mensagem pode ser estruturado com entradas de texto e imagem quando o endpoint selecionado do CometAPI expõe a capacidade de visão do modelo.
O endpoint exato do CometAPI, os parâmetros suportados e a disponibilidade atual devem ser obtidos na documentação ao vivo da API do CometAPI em vez de inferidos da API nativa da Z.ai.
Para o CometAPI, a integração deve usar o ID do modelo mostrado no endpoint de modelo ao vivo do CometAPI, em vez de copiar automaticamente IDs específicos do provedor da Z.ai, Cloudflare ou Vercel.
Limitações do GLM-5.3-Flash
- Pegada de modelo grande: Embora apenas 18B de parâmetros estejam ativos, o modelo lançado contém aproximadamente 321B de parâmetros, tornando a auto-hospedagem substancialmente mais exigente do que implantar um modelo convencional de 7B–70B.
- A velocidade de inferência não é necessariamente “flash” em termos absolutos: A Artificial Analysis atualmente mede cerca de 50 tokens de saída/segundo em seu ambiente de comparação, colocando o modelo bem abaixo dos modelos pequenos mais rápidos.
- Contexto muito longo aumenta os requisitos de infraestrutura: Uma janela de contexto de 1M é útil, mas pode aumentar a memória e a complexidade de serviço.
- Desempenho em benchmarks varia por tarefa: O GLM-5.3-Flash é especialmente forte em benchmarks de codificação orientada a agentes e uso de ferramentas, mas nenhum benchmark isolado estabelece superioridade universal sobre modelos proprietários de fronteira.
- Saída multimodal é limitada: A capacidade multimodal nativa do modelo é principalmente do lado da entrada; sua saída padrão é texto em vez de imagens ou vídeo gerados.