Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
Como executar o MiniMax M3.1 Flash localmente: guia de GPU, vLLM e SGLang
Saiba como executar o MiniMax M3.1 Flash localmente. Explore sua arquitetura MoE de 428B/23B, requisitos de GPU, configuração com vLLM e SGLang, benchmarks e alternativas de API.
Deon GoodwinEquipe de pesquisa de modelos e API de IA
MiniMax M3.1 Flash leva IA de pesos abertos a fluxos de trabalho exigentes de código e agentes, mas executá-lo localmente exige hardware robusto. Sua arquitetura MoE de 428B parâmetros ativa apenas 23B parâmetros por token, reduzindo a computação sem eliminar a necessidade de armazenar o modelo completo. Desenvolvedores com sistemas multi-GPU compatíveis podem implantá-lo usando o vLLM ou o SGLang. Para quem quer evitar a gestão de infraestrutura, a API do MiniMax M3.1 Flash na CometAPI oferece uma forma mais simples de começar.
Principais pontos
O hardware é a maior barreira. As configurações publicadas do vLLM usam quatro GPUs Blackwell ou AMD MI355X compatíveis, ou oito GPUs H100/H200.
Revisado para maior clareza, atribuição de fontes e terminologia de API atual.
Contexto longo tem custo de memória. O modelo suporta até um milhão de tokens, mas os limites práticos de serviço dependem da memória de GPU disponível e da concorrência.
A implantação é específica do hardware. Use um engine de inferência, formato de quantização e configuração de acelerador compatíveis, em vez de um comando genérico de instalação.
Benchmarks são apenas um ponto de partida. Avalie acurácia em código, conclusão de tarefas de agente, latência e throughput nos seus próprios workloads.
Inferência local e hospedada atendem a necessidades diferentes. Autohospedagem oferece maior controle de infraestrutura, enquanto o acesso via API reduz a complexidade de setup e a manutenção.
O que é o MiniMax M3.1 Flash?
MiniMax M3.1 Flash aceita texto, imagens e vídeo e gera texto. Ele é projetado para fluxos de trabalho de programação, automação, interação com computador e segurança. Os pesos são distribuídos sob a MiniMax Community License. Antes de oferecer um serviço comercial, leia a licença fornecida com o checkpoint e verifique as condições aplicáveis ao seu uso.
Especificações do MiniMax M3.1 Flash
Especificação
MiniMax M3.1 Flash
Desenvolvedor
MiniMax
Família do modelo
MoE multimodal nativo
Parâmetros totais
Aproximadamente 428B
Parâmetros ativos
Aproximadamente 23B por token
Contexto máximo
1,048,576 tokens (capacidade do modelo)
Tipos de entrada
Texto, imagens e vídeo (dependente da rota)
Saída
Texto
Atenção
MiniMax Sparse Attention em todas as camadas
Quantização
Camadas densas em MXFP8 / experts em NVFP4
Decodificação por rascunho
Cabeça de rascunho DSpark integrada
Esforço de raciocínio
low, medium, high, xhigh, max
Velocidade de saída reportada
200+ tokens/s em condições favoráveis; P50 170+ tokens/s
Licença
MiniMax Community License
Inferência documentada
vLLM, SGLang
Topologia típica
4 GPUs Blackwell ou MI355X suportadas; 8 GPUs H100/H200
Como o MiniMax M3.1 Flash utiliza sua arquitetura 428B/23B?
Um modelo Mixture-of-Experts (MoE) roteia cada token por experts selecionados. No MiniMax M3.1 Flash, aproximadamente 23B parâmetros ficam ativos por token, enquanto o conjunto completo de parâmetros é de aproximadamente 428B. A ativação esparsa reduz a computação; ela não transforma o checkpoint em um modelo denso de 23B.
O que mudou no MiniMax M3.1 Flash?
Atenção esparsa: Aplicada em todo o modelo para reduzir o trabalho de atenção em entradas longas; o benefício depende dos kernels de serving e do prompt.
Pesos de precisão mista: Componentes densos em MXFP8 e experts em NVFP4 reduzem as demandas de armazenamento e computação, mas ainda exigem hardware e kernels compatíveis.
Decodificação DSpark: Uma cabeça de rascunho integrada pode acelerar a geração em receitas suportadas; os resultados dependem da aceitação de tokens e do workload.
Serving ciente de energia: O agendamento no nível da infraestrutura pode melhorar a utilização, mas não é um recurso que você obtém automaticamente ao baixar os pesos.
Que hardware é necessário para o MiniMax M3.1 Flash?
Planeje a memória da GPU em quatro partes: pesos do checkpoint, cache de chave-valor (KV) para tokens anteriores, buffers em tempo de execução e folga para a carga de trabalho. As estimativas abaixo cobrem apenas o armazenamento bruto de parâmetros. Precisão mista, escalas de quantização, componentes multimodais e overhead de serviço alteram a necessidade real.
Topologias de GPU validadas
Aceleradores
Topologia publicada
Observações
NVIDIA GB200/GB300/B200/B300
4 GPUs, paralelismo de tensores
Caminho nativo NVFP4 do Blackwell
NVIDIA H100/H200
8 GPUs, paralelismo de tensores
Caches FP8 e caminho Marlin MoE
AMD MI355X
4 GPUs, paralelismo de tensores
Requer ROCm e configurações AITER compatíveis
GPU de consumidor 24–32 GB
Sem receita de checkpoint completo
Insuficiente para carregamento simples em 1 GPU
Workstation apenas CPU
Sem implantação prática validada
Experimentos de offloading não são guia de produção
Estimativa de memória: O armazenamento bruto para 428B parâmetros é aproximadamente 856 GB em BF16, 428 GB em 8 bits, ou 214 GB em um 4 bits idealizado. O checkpoint oficial mistura formatos, portanto essas cifras não são requisitos de VRAM em tempo de execução. Considere escalas de quantização, cache de KV, buffers de runtime e concorrência; use os arquivos do checkpoint e a receita para sua GPU para dimensionar o sistema.
Reserve espaço em NVMe para o checkpoint, downloads temporários e uma cópia para rollback.
Qual método de implantação você deve escolher?
Para um cluster local compatível, vLLM é um ponto de partida prático com configurações de referência e integração de API familiar; SGLang atende equipes que exploram personalização de serving após verificar compatibilidade, enquanto a CometAPI oferece uma rota hospedada para prototipagem e alternância de modelos.
Requisito
vLLM local
SGLang local
CometAPI
Pesos e GPUs
Baixar pesos; operar GPUs suportadas
Baixar pesos; operar GPUs suportadas
Inferência gerenciada pelo provedor; sem pesos locais
Blackwell / AMD MI355X
Receitas específicas de hardware
Receitas específicas de hardware
Hardware gerenciado pelo provedor
H100/H200
Receita documentada para oito GPUs
Verifique a matriz de suporte atual
Hardware gerenciado pelo provedor
Decodificação e paralelismo
DSpark em caminhos suportados; serving distribuído e de tensores
Decodificação específica de hardware; paralelismo de tensores e de experts
Limitado às opções expostas pela rota
Controle e processamento de dados
Seu ambiente; você gerencia a escalabilidade
Seu ambiente; você gerencia a escalabilidade
Provedor externo; provedor gerencia a escalabilidade
Escolha o framework com receita validada para seu hardware, depois compare latência e throughput usando os mesmos prompts, precisão e concorrência.
Como executar o MiniMax M3.1 Flash localmente com vLLM?
As etapas a seguir presumem um host Linux equipado com quatro GPUs NVIDIA Blackwell compatíveis, um driver/ambiente CUDA suportado e acesso ao checkpoint oficial. Use um build validado do vLLM; uma instalação comum em hardware de GPU não suportado pode falhar mesmo que a instalação de pacotes tenha sucesso.
Garanta que o wheel instalado e o runtime CUDA correspondam à sua família de GPU. Se um build de desenvolvimento específico do projeto for necessário, siga as notas de instalação de referência antes de usar os argumentos de lançamento.
Use um token de acesso do Hugging Face apropriado, preserve a estrutura de diretórios e verifique o download completo dos shards antes de iniciar o servidor.
Aguarde até o servidor concluir o carregamento e informar que está pronto antes de enviar uma solicitação. O comando acima limita o contexto a 32.768 tokens e sequências simultâneas a quatro para um teste inicial. Esses limites reduzidos não são configurações de benchmark; ajuste-os após medir o uso de memória e o comportamento das solicitações no seu hardware.
Se o identificador servido diferir do nome do diretório, chame /v1/models e use exatamente o ID retornado. Uma resposta de texto bem-sucedida valida apenas a inferência básica; teste visão, chamadas de ferramentas, concorrência e contexto longo separadamente.
Etapa 5: Integrar com um cliente Python compatível com OpenAI
O exemplo escuta em 127.0.0.1 para testes locais. Antes de conectar clientes remotos, coloque controles de acesso na frente do endpoint e configure timeouts do cliente, tentativas limitadas e monitoramento.
Variação H100/H200: use a receita Hopper de oito GPUs
Em oito GPUs H100/H200, use o cache FP8 específico do Hopper e o caminho Marlin MoE em vez da configuração NVFP4 do Blackwell. O comando abaixo segue a receita oficial do vLLM para Hopper com contexto e concorrência reduzidos para 32K e quatro sequências para um teste inicial. Ele desativa entrada de vídeo conforme essa receita. Mantenha este endpoint atrás dos seus controles de acesso existentes.
SGLang oferece receitas de implantação do M3.1 específicas de hardware e serving compatível com OpenAI. No snapshot de 23 de outubro, a documentação inclui imagens de contêiner de desenvolvimento dedicadas, portanto não se deve presumir que uma instalação genérica do SGLang contenha todo o suporte específico do modelo.
Baixar a imagem de contêiner dedicada
# Imagem de desenvolvimento NVIDIA
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# Imagem de desenvolvimento AMD MI350X/MI355X
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
Em seguida, siga o cookbook do MiniMax M3.1 no SGLang para seu acelerador. Fazer o pull de uma imagem apenas baixa o runtime; você ainda precisa iniciar um contêiner com acesso à GPU e executar a configuração de serving correspondente dentro dele. Use o comando completo específico de hardware do cookbook, aguarde a prontidão e, depois, consulte a lista de modelos do endpoint antes de enviar uma solicitação de teste. Os caminhos documentados para NVIDIA e AMD usam dependências diferentes e devem ser configurados separadamente.
Como o MiniMax M3.1 Flash se compara em benchmarks?
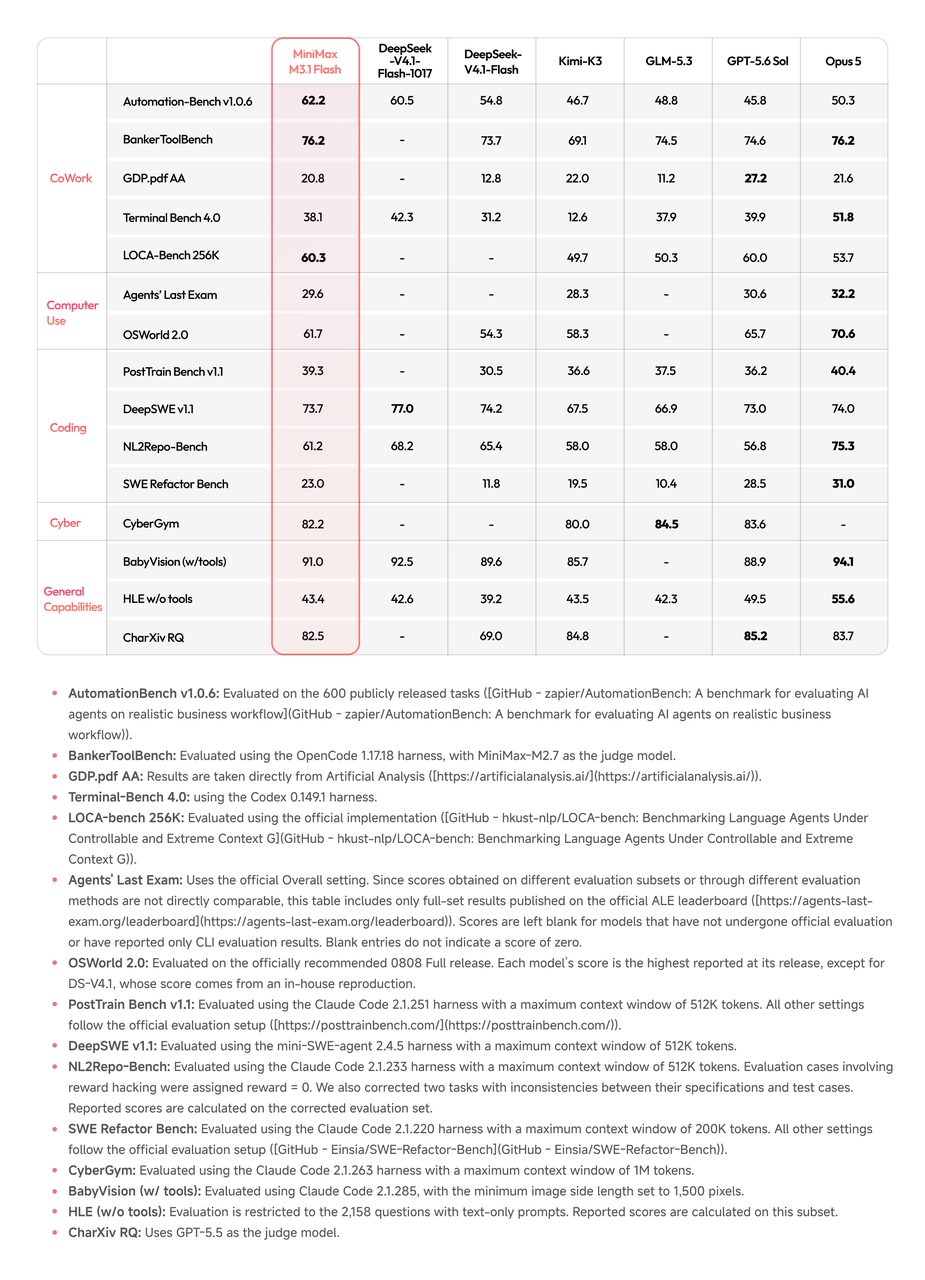
Depois que seu endpoint passar nas verificações básicas, use benchmarks publicados para decidir quais workloads testar em seguida. As cifras abaixo são avaliações publicadas pelo fornecedor, não medições da sua implantação local.
Benchmark
M3.1 Flash
DeepSeek V4.1 Flash 1017
Kimi K3
Automation-Bench v1.0.6
62.8
60.5
46.7
DeepSWE v1.1
73.7
77.0
67.5
Terminal Bench 4.0
38.1
42.3
12.6
OSWorld 2.0
61.7
N/A
58.3
NL2Repo-Bench
61.2
68.2
58.0
BabyVision with tools
91.0
92.5
85.7
Nesta comparação, MiniMax lidera os modelos listados no Automation-Bench, enquanto DeepSeek lidera vários benchmarks de código. Leia o model card e as configurações de avaliação antes de tirar conclusões, e teste os prompts e ferramentas que sua aplicação realmente usa. Pontuações de versões ou configurações de benchmark diferentes não são diretamente comparáveis.
Como otimizar o desempenho do MiniMax M3.1 Flash?
Controle contexto e concorrência
Após a primeira solicitação bem-sucedida, aumente uma variável de carga por vez: tamanho da entrada, tamanho da saída ou solicitações concorrentes. Registre memória de pico e latência de resposta para cada execução. Mantenha as últimas configurações estáveis como seu ponto de rollback, para que um experimento com falha não se torne seu novo baseline.
Escolha deliberadamente o esforço de raciocínio
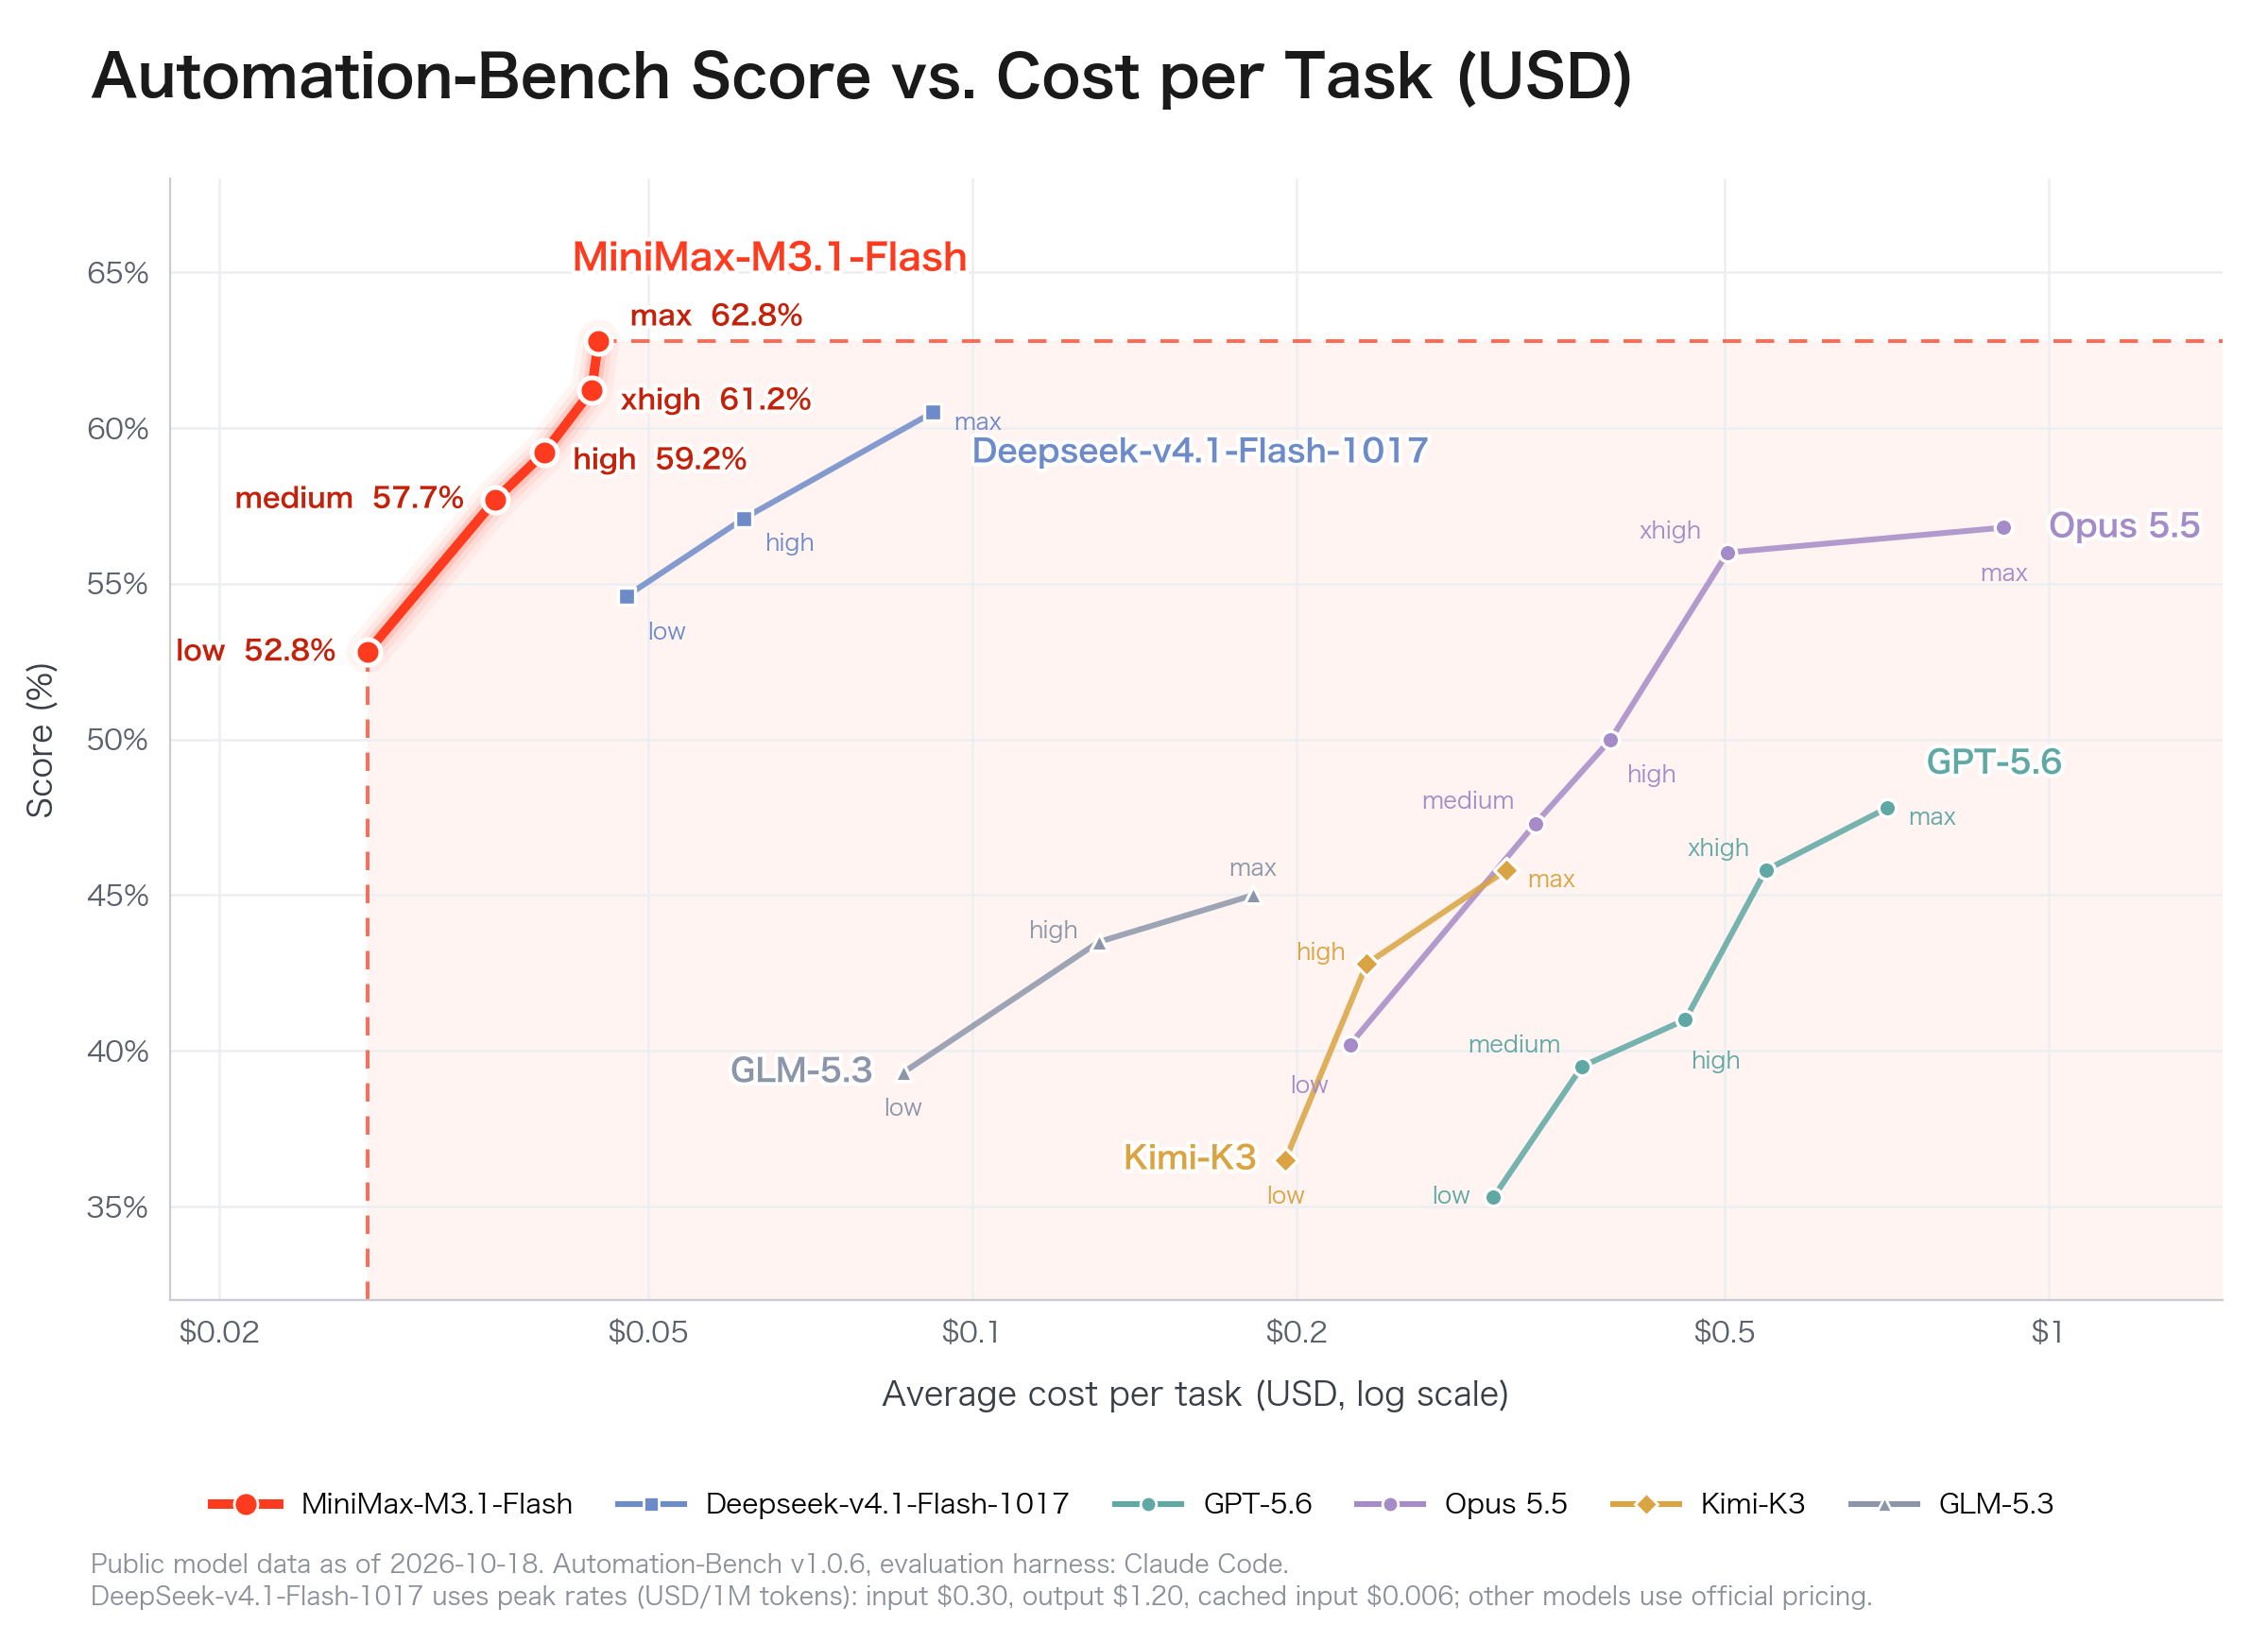
M3.1 Flash suporta esforços low, medium, high, xhigh e max. Configurações mais altas podem melhorar pontuações em tarefas exigentes, mas geralmente requerem mais tokens de raciocínio e maior latência. Use a qualidade de conclusão de tarefa e o custo computacional decorrido em conjunto.
Para solicitações locais no vLLM, a receita mostra configurações de reasoning-effort em chat_template_kwargs. Verifique tanto a resposta final quanto qualquer campo de raciocínio retornado separadamente ao validar seu cliente, já que endpoints hospedados e locais podem expor esses campos de forma diferente.
Acompanhe o custo por tarefa concluída
Para agentes, tokens por segundo não é suficiente. Registre tempo até o primeiro token, taxa de saída, taxa de aceitação para decodificação especulativa, throughput concorrente, falhas de chamadas de ferramentas, utilização de memória e custo por tarefa concluída. Uma resposta mais lenta com menos falhas de ferramentas pode gerar melhor economia geral.
Como usar a API do MiniMax M3.1 Flash na CometAPI?
Equipes que não precisam de infraestrutura dedicada de aceleradores podem usar um endpoint hospedado compatível com OpenAI. Isso elimina o download do checkpoint e a operação de GPUs, mas move o processamento de solicitações para fora do ambiente autohospedado.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Confirme o identificador do modelo no seu console da CometAPI antes de executar este exemplo. Use o gateway quando uma API comum entre provedores ajudar sua aplicação; compare sua cotação atual com o acesso direto para seu uso esperado.
Preços da API do MiniMax M3.1 Flash
Preço por milhão de tokens
API oficial da MiniMax
CometAPI
Entrada
$0.15
$0.80
Saída
$0.60
$3.20
Entrada em cache
$0.015
Confirme a cotação atual da rota
As tarifas diretas da API MiniMax no anúncio de lançamento de 19 de outubro de 2026 são $0.15 para entrada, $0.60 para saída e $0.015 para entrada em cache por milhão de tokens. Para a CometAPI, verifique a rota de modelo ativa, tarifas de entrada/saída, regras de cache e qualquer desconto de conta antes de estimar o gasto. Compare o custo total para sua mistura esperada de tokens e tentativas.
Que problemas podem ocorrer ao executar o MiniMax M3.1 Flash?
Falta de memória durante o carregamento ou as solicitações
Se os pesos falharem ao carregar: Verifique o estágio que falhou no log de inicialização, confirme que o checkpoint está completo e verifique se a topologia da GPU e o backend de quantização correspondem à receita. Se os pesos excederem a memória disponível, use uma configuração com capacidade suficiente; encurtar uma solicitação não corrige uma falha de carregamento de pesos.
Se os pesos carregarem, mas a alocação do cache falhar na inicialização: Verifique as configurações de cache e a memória disponível, depois reduza o contexto configurado ou a concorrência conforme apropriado para a receita.
Se o servidor iniciar, mas uma solicitação ficar sem memória: Tente novamente com um prompt curto e uma requisição por vez, depois aumente separadamente o tamanho da entrada, o tamanho da saída e a concorrência enquanto monitora a memória.
Kernels de quantização ou atenção incompatíveis
A execução NVFP4 difere entre hardware Blackwell, Hopper e AMD. Faça corresponder versões do engine de inferência, backends de quantização, versões de CUDA/ROCm e famílias de aceleradores, em vez de reutilizar flags indiscriminadamente.
Configuração de cache de atenção esparsa
Se a inicialização indicar um layout de cache não suportado, compare a configuração completa do cache com a receita específica de hardware. A receita atual do vLLM requer --block-size 128 para o cache esparso/indexador MSA. Se a inicialização relatar um erro de layout de cache ou de tamanho de bloco, compare a configuração completa com a receita para seu hardware.
Identificadores de modelo inesperados
Um caminho local e o nome de modelo de um gateway remoto não são necessariamente idênticos. Consulte a resposta de /v1/models local e evite codificar suposições de outro endpoint.
Vazão observada baixa
Separe processamento lento de prompt de geração lenta de tokens. Compare execuções com o mesmo tamanho de entrada e limite de saída, depois verifique a utilização da GPU e o comportamento do interconector antes de aumentar o tamanho do lote. Uma cifra de velocidade de um provedor hospedado não é baseline para seu cluster local.
Conclusão
Escolha seu primeiro caminho de implantação a partir do hardware que você pode operar hoje. Use o passo a passo do vLLM para um cluster local suportado, o cookbook específico de hardware do SGLang para uma pilha de serving alternativa ou uma API hospedada quando quiser focar na integração da aplicação. Mantenha a configuração que atende às suas metas de qualidade de tarefa e latência a um custo operacional sustentável.
A maneira mais confiável de selecionar um método de serving é otimizar por trabalho corretamente concluído por dólar e minuto, não apenas picos de tokens por segundo.
Perguntas frequentes
Como tornar uma implantação reprodutível após atualizar o runtime?
Fixe a revisão do checkpoint, as versões da imagem de runtime ou pacotes, a pilha de drivers e as configurações de lançamento. Execute o mesmo pequeno conjunto de aceitação antes de cada upgrade e mantenha a configuração anterior funcionando disponível para rollback.
Como devo lidar com novas tentativas quando um agente chama ferramentas?
Separe a nova tentativa do modelo de repetir uma ação de ferramenta. Use chaves de idempotência para ações que alteram dados, verifique se a primeira tentativa teve sucesso e valide os argumentos completos da ferramenta antes da execução.
Posso alternar entre um endpoint local e a CometAPI sem mudar o comportamento da aplicação?
Mantenha endpoint, credenciais e ID do modelo configuráveis. Teste streaming, chamadas de ferramentas, campos de raciocínio e entradas multimodais em ambas as rotas, e confirme seus requisitos de roteamento de dados antes de habilitar fallback.
O que devo testar antes de aceitar entradas multimodais?
Teste imagens e vídeos representativos, incluindo arquivos de baixa qualidade e não suportados. Verifique pré-processamento, limites de tamanho, qualidade das respostas e timeouts separadamente; uma solicitação de texto bem-sucedida não valida o caminho multimodal.
Como saber se uma implantação está pronta para usuários reais?
Defina metas para sucesso de tarefa, chamadas válidas de ferramentas, latência, erros e custo. Teste tráfego realista, verifique monitoramento e comportamento de fallback, depois expanda a partir de um rollout pequeno somente enquanto essas metas forem mantidas.