
TLDR A Anthropic descreve o Claude Haiku 5.5 como o modelo pequeno mais barato, mais rápido e mais capaz que já lançou. Projetado para cargas de alto volume e sensíveis à latência, como classificação, extração, roteamento, sumarização e tarefas de subagentes, ele oferece uma janela de contexto de 1 milhão de tokens, até 128K tokens de saída e raciocínio adaptativo com níveis de esforço ajustáveis.
Em média, custa cerca de 75% menos para operar do que o Haiku 4.5, ao mesmo tempo em que apresenta grandes ganhos em benchmarks de agentes e uso de computador. Desenvolvedores podem acessá-lo via a API oficial do Claude (claude-haiku-5-5), Amazon Bedrock, Google Cloud, Microsoft Foundry ou gateways otimizados para custo, como o CometAPI (a partir de $0.08 / $0.40).
Principais destaques
- Lançamento e posicionamento: Lançado em 7 de outubro de 2026 como o modelo pequeno e de alta vazão na família Claude 5.5 — ideal para suporte em tempo real, processamento de documentos e etapas delegadas de agentes.
- Especificações principais: contexto de 1M tokens, saída máxima de 128K (300K via Batch API beta), raciocínio adaptativo (esforço padrão médio), entrada de texto + imagem → saída de texto, corte de conhecimento em junho de 2026.
- Vantagem de preço: $0.10 por milhão de tokens de entrada / $0.50 por milhão de tokens de saída para prompts até 100K (≈90% mais barato que o Haiku 4.5 na maioria das solicitações); faixa superior acima de 100K. Leituras de cache a partir de $0.01. O CometAPI oferece taxas Standard ≈20% menores.
- Salto de desempenho: grandes ganhos vs Haiku 4.5 (por exemplo, OSWorld 72,4% vs 15,7%, Terminal-Bench 39,2% vs 0%, GDPval-AA 1620 vs 735 Elo), permanecendo competitivo com ou à frente do GPT-6 Luna em muitos testes.
- Recursos para desenvolvedores: parâmetro de esforço (
low–max), cache de prompt, Batch API (50% off), uso de computador/navegador (suporte beta no SDK). Temperature/top_p/top_k devem ser omitidos, caso contrário ocorre um erro 400.
O que é o Claude Haiku 5.5 e por que ele é importante em 2026
O Claude Haiku 5.5 é a mais recente aposta da Anthropic na camada “leve” da família Claude. Diferentemente dos modelos mais caros Opus 5.5 e Sonnet 5.5, otimizados para raciocínio complexo e agentes de longo horizonte, o Haiku 5.5 é feito sob medida para cargas de trabalho de alto volume, sensíveis a custo e a latência. A Anthropic o descreve como “o modelo pequeno mais barato, mais rápido e mais capaz que já lançamos”.
Casos típicos de produção incluem:
- Classificação e roteamento de tickets em suporte ao cliente
- Extração de campos e sumarização de documentos longos
- Compactação do histórico de conversas para modelos maiores
- Consultas estilo banco de dados e tarefas de dados estruturados
- Subagentes rápidos que lidam com etapas estreitas de código, uso de ferramentas ou navegador, enquanto um modelo mais forte orquestra
Como é dramaticamente mais barato e rápido que seu predecessor, ao mesmo tempo em que fecha boa parte da lacuna de qualidade em tarefas agentivas práticas, muitas equipes estão re-arquitetando pipelines para que o Haiku 5.5 trate a maioria das solicitações e apenas escale casos difíceis para o Sonnet ou Opus. Feedback inicial de clientes como Asana, HubSpot, Box e outros destaca reduções de latência superiores a 30% e ganhos mensuráveis de acurácia em avaliações internas de alto volume.
Especificações técnicas do Claude Haiku 5.5
| Especificação | Valor | Observações |
|---|---|---|
| ID do modelo (Claude API) | claude-haiku-5-5 | Sem sufixo de data |
| Amazon Bedrock | anthropic.claude-haiku-5-5 (ou perfis global/us/eu/au/jp) | |
| Janela de contexto | 1.000.000 tokens | ≈555k palavras com o novo tokenizador |
| Saída máx. (Messages API) | 128.000 tokens | 300K com Batch API + cabeçalho beta |
| Modalidades de entrada | Texto + imagens | |
| Modalidade de saída | Texto | |
| Raciocínio | Adaptativo (ativado por padrão) | Controlado via effort |
| Esforço padrão | medium | Opções: low, medium, high, xhigh, max |
| Corte de conhecimento | Junho de 2026 | |
| Compromisso de descontinuação | Não antes de 7 de outubro de 2027 | |
| Tokenizador | Mais novo (mesma família do Claude 4.7+) | Mesmo texto ≈30% mais tokens que o Haiku 4.5 |
Fonte: visão geral do modelo Anthropic e documentação da plataforma.
Os limites maiores de contexto e saída, combinados com raciocínio adaptativo, tornam o Haiku 5.5 muito mais utilizável em sistemas reais de produção do que modelos pequenos anteriores que exigiam truncamento agressivo ou orçamentos de raciocínio fixos.
Respostas e verificações de conclusão
Leia blocos de conteúdo por tipo, em vez de supor que content[0] é a resposta visível. Inspecione stop_reason antes de aceitar a saída: max_tokens indica uma geração truncada, e uma recusa requer uma resposta explícita da aplicação. Para solicitações com ferramentas habilitadas, processe blocos de uso de ferramentas e retorne os resultados da ferramenta no formato nativo, em vez de tratar como uma resposta de texto concluída.
O que mudou em comparação com a API do Claude Haiku 4.5?
Mudanças de capacidade, comportamento e preços
| Dimensão | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Janela de contexto | 200K | 1M | 1M |
| Saída máxima | 64K | 128K | 128K |
| Esforço adaptativo | Não | Sim | Sim |
| Entrada Anthropic / MTok | $1.00 | $0.10 | $2.00 |
| Saída Anthropic / MTok | $5.00 | $0.50 | $10.00 |
| Posicionamento | Modelo rápido legado | Trabalho rotineiro em escala | Tarefas complexas mais difíceis |
Os preços do Haiku 5.5 nesta comparação aplicam-se a prompts de até 100.000 tokens; prompts maiores custam mais. Estas são taxas Standard da Anthropic, não taxas do CometAPI. A comparação é um ponto de partida para roteamento, não uma afirmação de que os modelos têm desempenho idêntico.
Para integrações do Haiku 4.5, as principais mudanças de implementação são raciocínio adaptativo em vez de um orçamento manual, controles de esforço, análise seletiva de blocos de conteúdo e contagens de tokens atualizadas. O mesmo texto pode usar aproximadamente 30% mais tokens de entrada. Recontabilize prompts representativos em vez de reutilizar estimativas de tokens do Haiku 4.5. A seção de migração transforma essas mudanças em um checklist de implantação.
Melhorias de benchmark relatadas
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| OSWorld 2.1 (subconjunto offline; crédito parcial) | 15,7% | 72,4% | 83,9% |
| Terminal-Bench 4.0 | 0,0% | 39,2% | 70,6% |
| Humanity’s Last Exam (sem ferramentas) | 10,2% | 45,9% | 56,9% |
| Chartography (sem ferramentas) | 6,4% | 46,4% | 61,6% |
| GDPval-AA v2.1 (Elo) | 735 | 1.620 | 1.840 |
A Anthropic relata as pontuações acima em seu resumo de benchmarks de lançamento. São resultados de avaliação relatados, não testes ao vivo dos exemplos do CometAPI neste guia. Os 72,4% do OSWorld são crédito parcial, não uma taxa estrita de conclusão de tarefas.
O system card do Haiku 5.5 descreve as condições de avaliação. Avaliações padrão do Haiku 5.5 usam raciocínio adaptativo com esforço máximo e amostragem padrão, salvo indicação; o padrão do produto é medium. O OSWorld usa 82 tarefas offline, sem acesso à internet, resolução 1080p e limite de 500 ações. O Terminal-Bench 4.0 usa o Claude Code em modo bare, sem saída para internet e 10 tentativas por tarefa para o Haiku 5.5; a configuração do Sonnet difere. As linhas HLE e Chartography acima são sem ferramentas. O GDPval-AA reporta uma classificação Elo a partir de avaliações da Artificial Analysis. Combine o harness, esforço e configurações de ferramentas relevantes ao comparar resultados.
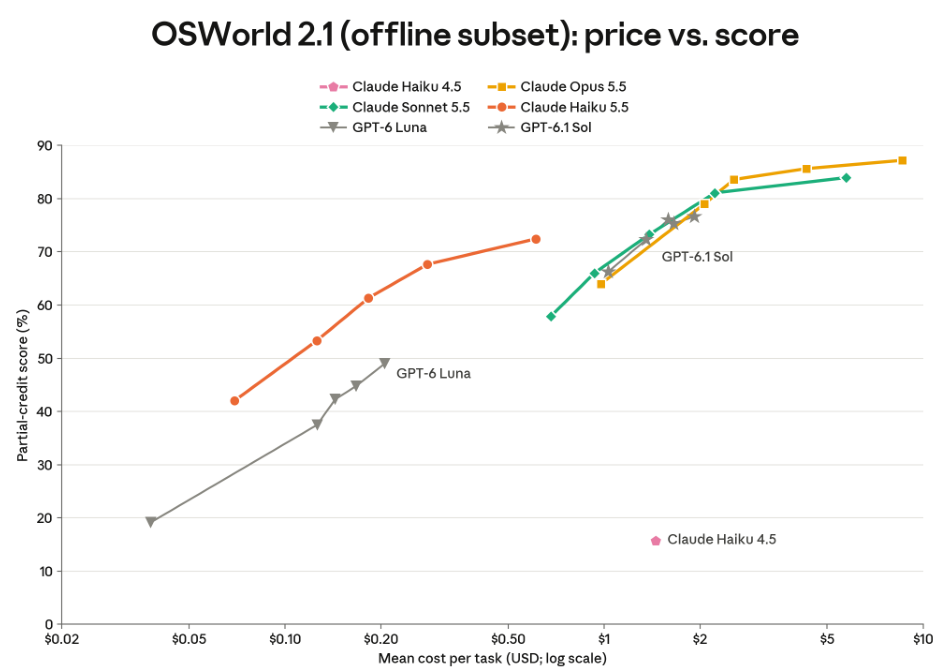
O gráfico original do OSWorld da Anthropic mostra a relação entre esforço, custo por tarefa e pontuação de crédito parcial. Ele não mede a latência da API nem garante o mesmo desempenho no seu workload.
As pontuações indicam um desempenho muito mais forte em uso de computador e tarefas gerais do que o Haiku 4.5, mas não garantem os mesmos resultados na sua aplicação. Execute um conjunto de avaliação representativo antes de comprometer tráfego de produção.
A tabela de benchmark e o gráfico fornecido são mantidos como comparações de modelos. São avaliações relatadas, não testes ao vivo dos exemplos do CometAPI. Use a mesma distribuição de tarefas, esforço e configurações de ferramentas ao avaliar uma aplicação; uma pontuação de benchmark não estabelece a latência do gateway nem sua própria taxa de sucesso.
Como usar a API do Claude Haiku 5.5 via CometAPI
Crie uma chave e escolha a rota nativa
Crie uma conta no CometAPI, confirme o acesso a claude-haiku-5-5 e gere uma chave de API do lado do servidor. Defina COMETAPI_KEY no seu ambiente. Mantenha a chave fora do controle de versão e do código no navegador. As chaves da Anthropic e do CometAPI pertencem a provedores diferentes; use a chave do CometAPI para cada exemplo neste guia revisado.
export COMETAPI_KEY="your_cometapi_api_key"
pip install --upgrade anthropic
$env:COMETAPI_KEY="your_cometapi_api_key"
| Integração | SDK base URL | Caminho da requisição | Credencial |
|---|---|---|---|
| Messages compatível com Anthropic | https://api.cometapi.com | /v1/messages | COMETAPI_KEY |
| Chat Completions compatível com OpenAI | https://api.cometapi.com/v1 | /chat/completions | COMETAPI_KEY |
O CometAPI suporta o formato nativo Messages e content-block do Claude. Use o SDK da Anthropic com a base URL raiz do CometAPI. Messages nativo é a rota preferida neste guia para o raciocínio específico do Claude e content blocks. A rota compatível Chat Completions é uma opção para uma aplicação no estilo OpenAI existente. Confirme o suporte a campos avançados na rota exata do gateway.
Envie uma requisição mínima e verifique o resultado
curl https://api.cometapi.com/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: $COMETAPI_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-haiku-5-5",
    "max_tokens": 2048,
    "output_config": {"effort": "low"},
    "messages": [{"role": "user", "content": "Summarize three AI uses in customer support."}]
  }'
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
    timeout=60.0,
    max_retries=2,
)

response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket: I cannot log in."}],
)
if response.stop_reason != "end_turn":
    raise RuntimeError(f"Unaccepted completion: {response.stop_reason}")
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Salve o exemplo em Python como example.py e execute python example.py. Um checkpoint bem-sucedido é uma resposta concluída com texto visível e campos de uso. Um erro de autenticação significa que a chave precisa ser verificada; um erro de modelo/rota significa que o ID do modelo, endpoint ou acesso da conta precisam ser verificados.
Use o mesmo formato nativo em JavaScript
npm install @anthropic-ai/sdk
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com",
  timeout: 60_000,
  maxRetries: 2,
});
const response = await client.messages.create({
  model: "claude-haiku-5-5",
  max_tokens: 2048,
  output_config: {effort: "low"},
  messages: [{role: "user", content: "Extract product, quantity and price: 3 laptops at $900 each."}],
});
if (response.stop_reason !== "end_turn") {
  throw new Error("Unaccepted completion: " + response.stop_reason);
}
for (const block of response.content) {
  if (block.type === "text") console.log(block.text);
}
Use uma versão suportada do Node.js. Salve o arquivo como example.mjs, defina COMETAPI_KEY e execute node example.mjs. Registre a versão do SDK que você valida para implantação.
Adapte uma aplicação compatível com OpenAI existente
Se sua aplicação já usa Chat Completions, instale o pacote openai e configure o cliente separado abaixo. Esta rota retorna choices em vez de content blocks nativos. Mantenha a análise específica de rota separada e teste raciocínio, imagens e ferramentas antes de confiar na tradução do gateway.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    messages=[
        {"role": "system", "content": "Be concise and helpful."},
        {"role": "user", "content": "Explain API rate limits."},
    ],
)
print(response.choices[0].message.content)
Enviando imagens para a API do Claude Haiku 5.5
Use uma imagem juntamente com uma instrução que especifique a evidência e a saída desejadas. A interface oficial de visão aceita blocos de conteúdo de imagem com dados base64, uma URL de imagem ou uma referência de arquivo enviado suportada. Este exemplo lê um PNG local, coloca a imagem antes da pergunta e solicita valores que podem ser verificados na fonte.
Analise um PNG local real através da Anthropic Messages API nativa.
import os
import base64
from pathlib import Path
import anthropic

# Replace dashboard.png with a real PNG file you are authorized to analyze.
image_data = base64.b64encode(Path("dashboard.png").read_bytes()).decode("ascii")
anthropic_client = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
response = anthropic_client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{
        "role": "user",
        "content": [
            {"type": "image", "source": {
                "type": "base64", "media_type": "image/png", "data": image_data
            }},
            {"type": "text", "text": (
                "Read the visible dashboard metrics. List anomalies with their "
                "labels and values, and state when text is unreadable."
            )},
        ],
    }],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Use o tipo MIME que corresponda ao arquivo real. Verifique legibilidade, dimensões da imagem e limites de tamanho da requisição antes do envio; evite enviar mídia em alta resolução que não ajude a tarefa. Para o CometAPI, altere a chave e a base URL raiz conforme mostrado no exemplo de Messages, e verifique o suporte a imagens na rota exata.
Controlando o raciocínio do Claude Haiku 5.5
O Haiku 5.5 usa raciocínio adaptativo por padrão. A configuração oficial de thinking explica quando disabled é aceito e como blocos de thinking são retornados. Defina o esforço via output_config.effort; não reutilize o legacy budget_tokens.
| Esforço | Caso de uso inicial recomendado | Trade-off |
|---|---|---|
| low | Classificação curta, extração simples | Tipicamente menor uso de tokens e latência |
| medium | Respostas de suporte, trabalho rotineiro de agentes | Padrão balanceado |
| high | Análise de documentos em múltiplas etapas | Potencialmente mais raciocínio |
| xhigh | Avaliações difíceis | Mais processamento e custo |
| max | Casos com raciocínio intensivo | Maior gasto potencial de raciocínio |
Configure raciocínio adaptativo com esforço baixo.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)response = anthropic_client.messages.create( model="claude-haiku-5-5", max_tokens=4096, thinking={"type": "adaptive"}, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Classify as billing, technical, or account: cannot log in."}],)for block in response.content: if block.type == "text": print(block.text)
Desenvolvedores podem desativar o thinking nos esforços low, medium e high, mas não em xhigh ou max. O thinking consome tokens de saída faturados e o orçamento de max_tokens, mesmo quando seu texto é oculto. Um campo thinking vazio ainda pode carregar uma assinatura; isso não prova que nenhum raciocínio ocorreu. Mantenha os blocos de conteúdo retornados inalterados ao continuar conversas com ferramentas.
Exemplo de requisição com thinking desativado
Envie um corpo de requisição nativo com thinking desativado.
{ "model": "claude-haiku-5-5", "max_tokens": 1024, "thinking": {"type": "disabled"}, "output_config": {"effort": "low"}, "messages": [ {"role": "user", "content": "Return sentiment only: positive, neutral, negative."} ]}
Streaming de respostas do Claude Haiku 5.5
O streaming entrega texto visível incrementalmente e melhora a responsividade em aplicações interativas. Trate o texto transmitido como provisório até que a requisição seja concluída com sucesso.
Transmita texto visível com o SDK Python da Anthropic.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)with anthropic_client.messages.stream( model="claude-haiku-5-5", max_tokens=4096, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Explain API caching."}],) as stream: for text in stream.text_stream: print(text, end="", flush=True)
Preços da API do Claude Haiku 5.5
Compare taxas por token e faixas de comprimento de prompt
Taxas verificadas em 8 de outubro de 2026. A tabela compara os preços Standard da Anthropic com as taxas publicadas do CometAPI, em USD por milhão de tokens. A faixa é determinada pelo comprimento do prompt: até 100.000 tokens versus mais de 100.000. Solicitações mais longas usam as taxas aplicáveis da faixa superior, não apenas um acréscimo sobre os tokens excedentes. Faturamento da conta, uso de cache e ferramentas opcionais devem ser reconciliados separadamente.
| Categoria de tokens | Anthropic ≤100K | CometAPI ≤100K | Anthropic >100K | CometAPI >100K |
|---|---|---|---|---|
| Entrada | $0.10 | $0.08 | $0.50 | $0.40 |
| Saída | $0.50 | $0.40 | $2.50 | $2.00 |
| Leitura de cache | $0.01 | $0.008 | $0.05 | $0.04 |
| Escrita de cache 5-min | $0.125 | $0.10 | $0.625 | $0.50 |
| Escrita de cache 1-h | $0.20 | $0.16 | $1.00 | $0.80 |
A captura de taxas do artigo original é mantida acima. Verifique a lista atual do CometAPI e o faturamento da conta antes da compra ou implantação; a taxa inicial de entrada listada não é uma cotação completa para cada faixa de comprimento de prompt, operação de cache ou ferramenta opcional.
Exemplo: custo de 100.000 solicitações de suporte
Suponha 100.000 solicitações mensais, cada uma com 2.000 tokens de entrada e 300 tokens de saída faturados, incluindo qualquer thinking gerado. Cada prompt se qualifica para a faixa de até 100K. Exclua caching, cobranças de ferramentas e retentativas.
| Componente | Uso | Anthropic | CometAPI |
|---|---|---|---|
| Entrada | 200M tokens | $20.00 | $16.00 |
| Saída | 30M tokens | $15.00 | $12.00 |
| Total | 100.000 solicitações | $35.00 | $28.00 |
Nessas condições, a diferença ilustrativa é de $7 por mês, ou 20%. Os custos de produção dependem do comprimento das solicitações, raciocínio oculto, caching e comportamento de retentativas.
Use as contagens de tokens atuais do modelo no cálculo. Custo = tokens de entrada × taxa de entrada aplicável / 1.000.000 + tokens de saída faturados × taxa de saída aplicável / 1.000.000, mais cobranças separadas de cache, ferramentas e retentativas. Tokens de thinking fazem parte da saída faturada.
Reduza o custo sem perder qualidade de tarefas aceitas
| Otimização | Ação | Benefício |
|---|---|---|
| Ajuste de esforço | Use low onde a qualidade permitir | Menor sobrecarga de raciocínio |
| Redução de prompt | Remova histórico de conversa redundante | Menos tokens de entrada |
| Cache de prompt | Mantenha prefixo reutilizado estável | Menor custo de entradas repetidas |
| Streaming | Renderize tokens à medida que chegam | Melhor responsividade percebida |
| Validação de schema | Rejeite registros malformados cedo | Menos retrabalho a jusante |
| Roteamento de modelos | Escale tarefas complexas | Melhor equilíbrio custo-qualidade |
| Processamento em lote | Loteie requisições offline elegíveis | Potenciais economias adicionais |
Não selecione automaticamente o menor esforço. Uma chamada individual mais barata pode aumentar o custo total se produzir mais retentativas. Avalie acurácia, latência p50/p95, uso de tokens e custo por tarefa bem-sucedida.
Para cache de prompt, reutilize um prefixo estável e inspecione a criação e leitura de cache, em vez de presumir acerto. O Haiku 5.5 tem um mínimo de 512 tokens cacheáveis no prompt na API documentada do Claude. Alterar o esforço pode invalidar prefixos em cache; mantenha as configurações estáveis em uma conversa. Uma janela de contexto de 1M é um teto de capacidade, não uma recomendação para enviar todo documento em cada turno.
Mantenha um prefixo reutilizável estável para caching, encurte entradas desnecessárias e avalie mudanças de esforço. Streaming melhora a responsividade percebida, não reduz automaticamente o uso faturado. Compare custo por tarefa aceita em todo o fluxo, incluindo retentativas e chamadas de ferramentas.
Guia de migração do Claude Haiku 4.5 para o Haiku 5.5
Atualize a integração e o formato da requisição
| Área | Ação de migração |
|---|---|
| ID do modelo | Substitua por claude-haiku-5-5 |
| Thinking | Substitua budget_tokens manual por raciocínio adaptativo |
| Esforço | Use output_config.effort se necessário |
| Amostragem | Omita temperature, top_p e top_k; qualquer valor de top_k é não suportado |
| Parser de resposta | Trate múltiplos tipos de content-block |
| Orçamento de saída | Reserve espaço suficiente para raciocínio e saída final |
| Prefill | Remova pré-preenchimento do assistente não suportado |
| Caching | Reteste prompts ao alterar o esforço |
| Integrações de ferramentas | Verifique versões de ferramentas suportadas |
Para a rota do CometAPI usada aqui, mantenha COMETAPI_KEY e a base URL nativa enquanto altera o ID do modelo e a configuração da requisição. Substitua thinking habilitado legado com orçamento por raciocínio adaptativo e esforço. Remova pré-preenchimento do assistente e omita parâmetros de amostragem. Preserve a distinção entre o array nativo de conteúdo do Claude e a resposta choices da rota compatível.
Preserve estado e recalcule orçamentos
O guia de migração oficial do Haiku 5.5 reporta aproximadamente 30% mais tokens de entrada para texto idêntico do que o Haiku 4.5. Reconte prompts representativos e retune limites antes de mover o tráfego. Blocos de thinking retornados funcionam apenas na conta que os produziu ou em uma conta vinculada; uma mudança de conta pode descartar silenciosamente esses blocos. Preserve um prefixo de conversa apenas-anexo em vez de modificar mensagens anteriores após a geração. Inspecione stop_reason, incluindo max_tokens e refusal, e trate-os explicitamente antes de aceitar a saída.
Reconte prompts representativos com o modelo-alvo e retune max_tokens, limites de latência e estimativas de custo por requisição. Teste conversas armazenadas na conta e na rota de gateway que as reproduzirão; não presuma que blocos de thinking assinados são portáveis entre contas não relacionadas ou prefixes de conversa reescritos.
Conclusão
O Claude Haiku 5.5 representa um ponto de inflexão real para IA de alto rendimento e custo eficiente. Ao oferecer desempenho dramaticamente melhor em agentes e uso de computador a aproximadamente um décimo do preço do Haiku anterior na maioria das solicitações, a Anthropic tornou prática a implantação em larga escala de modelos pequenos capazes. Seja chamando a API oficial, roteando via Amazon Bedrock ou usando um gateway unificado como o CometAPI para economias adicionais e simplicidade operacional, a combinação de velocidade, capacidade e preço abre novas possibilidades de produto antes pouco econômicas.