Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
Como usar a API MiMo-V2.5 Guia Completo do Desenvolvedor
Aprenda sobre as especificações da API da Xiaomi, benchmarks, preços, solicitações multimodais, streaming, integração com Python e práticas recomendadas para produção.
Deon GoodwinEquipe de pesquisa de modelos e API de IA
A MiMo-V2.5 API na CometAPI fornece acesso ao modelo de mistura esparsa de especialistas da Xiaomi para codificação, compreensão multimodal e cargas de trabalho de agentes. A API MiMo-V2.5 é o padrão prático quando um projeto precisa de uma janela de contexto de 1 milhão de tokens, entrada multimodal nativa e baixo custo por token; a MiMo-V2.5 Pro é a melhor opção quando codificação difícil, raciocínio ou uso de ferramentas de longo horizonte importam mais do que o preço. Este guia mostra como chamar a API via CometAPI, transmitir respostas, estruturar solicitações multimodais, estimar custos e tornar uma integração de produção mais robusta.
Principais pontos
O modelo MiMo-V2.5 usa 310B parâmetros totais com 15B parâmetros ativos por token e oferece suporte a uma janela de contexto de 1M tokens.
Use a rota MiMo-V2.5 para trabalho multimodal, análise de grande contexto e agentes sensíveis a custo; escolha MiMo-V2.5 Pro para as tarefas mais difíceis de codificação e raciocínio.
Revisado para maior clareza, atribuição de fontes e terminologia de API atual.
O endpoint compatível com OpenAI torna a migração simples, mas sistemas de produção ainda precisam de timeouts, lógica de repetição, orçamentos de tokens e verificações de capacidade no provedor.
Nas tarifas declaradas da CometAPI, uma solicitação com 10.000 tokens de entrada e 2.000 tokens de saída custa cerca de $0.001568 na rota MiMo-V2.5.
Visão geral do modelo MiMo-V2.5
A Xiaomi introduziu o modelo em 22 de abril de 2026. MiMo-V2.5 API na CometAPI o expõe por meio de uma interface de chat-completions compatível com OpenAI, de modo que clientes existentes geralmente podem migrar apenas alterando a URL base, a chave de API e o identificador do modelo.
De acordo com o model card oficial, o modelo combina um backbone de linguagem MoE esparso com codificadores dedicados de visão e áudio. Ele aceita entradas de texto, imagem, vídeo e áudio, enquanto produz saída em texto. Sua grande janela de contexto é útil para revisão de código em escala de repositório, conjuntos de documentos, transcrições longas e agentes de múltiplas etapas.
Especificação
Valor
Por que isso importa
Arquitetura
Mistura esparsa de especialistas
Ativa uma parte limitada da rede para cada token.
Parâmetros totais
310B
Oferece ampla capacidade sem usar todos os parâmetros por token.
Parâmetros ativos
15B
Permite inferência eficiente em relação ao tamanho total do modelo.
Janela de contexto
1,000,000 tokens
Lida com grandes repositórios e coleções de documentos longos.
Saída máxima
Até 128K tokens pela rota atual
Suporta relatórios longos e geração estendida de código.
Entradas nativas
Texto, imagem, vídeo, áudio
Permite fluxos de trabalho multimodais unificados.
Modalidade de saída
Texto
As respostas são retornadas como texto gerado.
Codificador de visão
ViT com 729M parâmetros
Processa conteúdo visual para tarefas de imagem e vídeo.
Codificador de áudio
Transformer com 261M parâmetros
Processa fala e outras entradas de áudio.
Licença
MIT
Permite amplo uso comercial e de pesquisa sob os termos da licença.
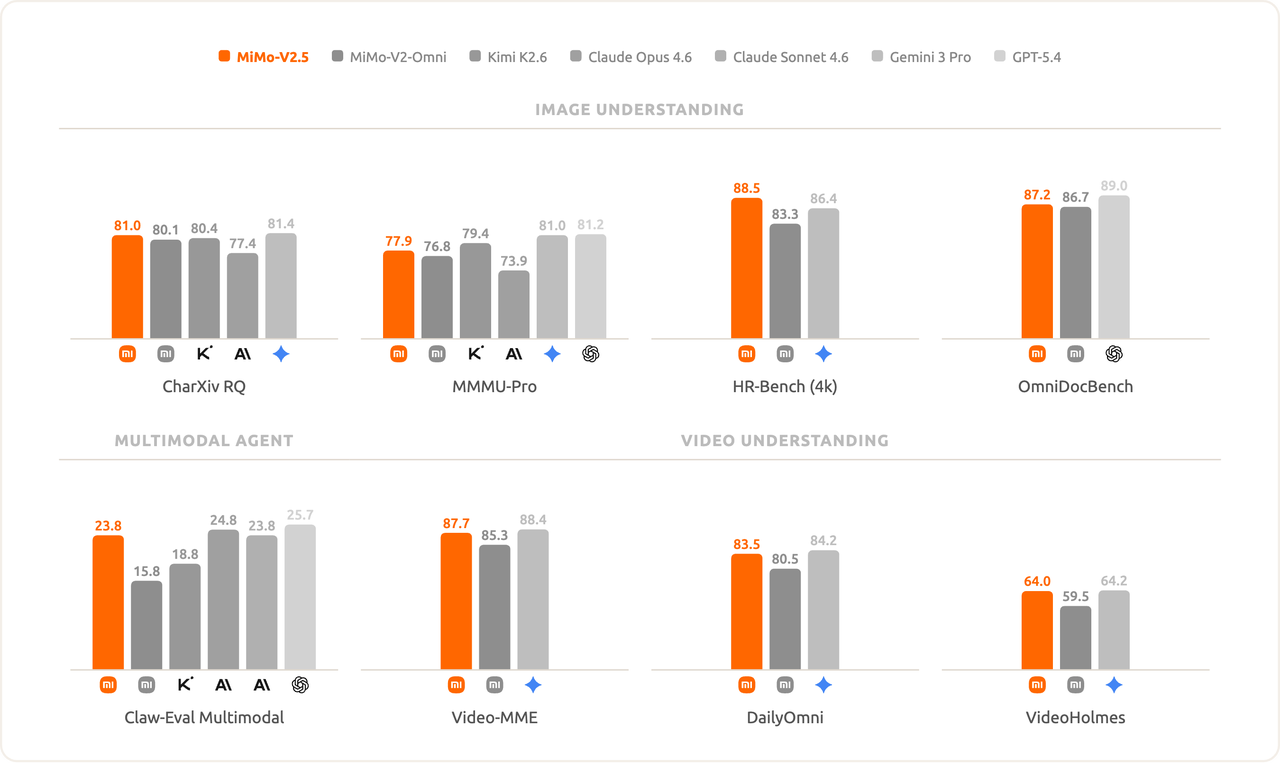
A imagem oficial de benchmark multimodal abaixo relata resultados em tarefas de compreensão de imagem, agente multimodal e compreensão de vídeo.
Comparação oficial de benchmark multimodal do Xiaomi MiMo-V2.5
As rotas do provedor podem expor um conjunto mais restrito de formatos de mídia do que o modelo subjacente suporta. Valide o formato exato de payload de imagem, áudio e vídeo no endpoint ativo antes de lançar um recurso multimodal.
Desempenho em benchmarks do MiMo-V2.5
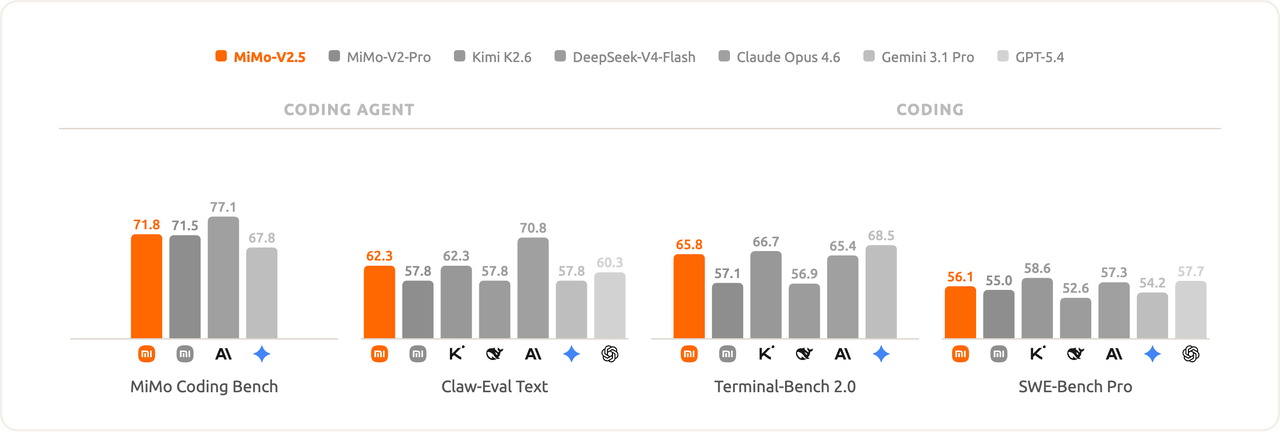
A Xiaomi relata resultados fortes em codificação, uso de terminal e avaliação de agentes multimodais. Esses números são úteis para posicionar o modelo, mas não substituem testes com seus próprios prompts, ferramentas, metas de latência e condições de falha.
Benchmark
Pontuação reportada
Foco da avaliação
SWE-Bench Pro
56.1
Engenharia de software em nível de repositório
Terminal-Bench 2.0
65.8
Tarefas de agente baseadas em terminal
Claw-Eval General
62.1 Pass@3
Capacidade geral de agente
Claw-Eval Multimodal
23.8 Pass@3
Tarefas de agente multimodal
Claw-Eval Multi-Turn
63.2 Pass@3
Comportamento de agente de múltiplas interações
ResearchClawBench
16.91
Fluxos de trabalho de agente orientados à pesquisa
A comparação oficial de codificação mostra 65.8 no Terminal-Bench 2.0 e 56.1 no SWE-Bench Pro, além de posicionar o modelo em uma comparação mais ampla de agentes de codificação.
Comparação oficial de benchmark de codificação do Xiaomi MiMo-V2.5
O que os resultados sugerem: o modelo é especialmente atraente para aplicações que combinam código, ferramentas e mídias mistas. Para decisões determinísticas em produção, execute uma avaliação interna que meça sucesso da tarefa, uso de tokens, latência de ponta a ponta, frequência de repetição e taxa de correção humana.
MiMo-V2.5 vs MiMo-V2.5 Pro: uma comparação multidimensional
Dimensão
MiMo-V2.5
MiMo-V2.5-Pro
Parâmetros totais
310B
1.02T
Parâmetros ativos
15B
42B
Janela de contexto
1M tokens
1M tokens
Força principal
Cargas de trabalho omnimodais e de agentes gerais
Agentes complexos e codificação exigente
Preço de entrada por 1M tokens
$0.112
$0.348
Preço de saída por 1M tokens
$0.224
$0.696
Melhor encaixe
Sistemas multimodais, de grande contexto e sensíveis a custo
Raciocínio difícil, codificação e execução de longo horizonte
Modalidades de entrada da API oficial
Texto, imagem, vídeo, áudio
Texto
Modalidade de saída da API oficial
Texto
Texto
Resultado da comparação: comece com a rota MiMo-V2.5 quando custo, throughput ou cobertura multimodal guiarem a decisão. Mova solicitações selecionadas para a MiMo-V2.5 Pro quando avaliações internas mostrarem ganho significativo de acurácia em casos difíceis de codificação, raciocínio ou uso de ferramentas. Um roteador em camadas geralmente oferece melhor equilíbrio custo-qualidade do que enviar todas as solicitações para a MiMo-V2.5 Pro.
Como chamar a API MiMo-V2.5
A API segue o conhecido esquema de chat-completions. Mantenha a chave no seu servidor, carregue-a a partir de uma variável de ambiente e nunca a incorpore em código de navegador ou mobile.
Defina a chave da API
export COMETAPI_KEY="your_api_key_here"
$env:COMETAPI_KEY = "your_api_key_here"
### Enviar uma solicitação cURL
curl https://api.cometapi.com/v1/chat/completions
-H "Authorization: Bearer $COMETAPI_KEY"
-H "Content-Type: application/json"
-d '{
"model": "mimo-v2.5",
"messages": [
{"role": "system", "content": "You are a careful coding assistant."},
{"role": "user", "content": "Explain the bug and propose a minimal patch."}
],
"temperature": 0.2
}'
response = client.chat.completions.create(
model="mimo-v2.5",
messages=[
{"role": "system", "content": "You are a precise engineering assistant."},
{"role": "user", "content": "Review this migration plan for hidden risks."},
],
temperature=0.2,
)
print(response.choices[0].message.content)
> Não registre chaves de API, cabeçalhos de autorização completos ou conteúdo sensível de prompts. Use um gerenciador de segredos em produção e gire as credenciais em um cronograma definido.

## Como transmitir respostas da API MiMo-V2.5

O streaming reduz a latência percebida para respostas longas. O serviço retorna eventos incrementais, que o SDK expõe como fragmentos.
for chunk in stream:
delta = chunk.choices[0].delta.content
if delta:
print(delta, end="", flush=True)
Em um serviço web, encaminhe deltas com Server-Sent Events ou mensagens WebSocket, trate desconexões do cliente e interrompa a geração upstream quando o usuário cancelar.

## Fluxos de trabalho multimodais e estruturados da API MiMo-V2.5

Para tarefas com reconhecimento de imagem, envie uma instrução de texto mais um objeto de imagem na mesma mensagem do usuário. A representação exata de mídia aceita pode variar por rota do provedor, portanto trate isso como um padrão de payload e confirme o suporte da rota atual.
{
"model": "mimo-v2.5",
"messages": [
{
"role": "user",
"content": [
{"type": "text", "text": "Extract the visible error and suggest the next diagnostic step."},
{"type": "image_url", "image_url": {"url": "https://example.com/error.png"}}
]
}
]
}
Para saída legível por máquina, solicite um objeto JSON compacto e valide-o contra seu próprio esquema. Nunca presuma que um JSON gerado é seguro apenas porque faz parse.
import json
raw = response.choices[0].message.content
result = json.loads(raw)
## Preços da API MiMo-V2.5 na CometAPI e controle de custos

| Rota                           | Entrada por 1M de tokens | Saída por 1M de tokens | Exemplo com 100 solicitações |
| ----------------------------- | ------------------------ | ---------------------- | ---------------------------- |
| MiMo-V2.5                     | $0.112                   | $0.224                 | $0.1568                      |
| MiMo-V2.5 Pro                 | $0.348                   | $0.696                 | $0.4872                      |
| Referência de pagamento conforme o uso da Xiaomi | $0.14    | $0.28                  | $0.1960                      |

O exemplo assume 100 solicitações, cada uma com 10.000 tokens de entrada e 2.000 tokens de saída. Nessas condições, a rota MiMo-V2.5 é cerca de 68% mais barata do que a MiMo-V2.5 Pro. As [tarifas publicadas de pagamento conforme o uso da Xiaomi](https://platform.xiaomimimo.com/docs/zh-CN/integration/roocode) fornecem um ponto de referência útil, enquanto as faturas reais devem ser verificadas em relação ao preço do provedor ativo antes da implantação.
Pro input: 100 × 10,000 / 1,000,000 × $0.348 = $0.3480
Pro output: 100 × 2,000 / 1,000,000 × $0.696 = $0.1392
Pro total: $0.4872
Controle custos com limites de saída máxima, compressão de prompt, contexto em cache, classificação de solicitações e um roteador que só escale tarefas difíceis. Acompanhe o custo por tarefa bem-sucedida em vez do custo por solicitação; uma solicitação mais barata que falha repetidamente pode sair mais cara no geral.

## Como projetar solicitações de API MiMo-V2.5 com contexto longo

Uma janela de 1M de tokens torna entradas maiores possíveis, mas não remove trade-offs de recuperação e atenção. Construa o prompt para que o modelo localize rapidamente a evidência relevante.

* Coloque a tarefa, o contrato de saída e os critérios de decisão próximo ao início.
* Separe documentos com identificadores estáveis e delimitadores claros.
* Inclua apenas evidências que possam afetar a resposta.
* Peça ao modelo que cite identificadores de documentos ou referências de linha no resultado.
* Meça a acurácia conforme o contexto cresce; não trate o contexto máximo como o contexto ideal.

> Contexto longo aumenta tanto o custo de tokens quanto a chance de material irrelevante distrair o modelo. Recuperação, sumarização e prompting hierárquico continuam importantes mesmo quando o corpus completo cabe.

## Confiabilidade em produção

### Repetir apenas falhas transitórias

Repita limites de taxa e falhas temporárias do servidor com backoff exponencial e jitter. Não repita automaticamente autenticação inválida, payloads malformados ou erros de política.
for attempt in range(5):
try:
result = call_model()
break
except TransientAPIError:
if attempt == 4:
raise
time.sleep(delay_for(attempt))
### Definir proteções operacionais

* Use timeouts de conexão e de solicitação geral.
* Anexe uma chave de idempotência a fluxos com efeitos colaterais externos.
* Registre o ID do modelo, latência, tokens de entrada e saída, contagem de repetições e status final.
* Redija segredos e dados pessoais antes de registrar.
* Exija listas de permissão de ferramentas e confirmação para ações destrutivas.
* Mantenha um modelo de fallback ou fila para indisponibilidade do provedor.

## Erros comuns da API MiMo-V2.5 e soluções

| Sintoma       | Causa provável                                 | Ação recomendada                                                |
| ------------- | ---------------------------------------------- | ----------------------------------------------------------------|
| 401 ou 403    | Chave de API ausente, inválida ou não autorizada | Verifique o segredo no lado do servidor e as permissões do projeto. |
| 400           | Mensagens malformadas ou objeto de mídia não suportado | Valide o JSON e confirme o suporte ao payload específico da rota. |
| 413           | Corpo da solicitação muito grande              | Reduza o tamanho da mídia ou divida a entrada.                  |
| 429           | Limite de taxa ou cota                         | Aplique backoff com jitter e imponha limites de concorrência no cliente. |
| 5xx           | Falha temporária do provedor                   | Repita dentro de um orçamento limitado ou faça failover.        |
| Resposta lenta| Grande contexto, saída longa ou latência de ferramenta | Transmita a saída, limite tokens e faça perfil de cada etapa.   |
| JSON inválido | Deriva na geração                              | Valide, repare uma vez se for seguro e rejeite falhas persistentes. |

## Conclusão

O modelo MiMo-V2.5 é o ponto de partida mais forte para equipes que precisam de entrada multimodal, grande contexto e controle agressivo de custos. A versão Pro deve ser uma escalada deliberada para tarefas em que ganhos de qualidade medidos justificam o preço mais alto. Comece com um conjunto de avaliação pequeno, instrumente cada solicitação e promova a integração somente após testar payloads reais, comportamento em contexto longo, tratamento de repetição e recuperação de falhas.

## Perguntas frequentes

### Qual endpoint devo usar?

Use `/api.cometapi.com/v1/chat/completions`, ou defina `/api.cometapi.com/v1` como a URL base em um SDK compatível com OpenAI.

### Qual identificador de modelo devo enviar?

Use `mimo-v2.5` para a rota MiMo-V2.5. Confirme o identificador atual antes do lançamento se sua conta usar um alias específico do provedor.

### Quando devo escolher MiMo-V2.5 Pro?

Escolha MiMo-V2.5 Pro quando sua avaliação mostrar uma vantagem material em tarefas difíceis de codificação, raciocínio ou ferramentas de longa duração. Mantenha o tráfego rotineiro ou multimodal na rota MiMo-V2.5 quando sua qualidade for suficiente.

### Um contexto de 1M de tokens significa que devo enviar tudo?

Não. Um grande contexto é um limite de capacidade, não um alvo de design de prompt. Recupere e organize as evidências que podem afetar a resposta e, em seguida, meça qualidade e custo conforme a entrada cresce.

### Posso chamar a API diretamente de um navegador?

Não exponha uma chave de API secreta no código do frontend. Chame o provedor a partir do seu backend e aplique autenticação, limites de taxa, logging e controles de dados lá.

### Como verifico o suporte multimodal?

Teste o payload exato de mídia contra a rota ativa do provedor. As modalidades nativas do modelo subjacente não garantem que cada rota exponha todos os formatos da mesma maneira.