

TL;DR
MiMo-V2.5 é a opção padrão mais forte para trabalho multimodal, agentes rotineiros e produção sensível a custos. MiMo-V2.5-Pro é a opção especializada para raciocínio difícil, programação em escala de repositório e uso de ferramentas de longa duração. Ambos fornecem uma janela de contexto de 1M tokens e até 128K tokens de saída, mas o Pro usa um backbone de linguagem muito maior e custa cerca de 3,1× mais para tokens comuns de entrada e saída.
MiMo-V2.5 vs. Pro: Quick Decision
| Specification — official release | MiMo-V2.5 | MiMo-V2.5-Pro | Recommended model | Reason |
|---|---|---|---|---|
| Primary positioning | Omni-modal model and efficient agents | Flagship agent and complex coding | Choose by workload | Omni-modal inputs favor V2.5; sustained difficult text work favors Pro. |
| Architecture | Sparse MoE | Sparse MoE | Choose by workload | Model size alone does not establish a better choice for every task. |
| Total parameters | 310B | 1.02T | Choose by workload | The larger model targets difficult reasoning, but total size is not a task outcome. |
| Activated parameters | 15B | 42B | Choose by workload | Use task completion and cost to decide. |
| LLM layers | 48 | 70 | Choose by workload | Layer count describes architecture, not a universal win. |
| Routed experts | 256 | 384 | Choose by workload | The difference matters only if it improves the target workload. |
| Experts activated per token | 8 | 8 | Either | Both activate eight experts per token. |
| Context window | 1M tokens | 1M tokens | Either | Both advertise a 1M-token window; test effective retrieval. |
| Maximum output | 128K tokens | 128K tokens | Either | Both advertise up to 128K output tokens. |
| Input modalities | Text, image, video, and audio | Text | MiMo-V2.5 | It accepts image, video, and audio input; Pro is text-input focused. |
| Tool calling | Yes | Yes | Choose by workload | Both call tools; test success rate on the actual trajectory. |
| Open weights and license | Yes; MIT | Yes; MIT | Either | Both offer open weights under MIT; serving costs differ. |
The Decisive Difference: Multimodal vs Agent-First
V2.5 aceita nativamente texto, imagens, vídeo e áudio. A Xiaomi combina o backbone de linguagem com um codificador de visão de 729M parâmetros e um codificador de áudio de 261M parâmetros, permitindo que informações multimodais participem diretamente do mesmo fluxo de raciocínio.
- Analisar capturas de tela antes de chamar ferramentas.
- Entender um vídeo e sua trilha de áudio em conjunto.
- Extrair informações de diagramas e imagens de documentos.
- Operar agentes de suporte de interface visual e multimodais.
- Raciocinar sobre longas sequências de vídeo.
V2.5-Pro segue um design diferente. A Xiaomi atualmente especifica texto como modalidade de entrada e enfatiza raciocínio profundo, desenvolvimento de código e orquestração de ferramentas de longa duração.
Se o fluxo de trabalho em si contiver entrada de imagem, vídeo ou áudio, comece com o V2.5. Teste o Pro quando a parte difícil for raciocinar sobre texto, código-fonte, ferramentas ou uma trajetória longa de agente.

Comparação oficial de benchmark multimodal da Xiaomi.
Why V2.5-Pro Can Be Better on Hard Tasks
Model Scale: 310B/15B vs. 1.02T/42B
Os dois modelos usam backbones esparsos de Mixture-of-Experts, atenção híbrida de janela deslizante e global, e três módulos de Predição Multi-Token. O model card do V2.5 documenta um backbone com 310B de parâmetros totais e 15B ativos; o model card do Pro escala isso para 1.02T de parâmetros totais com 42B ativados por token.
| Architecture — official model card | V2.5 | Pro | Difference |
|---|---|---|---|
| Total parameters | 310B | 1.02T | About 3.3× |
| Active parameters | 15B | 42B | 2.8× |
| Hidden size | 4,096 | 6,144 | 1.5× |
| LLM layers | 48 | 70 | 22 more |
| Attention heads | 64 | 128 | 2× |
| Routed experts | 256 | 384 | 1.5× |
| Experts per token | 8 | 8 | Same |
| MTP layers | 3 | 3 | Same |
V2.5 usa um padrão de atenção 5:1, enquanto o Pro adota um padrão local-para-global de 6:1. A Xiaomi afirma que esses designs reduzem os requisitos de cache de KV em quase 6× e 7×, respectivamente, em comparação com atenção completa em toda a rede.
Parâmetros totais não se traduzem linearmente em qualidade de resposta. O backbone maior do Pro importa mais quando a dificuldade do raciocínio ou o comprimento da trajetória faz com que pequenos ganhos de confiabilidade por etapa se acumulem.
Why Small Reliability Gains Compound
Uma tarefa longa de agente tem muitas etapas dependentes. Um erro em uma chamada de ferramenta inicial pode forçar novas tentativas ou invalidar o trabalho posterior, então um ganho modesto na confiabilidade por etapa pode ter um efeito maior na conclusão de ponta a ponta. Avalie esse efeito em tarefas representativas em vez de assumir que o tamanho do modelo o garante.
Where Does V2.5-Pro Actually Improve?
A comparação numérica mais limpa é a avaliação do modelo base da Xiaomi, onde ambos os modelos aparecem sob as mesmas configurações. Isso evita combinar resultados produzidos por harnesses não relacionados ou configurações de pós-treinamento diferentes.
General Knowledge: Small to Moderate Gains
Na comparação do modelo base da Xiaomi, o Pro ganha 1,2 pontos no BBH, 3,1 no MMLU e 2,7 no MMLU-Pro. São ganhos mensuráveis, mas menores do que em tarefas de raciocínio mais difíceis.
Mathematics and Science: Larger Gains
O Pro ganha 8,6 pontos no GPQA-Diamond, 16,3 no GSM8K e 18,5 no MATH na mesma avaliação de modelo base. Esta é a evidência mais clara para escolher o Pro quando o raciocínio difícil impulsiona o sucesso da tarefa.
Coding: Better, but Not Uniformly Better
Os ganhos relatados são de 4,3 pontos no HumanEval+, 3,2 no MBPP+, 4,1 no LiveCodeBench v6 e 4,9 no SWE-Bench AgentLess. Teste separadamente tarefas em nível de repositório e uso de ferramentas: essas pontuações de modelo base não medem todo fluxo de trabalho de agente em produção.
Resultado do benchmark: O Pro não é três vezes melhor porque custa cerca de três vezes mais. Ele se torna progressivamente mais valioso à medida que a dificuldade do raciocínio e a duração da tarefa aumentam.
Essas linhas são avaliações de modelos base, não uma promessa de que uma API de produção reproduzirá as mesmas pontuações. Resultados de agentes dependem de ferramentas, prompts, novas tentativas, ambiente de execução e orçamentos de tokens.
Post-Training and Long-Horizon Agents
Os modelos de produção adicionam fine-tuning supervisionado, aprendizado por reforço orientado a agentes e destilação on-policy com múltiplos professores. A Xiaomi relata pontuações de pós-treinamento de 56,1 no SWE-bench Pro, 65,8 no Terminal-Bench 2.0 e 62,1 Pass³ na parte geral do Claw-Eval para o V2.5.
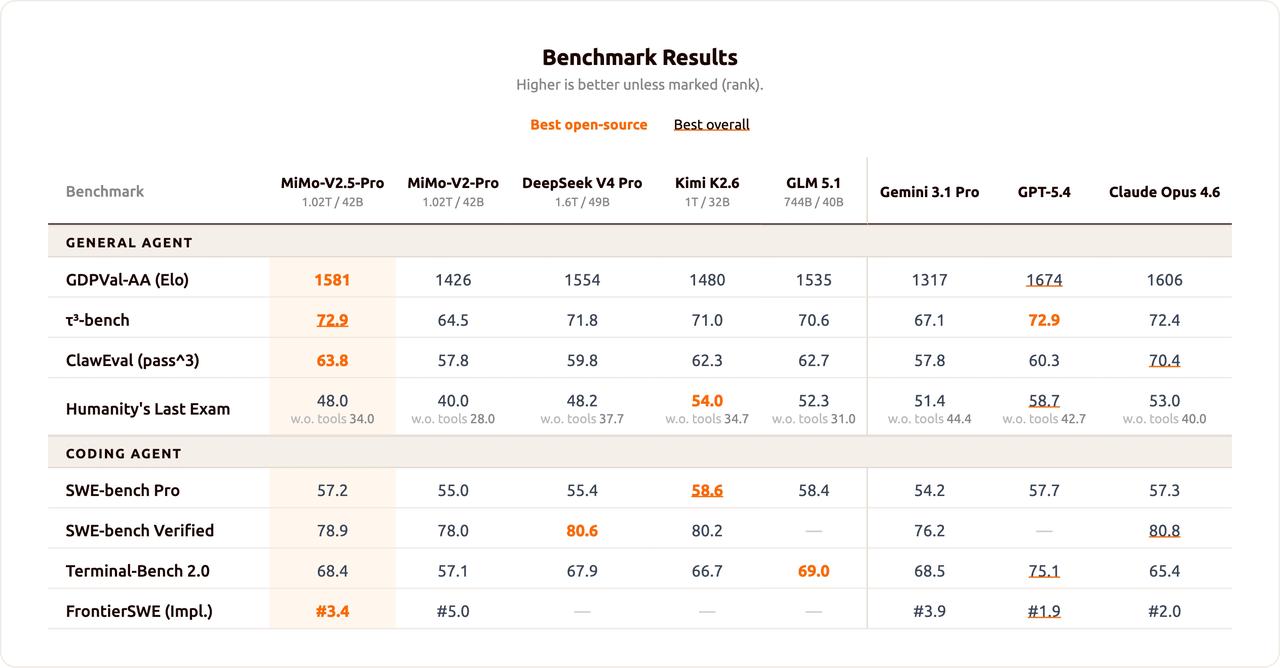
O Pro é mais explicitamente otimizado para engenharia de software de longo horizonte. A Xiaomi descreve centenas de chamadas de ferramentas em trajetórias sustentadas e publica um resultado de 78.9% no SWE-bench Verified.
Um estudo de caso oficial mostra o Pro concluindo um compilador SysY em 4,3 horas com 672 chamadas de ferramentas e todos os 233 testes aprovando. A lição não é que toda solicitação de código precisa do Pro; é que pequenas diferenças de confiabilidade podem determinar se um fluxo de trabalho com centenas de ações dependentes é concluído.

Figura oficial de benchmark de codificação e agentes da Xiaomi.
Long Context: Same Capacity, Different Workloads
Ambos os modelos fornecem uma janela de contexto de 1M tokens e até 128K tokens de saída pela API atual da Xiaomi. Portanto, o tamanho bruto do contexto não os diferencia.
V2.5 é atraente quando o contexto longo inclui material multimodal como vídeo, imagens de documentos ou rastros visuais de agentes. Pro é o modelo a testar quando o próprio contexto se torna o problema de raciocínio: um repositório grande, um contrato longo, um corpus de pesquisa ou uma trajetória de agente contendo muitas ações sequenciais.
Uma janela de contexto grande descreve capacidade, não fidelidade de raciocínio garantida. Avalie a recuperação, retenção de instruções e uso de evidências nos comprimentos que importam para a aplicação.
Price and Cost Efficiency
Os preços pay-as-you-go no exterior da Xiaomi deixam a troca clara.
| Pricing — official price sheet | V2.5 | Pro | Ratio |
|---|---|---|---|
| Uncached input per 1M tokens | $0.14 | $0.435 | 3.11× |
| Cached input per 1M tokens | $0.0028 | $0.0036 | 1.29× |
| Output per 1M tokens | $0.28 | $0.87 | 3.11× |
| Context window | 1M | 1M | Same |
| Maximum output | 128K | 128K | Same |
Uma solicitação com 1M tokens de entrada sem cache e 200K tokens de saída custa um valor estimado de $0.196 no V2.5 e $0.609 no Pro antes de acertos de cache, cobranças de busca web ou faturamento específico do provedor.
A diferença de preço do cache é menor: o Pro é cerca de 29% mais caro para entrada com acerto de cache, em vez de 211% mais caro. Agentes de longa duração com prompts de sistema, definições de ferramentas ou prefixos de repositório estáveis devem, portanto, medir sua taxa real de acerto de cache.
Estime o custo por tarefa bem-sucedida. Um agente Pro que conclui um fluxo de trabalho difícil uma vez pode custar menos do que tentativas repetidas fracassadas em um modelo mais barato.
Which Model Should You Use?
| Workload — official guidance | Better choice | Why |
|---|---|---|
| Routine text chat | V2.5 | Lower cost; Pro often unnecessary |
| High-volume generation | V2.5 | About 3.1× lower standard token price |
| Image, video, or audio understanding | V2.5 | Native multimodal input |
| Routine tool calling | V2.5 | Strong agent capability at lower cost |
| Difficult mathematics and science | Pro | Larger benchmark gains |
| Repository-scale coding | Pro | Designed for complex software engineering |
| Hundreds of dependent tool calls | Pro | Better fit for sustained execution |
| Cost-sensitive 1M context | V2.5 | Same nominal context at much lower cost |
Resultado da seleção: V2.5 é o padrão para aplicações multimodais, agentes rotineiros e workloads sensíveis a custos. Pro é o upgrade para raciocínio difícil, engenharia de software complexa e trajetórias autônomas longas.
A Better Production Strategy: Route Between Both
Uma escolha global única de modelo muitas vezes é desnecessária. Roteie solicitações multimodais e rotineiras para o V2.5, depois escale apenas raciocínio textual difícil, programação complexa ou execução de longo horizonte para o Pro.
| Evaluation dimension | Measure | Why it matters | Routing signal |
|---|---|---|---|
| Completion | Successful tasks / attempts | Captures end-to-end reliability | Escalate low-completion classes |
| Quality | Human or rubric score | Prevents token cost from dominating | Escalate high-stakes tasks |
| Tool reliability | Errors and retries | Small errors compound in agents | Escalate long trajectories |
| Latency | Time to accepted result | Includes retry overhead | Keep interactive tasks lightweight |
| Cost | Spend per accepted task | Reflects failures and reruns | Use the cheapest model that succeeds |
Test Both APIs in CometAPI
MiMo-V2.5 API in CometAPI e MiMo-V2.5-Pro API in CometAPI suportam avaliação lado a lado por meio de uma camada de agregação. Envie os mesmos prompts, instruções de sistema, ferramentas e limites de saída para ambos os modelos e compare sucesso da tarefa e custo.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Execute um lote representativo contendo solicitações diretas, raciocínio difícil, edição de código, tarefas de contexto longo e chamadas de ferramentas de agente. Registre taxa de conclusão, tokens, latência, erros de ferramentas, novas tentativas, qualidade da resposta e custo por tarefa bem-sucedida.
Limitations
V2.5 limitations
O backbone de linguagem menor deixa desempenho na mesa à medida que a dificuldade do raciocínio aumenta. A diferença é modesta no BBH, mas torna-se muito maior no GPQA-Diamond e no MATH. Uma janela de contexto de 1M tokens também não deve ser confundida com fidelidade de raciocínio garantida em 1M tokens.
Pro limitations
Os preços de entrada e saída comuns do Pro são cerca de 3,1× os do V2.5, e sua entrada somente texto o torna inadequado como substituição direta para aplicações multimodais. O modelo de pesos abertos com 1.02T parâmetros também é um projeto exigente para auto-hospedagem, embora 42B parâmetros sejam ativados por token.
Final Verdict
Escolha V2.5 para aplicações multimodais, agentes rotineiros e produção sensível a custos. Escolha Pro para raciocínio difícil, engenharia de software complexa e agentes autônomos de longa duração. Para cargas mistas, roteie a maior parte do tráfego para o V2.5 e escale apenas solicitações cuja dificuldade ou comprimento da trajetória justificam o custo adicional.
FAQ
O Pro é sempre melhor que o V2.5?
Não. O Pro é mais forte em raciocínio textual difícil e programação, mas o V2.5 suporta entrada de imagem, vídeo e áudio e é substancialmente mais barato.
Ambos os modelos suportam uma janela de contexto de 1M tokens?
Sim. Ambos anunciam 1M tokens de contexto e até 128K tokens de saída. As aplicações ainda devem testar recuperação e raciocínio nos comprimentos reais de operação.
Qual modelo um agente multimodal deve usar?
Comece com o V2.5 porque ele aceita nativamente entrada visual e de áudio. O Pro atualmente tem como alvo fluxos de trabalho com entrada de texto.
Quando o Pro vale o seu preço mais alto?
É mais defensável quando melhor confiabilidade de raciocínio afeta a conclusão de matemática difícil, programação em escala de repositório ou trajetórias longas contendo muitas chamadas de ferramentas dependentes.
Os sistemas de produção devem usar apenas um modelo?
Não necessariamente. Uma camada de roteamento pode manter trabalho rotineiro e multimodal no V2.5 enquanto escala raciocínio textual difícil e tarefas de agente para o Pro.