O que é a API GPT-5.2
A API GPT-5.2 é a mesma que GPT-5.2 Thinking no ChatGPT. GPT-5.2 Thinking é a variante de nível intermediário da família GPT-5.2 da OpenAI, projetada para trabalho mais profundo: raciocínio em múltiplas etapas, sumarização de documentos longos, geração de código de qualidade e trabalho profissional de conhecimento em que precisão e estrutura utilizável importam mais do que o throughput bruto. Na API, ela é exposta como o modelo gpt-5.2 (Responses API / Chat Completions), posicionando-se entre a variante Instant de baixa latência e a variante Pro de maior qualidade, porém mais cara.
Principais recursos
- Contexto muito longo e compactação: janela efetiva de 400K e ferramentas de compactação para gerenciar a relevância ao longo de conversas e documentos extensos.
- Esforço de raciocínio configurável:
none | medium | high | xhigh(xhigh habilita o máximo de cálculo interno para raciocínios difíceis).xhighestá disponível nas variantes Thinking/Pro. - Suporte mais robusto a ferramentas e funções: chamadas de ferramentas de primeira classe, gramáticas (CFG/Lark) para restringir saídas estruturadas e comportamentos agênticos aprimorados que simplificam automações complexas em múltiplas etapas.
- Compreensão multimodal: compreensão mais rica de imagem + texto e integração em tarefas de múltiplas etapas.
- Segurança aprimorada / tratamento de conteúdo sensível: intervenções direcionadas para reduzir respostas indesejáveis em áreas como autolesão e outros contextos sensíveis.
Capacidades técnicas e especificações (visão do desenvolvedor)
- Endpoints de API e IDs de modelo:
gpt-5.2para Thinking (Responses API),gpt-5.2-chat-latestpara fluxos de chat/instant, egpt-5.2-propara o nível Pro; disponível via Responses API e Chat Completions onde indicado. - Tokens de raciocínio e gestão de esforço: a API suporta parâmetros explícitos para alocar computação (esforço de raciocínio) por requisição; esforços maiores aumentam a latência e o custo, mas melhoram a qualidade da saída para tarefas complexas.
- Ferramentas de saída estruturada: suporte a gramáticas (Lark / CFG) para restringir a saída do modelo a uma DSL ou sintaxe exata (útil para SQL, JSON, geração de DSL).
- Chamadas paralelas de ferramentas e coordenação agêntica: paralelismo aprimorado e orquestração de ferramentas mais limpa reduzem a necessidade de prompts de sistema elaborados e estruturação multiagente.
Desempenho em benchmarks e dados de suporte
A OpenAI publicou diversos resultados de benchmarks internos e externos para o GPT-5.2. Destaques selecionados (números reportados pela OpenAI):
- GDPval (44 ocupações, trabalho de conhecimento) — GPT-5.2 Thinking “supera ou iguala os principais profissionais do setor em 70,9% das comparações”; a OpenAI reporta que as saídas foram produzidas a >11× a velocidade e <1% do custo de profissionais especialistas nas tarefas GDPval (as estimativas de velocidade e custo são baseadas em histórico). Essas tarefas incluem modelos de planilhas, apresentações e vídeos curtos.
- SWE-Bench Pro (codificação) — GPT-5.2 Thinking alcança ≈55,6% no SWE-Bench Pro e ~80% no SWE-Bench Verified (apenas Python), segundo a OpenAI, estabelecendo um novo estado da arte para avaliação de geração de código/engenharia em seus testes. Isso se traduz em depuração mais confiável e correções de ponta a ponta na prática, de acordo com exemplos da OpenAI.
- GPQA Diamond (Q&A em nível de pós-graduação em ciências) — GPT-5.2 Pro: 93,2%, GPT-5.2 Thinking: 92,4% no GPQA Diamond (sem ferramentas, raciocínio máximo).
- Série ARC-AGI — No ARC-AGI-2 (um benchmark de raciocínio fluido mais difícil), GPT-5.2 Thinking obteve 52,9% e GPT-5.2 Pro 54,2% (a OpenAI afirma que são novas marcas de estado da arte para modelos no estilo “cadeia de pensamento”).
- Contexto longo (OpenAI MRCRv2) — GPT-5.2 Thinking apresenta precisão quase 100% na variante MRCR de 4-needle até 256k tokens e pontuações substancialmente melhores vs GPT-5.1 em cenários de contexto longo. (A OpenAI publicou gráficos e tabelas do MRCRv2.)
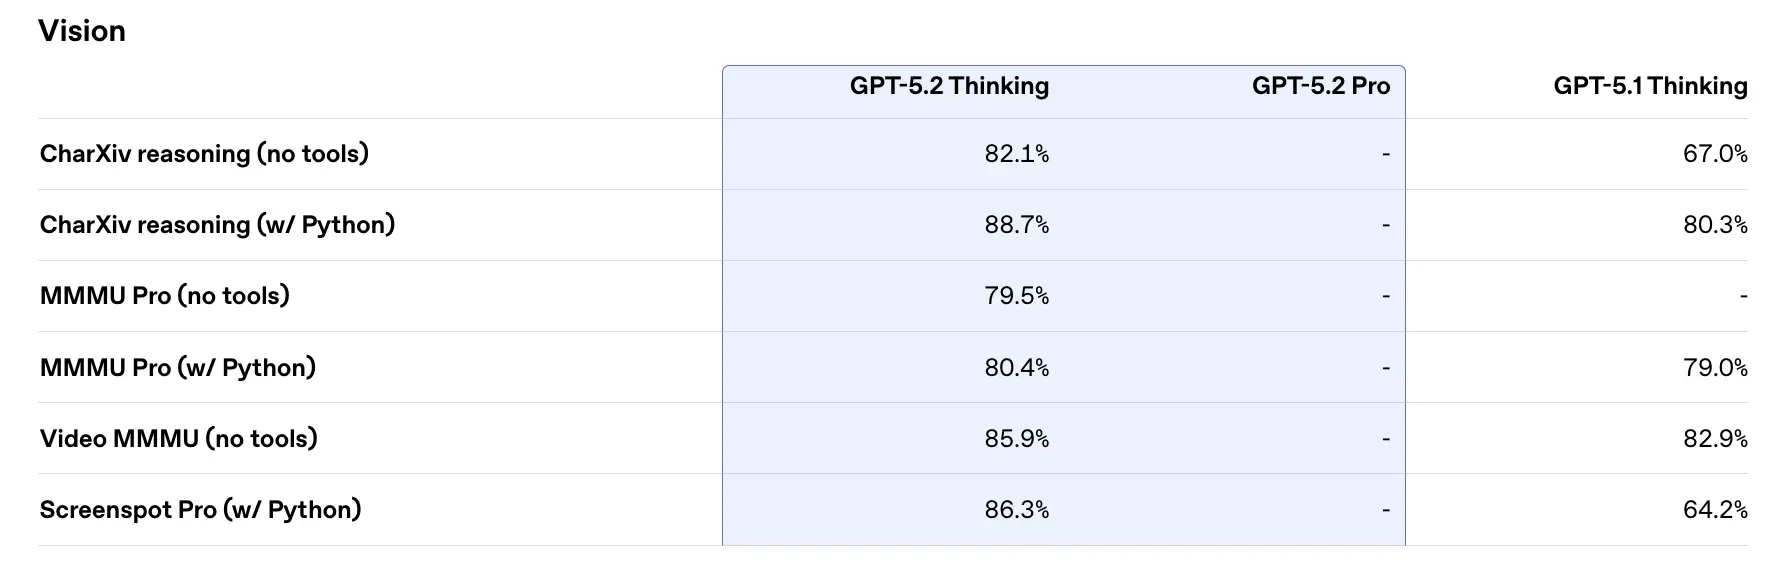
Comparação com contemporâneos
- vs Google Gemini 3 (Gemini 3 Pro / Deep Think): Gemini 3 Pro foi divulgado com uma janela de contexto de tokens de ~1.048.576 (≈1M) e entradas multimodais amplas (texto, imagem, áudio, vídeo, PDFs), além de integrações agênticas robustas via Vertex AI / AI Studio. No papel, a janela de contexto maior do Gemini 3 é um diferenciador para cargas de trabalho extremamente grandes em sessão única; os trade-offs incluem superfície de ferramentas e adequação ao ecossistema.
- vs Anthropic Claude Opus 4.5: Opus 4.5 enfatiza fluxos de trabalho de programação/agentes para empresas e reporta fortes resultados no SWE-bench e robustez para sessões agênticas longas; a Anthropic posiciona o Opus para automação e geração de código com uma janela de contexto de 200k e integrações especializadas de agente/Excel. Opus 4.5 é um concorrente forte em automação empresarial e tarefas de código.
Conclusão prática: GPT-5.2 busca um conjunto equilibrado de melhorias (contexto de 400k, saídas com muitos tokens, raciocínio/codificação aprimorados). Gemini 3 mira os contextos de sessão única absolutamente maiores (≈1M), enquanto Claude Opus foca em engenharia empresarial e robustez agêntica. Escolha combinando tamanho de contexto, necessidades de modalidade, adequação de recursos/ferramentas e trade-offs de custo/latência.
Como acessar e usar a API GPT-5.2
Etapa 1: Cadastre-se para obter a chave de API
Faça login em cometapi.com. Se você ainda não é nosso usuário, registre-se primeiro. Acesse seu console do CometAPI. Obtenha a credencial de acesso, a chave de API da interface. Clique em “Add Token” no token de API no centro pessoal, obtenha a chave do token: sk-xxxxx e envie.
Etapa 2: Envie solicitações para a API GPT-5.2
Selecione o endpoint “gpt-5.2” para enviar a solicitação de API e defina o corpo da requisição. O método e o corpo da requisição são obtidos na documentação de API em nosso site. Nosso site também fornece teste no Apifox para sua conveniência. Substitua <YOUR_API_KEY> pela sua chave CometAPI real da sua conta. Os desenvolvedores chamam isso via endpoints da Responses API / Chat.
Insira sua pergunta ou solicitação no campo de conteúdo — é isso que o modelo responderá. Processe a resposta da API para obter a resposta gerada.
Etapa 3: Recuperar e verificar os resultados
Processe a resposta da API para obter a resposta gerada. Após o processamento, a API responde com o status da tarefa e os dados de saída.
Veja também Gemini 3 Pro Preview API