Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
Como reduzir os custos com tokens de um agente de IA em produção
Reduza os custos de tokens do agente de IA controlando o crescimento do contexto, a saída das ferramentas, as tentativas, o raciocínio e os subagentes. Inclui um exemplo de custo em 12 etapas.
Mia MarenEquipe de pesquisa de modelos e API de IA
Os custos de tokens de agentes de IA aumentam quando cada etapa processa repetidamente instruções, histórico da conversa, resultados de ferramentas e estado intermediário.
Reduza o volume de tokens com orçamentos no nível da execução, filtragem de resultados de ferramentas, compactação de contexto, limites de tentativas e raciocínio controlado. Use cache de prompt para entradas estáveis e repetidas, mas otimize o loop do agente antes de migrar para um modelo mais barato.
A métrica de produção mais útil é o custo por tarefa bem-sucedida, medido em toda a execução — não o preço por requisição ou o tamanho do contexto da chamada final.
Este guia foca especificamente em agentes de IA de múltiplas etapas. Ele explica como o contexto repetido se acumula ao longo da execução, como identificar a maior fonte de desperdício e quais controles implementar primeiro.
Introduction
Um chatbot pode fazer uma chamada de modelo por mensagem do usuário. Um agente de IA pode fazer 10, 20 ou mais chamadas antes de completar uma tarefa.
Revisado para maior clareza, atribuição de fontes e terminologia de API atual.
Cada etapa pode reenviar instruções, histórico da conversa, resultados de ferramentas e estado intermediário. Tentativas, raciocínio e subagentes aumentam ainda mais o uso, então uma resposta final curta ainda pode consumir um grande número de tokens.
À medida que o uso escala, esses custos se tornam mais difíceis de prever e podem reduzir rapidamente as margens do produto. Diminuí-los exige otimizar todo o loop do agente — não apenas trocar para um modelo mais barato.
Este artigo concentra-se em custos específicos de Agentes. Para um guia mais amplo cobrindo cache de prompt, cache de resposta exata, cache semântico, roteamento de modelos e gestão geral de custos de API, veja Como Reduzir Custos de API de IA.
Why Do AI Agent Token Costs Compound?
Em um agente de múltiplas etapas, o custo de uma tarefa é a soma de todas as chamadas de modelo — não apenas a resposta final.
As principais fontes de uso de tokens em Agentes são:
Fonte de custo
O que causa
Primeiro controle a testar
Instruções repetidas
Prompts de sistema, esquemas de ferramentas, políticas, exemplos
Estabilizar o prefixo reutilizável
Histórico crescente
Turnos anteriores são reenviados a cada etapa
Compactar ou recuperar seletivamente o estado
Resultados de ferramentas
Páginas de busca, arquivos, logs e registros de banco de dados
Filtrar antes de adicioná-los ao contexto
Saída intermediária
Planos, mensagens de status e decisões verbosas de ferramentas
Usar saídas estruturadas compactas
Tokens de raciocínio
Esforço elevado de raciocínio em etapas rotineiras
Adequar o esforço à complexidade da tarefa
Tentativas
Saída inválida, timeouts, erros de ferramentas e limites de taxa
Classificar falhas e limitar tentativas
Subagentes
Subagentes duplicam contexto, ferramentas e análise
Enviar a cada subagente um recorte estreito de contexto
Há duas maneiras distintas de reduzir a conta:
Processar menos tokens por meio de filtragem, compactação, limites de saída e controles do loop.
Reduzir o preço efetivo dos tokens necessários via cache de prompt ou seleção de modelos.
Distinção-chave: O cache de prompt reduz o custo de entradas repetidas. A compactação de contexto reduz a própria entrada repetida.
How Can a 12-Step Agent Process 147,000 Tokens?
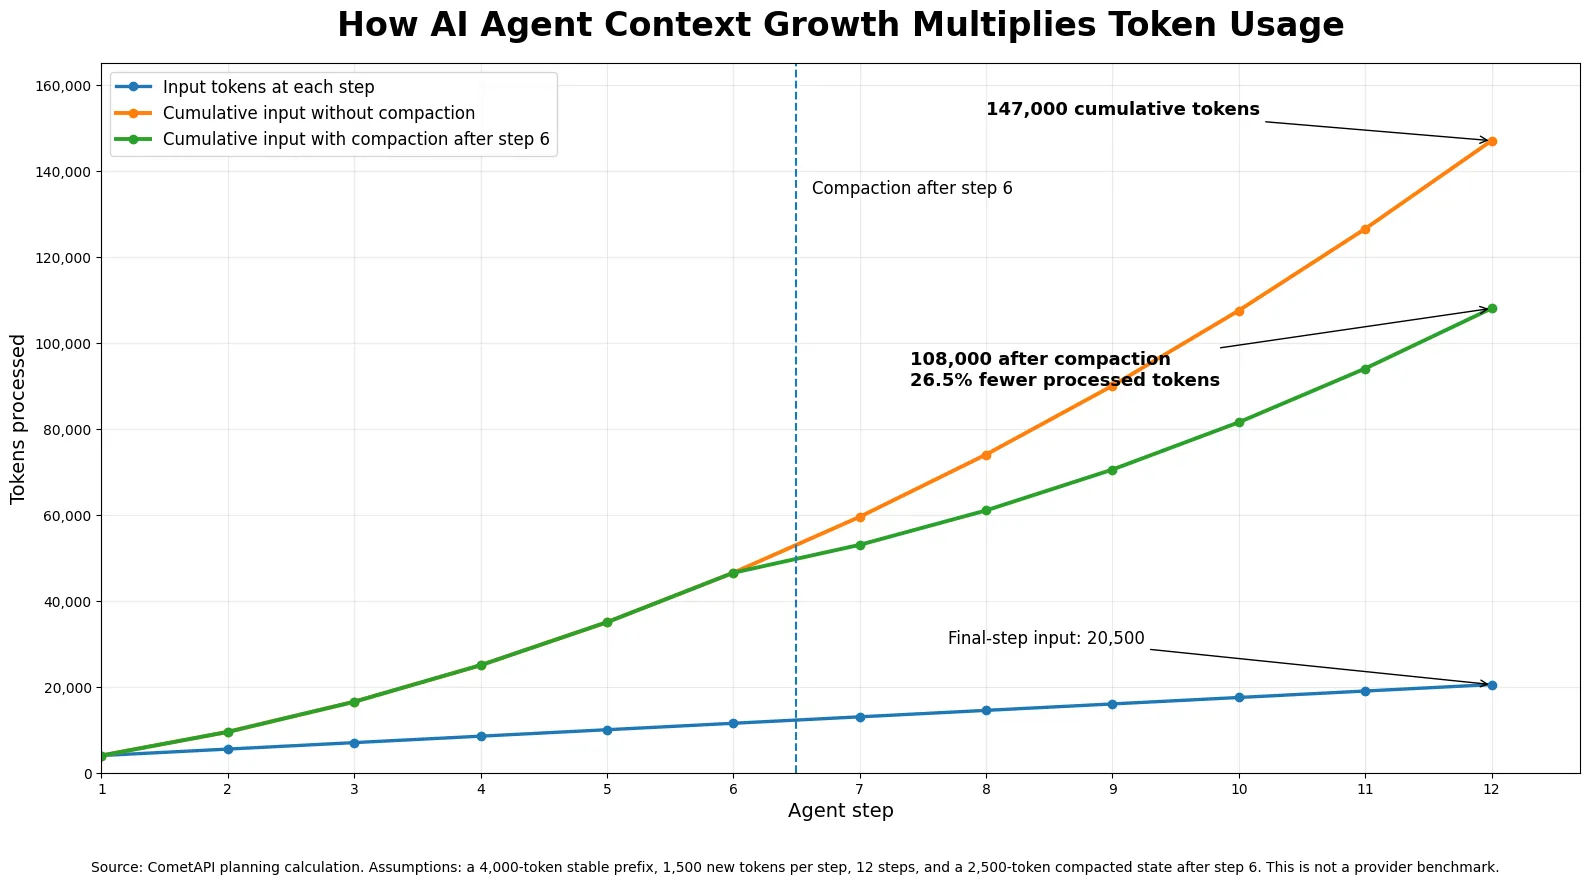
Considere um agente de suporte hipotético com:
Um prefixo estável de 4.000 tokens
1.500 novos tokens adicionados após cada etapa
O histórico acumulado completo reenviado em cada requisição
A chamada final contém apenas 20.500 tokens de entrada, mas toda a execução processa 147.000 tokens de entrada cumulativos.
Agora aplique dois controles:
Faça cache do prefixo estável de 4.000 tokens após a primeira chamada.
Compacte o histórico após a etapa seis em um resumo de estado de 2.500 tokens.
Cenário
Entrada sem cache
Entrada em cache
Total de entrada processada
Mudança
Histórico completo em cada etapa
147.000
0
147.000
Linha de base
Prefixo estável em cache
103.000
44.000
147.000
Mesmo volume, mistura mais barata
Cache + compactação
64.000
44.000
108.000
26,5% menos tokens processados
Este é um cálculo de planejamento, não um benchmark de provedor.
Ele presume que cada requisição inclui o histórico acumulado completo. Agentes que constroem estado seletivamente, resumem mensagens antigas ou recuperam apenas informações relevantes podem seguir uma curva de custo diferente.
Regra de crescimento de custo: Meça a entrada cumulativa ao longo de toda a execução. O tamanho do contexto final não representa o total de tokens processados.
Which Metrics Reveal Agent Token Waste?
Não comece trocando modelos. Primeiro identifique onde o fluxo de trabalho está gastando tokens sem melhorar o resultado.
Registre estes campos em cada etapa do Agente:
Campo
Por que importa
run_id, step_id, parent_step_id
Reconstrói a árvore do Agente e subagentes
Tokens de entrada renderizados
Mostra como o contexto cresce entre chamadas
Entrada em cache e sem cache
Separa reutilização de novo contexto
Tokens de saída e de raciocínio
Identifica etapas caras de geração
Tamanho do resultado de ferramenta e tokens retidos
Mostra quanto de evidência bruta entra em prompts posteriores
Motivo da tentativa e número da tentativa
Identifica falhas repetidas
Tokens de compactação antes e depois
Mede a redução real de contexto
ID do subagente e tokens retornados
Revela trabalho duplicado de subagentes
Resultado aceito, rejeitado ou escalado
Conecta custo à qualidade da tarefa
A métrica primária deve ser:
cost per successful task
= total workflow cost
/ accepted tasks
Uma execução mais barata não é uma melhoria quando causa mais tarefas falhas, ferramentas repetidas ou correção humana.
Quatro métricas específicas de Agentes ajudam a localizar o problema.
Um valor alto indica que o contexto anterior foi processado repetidamente.
Tool Retention Ratio
tool retention ratio
= tool-result tokens retained in context
/ tokens originally returned by tools
Uma razão alta pode indicar que o Agente está carregando evidência bruta demais entre etapas.
Retry Tax
retry tax
= retry and repair cost
/ total workflow cost
Reasoning Share
reasoning share
= reasoning-token cost
/ total model cost
Meça cada carga de trabalho separadamente. Agentes de pesquisa, codificação, navegador e suporte ao cliente não devem compartilhar uma linha de base global.
Six Ways to Reduce AI Agent Token Costs
1. Set a Budget for the Complete Run
Um limite de saída por requisição não controla um Agente de múltiplas etapas.
Defina limites no nível da execução para:
Total de etapas de modelo
Entrada e saída cumulativas
Chamadas de ferramentas e tamanho do resultado de ferramentas
Tentativas por tipo de falha
Subagentes
Tempo total decorrido ou custo estimado
O exemplo a seguir, neutro em relação a provedores, avalia a execução antes de cada chamada de modelo:
from dataclasses import dataclass
from enum import Enum


class Action(str, Enum):
    CONTINUE = "continue"
    COMPACT = "compact"
    STOP = "stop"


@dataclass(frozen=True)
class Budget:
    max_steps: int = 12
    max_input_tokens: int = 120_000
    max_output_tokens: int = 18_000
    compact_at: float = 0.80


@dataclass
class Usage:
    steps: int = 0
    input_tokens: int = 0
    output_tokens: int = 0


def evaluate_budget(usage: Usage, budget: Budget) -> Action:
    if (
        usage.steps >= budget.max_steps
        or usage.input_tokens >= budget.max_input_tokens
        or usage.output_tokens >= budget.max_output_tokens
    ):
        return Action.STOP

    input_ratio = usage.input_tokens / budget.max_input_tokens

    if input_ratio >= budget.compact_at:
        return Action.COMPACT

    return Action.CONTINUE
Execute a verificação antes de cada requisição ao modelo e atualize Usage com dados de tokens reportados pelo provedor.
Com 80% do orçamento de entrada, compacte o estado ou estreite a próxima consulta de ferramenta. Com 100%, pare com um motivo estruturado.
Erro comum: Limitar cada resposta enquanto permite etapas, ferramentas e tentativas ilimitadas.
2. Filter Tool Results Before They Enter the Transcript
Retorne apenas a evidência necessária para a próxima decisão do Agente.
Não anexe um:
Página da web
Arquivo de log
Árvore de repositório
Resposta de banco de dados
Sessão de terminal
Payload de API
inteiros quando a próxima etapa precisa apenas de alguns campos.
Uma ferramenta de busca pode retornar:
{
  "source_id": "search_17",
  "title": "Relevant page title",
  "url": "https://example.com/page",
  "relevant_passage": "A short evidence block"
}
Armazene o artefato completo fora do prompt e recupere uma seção mais estreita depois.
Regra de filtragem de ferramentas: Retorne os campos necessários para a próxima decisão — não todos os campos que podem se tornar úteis mais tarde.
Erro comum: Truncar os primeiros 1.000 caracteres de um payload JSON. Isso pode quebrar a estrutura ou remover os registros de que o Agente realmente precisa.
Faça o parsing do payload primeiro, selecione campos de forma estrutural, limite arrays e então serialize JSON válido.
3. Compact Operational State, Not Just Conversation Text
A compactação deve preservar as informações necessárias para continuar a tarefa enquanto remove o histórico que não afeta mais a próxima ação.
Um estado compactado útil contém:
Objetivo do usuário e critérios de sucesso
Decisões já tomadas
Fatos verificados e IDs de fonte
Arquivos ou registros alterados
Abordagens que falharam
Questões em aberto
A próxima ação
Restrições de segurança e de saída
Ele não deve recontar toda a conversa.
A OpenAI documenta a compactação para interações de longa duração na Responses API. A Anthropic fornece controles de gestão de contexto para limpar ou resumir conteúdo antigo. Essas implementações diferem, então verifique os campos atuais do provedor antes da integração.
Regra de compactação: Preserve decisões e trabalho não resolvido. Remova a narração e evidência que pode ser recuperada novamente.
Erro comum: Remover IDs de fonte, nomes de arquivos alterados, abordagens rejeitadas ou restrições não resolvidas.
Após adicionar a compactação, meça se o Agente repete buscas ou chamadas de ferramentas. Um prompt mais curto não é mais barato se o Agente precisar reconstruir estado perdido.
4. Keep the Reusable Prefix Stable
Prompts de agentes frequentemente contêm grandes blocos reutilizáveis:
Instruções de sistema
Esquemas de ferramentas
Políticas de segurança
Formatos de saída
Material de referência compartilhado
Instruções de repositório ou produto
Coloque esses elementos estáveis antes dos dados específicos da requisição:
1. System instructions
2. Policies and constraints
3. Tool definitions
4. Stable examples
5. Shared reference material
6. Request-specific data
Evite colocar carimbos de data/hora, IDs de requisição, dados de sessão ou valores que mudam com frequência perto do início.
O cache é mais útil quando o prefixo é longo, estável e reutilizado. Pode não economizar dinheiro em sessões curtas ou prompts que mudam com frequência.
Erro comum: Otimizar para alta taxa de acerto de cache sem medir custo de escrita, leitura ou armazenamento do cache.
Para uma comparação mais ampla de cache de prompt, cache de resposta exata e cache semântico entre provedores, veja Como Reduzir Custos de API de IA.
5. Prevent Retries From Replaying the Same Context
Uma tentativa é outra etapa do Agente, muitas vezes com o mesmo prompt grande.
Não repita uma requisição falha sem mudar a causa da falha.
Falha
Resposta melhor
Saída estruturada inválida
Retorne o erro de validação e tente novamente uma vez
Timeout de ferramenta
Tente novamente uma operação idempotente uma vez, depois pare ou use fallback
Estouro de contexto
Compacte estado ou recupere menos evidência
Chamada de ferramenta repetida
Deduplicate usando um hash de operação
Limite de taxa
Faça backoff ou use uma rota de fallback testada
Resultado de baixa confiança
Solicite informação faltante ou escale
Use chaves de idempotência para operações com efeitos colaterais, como pagamentos, e-mails, deploys e escritas em banco de dados.
Erro comum: Tentar novamente um modelo com limite de taxa várias vezes enquanto reenviando todo o contexto do Agente em cada tentativa.
Monitore a taxa de tentativas por tipo de falha para que a equipe corrija primeiro o maior loop.
6. Limit Reasoning and Subagents to Steps That Need Them
Nem toda etapa do Agente requer raciocínio profundo.
Extração, formatação, classificação, validação e seleção rotineira de ferramentas geralmente podem usar menor esforço de raciocínio e saída estruturada compacta.
Reserve maior esforço de raciocínio para tarefas como:
Planejamento complexo
Codificação difícil
Síntese de múltiplos documentos
Decisões ambíguas
Recuperação de execução falha
Regra de raciocínio: Use o menor esforço de raciocínio que preserve a taxa de tarefas aceitas.
Subagentes também exigem um limite claro. Dê a cada subagente:
Uma tarefa estreita
Um recorte de contexto específico da tarefa
Uma lista de ferramentas permitidas
Um orçamento de tokens
Um esquema de saída compacto
O Agente raiz geralmente precisa de achados, IDs de evidência, confiança e questões não resolvidas — não da transcrição completa do subagente.
Regra de subagentes: Paralelize trabalho independente, não contexto duplicado.
Erro comum: Enviar todo o histórico do Agente raiz para cada subagente antes de atribuir uma tarefa estreita.
Which Optimization Should You Apply First?
Use telemetria do Agente para escolher a primeira intervenção.
Os limites abaixo são gatilhos de investigação, não padrões universais.
Sinal observado
Comece aqui
Amplificação de contexto alta
Compacte o histórico e recupere seletivamente o estado
Saída de ferramenta domina o prompt
Filtre campos e armazene artefatos completos externamente
Taxa de tentativas alta
Corrija validação, timeouts e chamadas de ferramentas repetidas
Parcela de raciocínio alta
Reduza o esforço em etapas rotineiras
Subagentes repetem a mesma evidência
Estreite escopos de subagentes e recortes de contexto
Entrada em cache permanece baixa
Estabilize o prefixo reutilizável
Custos permanecem altos após limpeza do loop
Compare rotas de modelos de menor custo
Uma sequência de implementação segura é:
Meça entrada cumulativa, retenção de ferramentas, tentativas e raciocínio.
Adicione limites rígidos para etapas, ferramentas, tentativas e total de tokens.
Filtre resultados grandes de ferramentas.
Compacte estado mais antigo em um limiar medido.
Estabilize o prefixo de prompt reutilizável.
Compare rotas de modelos apenas depois que o loop do Agente estiver limpo.
Altere uma variável principal por vez e reproduza o mesmo conjunto de avaliação.
Compare:
Taxa de aceitação de tarefas
Custo por tarefa bem-sucedida
Entrada cumulativa
Contagem de chamadas de ferramentas
Taxa de tentativas
Parcela de raciocínio
Latência p50 e p95
Tempo de revisão humana
Desfaça mudanças que economizam tokens reduzindo a qualidade da tarefa ou removendo evidências necessárias.
Test Agent Workflows With CometAPI
Antes de executar uma avaliação com múltiplos modelos, use a página de preços da CometAPI e o guia de estimativa de custos para estimar custos de entrada, saída, tokens em cache e raciocínio.
Depois use o catálogo de modelos para identificar rotas elegíveis e o Quickstart para configurar um cliente compatível com OpenAI.
Para fallback em produção, siga o guia de fallback de modelos da CometAPI para alternar rotas sem repetir chamadas de ferramentas concluídas ou descartar estado validado.
O acesso unificado simplifica a comparação de modelos e a integração de fallback. Orçamentos de tokens, compactação, validação, filtragem de ferramentas, limites de tentativas e critérios de aceitação continuam pertencendo ao nível da aplicação.
FAQ
Why do AI agents use more tokens than chatbots?
Agentes fazem múltiplas chamadas de modelo e podem reenviar mensagens anteriores, resultados de ferramentas, instruções e estado intermediário em cada etapa. Isso faz com que o contexto anterior seja processado repetidamente.
Does prompt caching reduce context-window usage?
Não. O cache de prompt pode reduzir o preço efetivo ou a latência de entrada repetida, mas tokens em cache ainda compõem o contexto processado. Use compactação, filtragem ou recuperação seletiva para reduzir o tamanho do prompt.
When should an AI agent compact its context?
Compacte antes que o crescimento do contexto comece a afetar custo, latência ou espaço de saída disponível. Verifique se o estado compactado preserva decisões, IDs de evidência, arquivos alterados, questões em aberto e restrições de segurança.
Do subagents reduce token costs?
Não automaticamente. Eles podem reduzir o tempo decorrido ou melhorar a cobertura para trabalho independente, mas contexto duplicado e análise sobreposta frequentemente aumentam o uso total de tokens.
What is the best metric for AI agent cost optimization?
Use custo por tarefa bem-sucedida como métrica primária. Diagnostique com entrada cumulativa, amplificação de contexto, retenção de ferramentas, taxa de tentativas, parcela de raciocínio, latência e tempo de revisão humana.