Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
Tencent Hyra 2.0: Arquitetura do Harness, Benchmarks & Resultados
Explore Tencent Hunyuan Hyra 2.0, seu Harness de agente de três camadas, modelos científicos, benchmarks, avanços de pesquisa e as diferenças em relação ao Hyra 1.0.
Deon GoodwinEquipe de pesquisa de modelos e API de IA
A Tencent Hunyuan apresentou o Hyra 2.0 em 2 de novembro de 2026 como um Harness de pesquisa para desenvolver modelos científicos, ferramentas de software e fluxos de trabalho reutilizáveis. Sua característica definidora é a coordenação persistente ao longo de experimentos de múltiplos dias ou semanas.
A versão pública atualmente consiste em artefatos de pesquisa selecionados — modelos, código, pesos e relatórios — em vez de um serviço Hyra 2.0 hospedado de disponibilidade geral. Em 4 de novembro de 2026, os materiais públicos da Tencent não documentam uma API de orquestração de uso geral nem um plano de assinatura.
Key Takeaways
Objetivo de pesquisa: o Hyra 2.0 desenvolve modelos e ferramentas científicas reutilizáveis que podem atender a mais de um projeto de pesquisa.
Coordenação persistente: Overall, Mission e Worker dividem responsabilidades, enquanto filas e registros de pesquisa preservam o progresso ao longo de experimentos longos.
Conhecimento reutilizável: memória de agentes, Books e habilidades de pesquisa retêm descobertas junto com suas evidências de suporte e condições de uso.
Revisado para maior clareza, atribuição de fontes e terminologia de API atual.
Resultados específicos de tarefas: os modelos liberados de proteína, campo de força e células abordam diferentes cargas científicas; velocidade e qualidade devem ser avaliadas em conjunto.
Acesso prático: comece com os artefatos de pesquisa disponíveis. O Harness completo do Hyra e as APIs de modelos hospedadas do Hunyuan são ofertas distintas.
O que é o Tencent Hunyuan Hyra 2.0?
Hyra 2.0 significa Hunyuan Research Agent 2.0, um sistema multiagente projetado para automatizar fluxos de trabalho complexos de pesquisa científica e engenharia.
A Tencent apresenta o Hyra 2.0 como uma mudança de resolver problemas isolados para desenvolver os modelos, métodos e infraestrutura usados para investigar uma classe mais ampla de questões.
O Hyra 2.0 não é um modelo fundamental autônomo com contagem fixa de parâmetros ou janela de contexto. É um sistema de orquestração que pode usar diferentes modelos de IA, executar código, gerenciar experimentos científicos e coordenar agentes de pesquisa especializados.
Pesquisa científica envolve mais do que raciocínio. Um projeto completo pode exigir desenho experimental, implementação, treinamento, depuração, avaliação e revisões repetidas. Essas atividades podem se estender por vários dias ou semanas, muitas vezes envolvendo experimentos paralelos e recursos computacionais compartilhados.
O Hyra 2.0 aborda esse desafio operacional combinando inteligência de modelos com execução persistente, colaboração estruturada e verificação baseada em evidências.
Especificações técnicas do Hyra 2.0
Especificação
Hyra 2.0
Desenvolvedor
Tencent Hunyuan
Anúncio público
2 de novembro de 2026
Categoria do sistema
Agente de pesquisa científica autônomo
Arquitetura central
Harness multiagente hierárquico
Papéis de agentes
Overall, Mission, Worker
Execução de pesquisa
Fluxos de trabalho concorrentes e de longa duração
Gestão de tarefas
Fila de tarefas persistente
Colaboração
Research Board e mensagens entre agentes
Verificação
Resultados apoiados por evidências e Review Workers independentes
Memória
Estado do projeto, memória em camadas dos agentes, Books compartilhados
Reuso de conhecimento
Conclusões validadas e habilidades reutilizáveis
Flexibilidade de modelos
Diferentes Workers podem usar diferentes modelos subjacentes
Ambientes de pesquisa
WeCom, plataformas de computação, repositórios de código
As especificações do sistema descrevem suas capacidades de orquestração e pesquisa. Modelos científicos individuais criados pelo Hyra 2.0 têm arquiteturas, contagens de parâmetros e benchmarks de desempenho separados.
Por que o Hyra 2.0 constrói ferramentas
A mudança do Hyra 1.0 para o Hyra 2.0 aborda uma limitação fundamental na pesquisa automatizada: resolver com sucesso um problema não necessariamente melhora a capacidade do sistema de resolver o próximo.
O Hyra 1.0 usava um loop de agente relativamente simples para gerar soluções, executar avaliações e melhorar resultados por tentativas repetidas. Impulsionado pelo modelo open-source Hy3 da Tencent, o Hyra 1.0 ajudou a estabelecer o expoente ótimo que relaciona conjuntos soma e conjuntos diferença, com uma prova verificada por máquina publicada junto ao resultado. A distinção importa: um resultado matemático avaliado é um produto concreto, enquanto uma melhoria no processo de pesquisa pode ser reutilizada em problemas posteriores.
O próximo desafio é fazer o progresso da pesquisa se acumular.
De respostas a capacidades reutilizáveis
Considere três níveis de automação matemática:
Um agente resolve um problema matemático individual.
Um agente desenvolve um fluxo de prova que pode resolver problemas semelhantes.
Um agente melhora os modelos de raciocínio e as ferramentas de verificação usadas por sistemas de pesquisa futuros.
O primeiro produz uma resposta. O segundo produz um método reutilizável. O terceiro pode melhorar a própria capacidade subjacente de pesquisa.
O Hyra 2.0 mira os segundo e terceiro níveis.
A Tencent descreve duas categorias amplas de ferramentas reutilizáveis. Ferramentas simbólicas expressam capacidades por meio de código, algoritmos, regras e fluxos de trabalho. Exemplos incluem sistemas de verificação automatizada, algoritmos de busca científica e pipelines de gerenciamento de experimentos. Ferramentas paramétricas armazenam capacidades aprendidas em pesos de modelos, incluindo modelos de design de proteínas e modelos fundamentais científicos.
Melhorar qualquer uma das categorias pode beneficiar várias tarefas downstream sem exigir que todo projeto de pesquisa comece do mesmo ponto de partida.
A direção rumo à autoaperfeiçoamento recursivo
O Hyra 2.0 também cria um caminho rumo ao autoaperfeiçoamento recursivo. Pesquisa de modelos fundamentais depende de infraestrutura de treinamento, pipelines de dados sintéticos, algoritmos de otimização e sistemas de inferência.
Se agentes de IA melhorarem essas ferramentas, eles podem ajudar a desenvolver modelos mais fortes. Esses modelos mais fortes podem então participar de rodadas subsequentes de desenvolvimento de ferramentas.
Melhores ferramentas de pesquisa → modelos de IA mais fortes → agentes de pesquisa mais capazes → melhores ferramentas de pesquisa.
A Tencent descreve a aplicação do Hyra à infraestrutura de pré-treinamento, geração de dados pós-treinamento e otimização de inferência. Isso cria um loop de feedback plausível entre desenvolvimento de ferramentas e desenvolvimento de modelos. Por si só, não estabelece melhoria recursiva ilimitada ou totalmente autônoma; cada ganho proposto ainda precisa de um experimento que isole seu efeito.
Como funciona a arquitetura do Harness do Hyra 2.0?
O Harness é a inovação de engenharia central do Hyra 2.0. Um loop de agente convencional pode executar ferramentas, inspecionar resultados e continuar raciocinando dentro de uma sessão. Desenvolvimento de modelos científicos exige um ambiente de execução mais sofisticado.
Experimentos podem rodar por horas, tarefas de treinamento podem levar dias e direções de pesquisa separadas podem exigir diferentes recursos computacionais e métodos de validação. O Hyra 2.0 atende a esses requisitos por meio de três camadas de agentes, agendamento persistente de tarefas, registros estruturados de pesquisa e verificação independente.
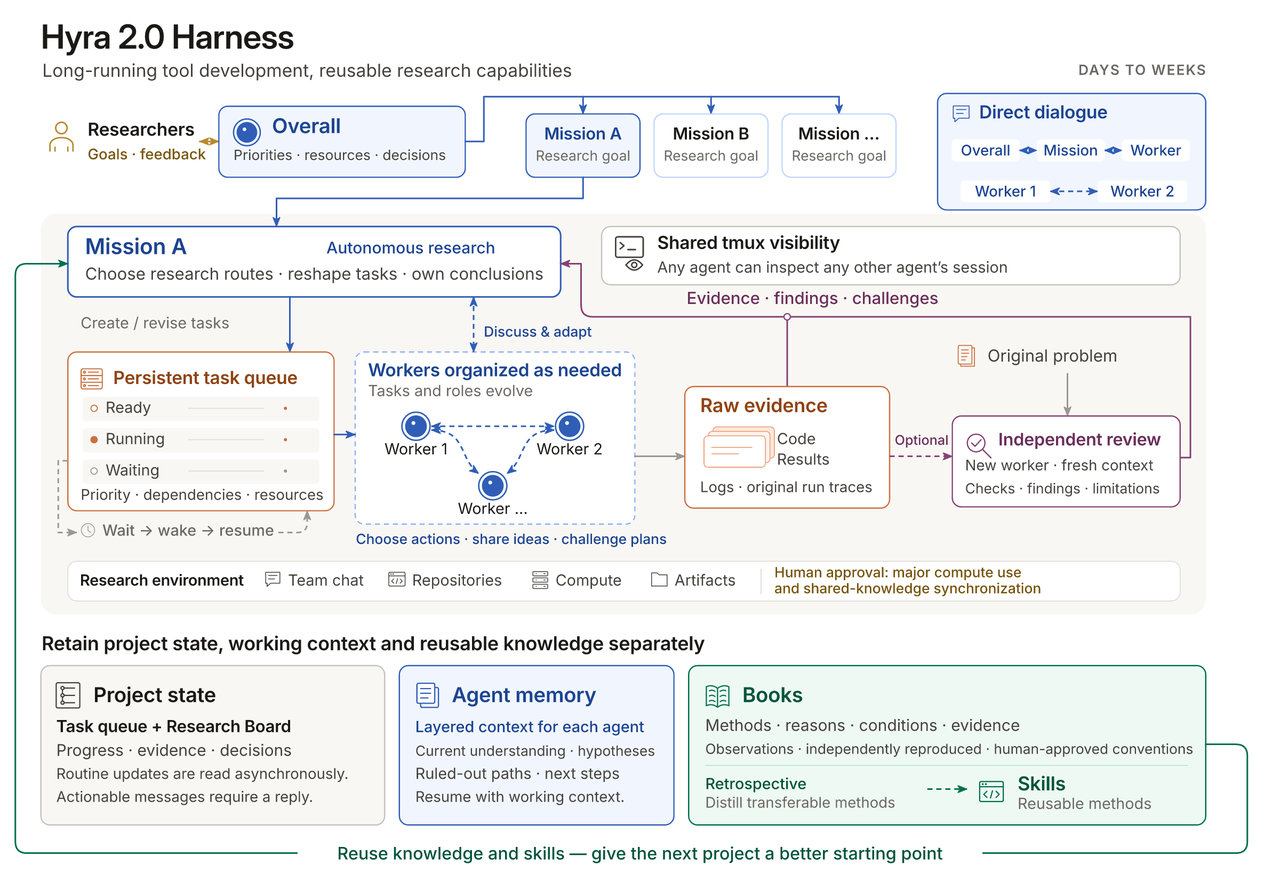
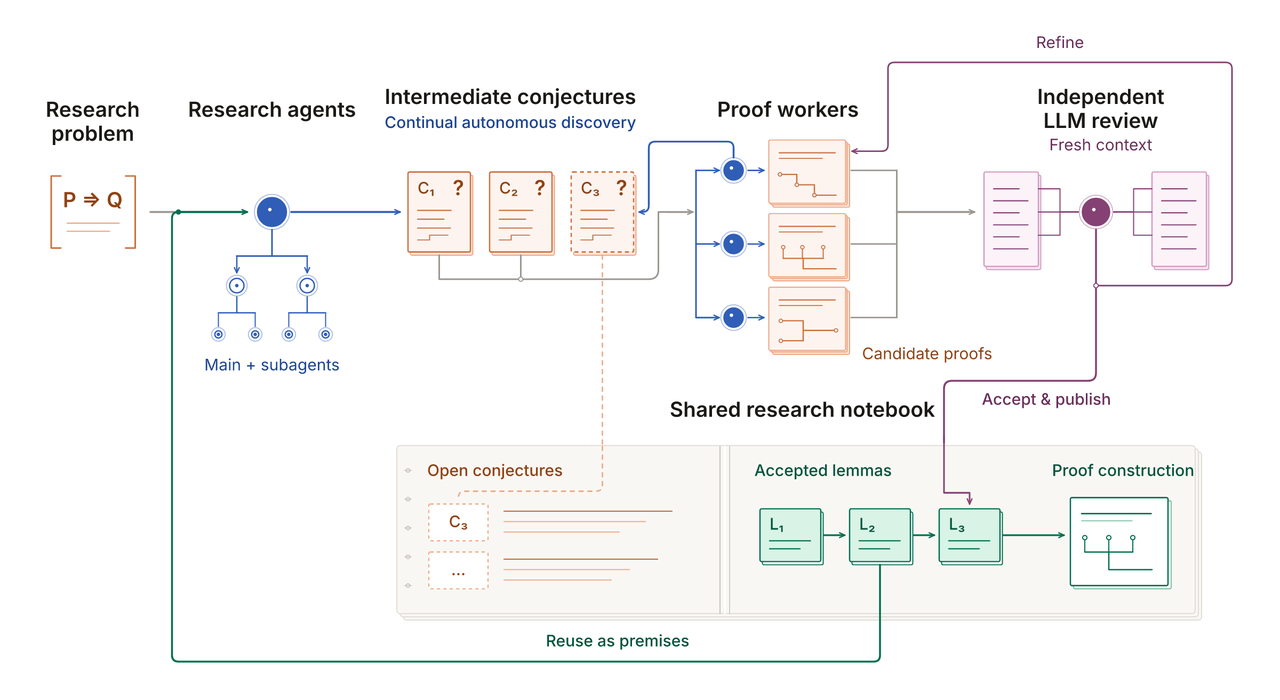
O diagrama de arquitetura do Hyra 2.0 oficial da Tencent Hunyuan mostra a hierarquia, a fila de trabalho persistente, o processo de revisão e armazenamentos separados para estado do projeto, memória de agentes e conhecimento compartilhado.
Overall: Coordenação de pesquisa e gestão de recursos
Overall é a camada de coordenação mais alta. Comunica-se com pesquisadores humanos, mantém alinhamento com os objetivos de pesquisa, gerencia prioridades e coordena recursos computacionais.
Suas responsabilidades incluem determinar quais projetos devem receber recursos adicionais e identificar decisões que requerem aprovação humana. Overall funciona, portanto, como a camada de coordenação entre atividades de pesquisa autônomas e a gestão de pesquisa humana.
Mission: Planejamento de pesquisa de longo prazo
Cada Mission é responsável por um problema de pesquisa particular. Uma Mission mantém a direção da pesquisa ao longo de múltiplos experimentos, organiza Workers, interpreta resultados e decide se uma hipótese merece investigação adicional.
Ela também determina quando uma abordagem de pesquisa deve ser revisada ou abandonada. Isso cria continuidade ao longo de um projeto de longa duração sem exigir que uma sessão de agente retenha todas as ações intermediárias.
Worker: Execução de experimentos e exploração independente
Workers executam tarefas de pesquisa especializadas. Suas responsabilidades incluem ler código, implementar algoritmos, rodar experimentos, diagnosticar falhas e propor abordagens alternativas.
Workers podem desafiar decisões da Mission, e diferentes Workers podem usar diferentes modelos de IA subjacentes. Essa estrutura suporta exploração paralela e reduz a dependência do caminho de raciocínio de um único agente.
Agendamento persistente e Research Board
O Hyra 2.0 coloca tarefas de pesquisa em uma fila persistente. O scheduler considera prioridade das tarefas, dependências e recursos disponíveis ao lançar Workers.
Quando um experimento está aguardando resultados de treinamento ou aprovação humana, outras tarefas podem continuar. Agentes também podem agendar sua próxima ativação após a conclusão de um experimento.
O Research Board registra hipóteses, descobertas, evidências e decisões principais. Isso separa o estado persistente do projeto das conversas individuais dos agentes.
Verificação independente e aprovação humana
Conclusões de Workers devem ser apoiadas por evidências experimentais, como versões de código, logs de execução, resultados de avaliação ou rastros originais.
Quando um resultado exige exame adicional, um Review Worker separado pode inspecionar de forma independente o problema original e as evidências. Esse processo ajuda a identificar conclusões sem suporte e erros de implementação antes que influenciem pesquisas posteriores.
Operações de computação de alto custo e mudanças no conhecimento compartilhado da equipe permanecem sujeitas à aprovação humana. A arquitetura combina, portanto, execução autônoma com pontos de verificação explícitos para decisões consequentes.
Books: Transformando experiência de pesquisa em habilidades
O Hyra 2.0 separa informações em três categorias de armazenamento:
Estado do projeto: filas de tarefas, registros de colaboração e progresso de pesquisa.
Memória do agente: entendimento atual, hipóteses, abordagens rejeitadas e planos futuros.
Books: conhecimento reutilizável compartilhado entre projetos de pesquisa.
Books categoriza informações em observações, descobertas verificadas e convenções. Um único experimento pode produzir uma observação. Descobertas reproduzidas de forma independente podem se tornar conhecimento verificado. Convenções que afetam o comportamento da equipe requerem confirmação humana.
Durante revisões de projetos, métodos reutilizáveis podem ser convertidos em habilidades. Um procedimento de verificação numérica bem-sucedido ou um método para diagnosticar instabilidade de treinamento pode se tornar um componente reutilizável de fluxos de trabalho de pesquisa futuros.
Esse mecanismo permite ao sistema preservar melhorias operacionais para além de sessões individuais.
Quais resultados de pesquisa o Hyra 2.0 alcançou?
Os resultados iniciais do Hyra 2.0 cobrem modelos científicos, pesquisa matemática, computação quântica, robótica, análise de célula única e engenharia de hardware.
O repositório oficial de pesquisa contém implementações selecionadas, pesos, relatórios e artefatos de verificação. A visão geral abaixo resume os resultados relatados pela Tencent; as subseções seguintes explicam suas condições de teste e disponibilidade. São tarefas científicas diferentes, não um único ranking de capacidade geral de agentes.
Resultado de pesquisa
Escala técnica ou métrica
Resultado reportado
HyInv
1,96M parâmetros
Geração de sequência de proteína 57× mais rápida que ProteinMPNN
HyPLM-Flash
650M parâmetros; 726B tokens de treinamento
130.000 resíduos/s em um H20; qualidade competitiva em 32 tarefas
HyFF
Cinco modelos; 2,3M–1,2B parâmetros
Fronteira de Pareto precisão-velocidade contra 16 modelos públicos
HyCell
16,1M parâmetros; embeddings de 512 dim.
Pontuação geral 0,735 em sete atlas de células mantidos à parte
HyProver
Fluxo de prova matemática
Resultados sobre a conjectura de Petty e a conjectura de ação de círculo de Yau
HyQEC
Código quântico [[488,123,22]]
Métrica de eficiência 122,0; cerca de 48% acima do líder anterior do desafio
Spiral Hand
Design robótico de cinco dedos
Rotação de objetos 28,6% mais rápida em simulação DR5
XiangShan RISC-V
Desempenho SPEC CPU2006
5,79% maior pontuação por GHz com aumento de área de 0,3%
Esses resultados demonstram múltiplos tipos de produção de pesquisa em vez de uma pontuação geral única de agente.
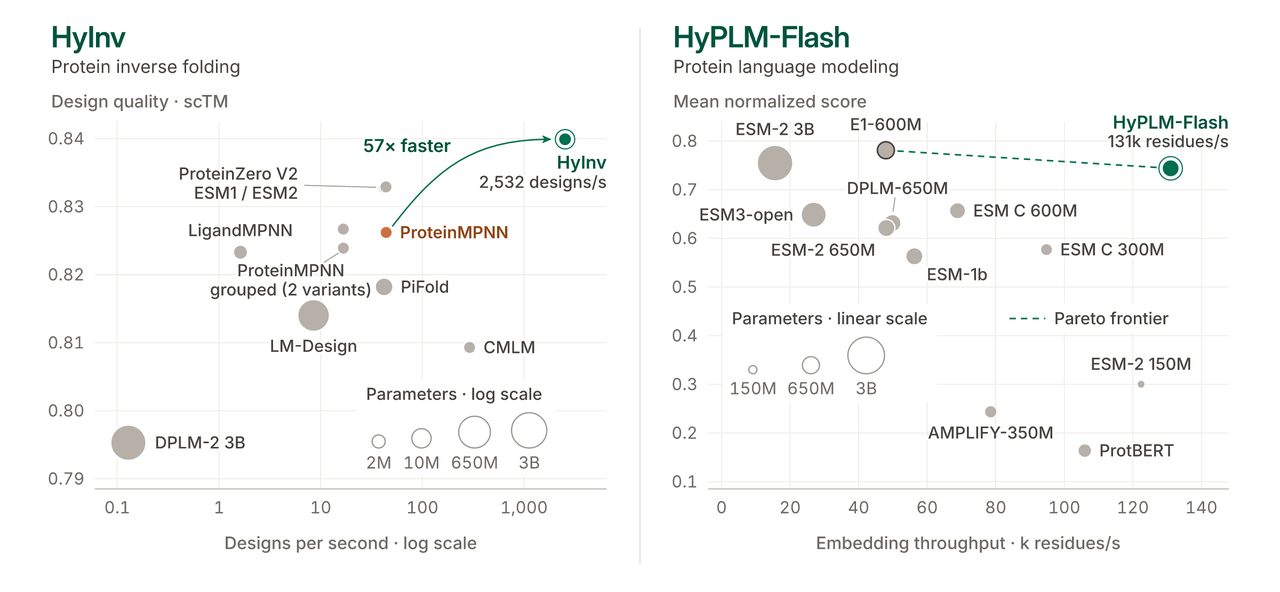
HyInv: dobramento inverso de proteínas 57× mais rápido
HyInv gera sequências de proteína para um esqueleto-alvo. Seu modelo de 1,96M parâmetros roda, segundo relatos, 57× mais rápido que ProteinMPNN. Os 50,6 ms relatados para 128 designs usam um esqueleto de 402 resíduos, um H20 e BF16, excluindo compilação e captura de gráfico CUDA. Trate isso como velocidade de geração aquecida; a triagem estrutural ainda contribui para o ciclo completo de design.
HyPLM-Flash: modelagem de linguagem de proteínas em alta vazão
HyPLM-Flash é um modelo de linguagem de proteínas com 650M parâmetros treinado em 726B tokens. Na avaliação lançada com 28 checkpoints e 32 tarefas, sua pontuação no ProteinGym foi estatisticamente empatada com codificadores comparáveis. Inferência em INT8 atinge cerca de 130.000 resíduos/s em um H20; BF16 é preferível quando pequenas diferenças de representação afetam análises downstream. A figura de lançamento abaixo usa um escopo de avaliação diferente.
HyFF: simulação molecular mais rápida com cinco tamanhos de modelo
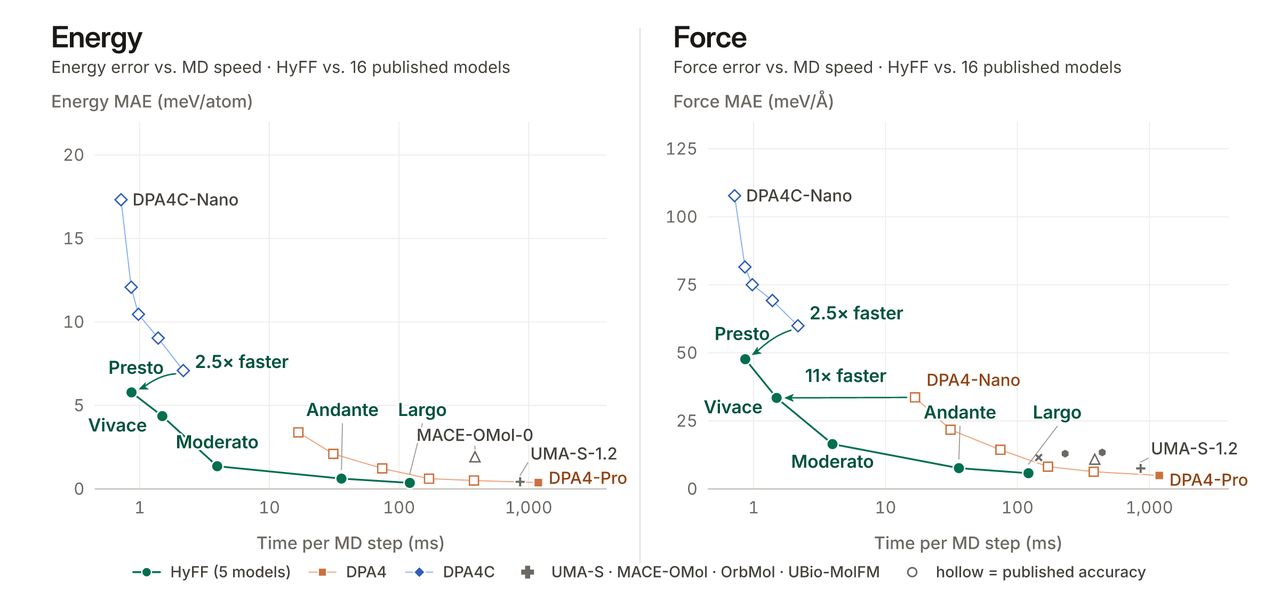
HyFF prevê energias moleculares e forças atômicas, com cinco tamanhos de modelo variando de 2,3M–1,2B parâmetros. Na comparação OMol25 relatada, Andante combina erro de força similar ao UMA-S-1.2 (7,65 versus 7,55 meV/Å) com dinâmica molecular 29× mais rápida. Largo reporta erro de energia menor que DPA4-Pro (0,364 versus 0,380 meV/átomo) e velocidade 9,7× maior. Escolha um tamanho testando tanto precisão quanto tempo de execução nas moléculas que pretende simular.
HyCell: um modelo de embedding de célula única
HyCell mapeia contagens de expressão gênica de células humanas para embeddings de 512 dimensões com um modelo de 16,1M parâmetros. Em sete atlas de células mantidos à parte, sua pontuação composta é 0,735, próxima ao 0,736 do Stack. Essa pontuação combina conservação biológica, correção de lote e transferência de anotação; não é acurácia de classificação. Verifique as métricas componentes relevantes para seu estudo.
HyProver: fluxos reutilizáveis para pesquisa matemática
HyProver organiza o trabalho matemático em exploração, desenvolvimento de prova e revisão. Seus resultados relatados estabelecem o caso de cinco dimensões da conjectura de conjuntos equiláteros de Petty e fornecem um contraexemplo à forma irrestrita da conjectura de ação de círculo de Yau. Esses resultados têm limites específicos: a conjectura de Petty não está resolvida em todas as dimensões, e a formulação simplesmente conexa de Yau permanece em aberto.
HyQEC: uma melhoria de 48% na eficiência de códigos quânticos
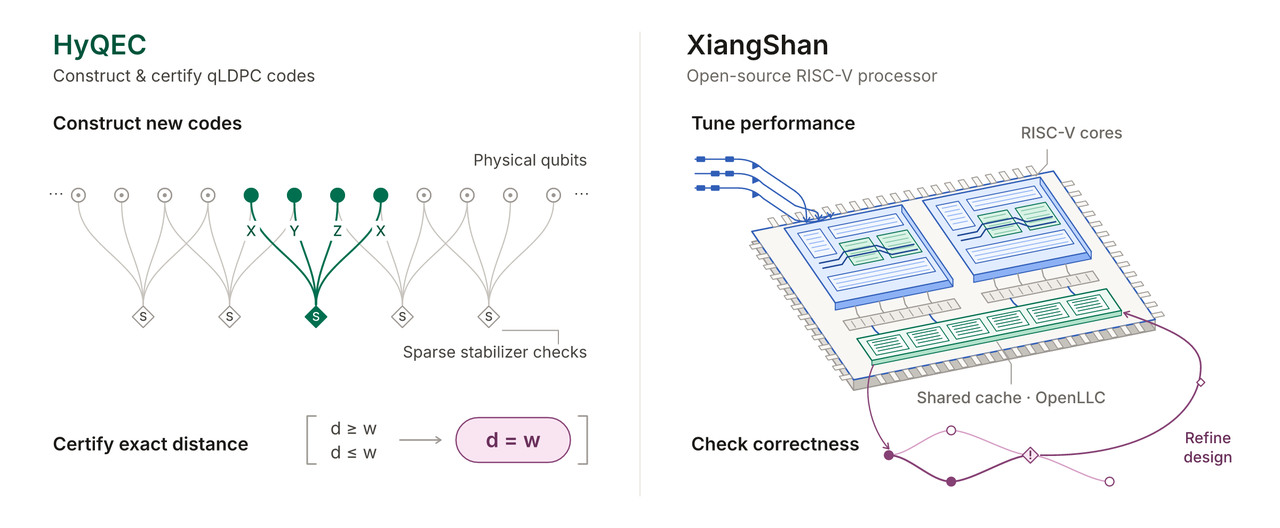
HyQEC busca códigos de correção de erros quânticos e verifica suas distâncias. A Tencent relata uma construção [[488,123,22]] com métrica de eficiência kd²/n de 122,0, cerca de 48% acima do líder anterior do desafio sob as restrições declaradas. Isso mede a eficiência do código, não o desempenho de hardware quântico. Verificado em 5 de novembro de 2026, a versão oficial inclui as ferramentas hyqec-verify e hyqec-check, mas ainda lista o arquivo de código dessa construção específica e seu certificado como evidências a serem liberadas. Ferramentas públicas e evidências publicamente reproduzíveis para um resultado específico são marcos distintos.
Spiral Hand: morfologia robótica projetada por IA
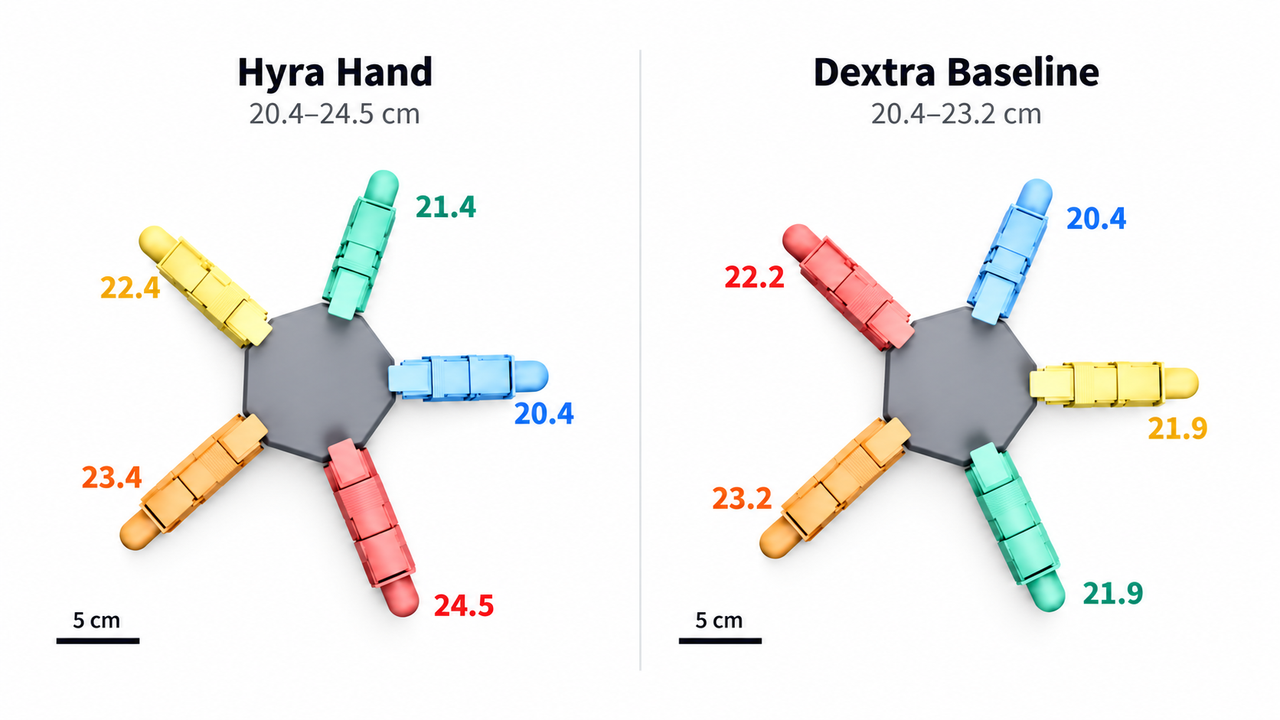
A Spiral Staircase Hand do Hyra usa dedos progressivamente mais longos ao redor da palma. A Tencent relata rotação de objetos 28,6% mais rápida e 21% mais alvos concluídos do que o baseline Dextra em simulação DR5 após orçamentos de fine-tuning de política iguais. A validação em hardware físico permanece pendente.
XiangShan: otimização de processadores e verificação formal
Para o processador XiangShan RISC-V, a Tencent relata melhoria de 5,79% na pontuação SPEC CPU2006 por GHz, frequência de núcleo inalterada e aumento de área de 0,3%. O trabalho também encontrou dez bugs não reportados anteriormente e um contraexemplo de coerência de cache. Esses resultados se aplicam ao design e cargas de trabalho avaliados, em vez de a todos os sistemas RISC-V.
Como pesquisadores devem interpretar os benchmarks do Hyra 2.0?
Leia cada benchmark dentro de sua própria carga de trabalho. Compare os mesmos inputs, hardware, precisão e limite de tempo, depois avalie a qualidade de saída junto com o tempo de execução. Para afirmações científicas, inspecione o código, os dados, a prova ou o certificado de suporte: um resultado relatado e um resultado reproduzido de forma independente fornecem níveis diferentes de evidência.
Desenvolvedores podem usar o Hyra 2.0 por meio de uma API?
Em 4 de novembro de 2026, os materiais públicos do Hyra descrevem resultados de pesquisa e lançamentos selecionados. Eles não documentam uma API de orquestração Hyra 2.0 de disponibilidade geral, preço de assinatura ou pacote completo de implantação. Um anúncio de pesquisa e artefatos para download devem, portanto, ser distinguidos de acesso hospedado ao sistema completo.
Os materiais disponíveis publicamente focam em resultados de pesquisa e artefatos selecionados. Desenvolvedores podem acessar certos modelos criados pelo Hyra, incluindo HyInv, HyPLM-Flash, HyFF e HyCell, por meio dos repositórios de pesquisa associados.
O Harness completo do Hyra 2.0 deve ser distinguido dessas saídas para download.
Hyra 2.0 e APIs hospedadas do Hunyuan
Desenvolvedores podem acessar o Tencent Hy4 por meio do CometAPI usando o ID de modelo hy4. Isso fornece inferência de modelos hospedados para aplicações como codificação, análise e fluxos de trabalho de agentes. Não fornece o Harness de pesquisa completo do Hyra 2.0; modelos científicos desenvolvidos pelo Hyra estão disponíveis separadamente por meio dos repositórios de pesquisa da Tencent.
O que tornaria o Hyra 2.0 útil em uma equipe de pesquisa?
Comece com um artefato liberado e uma pequena carga de referência. Uma vez que isso rode com sucesso, teste dados locais representativos com um limite de qualidade fixo e orçamento de computação. Mantenha juntos a revisão do repositório, os pesos, o ambiente, os inputs e outputs para que colegas possam reproduzir o resultado. Adicione coordenação multiagente persistente quando esperas longas, experimentos dependentes ou hipóteses concorrentes tornarem isso útil.
Conclusão
O Hyra 2.0 traz planejamento de pesquisa, execução de experimentos e conhecimento reutilizável para um fluxo de trabalho persistente. Suas saídas científicas são pontos de partida promissores para trabalhos futuros. Para uma equipe de pesquisa, o teste prático é se um artefato lançado melhora um experimento real e produz evidências que outros podem inspecionar e reproduzir.
FAQ
Como um laboratório deve orçar seu primeiro teste de artefato do Hyra?
Orce três etapas: configurar um ambiente reproduzível, executar um pequeno caso de referência e avaliar uma carga local representativa. Inclua tempo de preparação e revisão, bem como uso de aceleradores. Escolha um critério de aceitação antes de começar, como manter um nível de qualidade exigido enquanto reduz o tempo de retorno. Um teste inicial deve ser pequeno o suficiente para diagnosticar falhas sem comprometer os recursos exigidos por uma campanha de pesquisa completa.
O que deve conter um pacote de reprodutibilidade?
Mantenha juntos a revisão do repositório, identificadores dos pesos do modelo, versões do ambiente, proveniência dos dados de input, configuração, seeds aleatórios quando relevantes e outputs de avaliação. Registre quaisquer mudanças no exemplo publicado. Quando um resultado depende de uma prova ou certificado, preserve a versão do verificador e seu output também. O pacote deve permitir que outro pesquisador distinga um problema de software, um input alterado e uma diferença genuína no resultado científico.
Como pesquisadores podem evitar contaminação de benchmarks?
Separe os dados usados para escolher modelos ou ajustar configurações dos dados usados para avaliação final. Congele o protocolo final antes de comparar candidatos e documente qualquer sobreposição com dados de pré-treinamento ou desenvolvimento que possa ser estabelecida. Para novos datasets científicos, use divisões que reflitam o cenário de implantação pretendido, como um estudo ou condição experimental mantidos à parte. Uma pontuação forte é menos informativa se os exemplos de avaliação moldaram repetidamente o sistema testado.
Como as equipes devem lidar com conclusões conflitantes de agentes?
Compare os experimentos subjacentes em vez de combinar conclusões por voto da maioria. Verifique se os agentes usaram a mesma versão de dataset, suposições, métrica e configuração de software. Preserve ambas as descobertas até que a diferença seja explicada, depois execute um experimento focado que discrimine entre as explicações concorrentes. Concordância entre agentes é útil, mas não substitui medições externas ou um argumento verificável.
Quando um fluxo de trabalho de pesquisa mais simples é preferível?
Uma tarefa curta e determinística, com script maduro e avaliador claro, pode não se beneficiar de coordenação multiagente persistente. O agendamento adicional, registro e revisão podem custar mais do que economizam. Introduza orquestração quando experimentos tiverem dependências significativas, esperas longas, várias hipóteses concorrentes ou saídas reutilizáveis que necessitem de manutenção contínua. A decisão deve seguir a estrutura da carga de trabalho e o custo observado de coordenação.