
TL;DR
Claude Haiku 5.5 и GPT-6 Luna — недорогие модели рассуждений для высоконагруженных API-сценариев. Обе начинаются с $0.10 за миллион входных токенов и $0.50 за миллион выходных токенов. Haiku показывает более высокие результаты в шести сравнениях, опубликованных в материалах запуска Anthropic. Luna сохраняет базовые тарифы на токены для промптов до 272K входных токенов, тогда как порог Haiku — 100K. Для разработчиков ключевые метрики — доля принятых результатов, сквозная задержка, совместимость API и стоимость за принятый результат — общая стоимость всех попыток, делённая на число выходов, прошедших предопределённые проверки.
Key Takeaways
- Haiku 5.5 лидирует в указанном сравнении OSWorld 2.1 по использованию компьютера: 72.4% против 48.9% у Luna.
- На Terminal-Bench 4.0 указанные результаты: 39.2% у Haiku и 16.4% у Luna.
- Базовые цены при коротком контексте идентичны, но у Haiku повышенный тариф начинается при пороге свыше 100K токенов промпта, тогда как у Luna — свыше 272K.
- По данным страниц моделей Artificial Analysis при максимальном усилии, проверено 9 октября 2026 года: скорость вывода 240.6 токенов/с у Haiku и 123.0 у Luna; пропускная способность исключает ожидание первого токена.
- Начните с Haiku для задач по использованию компьютера и терминала, отражённых в общих бенчмарках; рассматривайте Luna для больших промптов. Сохраняйте текущую модель, пока репрезентативный пилот не подтвердит полезное улучшение.
What Are Claude Haiku 5.5 and GPT-6 Luna?
Claude Haiku 5.5: Overview
Claude Haiku 5.5 запущен 7 октября 2026 года. Он сочетает низкую стоимость инференса с настраиваемыми рассуждениями, использованием инструментов, длинным контекстом и вводом текста и изображений. Типичные сценарии — извлечение из документов, запросы к базам данных, поддержка клиентов и лёгкие субагенты.
GPT-6 Luna: Overview
GPT-6 Luna запущен 22 сентября 2026 года. Позиционируется для масштабных фокусных задач, включая классификацию, извлечение информации, структурированный вывод, помощь в программировании и обработку длинных документов. Гибкие настройки рассуждений включают конфигурацию без рассуждений для простых задач.
Specifications
| Specification | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Developer | Anthropic | OpenAI |
| Release | October 7, 2026 | September 22, 2026 |
| Model ID | claude-haiku-5-5 | gpt-6-luna |
| Context window | 1,000,000 tokens | 1,050,000 tokens |
| Maximum output (standard API) | 128,000 tokens | 128,000 tokens |
| Input | Text and image | Text and image |
| Output | Text | Text |
| Reasoning | Adjustable, Low to Max | None to Max |
| Default effort | Medium | Medium |
| Knowledge cutoff | June 2026 | May 18, 2026 |
| Tool use | Yes | Yes |
| Structured output | Yes | Yes |
| Open weights | No | No |
| Architecture and parameter count | Not specified in the cited official materials | Not specified in the cited official materials |
Specifications основаны на стандартной документации по моделям в API поставщиков, проверено 9 октября 2026 года: стандартные спецификации API Haiku и стандартные спецификации API Luna. Архитектура и число параметров не указаны, поскольку эти источники их не подтверждают.
Claude Haiku 5.5 vs GPT-6 Luna: Benchmark Results
| Benchmark | Haiku 5.5 | GPT-6 Luna | Leader |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, offline partial score | 72.4% | 48.9% | Haiku +23.5 pp |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 pp |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 pp |
| Chartography, no tools | 46.4% | 29.1% | Haiku +17.3 pp |
Шесть строк выше воспроизводят опубликованные Anthropic результаты сравнений к запуску, проверено 9 октября 2026 года. Это сравнения, опубликованные Anthropic, включая воспроизведённые там независимые результаты, а не новые тесты для этой статьи. GDPval-AA и AA-Briefcase — это Elo-рейтинги; разницы в процентах — это процентные пункты. Эти семейства бенчмарков измеряют разные задачи и не должны усредняться в универсального победителя.
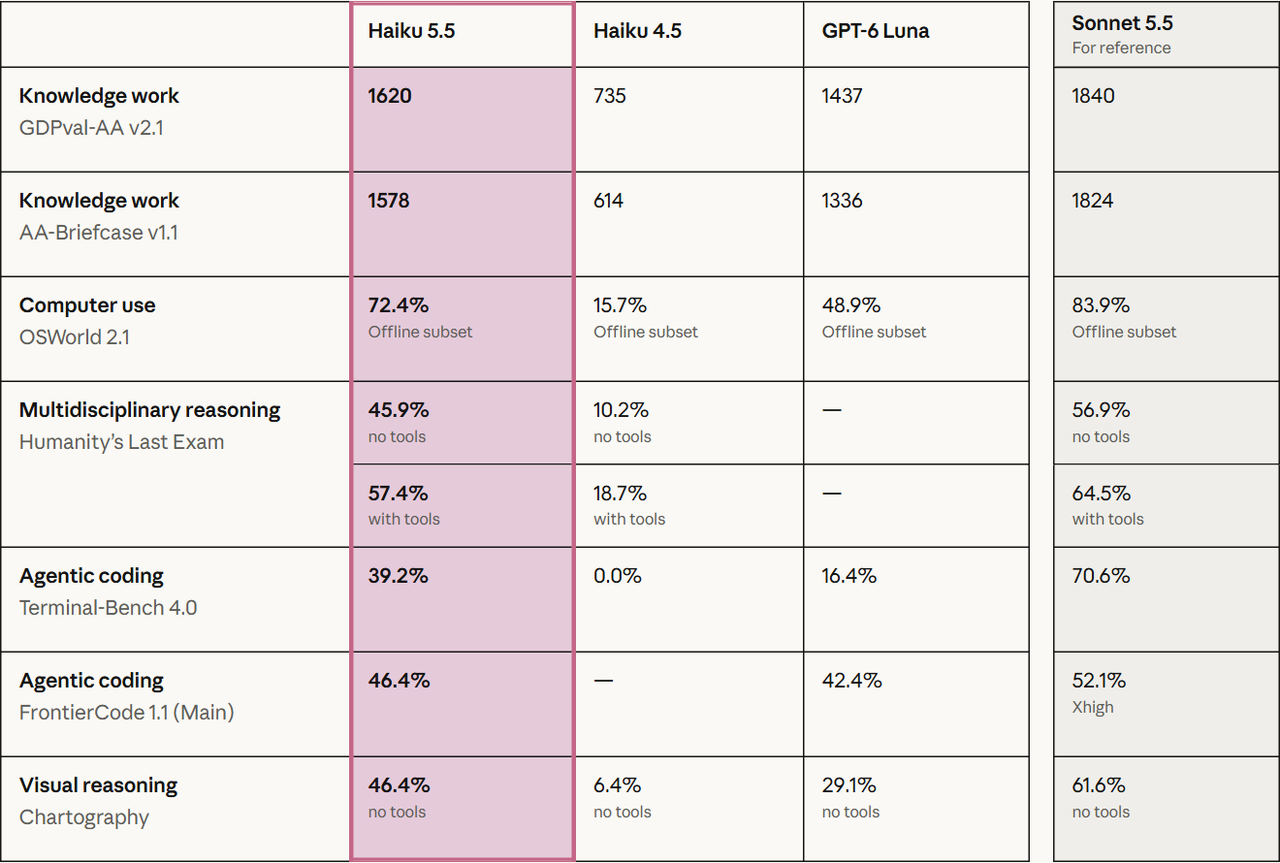
Самые сильные относительные результаты Haiku в этой таблице запуска — во взаимодействии с визуальными интерфейсами компьютера и в задачах на терминал. Его меньший отрыв в FrontierCode предостерегает от экстраполяции 20-процентного разрыва на все ситуации кодирования. Используйте эти результаты для выбора кандидатов на пилот, затем валидируйте свои промпты и стек инструментов.
Reasoning Effort and Evaluation Limits
Уровень рассуждений меняет баланс точности и стоимости. Сравнивайте доступные настройки на одинаковой нагрузке и в одном и том же каркасе тестирования; совпадение названий настроек у разных поставщиков не гарантирует равные бюджеты на токены рассуждений. Таблица запуска приводит офлайновое подмножество OSWorld и Chartography без инструментов. Каркас, выбор задач, повторы и доступ к инструментам могут менять результаты. Системная карта Anthropic документирует условия, специфичные для бенчмарков. Прочитайте описание методики бенчмарков в системной карте Anthropic.
- OSWorld использует офлайновое подмножество из 82 задач, виртуальную машину Ubuntu, скриншоты 1080p, лимит в 500 действий, максимальный уровень усилий и пять попыток на задачу. Сравнение 72.4%/48.9% — это оценивание с частичным зачётом, а не доля идеально выполненных задач; строгая доля прохождений у Haiku — 37.1%. Anthropic запускал Luna на том же подмножестве задач через API OpenAI.
- Terminal-Bench использует 66 контейнеризованных задач; Haiku работал на максимальном усилии в «bare mode» Claude Code, без выхода в интернет и без резервной модели, в среднем десять прогонов на задачу.
- FrontierCode Main включает 100 задач с пятью прогонами на задачу; модели Claude использовали Claude Code, а модели GPT — Codex.
- GDPval-AA и AA-Briefcase были независимо оценены Artificial Analysis и воспроизведены в материалах запуска. Это отдельные пайплайны оценки, а не единый общий продакшен-каркас.
Claude Haiku 5.5 vs GPT-6 Luna: Feature Comparison
Computer Use and Agentic Coding
Сильнейшее преимущество Haiku — в общих задачах запуска, требующих взаимодействия с графическим компьютером или работы в терминале. Разрыв по OSWorld по частичной оценке — 23.5 п. п., а по Terminal-Bench — 22.8 п. п. Меньшая разница в FrontierCode (4.0 п. п.) показывает, почему категорию «кодинг» не следует рассматривать как единую нагрузку.
Для автоматизации браузера тестируйте навигацию по страницам, ввод в формы, восстановление после сбоев инструментов и сквозное завершение. Для кодинга проверяйте, проходит ли патч функциональные проверки вашего репозитория и остаётся ли в рамках задачи. Эти критерии приёмки полезнее, чем выбор модели по максимальному «заголовочному» разрыву.
Long Context and Document Processing
Разница в 5% по номинальной ёмкости контекста менее значима, чем надёжность и стоимость обработки объёмных промптов. Ни одна из моделей не извлекает информацию «лучше» только из-за бóльшего контекстного окна.
Ключевая разница — момент применения повышенных тарифов: промпт на 150K токенов пересекает порог Haiku, но остаётся в базовом тарифе Luna. Следовательно, Luna — более дешёвая стартовая точка для такой токенной нагрузки. Будет ли она лучшим аналитиком документов, зависит от точности извлечения, ссылок и числа повторов, необходимых для приемлемого ответа.
Reasoning Controls
Обе модели предоставляют настраиваемый уровень рассуждений, по умолчанию — средний, согласно указанной документации. Luna также предоставляет настройку none. Используйте эти контролы по задаче: извлечение и маршрутизация могут требовать меньше рассуждений, чем неопределённый многошаговый рабочий процесс с инструментами. Одинаковая метка усилий не подразумевает одинаковый бюджет вычислений у разных поставщиков.
Multimodal Input and Structured Workflows
Обе принимают текст и изображения и выдают текст. Это делает их кандидатами для скриншотов, извлечения из изображений документов и структурированных downstream-воркфлоу. Сам по себе ввод не устанавливает равную точность на мелком тексте, диаграммах или визуальных интерфейсах; оценивайте эти случаи отдельно.
Speed and Task Economics
| Independent metric (max effort) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Output speed | 240.6 tokens/s | 123.0 tokens/s |
| Weighted cost per Intelligence Index task | $0.21 | $0.07 |
Artificial Analysis — независимый издатель тестов. Таблица — снэпшот страниц моделей при максимальном усилии, проверено 9 октября 2026 года, а не официальные показатели поставщиков. Скорость вывода — это токены, полученные после начала генерации; она отделена от времени до первого токена и полной задержки задачи. Стоимость на задачу — взвешенная метрика Intelligence Index, а не цена вашей производственной задачи или стоимость успешного исхода.
Снэпшотная пропускная способность вывода у Haiku примерно в 1.96 раза выше, чем у Luna, в то время как взвешенная стоимость оценочной задачи ниже у Luna. Это не доказывает 1.96-кратного преимущества по времени полного завершения задачи. В продакшене фиксируйте время до первого токена, время завершения, длину вывода, расход токенов рассуждений и время работы инструментов отдельно.
Claude Haiku 5.5 vs GPT-6 Luna: Pricing and API Access
Official Standard Rates
| USD per 1M tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $0.10 | $0.20 |
| Cached read | $0.01 | $0.05 | $0.01 | $0.02 |
| Cache write (Haiku: 5-minute TTL) | $0.125 | $0.625 | $0.125 | $0.25 |
| Output | $0.50 | $2.50 | $0.50 | $0.75 |
USD за миллион токенов при стандартных режимах обработки, проверено 9 октября 2026 года. Таблица использует стандартные тарифы Haiku и тарифы записи в кеш на 5 минут и тарифы Luna для короткого и длинного контекста. Платы за инструменты, налоги, региональные надбавки и опциональные корректировки уровней обработки исключены. При превышении порога входа повышенные тарифы применяются к запросу целиком, а не только к токенам сверх порога.
Ключевое различие — порог тарификации. Haiku переходит на повышенные тарифы свыше 100K токенов промпта, тогда как Luna сохраняет низкий уровень до 272K. Даже выше этого порога у Luna указанные цены ввода и вывода для длинного контекста ниже.
Haiku также предлагает записи в кеш на 1 час по $0.20/$1.00 за миллион токенов для коротких/длинных промптов. Устойчивость кеша и ценовые механизмы различаются у поставщиков, поэтому сравнивайте паттерны переиспользования, а не считайте строки записи в кеш идентичными продуктами. Лимит вывода Haiku в 128K — это ограничение стандартного API; его Message Batches API может поддерживать 300K вывода с бета-заголовком.
Illustrative Costs at Fixed Token Budgets
| Workload | Input / Output | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Ticket classification | 2K / 200 | $0.0003 | $0.0003 |
| Short report | 40K / 4K | $0.006 | $0.006 |
| Repository analysis | 150K / 5K | $0.0875 | $0.0175 |
| Large document review | 300K / 10K | $0.175 | $0.0675 |
| Massive context analysis | 800K / 20K | $0.45 | $0.175 |
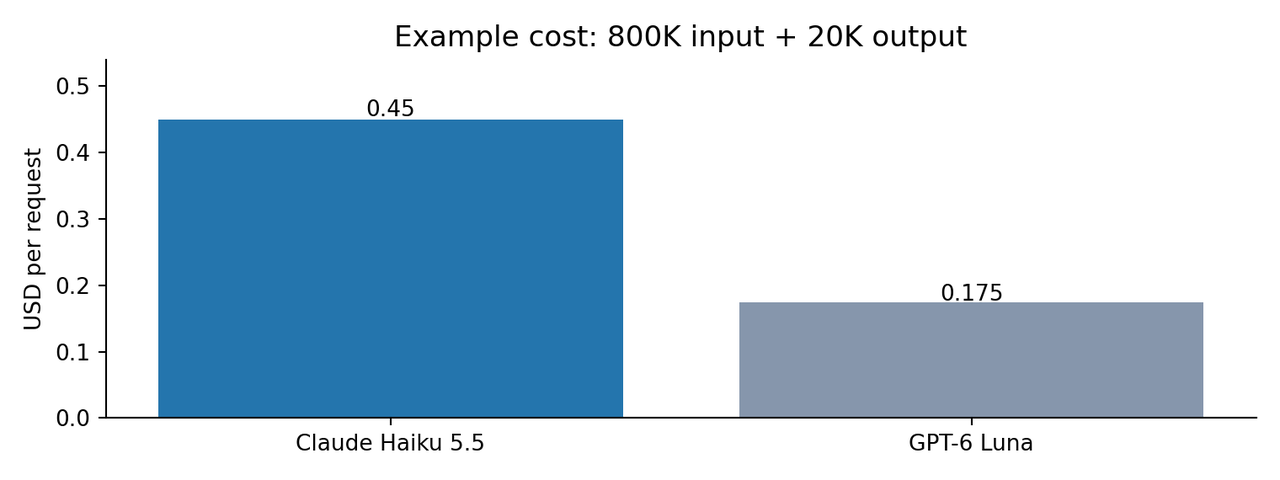
Оценка автора, без кеша и по стандартным тарифам: cost = входные токены × ставка ввода / 1,000,000 + тарифицируемые выходные токены × ставка вывода / 1,000,000. «Output» означает суммарный тарифицируемый вывод для этой оценки, включая токены рассуждений, если они тарифицируются как вывод; это не обязательно длина видимого ответа. Для обеих моделей используются одни и те же отчётные числа токенов, хотя токенизаторы могут отличаться.
Дешёвый токен не обязательно означает дешёвый успешный результат. Командам следует учитывать повторные попытки, неудачные вызовы инструментов, потребление токенов рассуждений и различия в поведении токенизатора.
CometAPI Access and Integration Constraints
CometAPI предоставляет варианты доступа для обеих моделей. Перед сравнением или развёртыванием через шлюз проверьте идентификаторы моделей, поддерживаемые эндпоинты, параметры запроса, поведение инструментов и правила биллинга для каждого маршрута. Эти ссылки провайдера документируют варианты доступа; они не заменяют технические или стандартные ценовые источники поставщиков.
Для прямых интеграций OpenAI Luna поддерживает встроенные инструменты через Responses API; вызов функций Chat Completions требует уровня рассуждений none. Haiku использует Messages API Anthropic и адаптивное мышление. Шлюз не делает базовые схемы взаимозаменяемыми: валидируйте определения инструментов, поведение структурированного вывода, событий стриминга и биллинг на том маршруте, который вы намерены использовать.
How Can Developers Compare Claude Haiku 5.5 and GPT-6 Luna With the Same Prompt?
Long-Document Extraction Example
Практическое сравнение можно провести на пакете договоров с поставщиками, содержащем даты вступления в силу, условия продления, сроки уведомления и исключения. Сохраните идентичными пакет документов, инструкции по извлечению, ожидаемые поля и правила валидации. Ниже — дизайн оценки, а не новый измеренный результат модели.
Пример запроса: извлеките для каждого договора название поставщика, дату вступления в силу, дату продления, срок уведомления о расторжении и ценовые исключения. Для каждого извлечённого значения укажите название документа и точный подтверждающий фрагмент. Возвращайте null, если поле отсутствует; не выводите недостающие даты. Пометьте конфликтующие положения и держите финальный ответ в пределах 1,000 слов.
| Check | Acceptance criterion | What to record |
|---|---|---|
| Extraction accuracy | Требуемые поля совпадают с независимо проверенным ключом | Корректные, неверные и отсутствующие значения |
| Grounding | Каждое ненулевое поле имеет валидный подтверждающий отрывок | Необоснованные утверждения и неверные ссылки на документы |
| Instruction following | Нет выдуманных дат; отсутствующие поля возвращают null | Срыв схемы и нарушения ограничений |
| Economics | Рассчитать расход на принятый результат | Тарифицируемый ввод, вывод, рассуждения, повторы и резерв |
| Latency | Сравнить полное время выполнения при одинаковой политике инструментов | Время до первого токена и общее время выполнения |
Запускайте более чем один репрезентативный пакет и повторяйте случаи с различиями в результатах. Начните с одинакового доступного уровня усилий, затем протестируйте более дешёвую конфигурацию для каждой модели. Указывайте размер выборки, настройки, маршрут, дату и число сбоев до объявления победителя.
Haiku 5.5 or GPT-6 Luna: Which to Choose?
| Dimension | Better-supported starting point | Decision boundary |
|---|---|---|
| GUI interaction | Claude Haiku 5.5 | Общие частичные оценки OSWorld в пользу Haiku; проверяйте полное завершение задач |
| Terminal coding | Claude Haiku 5.5 | Общие результаты Terminal-Bench в пользу Haiku; валидируйте изменения в репозитории |
| Short prompts and base prices | Test both | Базовые ставки идентичны; сравнивайте тарифицируемое использование и повторы |
| Prompts above 100K tokens | GPT-6 Luna on standard rates | Luna дольше сохраняет базовый уровень; точность может изменить общую стоимость |
| Streamed token throughput | Claude Haiku 5.5 in the dated snapshot | Пропускная способность отличается от сквозной задержки полного выполнения |
| Simple repeated extraction | Test Luna with low or no reasoning | Выбирайте по валидным принятым результатам, а не по цене в отрыве |
Choose Claude Haiku 5.5 for Benchmark-Relevant Interactive Tasks
Начинайте с Haiku, если ваше приложение похоже на опубликованные задачи с графическим компьютером, терминальным кодингом или профессиональной работой, и более высокая доля завершений компенсирует дополнительные расходы на рассуждения или длинный контекст. Подтвердите это преимущество в своём стеке инструментов перед маршрутизацией продакшен-трафика.
Choose GPT-6 Luna for Large-Prompt Cost Control
Начинайте с Luna, если промпты часто превышают 100K токенов и стандартные токенные расходы существенно влияют на бюджет. Это также кандидат для повторяющегося извлечения или маршрутизации, где можно обойтись низкими или нулевыми рассуждениями. Оставляйте рекомендацию условной — по доле принятых результатов и фактическому биллингу.
Use Both When Workloads Have Different Needs
Пилот может маршрутизировать извлечение из длинных документов в Luna, а задачи GUI или терминала — в Haiku, затем валидировать каждое решение по критериям приёмки. Запускайте резерв при неуспехе схемной валидации, отсутствии требуемых доказательств или провале задачеспецифичных проверок, учитывая стоимость и задержку резерва в сравнении.
Validate Before Switching
Включайте вашу текущую модель как базовый уровень. Переходите только когда кандидат достигает заданной цели по корректности и улучшает стоимость за принятый результат или сквозную задержку настолько, чтобы покрыть миграцию и поддержку. Остановите развёртывание, если возрастает число критических ошибок инструментов. Рекомендация меняется, если пилот показывает, что низкая ставка Luna «съедается» повторами, или что более высокие бенчмарковые баллы Haiku не улучшают успех вашей задачи.
- Используйте репрезентативную выборку и учитывайте корректные, неверные и неполные результаты.
- Измеряйте задержку до первого токена, сквозное время и надёжность инструментов.
- Отдельно отслеживайте входные, кешируемые, выходные и рассуждательные токены.
- Считайте стоимость за успешный результат, включая повторы и резерв.
- Сравнивайте средний и высокий уровень рассуждений перед включением максимума по умолчанию.
Conclusion
Claude Haiku 5.5 имеет более сильные доказательства head-to-head при запуске в бенчмарках профессиональной работы, использования компьютера и агентного кодинга, приведённых здесь. Также у него выше пропускная способность вывода в независимом снэпшоте. GPT-6 Luna имеет явное преимущество по стандартным тарифам для промптов свыше порога 100K у Haiku и более низкую взвешенную стоимость оценочной задачи. Ни одно из наблюдений само по себе не определяет производственную надёжность или стоимость за успешный результат.
Практический победитель — модель, которая выдаёт приемлемый результат по наименьшей полностью измеренной операционной стоимости. Запускайте обе на ваших собственных промптах, инструментах и правилах повтора, а не рассматривайте один бенчмарк как окончательный ответ.
FAQ
Почему стоимость задач может различаться, если у обеих моделей одинаковые базовые цены на токены?
Одинаковая базовая цена не означает одинаковый общий счёт. Модели могут расходовать разное количество входных, выходных и рассуждательных токенов, и им может требоваться разное число повторов или вызовов инструментов для получения приемлемого результата. Тарифы для длинного контекста и использование кеша также влияют на итог. Сравнивайте общую стоимость всех попыток, делённую на число принятых результатов, а не только цены на токены.
Повышенные тарифы для длинного контекста применяются только к токенам сверх порога?
Нет. В рамках стандартного ценообразования, описанного в этой статье, при превышении порога входа повышенные тарифы применяются к запросу целиком, а не только к «лишним» токенам. Например, запрос на 150K входных токенов пересекает порог Haiku в 100K, но остаётся в базовом уровне Luna до 272K. Используйте применимые ставки ввода и вывода для всего запроса при оценке стоимости.
Могут ли Claude Haiku 5.5 и GPT-6 Luna использовать общий кеш промптов?
Не предполагаете перенос кеш-записей между моделями или провайдерами. Проектируйте отдельные стратегии переиспользования, затем измеряйте доли попаданий и тарификацию на каждом маршруте. Поддержка шлюзом, правила удержания и структура запроса могут влиять на пригодность повторного ввода для кеширования; проверьте это до прогнозирования экономии.
Что должен покрывать тест миграции с Haiku на Luna?
Тестируйте репрезентативные текстовые и графические входы, требуемые структурированные поля, аргументы инструментов, потоковые ответы и восстановление после ошибок. Зафиксируйте долю приёмки текущей системы до миграции, затем сравнивайте обоих кандидатов при одинаковых правилах повторов и инструментов. Схожие цены на токены или категории моделей не устанавливают совместимость.
Должны ли бенчмарковые баллы включать резерв на Haiku или Luna?
Используйте баллы для выбора кандидатов, затем запускайте резерв по наблюдаемым сбоям, таким как неверные аргументы инструментов, отсутствие требуемых полей или невыполнение проверок задачи. Отслеживайте частоту резерва и общий тарифицируемый расход. Вторая модель может добавить задержку и расходы, поэтому убедитесь, что она улучшает долю принятых результатов, а не просто выдаёт второй ответ.
Можно ли маршрутизировать чувствительные данные через оба API?
Проверьте точных поставщиков и используемый шлюз, их текущие правила удержания, локации обработки, договорные условия и политику данных вашей организации перед маршрутизацией чувствительного ввода. Возможности модели и таблицы цен не устанавливают пригодность маршрута для регулируемых или конфиденциальных данных. Используйте одобренный маршрут, когда эти требования определяющие.