
Кратко
Google объявила Gemini 4 Argon 30 сентября 2026 года как передовую модель для сложных, долгих рабочих процессов. Опубликованные результаты показывают ясный паттерн: высокая эффективность в профессиональной интеллектуальной работе, задачах с длинным контекстом и отдельных оценках по разработке ПО, при более слабых результатах на некоторых бенчмарках терминала и компьютерного использования. Google вводит модель поэтапно. Отдельно CometAPI сообщает о доступности в каталоге с 1 октября; перед внедрением следует проверить право доступа аккаунта и выполнить успешный тестовый запрос. Более полезная история о производительности — где именно проявляются её выигрыши.
Argon набирает 68.9% на Vals Index, 65.4% на Vals Finance Agent v2, 77.9% на DeepSWE v1.1, 91.7% на LVBench и 84.2% на GraphWalks при контексте 256K–1M. Одновременно она отстаёт от конкурирующих передовых моделей на FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science и OSWorld-2.0.
Результаты благоприятствуют представлению Argon как модель для конкретных типов нагрузок. Её сильнейшие показатели сосредоточены вокруг профессиональной интеллектуальной работы, задач с очень длинным контекстом и отдельных мультимодальных и программно-инженерных оценок. Другие модели сохраняют преимущества в ряде тестов на терминал и компьютерное использование.
Ключевые выводы
- Gemini 4 Argon сильнее всего в корпоративной интеллектуальной работе, рассуждении на длинном контексте, мультимодальном понимании и нескольких оценках кодирования с длинным горизонтом.
- Её максимальный лимит вывода в 1 миллион токенов даёт больше пространства для длинных траекторий рассуждения; при этом публичная спецификация входного контекста не заявлена.
- Argon лидирует в ряде опубликованных результатов по интеллектуальной работе и длинному контексту, но GPT-6 Astra и Claude Opus 5.5 остаются впереди в отдельных оценках по кодированию и компьютерному использованию.
- Бенчмарки описывают конкретные конфигурации модели и агента. Метрики, входные условия и настройки оценки столь же важны, как и итоговые проценты.
- Роллаут Google и доступ через CometAPI — это отдельные заявления о доступности. Перед миграцией трафика проверьте активный маршрут, идентификатор модели и право доступа аккаунта.
Что такое Gemini 4 Argon?
Gemini 4 Argon — новая передовая модель Gemini от Google DeepMind, ориентированная на сложные рабочие процессы, требующие рассуждений через множество шагов, а не ответа на короткий запрос.
Официальное позиционирование Google подчёркивает реальную разработку ПО, корпоративную интеллектуальную работу, такую как юридическая и финансовая, оборонительную кибербезопасность, мультимодальное понимание и долгие агентные задачи.
Это важное отличие от недавних выпусков Flash. Gemini 3.8 Flash API в CometAPI предназначен как более дешёвая рабочая лошадка для массовых агентных нагрузок. Argon же представляет передний край стека Google, отдавая приоритет глубине и устойчивому исполнению.
Спецификации модели
| Спецификация | Gemini 4 Argon |
|---|---|
| Разработчик | Google DeepMind |
| Дата объявления | 30 сентября 2026 года |
| Семейство модели | Gemini 4 |
| Позиционирование | Передовая модель для рассуждений и длинного горизонта |
| Максимальный вывод | 1,000,000 токенов |
| Оценка длинного контекста | Тестировалась в диапазоне 256K–1M на GraphWalks |
| Публичный лимит входа | Не формализован в стандартной публичной спецификации API на момент запуска |
| Мультимодальное понимание | Да; включает графики, документы и оценку длинных видео |
| Агентное кодирование | Да |
| Компьютерное использование | Оценивалось |
| Кибербезопасность | Специализированные оборонительные возможности |
| Публичный ID модели в API Google | Не объявлен в начальной публичной документации Google; CometAPI использует gemini-4-argon как идентификатор в каталоге. |
Бюджет вывода и компромиссы
Google объявляет максимальный лимит вывода в 1 миллион токенов для Argon, что выше предыдущего лимита 64K, указанного в анонсе запуска. Это даёт запас для более длинных траекторий рассуждения. Не следует трактовать это как гарантированный общий бюджет для всей многозвонковой сессии агента или как доказательство улучшения каждого задания.
Максимальный вывод — не то же самое, что интеллект. Большее число токенов вывода само по себе не делает модель более способной; оно убирает один из возможных узких мест. Модель всё равно должна расходовать этот бюджет продуктивно.
Также есть компромисс по стоимости и задержке. Модель, которая действительно генерирует сотни тысяч токенов, может быть дорогой и медленной, даже если номинальная цена за токен кажется привлекательной.

Выбранные результаты бенчмарков воспроизведены из статьи. Сравнивайте модели внутри каждой строки; метрики и условия оценивания различаются. Эта диаграмма заменяет декоративный градиент и не представляет независимого тестирования.
Максимальный лимит вывода и окно входного контекста описывают разные возможности. Диапазон оценки GraphWalks — это свидетельство о протестированных входах, а не замена публичной спецификации API.
Как Gemini 4 Argon показывает себя на бенчмарках?
Таблица производительности Google DeepMind охватывает агентные рабочие процессы, профессиональную интеллектуальную работу и мультимодальные задачи. Значения ниже воспроизводят опубликованное сравнение. Они измеряют качество выполнения задач, а не пропускную способность по токенам или задержку ответа; «—» означает, что результат не приведён в этом сравнении.
| Бенчмарк | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Условия оценивания |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | Приватный набор; таблица лидеров Zapier |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe harness; смешанные источники |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Proximal leaderboard |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Таблица лидеров Vals AI |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | Самотест / таблица лидеров |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1; OpenCode; 10h; одна H100 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | Таймаут верификатора ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Инструменты Linux; интернет |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Таблица лидеров Surge |
| GraphWalks до 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1; 650 элементов |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1; 200 элементов |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | Бинарный проход; ALE-Claw; 5h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | Оффлайн частичный балл; лучшее из 3 запусков |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | Без инструментов; таблица лидеров Surge |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | Без инструментов; специфическая для модели выборка кадров |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1; pass@4 решает ничьи |
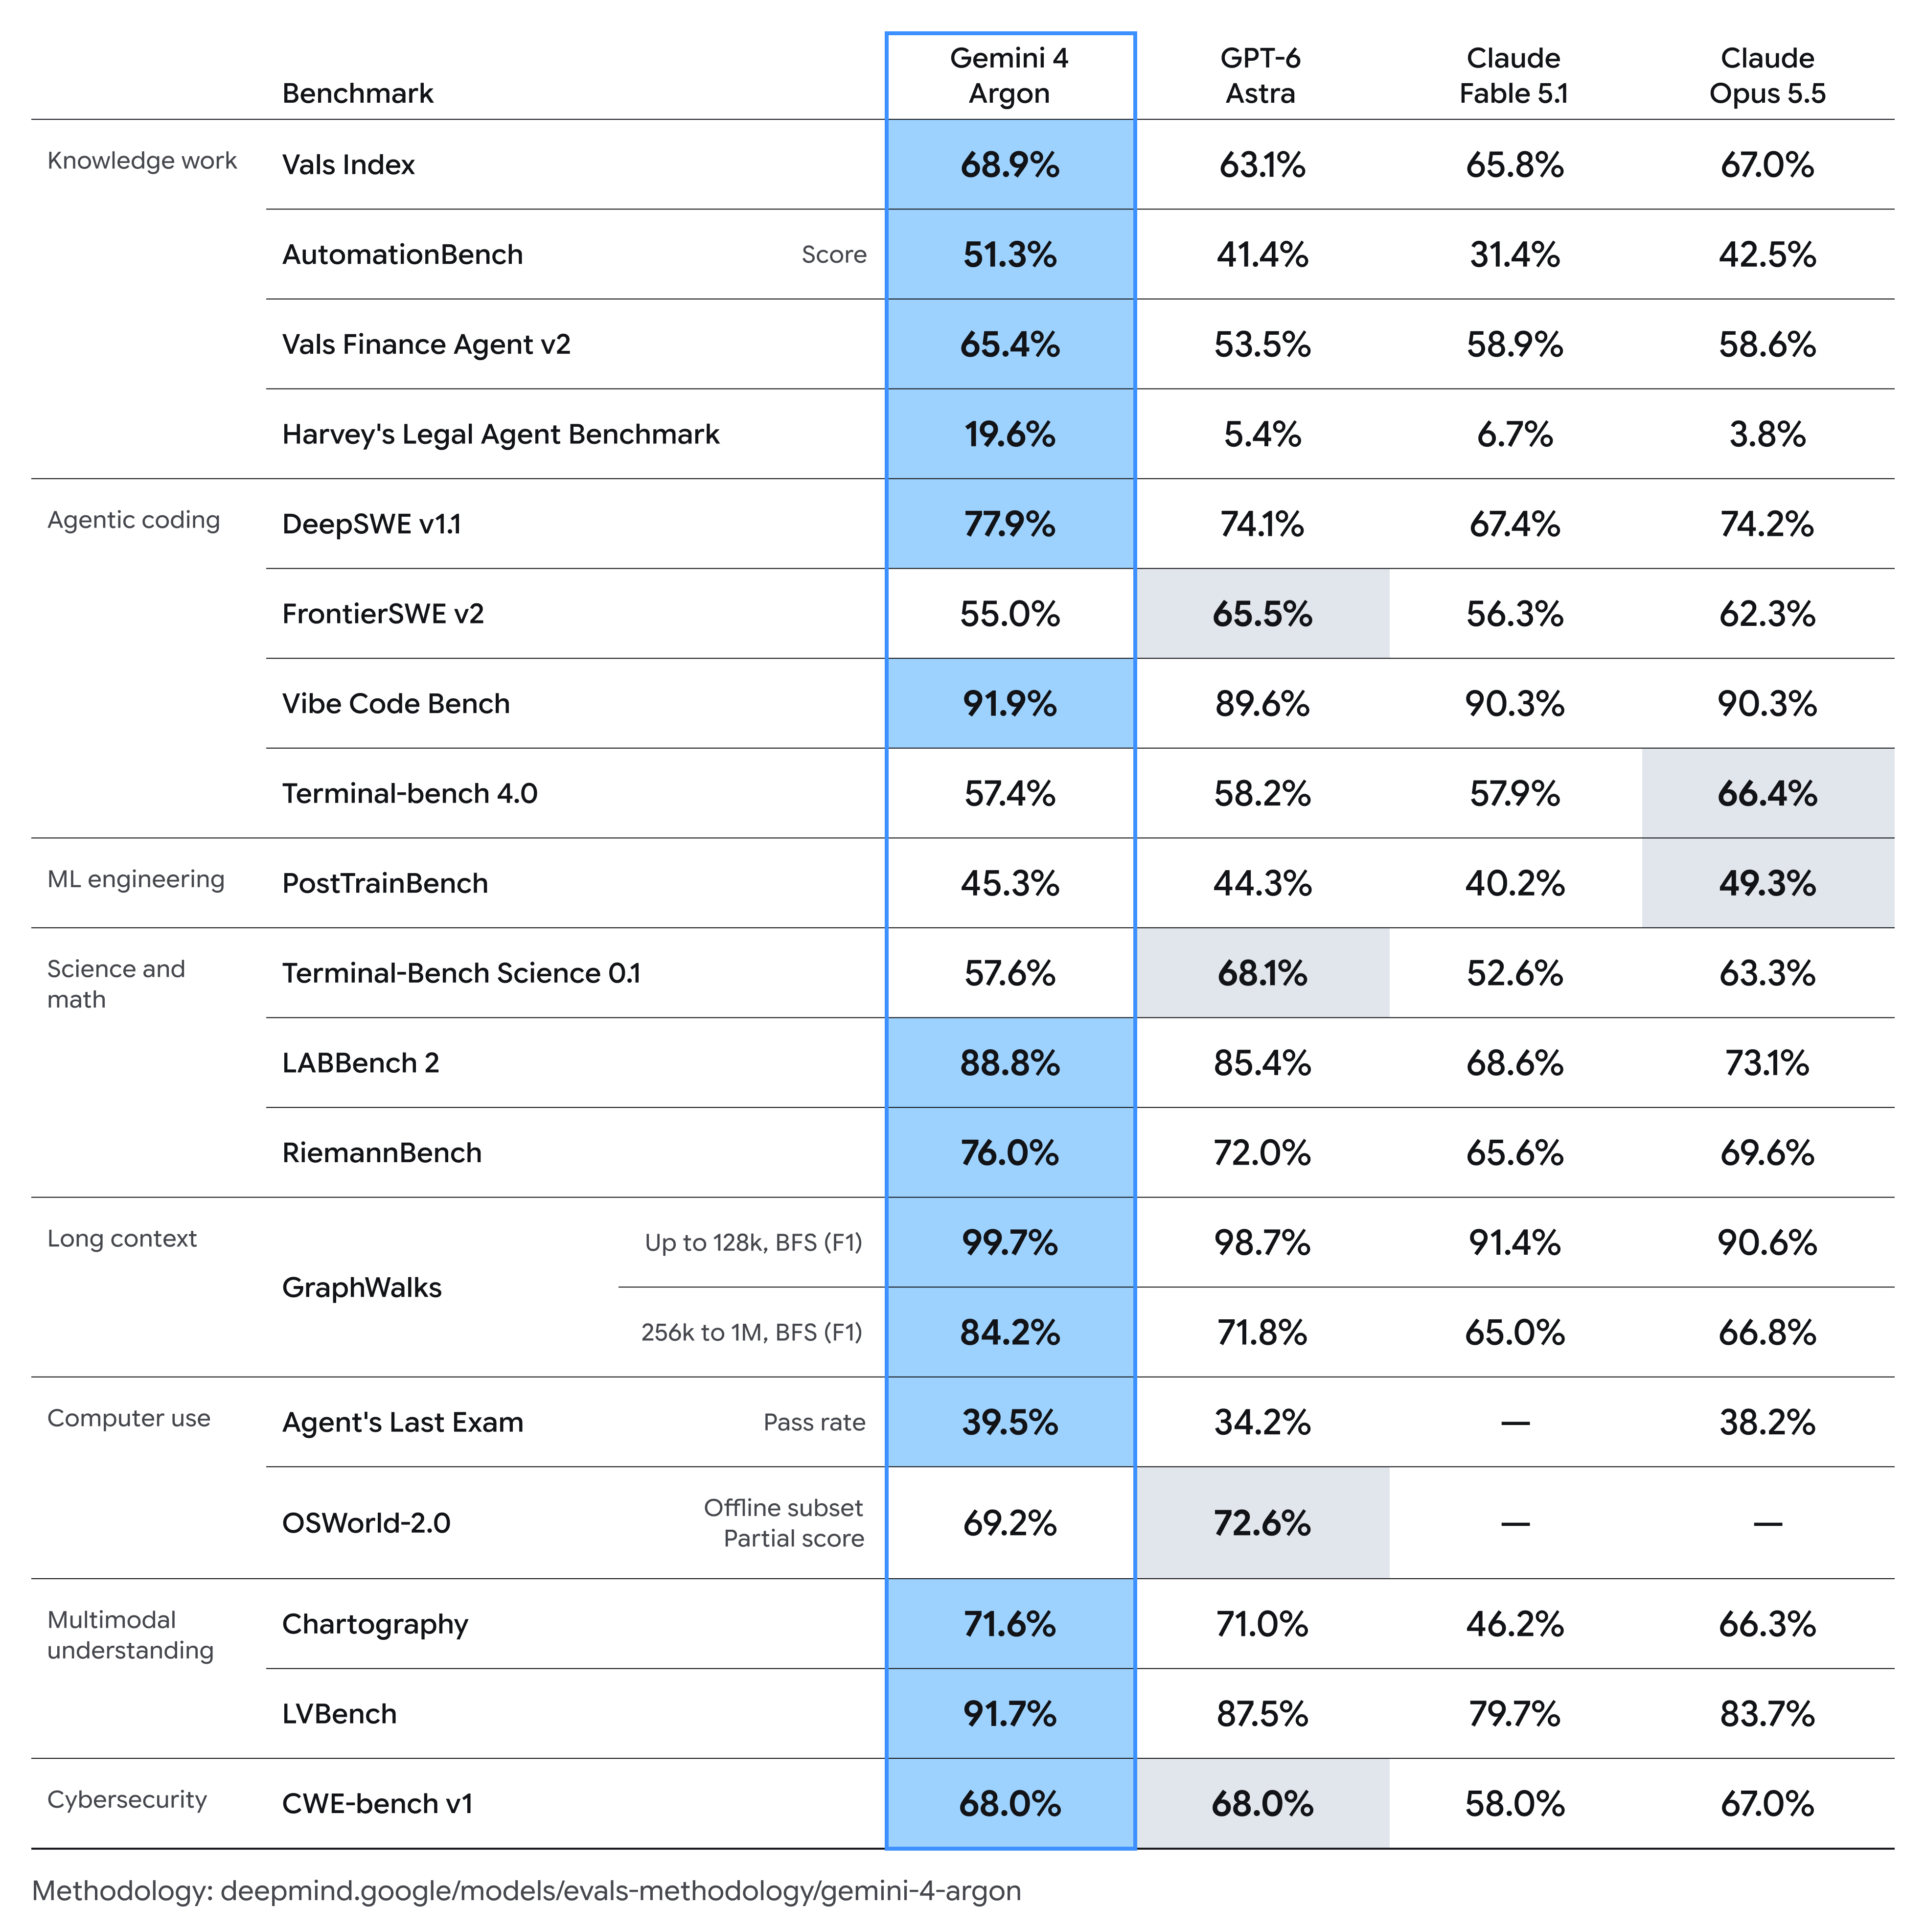
Официальное сравнительное тестирование Gemini 4 Argon от Google
Если не указано иное, результаты Argon используют одну попытку и наивысший режим thinking. Результаты других моделей, как правило, взяты из отчётов провайдеров, с бенчмарко-специфичными исключениями. LVBench использует 1 FPS для Gemini, 800 кадров для GPT-6 Astra, 300 для Fable 5.1 и 600 для Opus 5.5. Эти входы не идентичны, поэтому сравнивайте заявленные конфигурации, а не трактуйте каждую строку как контролируемый перезапуск.
Условия оценивания и ограничения
Таблица полезна, но её не следует интерпретировать как независимую универсальную таблицу лидеров.
- Выбор бенчмарков — это выбор Google.
- Бенчмарко-специфические настройки оценивания различаются по строкам, включая агентные фреймворки, временные бюджеты, инструменты и выборку входов.
- Официальная методология определяет результаты конкурентов, сообщаемые провайдерами, как базовые, с бенчмарко-специфичными исключениями для таблиц лидеров и собственных вычислений.
- Наивысшая настройка бенчмарка может не отражать стандартную продакшн-конфигурацию инференса.
- Один заголовочный балл бенчмарка не раскрывает использование токенов, вызовы инструментов, ретраи, затраченное время или человеческое вмешательство.
Для продакшн-систем часто лучшая метрика — стоимость за успешно выполненную задачу, а не цена за токен или один процент в бенчмарке.
Для каких нагрузок Gemini 4 Argon подходит лучше всего?
Производительность в интеллектуальной работе
Самый явный паттерн в результатах Argon проявляется в профессиональной многошаговой интеллектуальной работе.
На Vals Index Argon достигает 68.9% против 67.0% у Claude Opus 5.5. Числовой разрыв умеренный, но в специализированных процессах он становится более явным.
- Vals Finance Agent v2: 65.4%, на 6.5 пункта выше сильнейшего конкурента в таблице Google.
- AutomationBench: 51.3%, на 8.8 пункта выше Claude Opus 5.5.
- Harvey's Legal Agent Benchmark: 19.6% против 6.7% у следующей по силе модели.
Профиль производительности предполагает, что Argon приносит наибольшую пользу, когда модели нужно собрать информацию, сохранять состояние, рассуждать через несколько стадий и создавать профессиональный артефакт, а не просто отвечать на закрытый вопрос.
Важно и то, что абсолютный балл на юридическом агенте низкий. Один показатель 19.6% не разоблачает, сколько критериев или полных процессов провалено. Полезный вывод: Argon показывает большое относительное улучшение в этой оценке, однако результат не устанавливает надёжную автоматизацию юридической работы.
Рассуждение на длинном контексте
Самое яркое преимущество — версия GraphWalks в диапазоне 256K–1M.
- Gemini 4 Argon: 84.2%
- GPT-6 Astra: 71.8%
- Claude Opus 5.5: 66.8%
- Claude Fable 5.1: 65.0%
Это преимущество в 12.4 пункта над ближайшей моделью в опубликованном сравнении.
Разрыв гораздо меньше на коротких контекстах: в GraphWalks до 128K Argon набирает 99.7%, а GPT-6 Astra — 98.7%. Это предполагает, что Argon деградирует менее резко, чем сравниваемые модели, на этом конкретном бенчмарке с очень длинным контекстом.
Google не раскрыл достаточно архитектурной информации, чтобы приписать это различие конкретному механизму внимания, системе извлечения, рецепту обучения или стратегии в момент инференса. Утверждения вроде «Gemini 4 вводит новую архитектуру внимания» выходили бы за пределы публичных доказательств.
Производительность в кодировании
Официальная таблица бенчмарков не поддерживает простой ответ «да».
Argon показывает отличные результаты в некоторых видах кодирования и явно проигрывает в других. На DeepSWE v1.1 она достигает 77.9% против 74.2% у Claude Opus 5.5 и 74.1% у GPT-6 Astra. Её показатель на Vibe Code Bench также высок — 91.9%.
- FrontierSWE v2: 55.0% у Argon против 65.5% у GPT-6 Astra.
- Terminal-Bench 4.0: 57.4% у Argon против 66.4% у Claude Opus 5.5.
- Terminal-Bench Science 0.1: 57.6% у Argon против 68.1% у GPT-6 Astra.
Этот сплит важен для разработчиков. Argon особенно сильна, когда кодирование превращается в длинный инженерный процесс с существенным контекстом и планированием, тогда как терминал-ориентированное исполнение остаётся более конкурентным. Бенчмарк миграции репозитория и интерактивный терминальный бенчмарк не следует рассматривать как взаимозаменяемые меры «способности к кодированию».
Оборонительная кибербезопасность
Кибербезопасность — ключевая область внедрения. Оборонительное позиционирование Google включает автономное обнаружение уязвимостей, их валидацию и патчинг. Это заявление о возможностях провайдера; результат CWE-bench ниже измеряет устранение уязвимостей в собственной оценке.
На CWE-bench v1 Argon набирает 68%, на одном уровне с GPT-6 Astra и чуть выше Claude Opus 5.5 с 67%.
Google также подчёркивает усиленные меры против злоупотребления, косвенной инъекции подсказок, рискованного поведения агента и компрометации среды исполнения. Таким образом, Argon — это в равной степени релиз по безопасности агентов, как и традиционное обновление модели.
Мультимодальное понимание
Argon набирает 71.6% на Chartography и 91.7% на LVBench для понимания длинных видео. На LVBench результат на 4.2 пункта выше, чем у GPT-6 Astra в таблице Google. Так как модели получают разные конфигурации выборки кадров, это сравнение настроек, а не «чистого» преимущества самой модели.
Это важно, потому что многие профессиональные процессы не ограничиваются текстом. Финансовому исследовательскому агенту может понадобиться рассмотреть график; корпоративный ассистент может сочетать отчёты, PDF и скриншоты; система анализа видео должна сохранять события по длинной последовательности, а не обрабатывать отдельные кадры независимо.
Комбинация мультимодального восприятия и устойчивого рассуждения у Argon важнее, чем одна лишь поддержка мультимодальности.
Научные и математические задачи
Результаты неоднородные, но в целом сильные. Argon достигает 88.8% на LABBench 2 и 76.0% на RiemannBench, опережая сравниваемые модели в таблице Google. Однако на Terminal-Bench Science 0.1 GPT-6 Astra набирает 68.1% против 57.6% у Argon.
Эта разница указывает на более широкий паттерн: Argon сильнее в рассуждении по научной информации, чем во всех формах инструментально управляемого научного исполнения.
Компьютерное использование
На Agent's Last Exam Argon набирает 39.5% бинарного прохождения, опережая GPT-6 Astra с 34.2% и Claude Opus 5.5 с 38.2%. На оффлайн-подмножестве OSWorld-2.0 её частичный балл — 69.2%, ниже 72.6% у GPT-6 Astra. Значение OSWorld не является показателем полного успешного завершения задач, а отсутствие записей для Claude не означает нулевую способность.
Текущие данные не демонстрируют повсеместного преимущества в компьютерном использовании. Для продакшна баллы бенчмарков следует дополнять тестами на уровне задач: точность навигации, количество неудачных кликов, частота ретраев, нежелательные действия, время до завершения и частота человеческой коррекции.
Gemini 4 Argon vs GPT-6 Astra и Claude
| Измерение | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Интеллектуальная работа | Очень сильная | Сильная | Очень сильная | Сильная |
| Длинный контекст | Сильнейший опубликованный результат | Сильная | Средне–сильная | Средняя |
| Длинный горизонт кодирования | Очень сильная | Очень сильная | Очень сильная | Сильная |
| Терминальное кодирование | Конкурентоспособная | Сильная | Сильнейшая в отдельных тестах | Конкурентоспособная |
| Научные терминальные агенты | Конкурентоспособная | Сильнейшая в отдельных тестах | Сильная | Конкурентоспособная |
| Мультимодальное понимание | Очень сильная | Очень сильная | Сильная | Конкурентоспособная |
| Компьютерное использование | Конкурентоспособная | Сильная | Смешанная / ограниченное сравнение | Ограниченное сравнение |
| Кибербезопасность | Делит лидерство на CWE-bench v1 | Делит лидерство | Очень близко | Ниже |
Argon выделяется в этом сравнении на задачах с длинным контекстом, насыщенных документами, и профессиональной агентной работе. Разработчики могут сравнить её с GPT-6 Astra, Claude Opus 5.5 и Claude Fable 5.1 через CometAPI.
Выбор на основе производительности
Качественные ярлыки выше суммируют выбранную таблицу бенчмарков, а не универсальный рейтинг. Отдавайте приоритет Argon в пилоте, когда работа похожа на её лидирующие оценки; тестируйте Astra и Opus на терминал-ориентированных нагрузках перед выбором дефолта.
Спецификации и ограничения внедрения
Это сравнение по производительности не устанавливает архитектурного преимущества или общего победителя по price-performance. Число параметров и архитектура Argon не указаны в изученных материалах запуска Google. Её публичный лимит входного контекста требует официальной документации API. CometAPI сообщает маршрут gemini-4-argon; подтвердите поддерживаемые параметры и доступ аккаунта независимо от широкой программы роллаута Google. Сравните лимиты каждого маршрута и реальные затраты на задачи перед внедрением.
Как разработчики могут получить доступ к Gemini 4 Argon через CometAPI?
CometAPI сообщает, что модель доступна под идентификатором gemini-4-argon. Используйте панель управления для создания API-ключа, выберите этот идентификатор в песочнице и выполните тестовый запрос перед интеграцией. В OpenAI-совместимом примере базовый URL — https://api.cometapi.com/v1. Подтвердите поддерживаемые конечные точки и параметры в документации аккаунта; одной лишь метки в каталоге недостаточно, чтобы подтвердить успешный вызов.
- Создайте аккаунт CometAPI и сгенерируйте API-ключ в панели управления.
- Выберите gemini-4-argon и проверьте репрезентативный запрос в песочнице.
- Настройте совместимый клиент с базовым URL CometAPI, вашим ключом и идентификатором модели; подтвердите поддерживаемую схему запроса и биллинг перед внедрением.
CometAPI и официальное ценообразование
Google объявила вводные цены $2 за миллион входных токенов и $10 за миллион выходных токенов, с кэшированными входами по цене со скидкой 95% от ставки для входа. После вводного периода объявленные ставки — $4 за вход и $20 за выход за миллион токенов. Это объявленные Google ставки, а не цены CometAPI и не подтверждение немедленного общего доступа к API.
| Основа биллинга | Gemini 4 Argon API в CometAPI | Официальное объявление Google | Сравнение |
|---|---|---|---|
| Вход / 1M токенов | $3.20 | $4.00 после вводного периода | На 20% ниже объявленной пост-вводной ставки |
| Выход / 1M токенов | $16.00 | $20.00 после вводного периода | На 20% ниже объявленной пост-вводной ставки |
Заключение
Профиль бенчмарков Gemini 4 Argon интереснее, чем простое заявление о лидерстве.
Сильнейшие результаты в этом сравнении сосредоточены вокруг профессиональной интеллектуальной работы, длинного контекста и устойчивого агентного исполнения. Этот паттерн полезен для выбора нагрузок, но не идентифицирует базовую архитектуру и не доказывает, какой механизм вызвал выигрыши.
Опубликованные результаты по финансам, праву, длинному видео и разработке ПО поддерживают сфокусированный пилот для этих нагрузок. Сохранится ли то же преимущество в продакшне, зависит от микса входов, агентного фреймворка, настроек инференса и требований к верификации.
Одновременно результаты показывают, что производительность передовых моделей становится всё более специализированной. Argon может лидировать на DeepSWE, отставая на FrontierSWE; лидировать на Agent's Last Exam, уступая на OSWorld; и лидировать на LABBench, уступая на Terminal-Bench Science. Эти бенчмарки нагружают разные части агентной системы.
Для разработчиков главный урок в том, что выбор модели всё чаще должен происходить на уровне конкретной нагрузки, а не бренда или семейства.
FAQ
Как разработчикам валидировать Gemini 4 Argon на собственных задачах?
Соберите репрезентативный набор задач с явными критериями приёмки. Держите инструменты, лимиты времени, подготовку входов и политику ретраев сопоставимыми между моделями. Записывайте выполненные задачи, общее число токенов, затраченное время и объём человеческой коррекции. Начните с небольшого пилота и изучите случаи отказов перед маршрутизацией продакшн-трафика.
Можно ли усреднить проценты бенчмарков Gemini 4 Argon в один балл?
Нет. Таблица объединяет разные метрики, включая F1, доли прохождений и частичные баллы. Используйте критерии, специфичные для задачи, а не усреднение всех процентов.
Должен ли агент Gemini 4 Argon всегда использовать весь бюджет вывода?
Нет. Выбирайте наименьший протестированный бюджет, который соответствует вашим требованиям по качеству и надёжности. Максимальный лимит вывода — это потолок, а не целевой показатель.
Как командам оценить доступ к Gemini 4 Argon через CometAPI?
Начните с проверки доступности на уровне аккаунта и небольшого запроса по документированному маршруту CometAPI. Измерьте качество ответа, задержку, лимиты и биллингуемые токены, затем примените те же критерии приёмки, что и для альтернативных моделей. Рассматривайте заявление о доступе в CometAPI отдельно от более широкого роллаута Google и держите маршрутизацию конфигурируемой, пока маршрут не соответствует вашим требованиям.