
TL;DR
Claude Fable 5.1 имеет более сильные бенчмарки для сложного автономного кодинга и задач с длинным горизонтом. GPT-5.6 Sol предлагает более низкую стоимость обычных токенов, широкий нативный стек инструментов и меньшую задержку до первого токена в независимом сравнении при максимальном усилии. Правильный дефолт зависит от стоимости неуспешной задачи, а не только от наивысшего бенчмаркового балла.
В снимке Intelligence Index от 8 сентября 2026 года Fable 5.1 набирает 53, против 47 у GPT-5.6 Sol. Скорость вывода фактически одинакова — 69,9 против 69,8 токенов/с. Эти результаты поддерживают решение по схеме «качество против стоимости»; они не устанавливают универсального лидера по скорости.
Ключевые выводы
- Выбирайте Fable 5.1 для самых сложных автономных задач, если ваши собственные оценки оправдывают более высокую цену.
- Начинайте с GPT-5.6 Sol для чувствительных к стоимости задач на переднем крае и приложений, которым полезен его интегрированный инструментарий.
- Сравнивайте задержку старта отдельно от скорости вывода: у GPT-5.6 Sol ниже измеренное время до первого токена, тогда как пропускная способность почти равна.
- Учитывайте запись/чтение/удержание кэша и тарифы длинного контекста отдельно. Заголовочные цены на ввод/вывод не описывают каждый агентный рабочий процесс.
Данные проверены 8 сентября 2026 года. Независимые результаты используют GPT-5.6 Sol на максимальном усилии и Fable 5.1 с Adaptive Reasoning, Max Effort, Default Fallback. Бенчмарки вендоров и независимые бенчмарки используют разные конфигурации оценок. Цены указаны в долларах США за миллион токенов (MTok), если не указано иное.
GPT-5.6 Sol vs Fable 5.1: краткий вердикт
| Измерение | GPT-5.6 Sol | Claude Fable 5.1 | Лучший выбор |
|---|---|---|---|
| Независимый Intelligence Index v4.3 (8 сен) | 47 | 53 | Fable 5.1 |
| Independent Terminal-Bench 4.0 (7 сен) | 39.9% | 52.0% | Fable 5.1 |
| Anthropic-run Terminal-Bench 4.0 | 37.3% | 55.8% | Fable 5.1 |
| Окно контекста | 1.05M | 1M | Практически равны |
| Максимальный вывод | 128K | 128K | Ничья |
| Ввод текста/изображений | Да | Да | Ничья |
| Официальная цена ввода / MTok | $4 | $10 | Sol |
| Официальная цена вывода / MTok | $20 | $50 | Sol |
| Официальное чтение кэша / MTok | $0.40 | $0.25 | Fable 5.1 |
| Независимая скорость вывода (8 сен) | 69.8 tok/s | 69.9 tok/s | Практически равны |
| Широта набора инструментов API | Очень широкая | Сильная | Sol |
| Длительная автономная работа | Отличная | Ключевая сила | Fable 5.1 |
| Продакшн, чувствительный к стоимости | Лучший дефолт | Премиум-эскалация | Sol |
Полезная стартовая политика — Sol для рутинной работы на переднем крае, с Fable 5.1 как маршрутом эскалации, когда задача не проходит ваши пороги качества или автономности. Валидируйте эту политику по стоимости успешной задачи.
GPT-5.6 Sol предоставляет шесть уровней усилия рассуждений — от none до max, по умолчанию medium. Fable 5.1 использует постоянно задействованное адаптивное мышление; параметр effort управляет глубиной рассуждений, и по умолчанию он высокий.
Дополнительные 50 000 токенов в контексте GPT-5.6 Sol вряд ли определят архитектуру в большинстве случаев. По мере приближения запроса к одному миллиону токенов тарификация и повторное использование кэша становятся более существенными; ниже раздел о длинном контексте объясняет почему.
Что такое GPT-5.6 Sol?
GPT-5.6 Sol — высоковозможностной уровень в семействе GPT-5.6 для требовательного кодинга, исследований, планирования и агентных рабочих процессов. Его главный плюс в этом сравнении — сочетание контролей рассуждений и окружающей среды исполнения.
Через Responses API GPT-5.6 Sol поддерживает широкий портфель нативных инструментов: веб-поиск, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills и tool search. Это может сократить количество отдельных компонентов рантайма, которые приложению нужно интегрировать.
OpenAI также описывает программный вызов инструментов и многовычислительное исполнение для семейства. Эти платформенные возможности важны, когда модель должна координировать работу между инструментами, а не просто вернуть единичный ответ.
Что такое Claude Fable 5.1?
Claude Fable 5.1 ориентирован на требовательный кодинг, профессиональную интеллектуальную работу, исследования и долго работающие агенты. Его прямые бенчмарки делают его сильным кандидатом для задач, где важнее восстановление, устойчивость и успешное завершение, чем короткий ответ.
Anthropic подчеркивает устойчивое автономное исполнение в приложениях, включая планирование, восстановление после неудачных шагов и коммуникацию прогресса. Рассматривайте это позиционирование как повод тестировать более длинные задачи, а не как гарантию, что каждый рабочий процесс завершится корректно.
Fable 5.1 также отличается от GPT-5.6 Sol поведением API: его ограничения на принудительный выбор инструмента важны для рабочих процессов, где модель должна вызвать конкретный инструмент. Проверьте поддерживаемые режимы tool_choice при миграции детерминированного агентного цикла.
Вопрос интеграции, таким образом, практический: может ли ваше приложение терпеть более автономный цикл рассуждений или ему требуется более тонкий контроль над каждым шагом? Тестируйте точное поведение инструментов перед выбором маршрута.
Сравнение бенчмарков: у Fable 5.1 более сильная прямая база доказательств
Сравнение бенчмарков конкурирующих вендоров легко использовать неправильно. Исходные оценки релиза GPT-5.6 от OpenAI предшествуют Fable 5.1, тогда как релиз Fable 5.1 от Anthropic содержит новые прямые сравнения с GPT-5.6 Sol.
Чистый способ читать доказательства — в трех слоях: прямое сравнение от Anthropic, актуальные независимые тесты и собственный профиль возможностей GPT-5.6 Sol от OpenAI.
Прямые результаты Anthropic: Fable 5.1 vs GPT-5.6 Sol
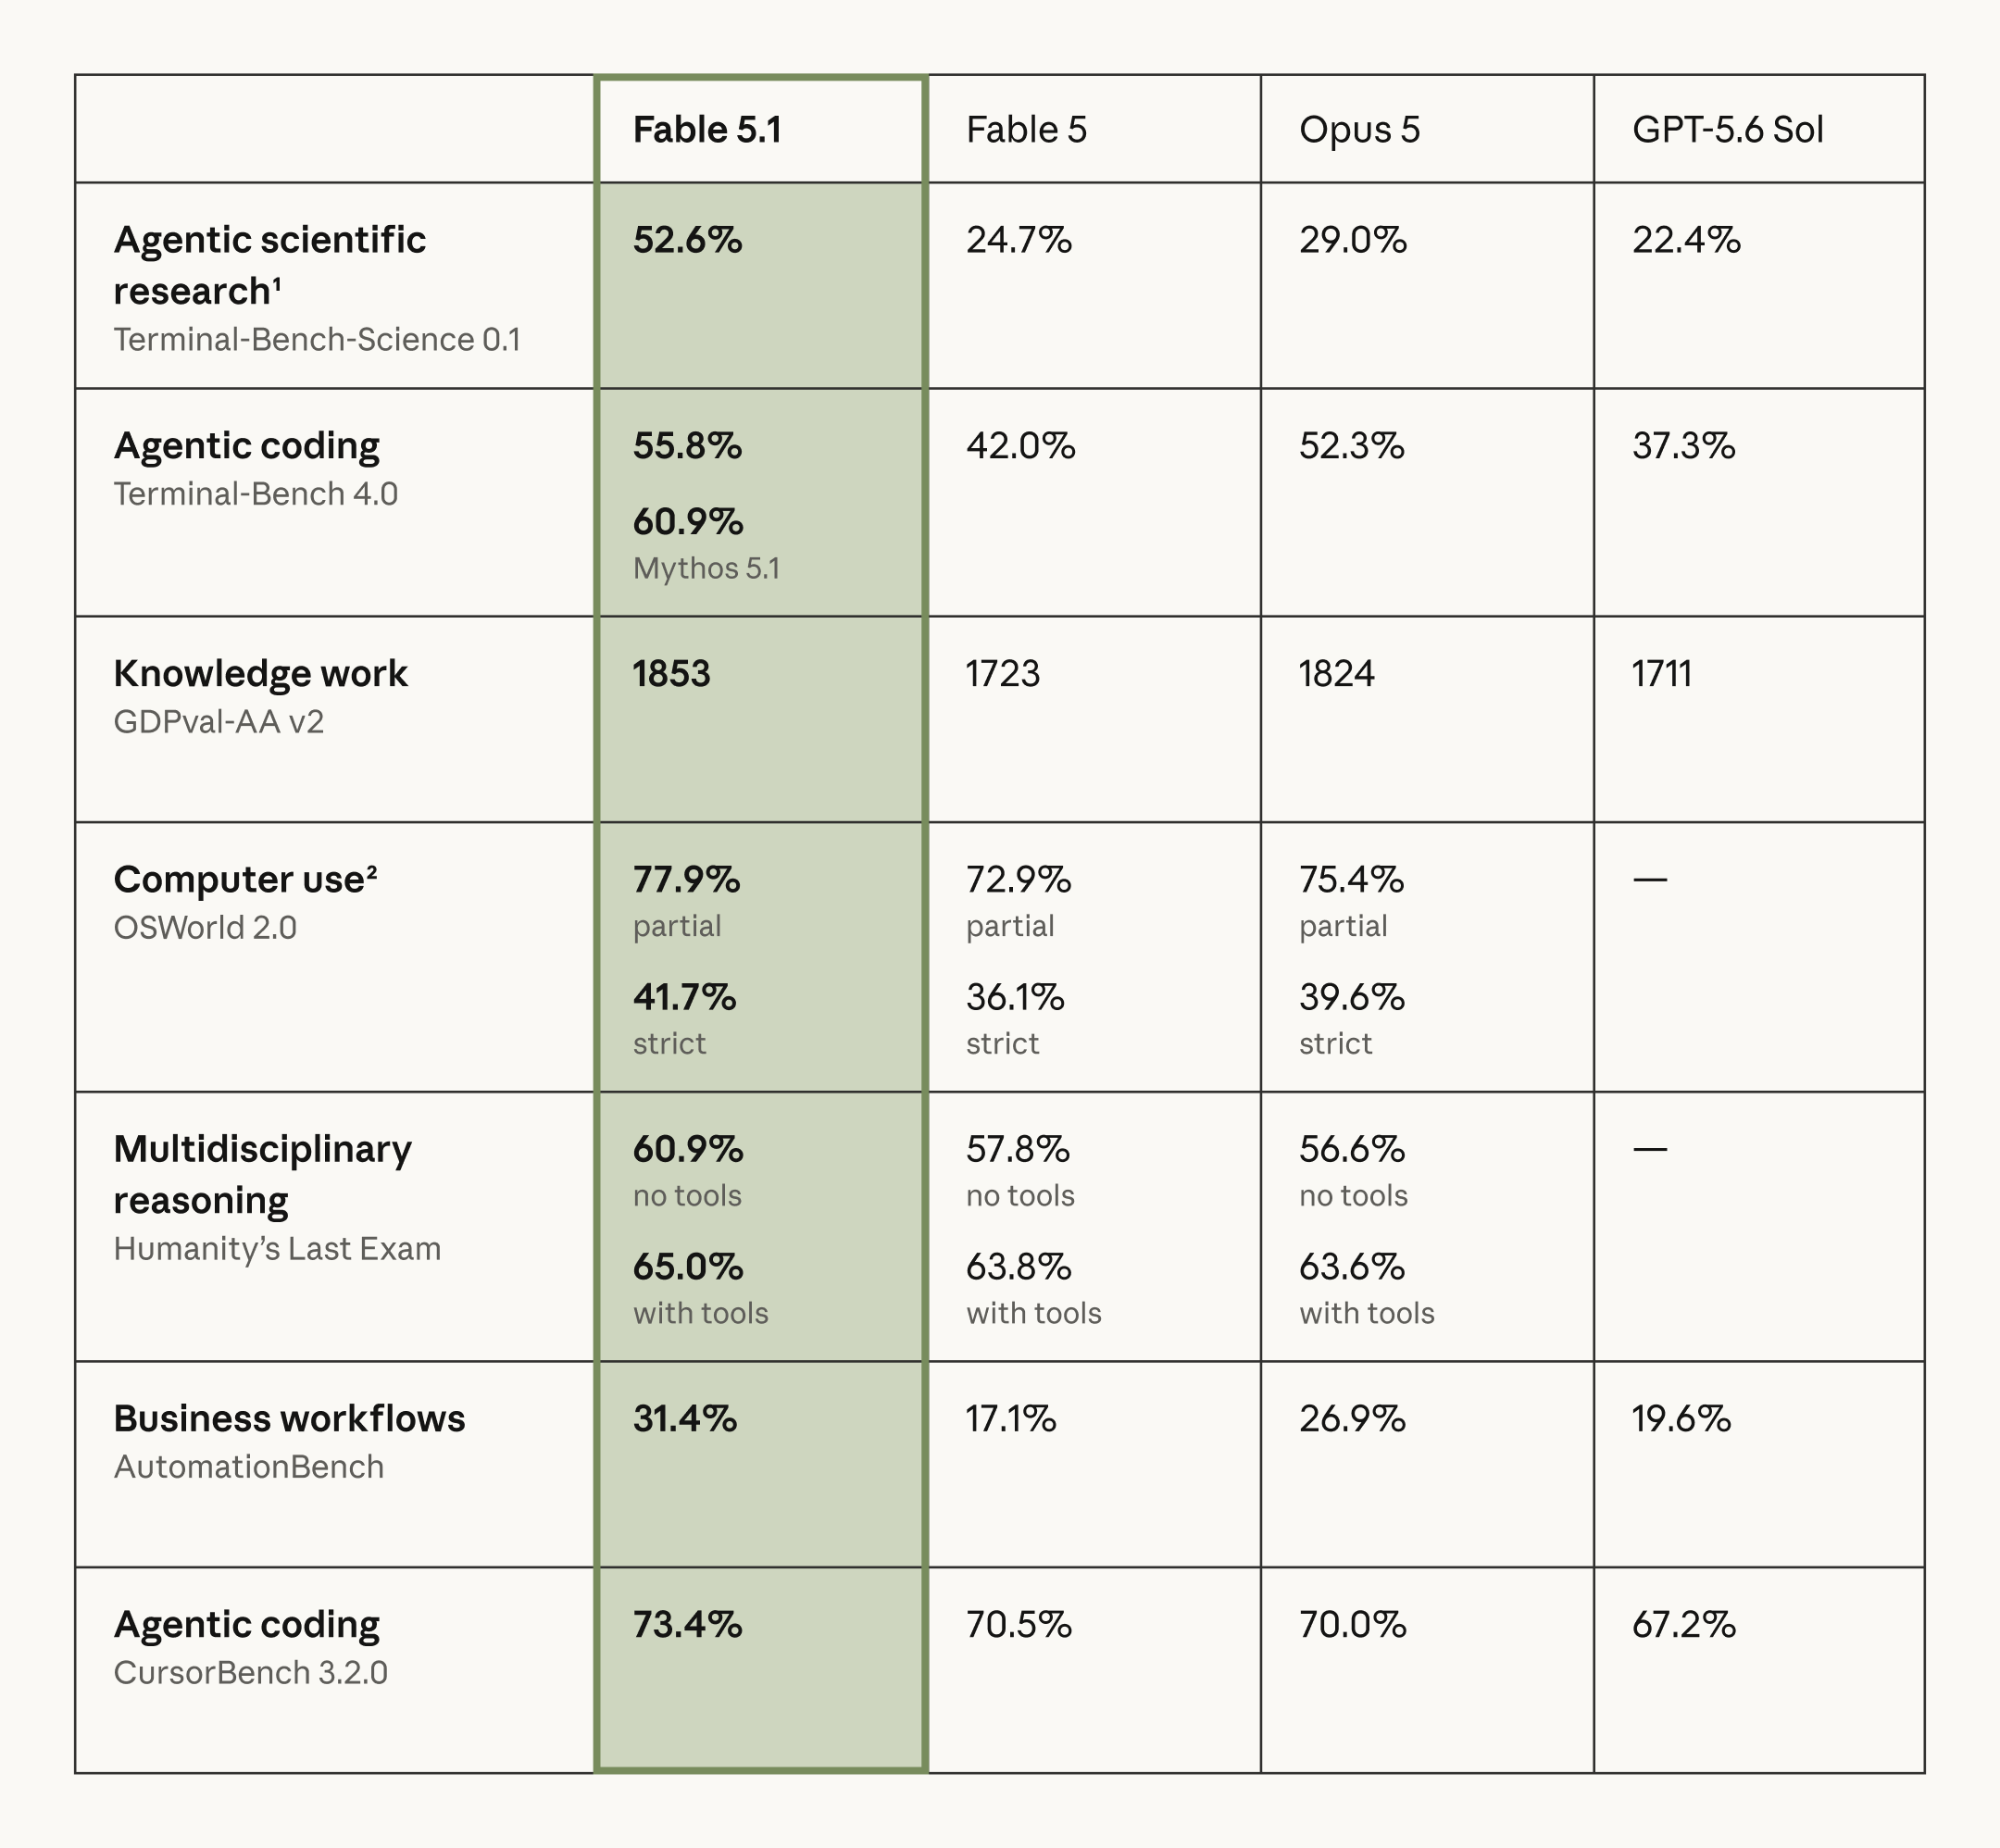
Официальные результаты бенчмарков включают пять задач с опубликованными баллами для обеих моделей. Разницы в процентных пунктах и Elo ниже рассчитаны по опубликованным значениям.
| Бенчмарк | GPT-5.6 Sol | Claude Fable 5.1 | Преимущество Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 п.п. |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 п.п. |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 п.п. |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 п.п. |
Результат необычно консистентный: Fable 5.1 опережает GPT-5.6 Sol в каждой опубликованной строке. Наибольшие различия проявляются в агентных научных исследованиях и терминально-ориентированном кодинге, а не в коротких задачах рассуждения.
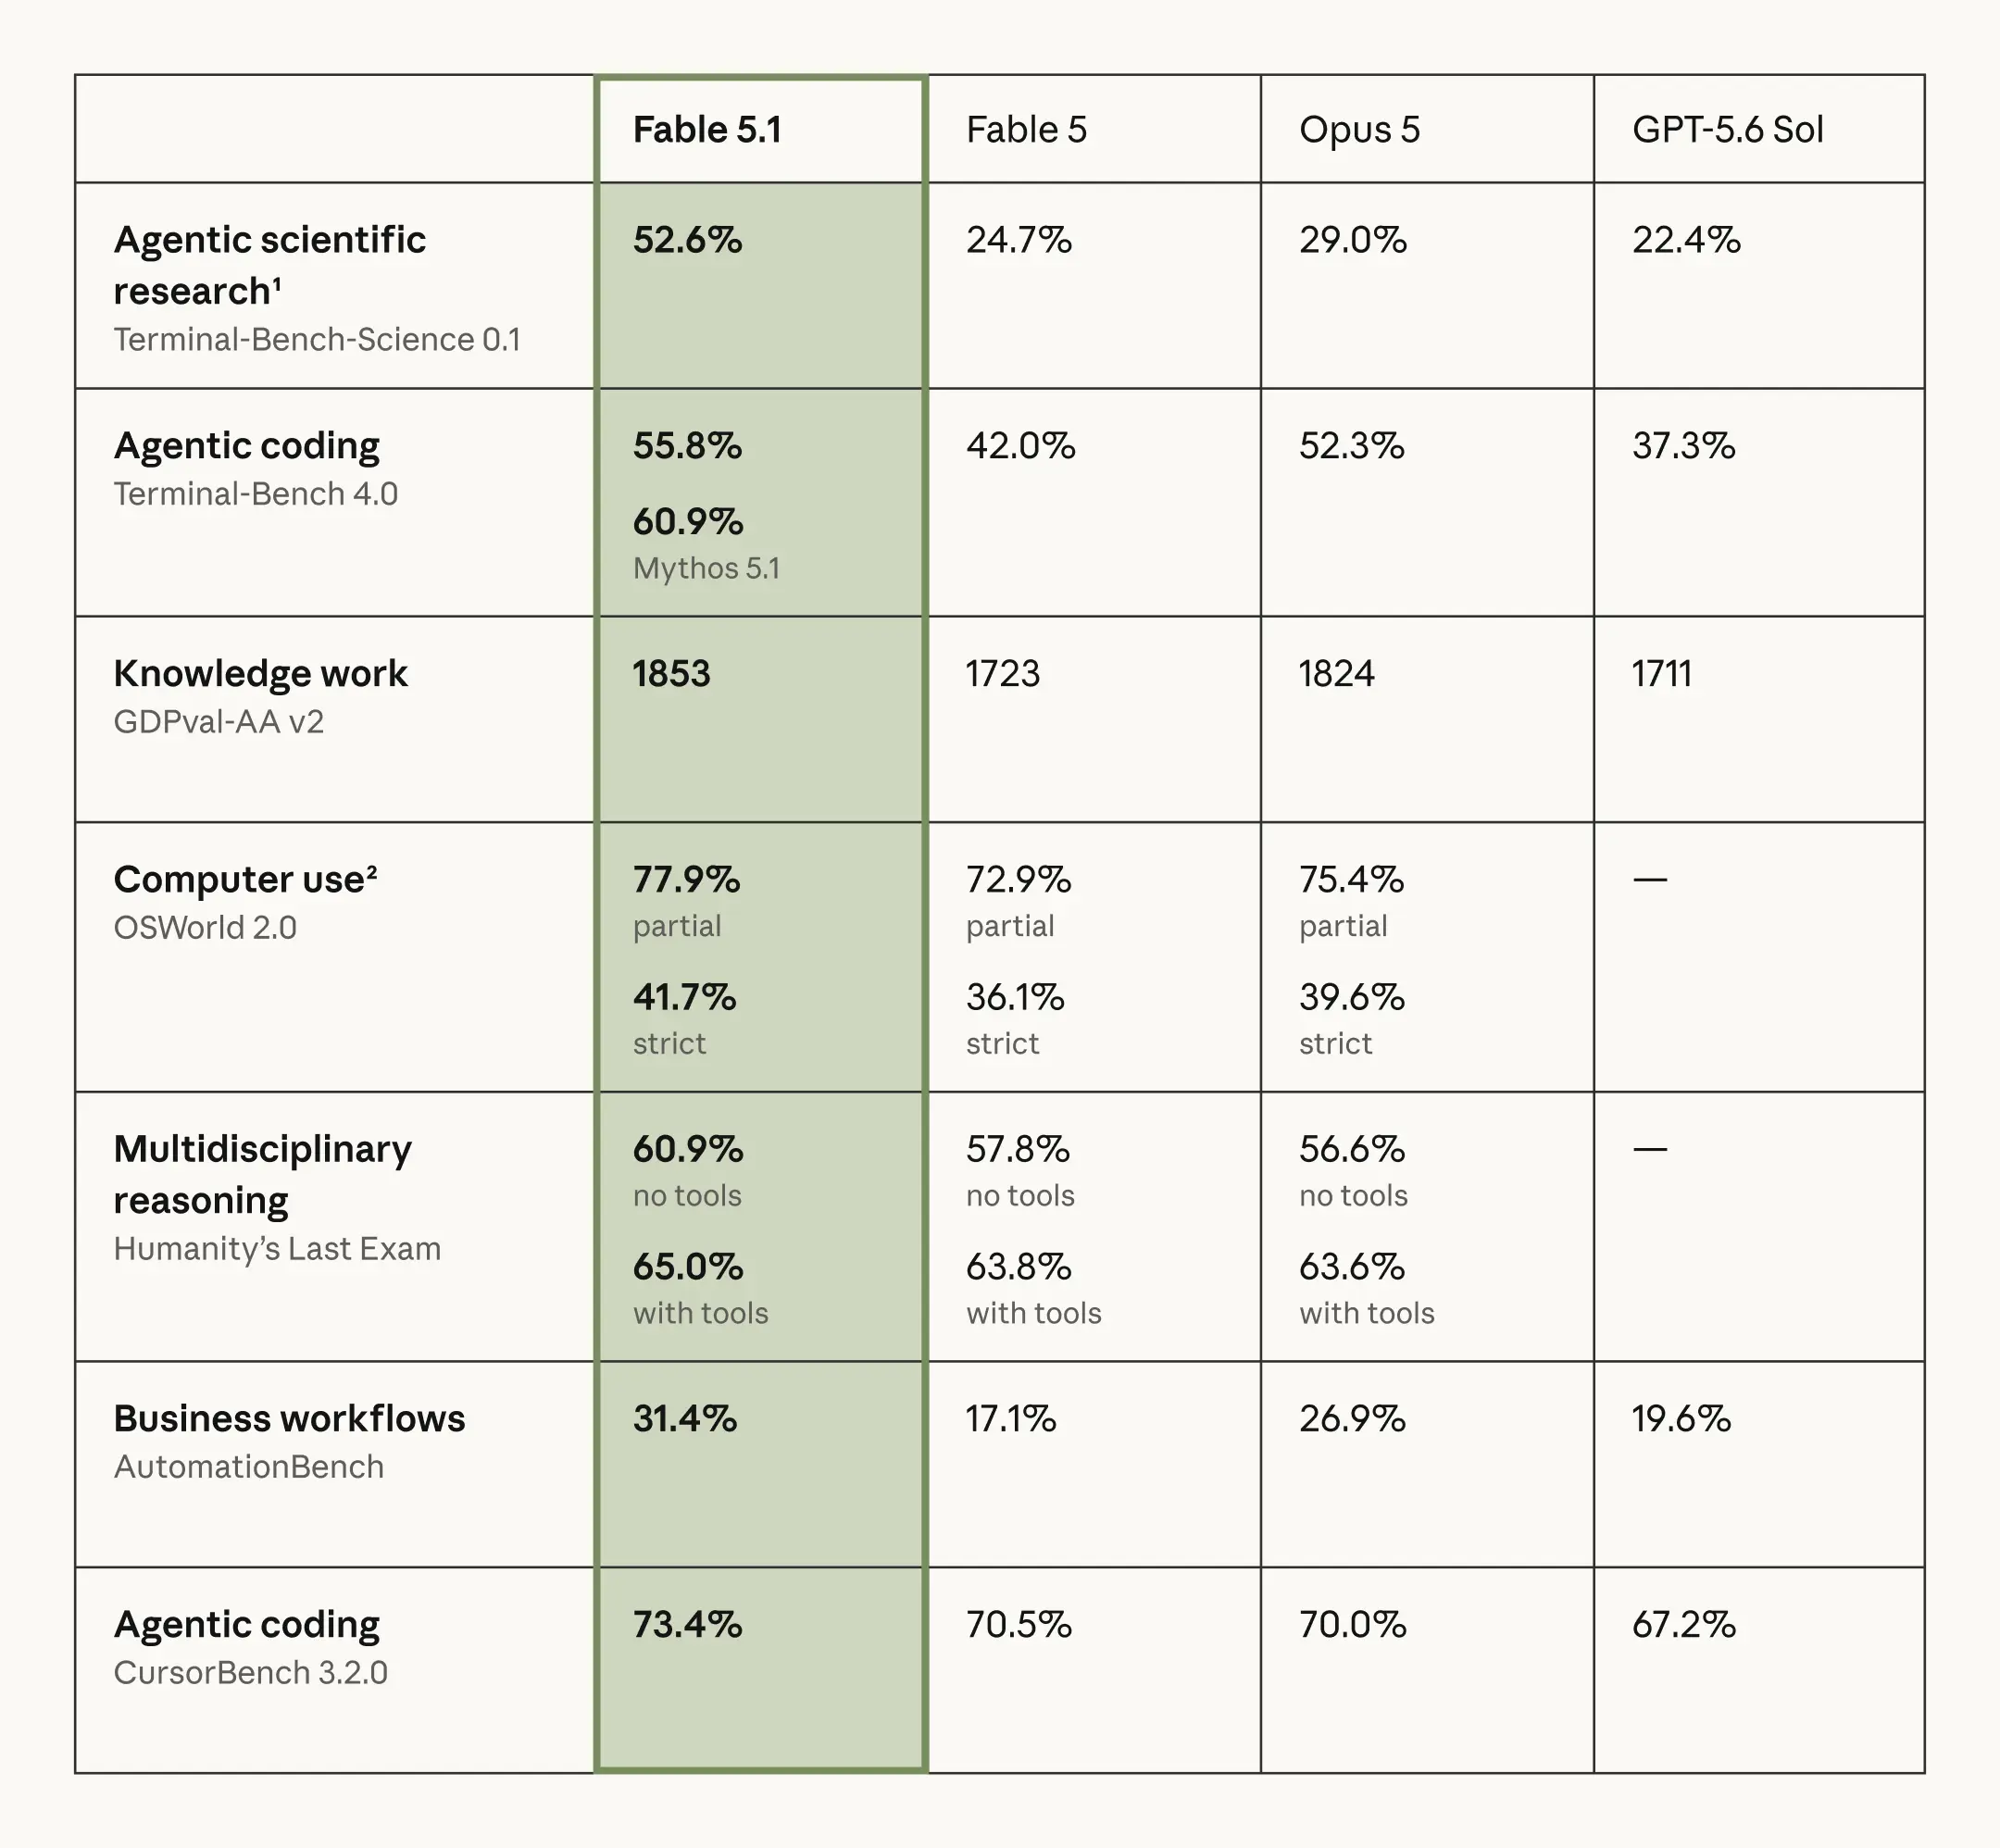
Источник: Anthropic — оригинальная графика бенчмарков.
Это оценки, выполненные вендором: Anthropic тестировал и свою модель, и модель конкурента. Они дают прямое сравнительное свидетельство, но не являются независимыми тестами. Anthropic сообщает стандартную ошибку ±3.5–4.5 п.п. на модель для Terminal-Bench-Science; таблица выше показывает точечные оценки, а не доверительные интервалы.
Результаты вендора благоприятствуют Fable 5.1, но независимые данные нужно рассматривать с учетом дат и конфигураций.
Независимые бенчмарки: отделяйте датированные результаты от живых замеров
Artificial Analysis представил Intelligence Index v4.3 7 сентября, заменив Terminal-Bench 2.1 на Terminal-Bench 4.0 и добавив AutomationBench-AA. В релизе указаны 53 для Fable 5.1 и 47 для GPT-5.6 Sol, что совпадает с округленными значениями в сравнении от 8 сентября. Таблица отделяет терминальные результаты релиза от более позднего снимка производительности.
| Независимая метрика AA / релиз v4.3 | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Результат |
|---|---|---|---|
| Intelligence Index v4.3 (8 сен) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (релиз 7 сен) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Скорость вывода (8 сен) | 69.8 tok/s | 69.9 tok/s | Практически равны |
| Время до первого токена (8 сен) | 132.10 s | 277.47 s | Sol |
| Нормализ. цена токен-микса AA / MTok | $3.08 | $7.175 | Sol |
Снимок: 8 сентября 2026 года, кроме явно датированной строки Terminal-Bench от 7 сентября. Fable 5.1 использует Adaptive Reasoning, Max Effort, Default Fallback; Sol — max. Живые замеры могут меняться. Нормализованная цена токен-микса AA использует соотношение кэш-хит/ввод/вывод 7:2:1; это не стоимость каждого API-запроса.
OSWorld 2.0 — самое большое зафиксированное преимущество Sol в этом сравнении: 62,6% против 41,7% у Fable 5.1, разница 20,9 п.п. Это уравновешивает более сильные результаты Fable в Intelligence Index и Terminal-Bench.
Данные поддерживают конкретный компромисс: у Fable 5.1 выше Intelligence Index, у Sol ниже время до первого токена и ниже нормализованная цена. Пропускная способность вывода практически одинакова. Эти измерения поддерживают разные выборы для чувствительных к качеству пакетных работ и интерактивных приложений.
Датированное независимое сравнение Terminal-Bench указывает в ту же сторону, что и тест Anthropic: 52,0% против 39,9%, по сравнению с 55,8% против 37,3% у вендора. Эти разрывы нельзя напрямую взаимозаменять, так как настройки оценок различаются.
Что все еще говорят бенчмарки OpenAI о GPT-5.6 Sol
Релизные оценки OpenAI дают дополнительный контекст по возможностям GPT-5.6 Sol. Они предшествуют более новым head-to-head результатам, рассмотренным выше, поэтому их не следует использовать как прямое сравнение с Fable 5.1.
OpenAI сообщает 88,8% по Terminal-Bench 2.1 для GPT-5.6 Sol. Это свидетельство сильных агентных способностей к кодированию в релизной конфигурации; старую версию бенчмарка нельзя сопоставлять численно с баллами Terminal-Bench 4.0.
GPT-5.6 Sol vs Fable 5.1 для кодинга
Для простого генерирования кода обе модели избыточны для многих продакшн-нагрузок. Разделение проявляется, когда кодинг становится агентной разработкой ПО: инспекция большого репозитория, редактирование нескольких файлов, выполнение команд, диагностика сбоев, написание тестов и итерации до прохождения задачи.
Здесь у Claude Fable 5.1 более сильная текущая бенчмарковая база. Он лидирует и в вендорском, и в независимом сравнениях Terminal-Bench 4.0, а также результат Anthropic в CursorBench — 73,4% против 67,2% — тоже в его пользу.
Для практической оценки кодинга включайте изменения по всему репозиторию, тесты, ревью и работу с производительностью. Успешный короткий сниппет — слабый заменитель выполнения задачи, охватывающей несколько файлов и неудачных попыток.
GPT-5.6 Sol остается убедительным, когда окружение исполнения важно не меньше качества модели. Нативная поддержка shell execution, apply-patch, code interpreter, file search, computer use и MCP может сократить объем оркестрационного инфраструктурного кода, который вам пришлось бы строить.
Вердикт по кодингу: выбирайте Fable 5.1, если ваши оценки акцентируют самые сложные автономные репозиторные задачи. Выбирайте GPT-5.6 Sol, если немного более низкая бенчмарковая способность приемлема в обмен на более низкую стоимость и широкий интегрированный стек исполнения.
Контроли рассуждений и опыт разработчика
Два API по-разному экспонируют «интеллект».
Диапазон none-to-max у Sol позволяет команде тестировать качество и задержку на нескольких настройках. Более низкое усилие может уменьшить работу рассуждения, но правильная настройка зависит от стоимости ошибки задачи.
Постоянно задействованное адаптивное мышление у Fable делает тюнинг усилий другой задачей. Сравнивайте те настройки, которые ваше приложение будет реально деплоить, вместо того чтобы считать идентичные метки effort идентичными бюджетами вычислений.
Соответственно, нет универсально честного сравнения между «дефолтным Sol» и «дефолтным Fable». Их дефолтные конфигурации рассуждений различаются. В продакшн-оценках либо сопоставляйте эквивалентные бюджеты усилий, либо сравнивайте ровно те настройки, которые вы будете использовать.
GPT-5.6 Sol vs Fable 5.1: что лучше для AI-агентов?
Выбор зависит от того, где бутылочное горлышко — в сложном рассуждении или в окружающем рантайме.
Преимущество Fable в упомянутых терминальных, автоматизационных и профессиональных бенчмарках делает его разумным кандидатом для самых сложных задач. Измеряйте долю завершений и восстановление после ошибок, прежде чем обобщать это преимущество на ваш агент.
Документированный портфель инструментов Responses у GPT-5.6 Sol делает его привлекательным для приложений, построенных вокруг поиска, файлов, исполнения shell и патчей. Это интеграционное преимущество, которое следует оценивать наряду с точностью задач, а не вместо нее.
| Требование агента | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Сложное долгогоризонтное рассуждение | Отлично | Лучшее соответствие |
| Автономия в терминале/репозитории | Отлично | Более сильные свидетельства |
| Нативный интегрированный набор инструментов | Сильнее | Сильный |
| Принудительный выбор инструмента | Поддерживается; проверяйте API | Ограничен; проверяйте tool_choice |
| Интеграция в мультиагентную платформу | Сильное преимущество | Доступно через архитектуру агента |
| Коммуникация прогресса при длинных задачах | Хорошо | Ключевое поведение |
| Дешевые высокообъемные агенты | Лучше | Премиум |
| Повторяющийся массивный кэшированный контекст | Хорошо | Потенциально очень привлекательно |
Использование обеих моделей может быть экономичным, если лишь малая доля задач требует эскалации. Измеряйте, перекрывают ли дополнительные успешные завершения более высокую цену и задержку старта второй модели.
Длинный контекст: 1.05M против 1M — это не важное различие
Заголовочные цифры выглядят почти идентичными: GPT-5.6 Sol предлагает 1,05 млн токенов, а Fable — 1 млн. Разница в 5% вряд ли решит, сможете ли вы анализировать большой репозиторий, юридический корпус, исследовательский архив или многочасовую историю агента. Обе модели уже в миллионном классе.
Для GPT-5.6 Sol ввод выше 272K включает повышенные тарифы длинного контекста для запроса: $8/MTok за ввод, $0.80/MTok за кэшированный ввод и $30/MTok за вывод. Запись кэша также растет с $5 до $10/MTok.
Fable 5.1 сохраняет свои базовые тарифы на 1M-контекст: $10/MTok за ввод, $50/MTok за вывод и $0.25/MTok за чтение кэша. В этой документированной конфигурации нет отдельной надбавки выше 272K.
Рассмотрим ход с 100K некэшированных входных токенов, 900K токенов чтения из кэша и 20K суммарных тарифицируемых выходных токенов. GPT-5.6 Sol стоит 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. Fable 5.1 стоит 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
Этот кэш-ориентированный ход почти закрывает разрыв в цене, потому что у Fable дешевле чтение кэша. Результат зависит от токен-микса рабочего процесса; это не означает, что обе модели стоят одинаково за всю сессию агента.
Предпосылки по стоимости: 900K-префикс уже закэширован, а 100K свежего ввода не тарифицируется как новая запись кэша. Оценка исключает исходную запись кэша и плату за инструменты. 20K допуска вывода включает все тарифицируемые выходные токены, включая любые тарифицируемые токены рассуждения.
Ценообразование: Sol выигрывает в обычных нагрузках, Fable выигрывает одну важную метрику кэша
По проверенным ставкам Sol стоит $4 за ввод / $20 за вывод за MTok, при $0.40 за чтение кэша. Fable 5.1 стоит $10 за ввод, $50 за вывод и $0.25 за чтение кэша. Таблица отделяет цены провайдеров от ставок GPT-5.6 Sol API в CometAPI и Claude Fable 5.1 API в CometAPI.
| Компонент цены | GPT-5.6 Sol Официальные цены | Claude Fable 5.1 Официальные цены |
|---|---|---|
| Официальный ввод / MTok | $4.00 | $10.00 |
| Официальный вывод / MTok | $20.00 | $50.00 |
| Официальное чтение кэша / MTok | $0.40 | $0.25 |
| Официальная запись кэша / MTok | $5.00 (30 минут) | $12.50 (5 минут) |
| Выше 272K ввода: ввод / чтение кэша / запись кэша / вывод | $8 / $0.80 / $10 / $30 | Те же документированные базовые |
| CometAPI ввод / MTok | $3.20 | $8.00 |
| CometAPI вывод / MTok | $16.00 | $40.00 |
Время удержания записи кэша различается: Sol использует дефолтный период удержания 30 минут, тогда как ставка Fable 5.1 указана для записи на 5 минут. Проверьте создание, обновление и срок действия кэша у провайдера и маршрута, который вы используете.
По проверенным прямым ценам провайдеров Fable 5.1 стоит в 2,5 раза больше, чем Sol, и для некэшированного ввода ($10 против $4/MTok), и для вывода ($50 против $20/MTok). Рассматривайте эти ставки как датированное сравнение, поскольку акции провайдеров и цены на шлюзах могут меняться.
Запрос с коротким контекстом и 100K ввода и 10K суммарного тарифицируемого вывода стоит около $0.60 с Sol или $1.50 с Fable по прямым ставкам провайдеров. По приведенным ставкам CometAPI тот же микс стоит $0.48 или $1.20. Эти примеры исключают записи кэша и плату за инструменты.
Ставка чтения кэша Fable для короткого контекста на 37,5% ниже: ($0.40 − $0.25) ÷ $0.40. Это может быть важно для агентов, повторно использующих большой стабильный префикс, но итоговая экономия все равно зависит от свежего ввода, частоты записей и объема вывода.
Вердикт по ценам: Sol — более дешевый старт для трафика со свежим контекстом. Fable становится более конкурентоспособным по мере роста доли чтения из кэша; оценивайте полную стоимость сессии, включая создание и обновление кэша.
Скорость и латентность
Тесты при максимальном усилии могут тратить существенное время на рассуждения до первого видимого токена.
Измерения пропускной способности и латентности от 8 сентября показывают 69,9 токенов/с для Fable и 69,8 для Sol. Время до первого токена — 277,47 секунды против 132,10 секунды. Пропускная способность вывода практически равна; в этой конфигурации Sol начинает выдавать видимый вывод быстрее.
Это измерения при максимальном усилии, а не обещанная латентность для каждого API-вызова. Длина промпта, конфигурация рассуждений, нагрузка провайдера, инструменты и состояние кэша могут менять результат. Время до первого токена и время до полного ответа — разные метрики.
Для интерактивной работы более низкая наблюдаемая задержка старта может склонить выбор в пользу Sol. Для асинхронных исследований или ночной работы с репозиториями успешное завершение может быть важнее, чем ожидание первого токена. Бенчмаркуйте обе модели в тех настройках и с той конкуррентностью, которые вы планируете.
Меры защиты — это производственное различие
Обе модели применяют более сильные меры защиты, поскольку их возможности распространяются на чувствительные области кибербезопасности и науки, но реализуют их по-разному.
OpenAI описывает многоуровневые защиты и мониторинг для семейства GPT-5.6. Приложения в чувствительных доменах должны оценивать соответствующие меры безопасности как часть поведения деплоймента.
Маршрутизация и условия удержания данных от Anthropic описывают перенаправление некоторых чувствительных запросов по кибербезопасности или биологии на менее способные модели без взимания ставки Fable за такие запросы. Дефолтный период удержания данных — 30 дней, с исключениями для соответствующих корпоративных договоренностей.
Для обычного кодинга и интеллектуальной работы эти различия могут не проявляться. Для продуктов безопасности, регулируемых рабочих процессов или приватно-чувствительных деплойментов они должны быть в чек-листе оценки наряду с качеством и ценой.
Какую модель выбрать?
Общее сравнение сводится к форме рабочей нагрузки.
| Нагрузка | GPT-5.6 Sol | Claude Fable 5.1 | Рекомендация |
|---|---|---|---|
| Сложный автономный кодинг | Отлично | Более сильные текущие бенчмарки | Fable 5.1 |
| Долгий горизонт исследований | Отлично | Ключевая сила | Fable 5.1 |
| Высокообъемный frontier API | Гораздо дешевле | Дорого | Sol |
| Интерактивный помощник кодинга | Ниже измеренный TTFT при max | Выше измеренный TTFT при max | Тестировать настройки |
| Агент с тяжелыми инструментами | Более широкий нативный стек | Сильный | Sol |
| Агент с миллионным кэшем | Конкурентоспособен | Очень низкая цена чтения кэша | Тестировать обе |
| Максимальное качество рассуждений | Отлично | Независимое лидерство | Fable 5.1 |
| Стоимость обычного запроса | Явное преимущество | Премиум | Sol |
| Рассуждение по изображениям/документам | Сильное | Сильное | Тест на вашей задаче |
| Стек Single-provider OpenAI | Естественный выбор | Требует миграции/шлюза | Sol |
| Маршрутизация независимая от модели | Сильная | Сильная | Использовать обе через CometAPI |
Политика маршрутизации должна оправдывать свою сложность. Сравните базовый вариант с одной моделью с политикой «сначала Sol», которая эскалирует сложные задачи на Fable 5.1, и сохраняйте маршрутизатор только если он улучшает стоимость успешной задачи при требуемом качестве.
Как сравнить GPT-5.6 Sol и Fable 5.1 через CometAPI
CometAPI уже интегрирует GPT-5.6 Sol и Claude Fable 5.1. Доступайтесь к обеим моделям с их нативными форматами запросов, отправляйте один и тот же набор оценок и сравнивайте результаты при согласованных настройках.
Используйте нативные форматы запросов для каждой модели и фиксируйте промпты, датасеты, настройки усилий, конкуррентность и правила скоринга. Повторяйте прогоны; один последовательный запрос на модель недостаточен для надежной оценки латентности или качества.
Для продакшн-оценки используйте фиксированный набор промптов, повторяйте прогоны в чередующемся порядке, записывайте настройку усилий и оценивайте корректность, долю пройденных тестов, успех инструментов, ретраи, использование токенов, прошедшее время и общую стоимость успешной задачи. Тюньте каждую модель отдельно после общего базиса.
Итоговый вердикт: GPT-5.6 Sol или Claude Fable 5.1?
Fable 5.1 имеет более сильные прямые доказательства для самых сложных автономных задач кодинга и задач с длинным горизонтом. Он лидирует в пяти общих строках вендорских бенчмарков и в датированном независимом терминальном сравнении. Это делает его сильным кандидатом для эскалации — при условии валидации на ваших задачах.
Sol имеет более низкие обычные цены на токены, более тонкие контроли рассуждений и широкий нативный стек инструментов. В проверенной независимой конфигурации при максимальном усилии у него также меньше время до первого токена; пропускная способность вывода практически равна.
Отдавайте приоритет Fable 5.1, когда самый сложный автономный пул задач определяет вашу долю успеха. Начинайте с Sol для чувствительных к стоимости задач на переднем крае или приложений с тяжелой инструментальной интеграцией. Для интерактивных нагрузок тестируйте развернутые настройки усилий, чтобы подтвердить, сохраняется ли наблюдаемое преимущество по задержке старта.
Выбирайте одну модель, если она просто удовлетворяет вашим требованиям. Добавляйте маршрутизацию, когда результаты оценок показывают, что переключение между двумя улучшает качество или стоимость успешной задачи.
FAQ
Является ли Claude Fable 5.1 лучше, чем GPT-5.6 Sol?
В снимке от 8 сентября у него выше независимый Intelligence Index: 53 против 47 у Sol. Он также лидирует в датированном независимом терминальном тесте. Это поддерживает преимущество по качеству на этих оценках, но не утверждение, что он лучше для каждой нагрузки.
Дешевле ли GPT-5.6 Sol, чем Claude Fable 5.1?
Для обычного некэшированного API-трафика — да: проверенные прямые ставки провайдера составляют $4/$20 за MTok для Sol и $10/$50 для Fable 5.1. Нагрузки с доминирующим кэшем могут сузить этот разрыв, поскольку у Fable ниже ставка чтения кэша. Включайте поведение записи и истечения кэша в оценку.
Какая модель лучше для кодинга?
Fable 5.1 имеет более сильные бенчмарковые доказательства для автономного кодинга в этом сравнении. Sol остается привлекательным для более дешевых рабочих процессов и за счет интегрированных инструментов исполнения. Используйте задачи с репозиторием и запускаемыми тестами, чтобы решить, важен ли измеренный разрыв возможностей для вашего приложения.
У какой модели больше окно контекста?
Технически Sol лидирует — 1,05M против 1M токенов у Fable 5.1, при этом обе допускают до 128K вывода. На практике порог тарификации Sol >272K и дешевые чтения кэша у Fable обычно важнее, чем разница в 50K емкости.
Могу ли я получить доступ к обеим моделям через CometAPI?
Да. GPT-5.6 Sol API в CometAPI и Claude Fable 5.1 API в CometAPI обеспечивают общий старт для текстовых оценок. Проверьте специфичные для маршрута рассуждения, кэширование и поддержку инструментов, прежде чем расширять базис до продакшн-агента.