Создавайте с CometAPIНужен один API для нескольких моделей?Протестируйте рабочий процесс в Playground, затем создайте API-ключ, когда модель и стоимость подойдут для вашего сценария.
Как запустить MiniMax M3.1 Flash локально: руководство по GPU, vLLM и SGLang
Узнайте, как запустить MiniMax M3.1 Flash локально. Изучите его архитектуру MoE 428B/23B, требования к GPU, настройку vLLM и SGLang, бенчмарки, альтернативы API.
Deon GoodwinКоманда исследователей AI-моделей и API
MiniMax M3.1 Flash приносит открытые веса ИИ в требовательные сценарии кодирования и агентные рабочие процессы, но локальный запуск требует серьёзного оборудования. Его архитектура MoE с 428B параметров активирует лишь 23B параметров на токен, снижая вычисления, но не устраняя необходимость хранить всю модель. Разработчики с поддерживаемыми мульти-GPU системами могут развернуть её через vLLM или SGLang. Для тех, кто хочет избежать управления инфраструктурой, MiniMax M3.1 Flash API в CometAPI предлагает более простой старт.
Основные выводы
Самое большое препятствие — оборудование. Опубликованные конфигурации vLLM используют четыре поддерживаемых GPU Blackwell или AMD MI355X, либо восемь H100/H200.
Проверено на ясность, указание источников и актуальную терминологию API.
Длинный контекст стоит памяти. Модель поддерживает до миллиона токенов, но практические пределы зависят от доступной памяти GPU и конкурентности.
Развёртывание зависит от «железа». Используйте совместимый движок инференса, формат квантования и конфигурацию ускорителя, а не универсальную команду установки.
Бенчмарки — только отправная точка. Оцените точность кодирования, выполнение агентных задач, задержку и пропускную способность на ваших нагрузках.
Локальный и облачный инференс решают разные задачи. Самостоятельный хостинг даёт больший контроль над инфраструктурой, тогда как доступ через API уменьшает сложность настройки и накладные расходы на сопровождение.
Что такое MiniMax M3.1 Flash?
MiniMax M3.1 Flash принимает текст, изображения и видео и генерирует текст. Она предназначена для рабочих процессов по кодированию, автоматизации, взаимодействию с компьютером и обеспечению безопасности. Веса распространяются по лицензии MiniMax Community License. Перед коммерческим использованием ознакомьтесь с лицензией, поставляемой с чекпоинтом и условиями, применимыми к вашему кейсу.
Характеристики MiniMax M3.1 Flash
Характеристика
MiniMax M3.1 Flash
Разработчик
MiniMax
Семейство моделей
Нативная мультимодальная MoE
Всего параметров
Примерно 428B
Активных параметров
Примерно 23B на токен
Максимальный контекст
1,048,576 токенов (возможность модели)
Типы ввода
Текст, изображения и видео (зависит от маршрута)
Вывод
Текст
Внимание
MiniMax Sparse Attention в каждом слое
Квантование
MXFP8 для плотных слоёв / NVFP4 для экспертов
Черновое декодирование
Интегрированный draft‑head DSpark
Усилие рассуждения
low, medium, high, xhigh, max
Заявленная скорость вывода
200+ токенов/с в благоприятных условиях; P50 170+ ток/с
Лицензия
MiniMax Community License
Документированный инференс
vLLM, SGLang
Типичная топология
4 поддерживаемых GPU Blackwell или MI355X; 8 GPU H100/H200
Как MiniMax M3.1 Flash использует архитектуру 428B/23B?
Модель Mixture‑of‑Experts (MoE) маршрутизирует каждый токен через выбранных экспертов. В MiniMax M3.1 Flash примерно 23B параметров активны на токен, тогда как общий пул параметров — около 428B. Разреженная активация снижает вычисления; это не превращает чекпоинт в плотную модель на 23B.
Что изменилось в MiniMax M3.1 Flash?
Разреженное внимание: применяется по всей модели для уменьшения работы внимания на длинных вводах; выгода зависит от ядер сервинга и промпта.
Смешанная точность весов: плотные компоненты MXFP8 и эксперты NVFP4 снижают требования к хранению и вычислениям, но всё равно требуют совместимого «железа» и ядер.
Декодирование DSpark: интегрированный draft‑head может ускорить генерацию в поддерживаемых рецептах; результаты зависят от принятия токенов и нагрузки.
Энерго‑осведомлённый сервинг: планирование на уровне инфраструктуры может повысить утилизацию, но это не функция, которую вы получите автоматически, просто скачав веса.
Какое оборудование нужно для MiniMax M3.1 Flash?
Планируйте память GPU по четырём частям: веса чекпоинта, KV‑кэш для прошлых токенов, буферы времени выполнения и запас под нагрузку. Оценки ниже относятся только к сырым параметрам хранения. Смешанная точность, масштабы квантования, мультимодальные компоненты и накладные расходы сервинга меняют реальную потребность.
Подтверждённые топологии GPU
Ускорители
Опубликованная топология
Примечания
NVIDIA GB200/GB300/B200/B300
4 GPU, тензорный параллелизм
Родной путь NVFP4 для Blackwell
NVIDIA H100/H200
8 GPU, тензорный параллелизм
FP8‑кэши и путь Marlin MoE
AMD MI355X
4 GPU, тензорный параллелизм
Требуются поддерживаемые ROCm и настройки AITER
Потребительские GPU 24–32 ГБ
Нет рецепта для полного чекпоинта
Недостаточно для простого одногпу‑запуска
Рабочая станция только CPU
Нет валидированного практического развёртывания
Эксперименты с оффлоудингом не являются прод. руководством
Оценка памяти: Сырое хранение для 428B параметров — примерно 856 ГБ при BF16, 428 ГБ при 8‑бит, или 214 ГБ при идеализированных 4‑бит. Официальный чекпоинт смешивает форматы, поэтому эти цифры — не требования к VRAM во время выполнения. Закладывайте масштабы квантования, KV‑кэш, буферы рантайма и конкурентность; используйте реальные файлы чекпоинта и рецепт под ваш GPU для расчёта системы.
Зарезервируйте место на NVMe под чекпоинт, временные загрузки и откатную копию.
Какой способ развёртывания выбрать?
Для поддерживаемого локального кластера vLLM — практичная отправная точка с референс‑конфигурациями и знакомой API‑интеграцией; SGLang подходит командам, исследующим кастомизацию сервинга после проверки совместимости, а CometAPI предлагает облачный путь для прототипирования и переключения моделей.
Требование
Локально: vLLM
Локально: SGLang
CometAPI
Веса и GPU
Скачайте веса; эксплуатируйте поддерживаемые GPU
Скачайте веса; эксплуатируйте поддерживаемые GPU
Инференс управляется провайдером; локальных весов нет
Blackwell / AMD MI355X
Рецепты, зависящие от «железа»
Рецепты, зависящие от «железа»
«Железо» управляется провайдером
H100/H200
Документированный рецепт на восьми GPU
Проверьте текущую матрицу поддержки
«Железо» управляется провайдером
Декодирование и параллелизм
DSpark на поддерживаемых путях; тензорный и распределённый сервинг
Декодирование под «железо»; тензорный и expert‑параллелизм
Выберите фреймворк с валидированным рецептом под ваше оборудование, затем сравните задержку и пропускную способность на одинаковых промптах, точности и конкурентности.
Как запустить MiniMax M3.1 Flash локально с vLLM?
Ниже предполагается Linux‑хост с четырьмя совместимыми NVIDIA Blackwell GPU, поддерживаемым драйвером/CUDA и доступом к официальному чекпоинту. Используйте валидированную сборку vLLM; обычная установка на неподдерживаемом GPU может завершиться неудачей, даже если пакеты установились.
Убедитесь, что установленное колесо и CUDA‑рантайм соответствуют вашему семейству GPU. Если требуется специализированная дев‑сборка, следуйте референс‑инструкции установки до использования аргументов запуска.
При необходимости используйте соответствующий токен Hugging Face, сохраняйте структуру каталогов и проверьте полную загрузку шардов перед запуском сервера.
Дождитесь полной загрузки и сообщения о готовности сервера, прежде чем отправлять запрос. Команда выше ограничивает контекст 32 768 токенами и конкурентность четырьмя последовательностями для первичного smoke‑теста. Эти сниженные лимиты не являются настройками для бенчмарков; корректируйте их после измерения использования памяти и поведения запросов на вашем «железе».
Если идентификатор сервируемой модели отличается от имени каталога, вызовите /v1/models и используйте возвращённый ID без изменений. Успешный текстовый ответ подтверждает лишь базовый инференс; проверьте отдельно vision, вызовы инструментов, конкурентность и длинный контекст.
Шаг 5: Интеграция с OpenAI‑совместимым Python‑клиентом
В примере используется 127.0.0.1 для локального тестирования. Перед подключением удалённых клиентов поставьте средства контроля доступа перед эндпоинтом и настройте таймауты клиента, ограниченные ретраи и мониторинг.
Вариант H100/H200: используйте восьми‑GPU рецепт для Hopper
На восьми H100/H200 используйте специфичные для Hopper FP8‑кэш и путь Marlin MoE, а не конфигурацию NVFP4 для Blackwell. Команда ниже следует официальному рецепту vLLM для Hopper с контекстом и конкурентностью, уменьшенными до 32K и четырёх последовательностей для первичного теста. Она отключает видеоввод в соответствии с этим рецептом. Держите эндпоинт за существующими средствами контроля доступа.
SGLang предлагает аппаратно‑специфичные рецепты развёртывания M3.1 и OpenAI‑совместимый сервинг. На срезе от 23 октября документация включает выделенные образы dev‑контейнеров, поэтому не следует считать, что обычная установка SGLang содержит всю поддержку, специфичную для модели.
Загрузка выделенного образа контейнера
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
Далее следуйте поваренной книге SGLang для MiniMax M3.1 под ваш ускоритель. Загрузка образа скачивает только рантайм; вам всё ещё нужно запустить контейнер с доступом к GPU и стартовать соответствующую конфигурацию сервинга внутри него. Используйте полный аппаратно‑специфичный запуск из поваренной книги, дождитесь готовности, затем запросите список моделей у эндпоинта перед тестовым запросом. Документированные пути NVIDIA и AMD используют разные зависимости и должны настраиваться раздельно.
Как MiniMax M3.1 Flash смотрится на бенчмарках?
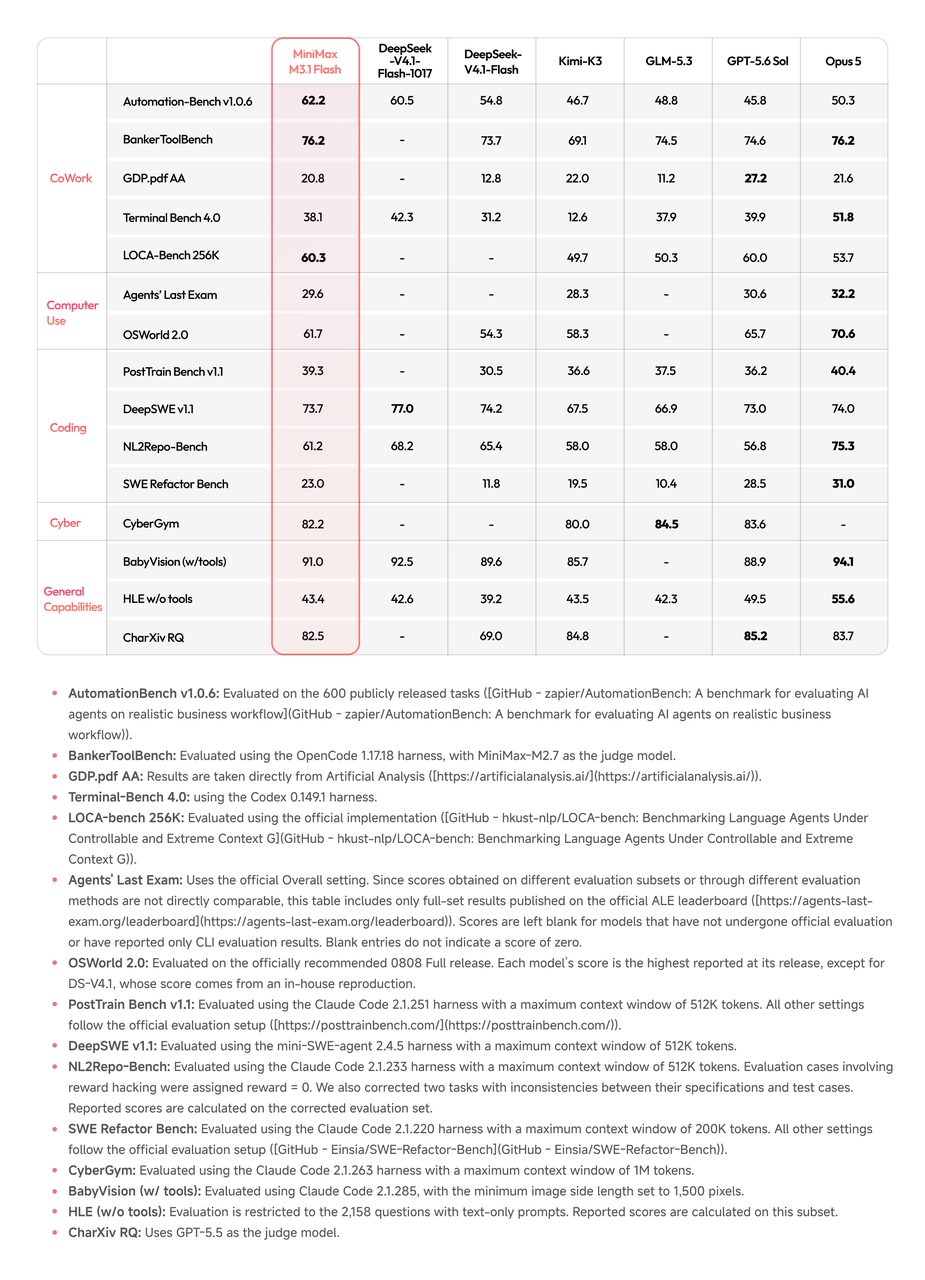
Когда ваш эндпоинт проходит базовые проверки, используйте опубликованные бенчмарки, чтобы решить, какие нагрузки тестировать далее. Приведённые цифры — это оценки, опубликованные вендором, а не измерения вашего локального развёртывания.
Бенчмарк
M3.1 Flash
DeepSeek V4.1 Flash 1017
Kimi K3
Automation-Bench v1.0.6
62.8
60.5
46.7
DeepSWE v1.1
73.7
77.0
67.5
Terminal Bench 4.0
38.1
42.3
12.6
OSWorld 2.0
61.7
N/A
58.3
NL2Repo-Bench
61.2
68.2
58.0
BabyVision with tools
91.0
92.5
85.7
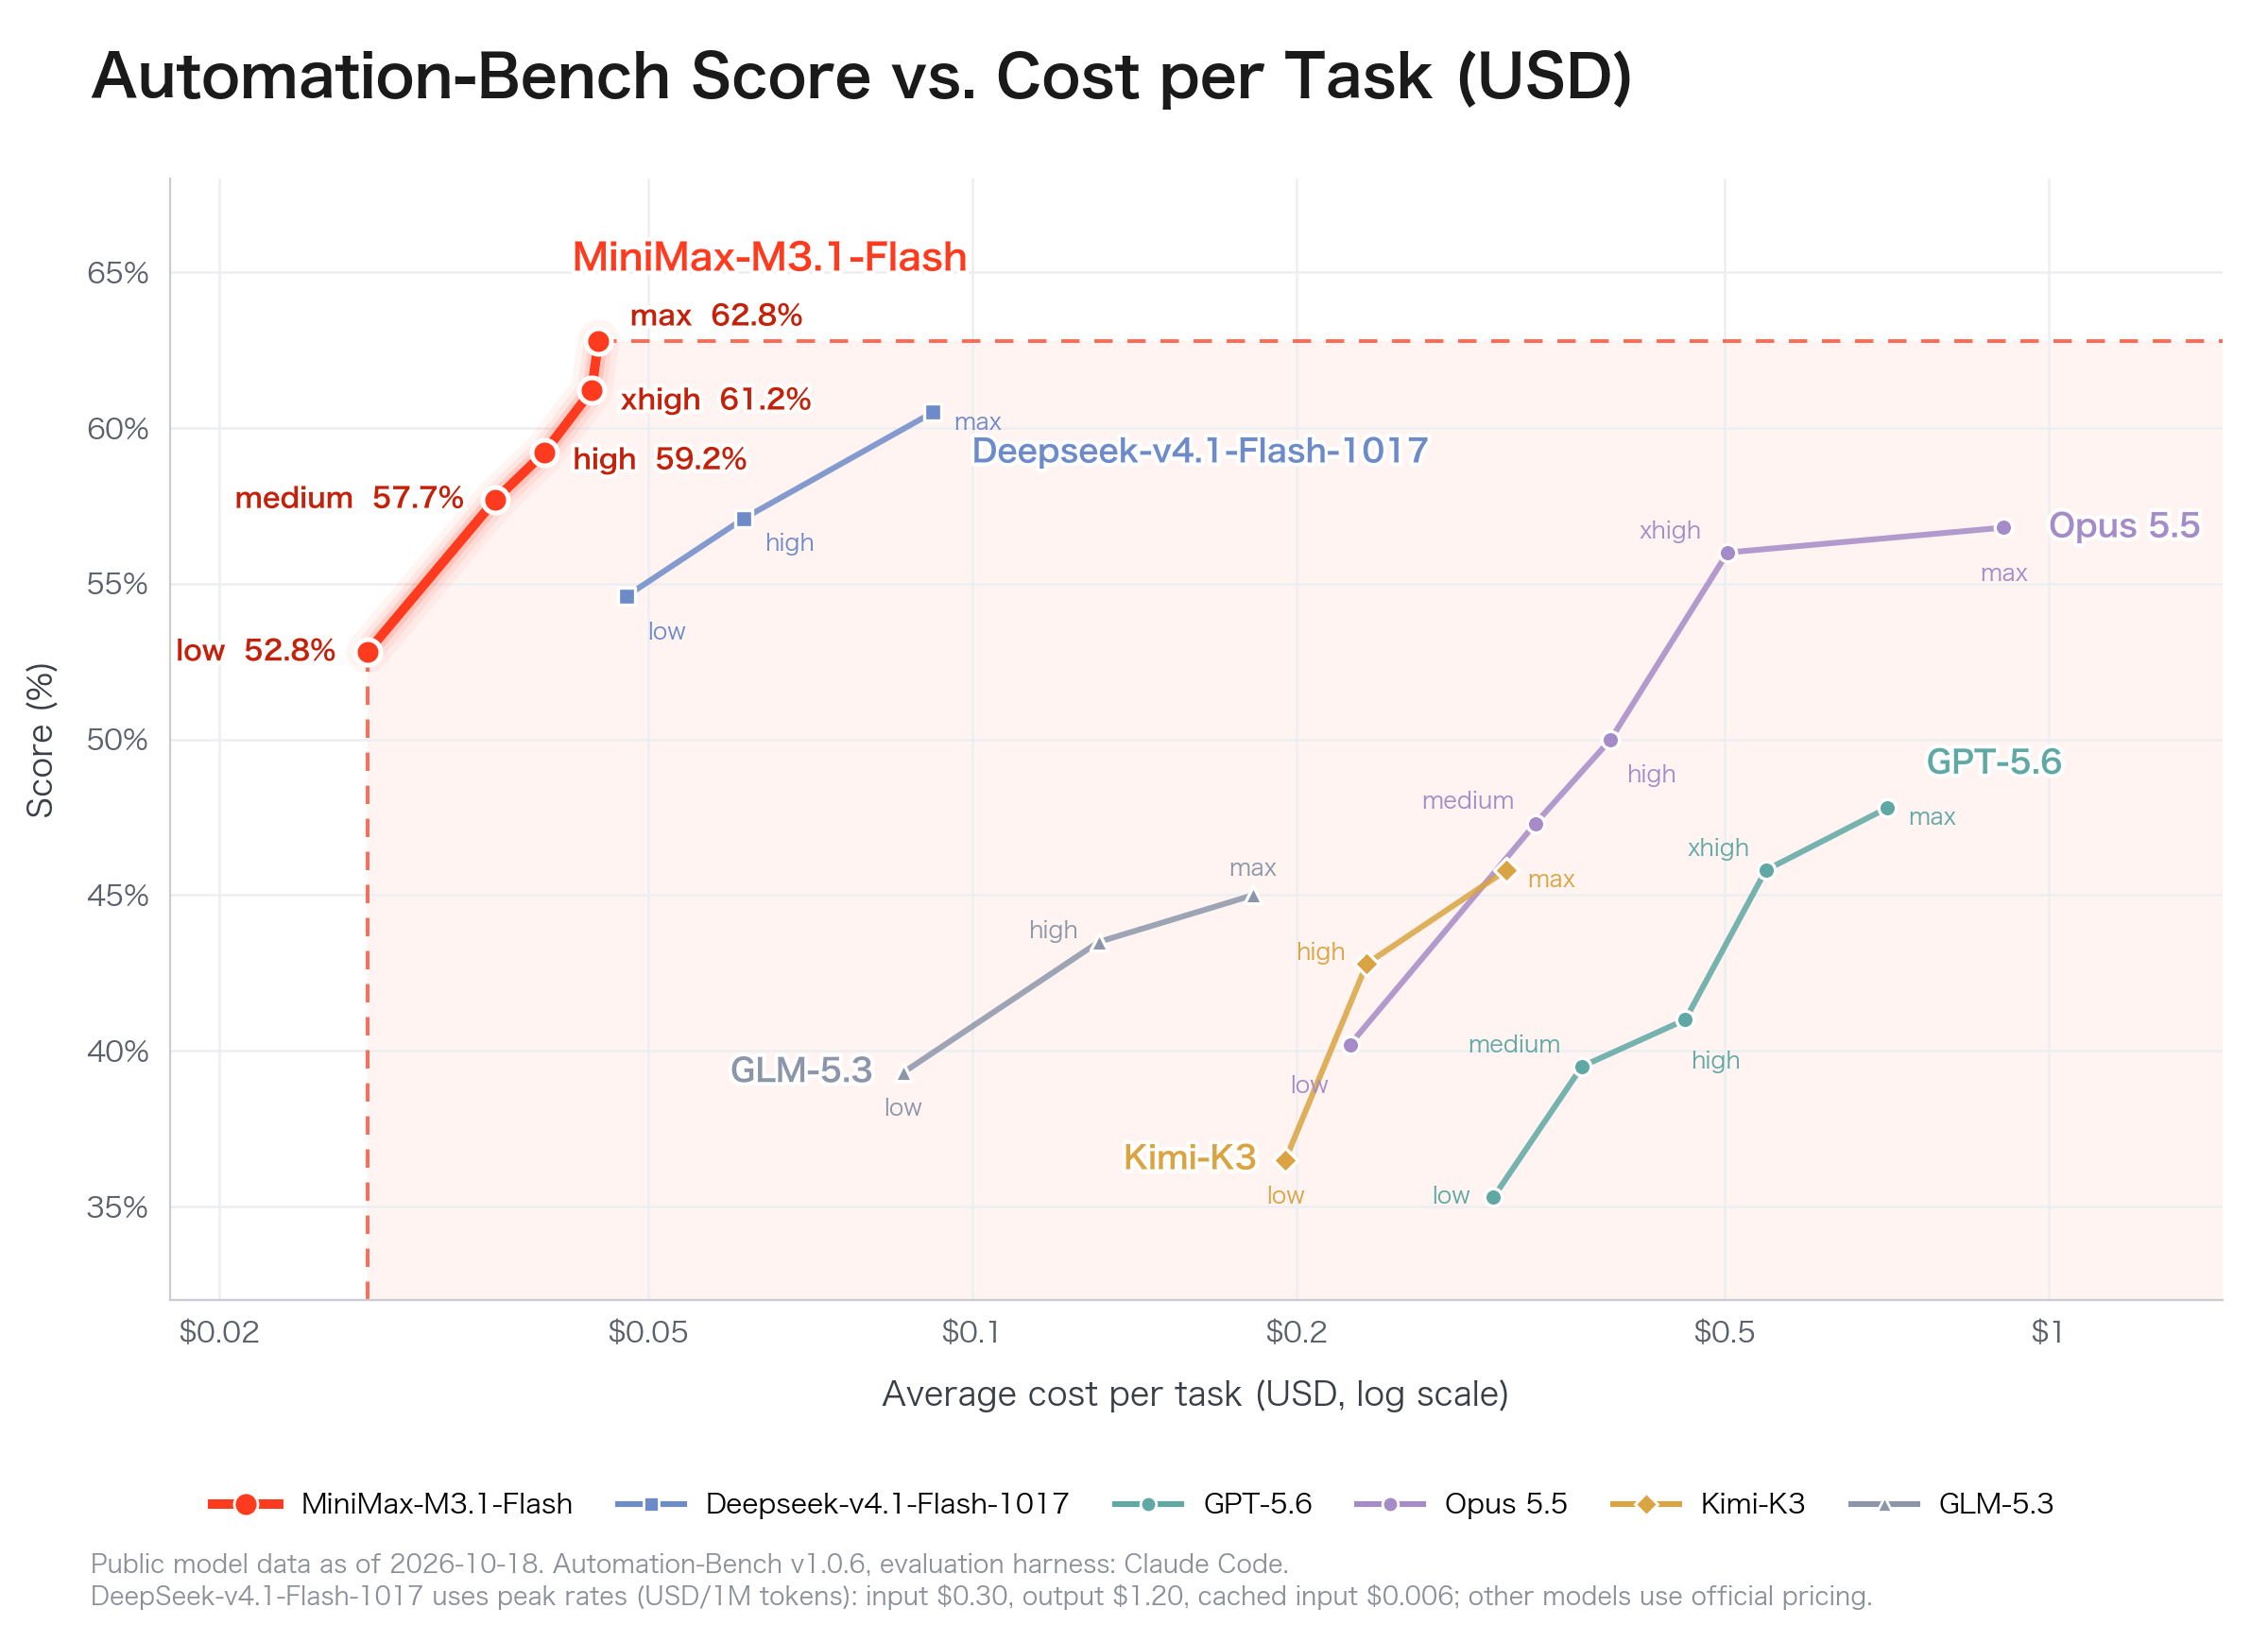
В этом сравнении MiniMax лидирует по Automation‑Bench среди перечисленных моделей, тогда как DeepSeek лидирует в ряде бенчмарков по кодированию. Прочтите карту модели и настройки оценки прежде чем делать выводы, и тестируйте промпты и инструменты, которые реально использует ваше приложение. Баллы из разных версий или конфигураций бенчмарков несопоставимы напрямую.
Как оптимизировать производительность MiniMax M3.1 Flash?
Контролируйте контекст и конкурентность
После первого успешного запроса повышайте по одному переменную нагрузки: длину ввода, длину вывода или число параллельных запросов. Записывайте пик памяти и задержку ответа для каждого прогона. Держите последние стабильные настройки как точку отката, чтобы неудачный эксперимент не стал новой базой.
Выбирайте усилие рассуждения осознанно
M3.1 Flash поддерживает low, medium, high, xhigh и max. Более высокие настройки могут улучшить результаты на сложных задачах, но часто требуют больше токенов рассуждения и большей задержки. Оценивайте качество выполнения задач и затраты вычислений вместе.
Для локальных запросов vLLM рецепт показывает настройки reasoning‑effort в разделе chat_template_kwargs. При валидации клиента проверяйте и финальный ответ, и при необходимости отдельно возвращаемое поле рассуждений, поскольку облачные и локальные эндпоинты могут экспонировать их по‑разному.
Отслеживайте стоимость за завершённую задачу
Для агентов токенов в секунду недостаточно. Записывайте время до первого токена, скорость вывода, долю принятых токенов при спекулятивном декодировании, сквозную пропускную способность при конкуренции, ошибки вызова инструментов, утилизацию памяти и стоимость завершённой задачи. Более медленный ответ с меньшим числом ошибок инструментов может дать лучшую экономику.
Как использовать MiniMax M3.1 Flash API в CometAPI?
Командам, которым не нужна выделенная инфраструктура ускорителей, подходит OpenAI‑совместимый облачный эндпоинт. Это устраняет загрузку чекпоинта и операции с GPU, но переносит обработку запросов за пределы вашей среды.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Подтвердите идентификатор модели в консоли CometAPI перед запуском примера. Используйте шлюз, когда единственный API у разных провайдеров упрощает интеграцию; сравнивайте его текущие расценки с прямым доступом для ожидаемого объёма.
Цены MiniMax M3.1 Flash API
Цена за миллион токенов
Официальный API MiniMax
CometAPI
Ввод
$0.15
$0.80
Вывод
$0.60
$3.20
Кэшированный ввод
$0.015
Уточните текущий тариф маршрута
Прямые тарифы MiniMax из анонса запуска от 19 октября 2026 года (ссылка): $0.15 за ввод, $0.60 за вывод и $0.015 за кэшированный ввод за миллион токенов. Для CometAPI проверьте активный маршрут модели, ставки ввода/вывода, правила кэширования и возможные скидки аккаунта перед оценкой затрат. Сравните итоговую стоимость для ожидаемого микса токенов и ретраев.
Какие проблемы могут возникнуть при запуске MiniMax M3.1 Flash?
Нехватка памяти при загрузке или выполнении запросов
Если веса не загружаются: проверьте этап сбоя в логах старта, убедитесь в целостности чекпоинта, и что топология GPU и бэкенд квантования соответствуют рецепту. Если веса превышают доступную память, используйте конфигурацию с достаточной ёмкостью; сокращение запроса не исправит сбой загрузки весов.
Если веса загружаются, но выделение кэша падает при старте: проверьте настройки кэша и доступную память, затем уменьшите настроенный контекст или конкурентность в соответствии с рецептом.
Если сервер стартует, но запрос приводит к OOM: повторите с коротким промптом по одному запросу, затем по отдельности увеличивайте длину ввода, длину вывода и конкурентность, наблюдая за памятью.
Несовместимые ядра квантования или внимания
Выполнение NVFP4 отличается между Blackwell, Hopper и AMD. Сопоставляйте версии движка инференса, бэкенды квантования, версии CUDA/ROCm и семейства ускорителей, а не переиспользуйте флаги без разбору.
Конфигурация кэша с разреженным вниманием
Если при старте сообщается о неподдерживаемой раскладке кэша, сравните полную конфигурацию кэша с аппаратным рецептом. Текущий рецепт vLLM требует --block-size 128 для разрежённого/индексного кэша MSA. Если при старте ошибка раскладки кэша или размера блока, сверьте полную конфигурацию с рецептом под ваше «железо».
Неожиданные идентификаторы модели
Локальный путь и имя модели в облачном шлюзе не обязаны совпадать. Запрашивайте локальный ответ /v1/models и избегайте жёстко прошитых предположений из другого эндпоинта.
Низкая наблюдаемая пропускная способность
Разделяйте медленную обработку промпта и медленную генерацию токенов. Сравнивайте прогоны с одинаковой длиной ввода и лимитом вывода, затем проверьте утилизацию GPU и поведение межсоединений до увеличения батча. Показатель скорости у провайдера не является базовым для вашего локального кластера.
Заключение
Выбирайте первый путь развёртывания исходя из доступного вам сегодня «железа». Используйте пошаговый разбор vLLM для поддерживаемого локального кластера, аппаратно‑специфичную поваренную книгу SGLang для альтернативного стека сервинга или облачный API, когда вы хотите сосредоточиться на интеграции приложения. Сохраняйте конфигурацию, которая достигает требуемого качества решения задач и задержки при устойчивой операционной стоимости.
Самый надёжный способ выбрать метод сервинга — оптимизировать за корректно выполненную работу на доллар и минуту, а не только за пик токенов в секунду.
FAQ
Как сделать развёртывание воспроизводимым после обновления рантайма?
Зафиксируйте ревизию чекпоинта, версии образа рантайма или пакетов, стек драйверов и параметры запуска. Перед каждым обновлением гоняйте один и тот же небольшой набор приёмочных тестов и держите предыдущую рабочую конфигурацию для отката.
Как обрабатывать ретраи, когда агент вызывает инструменты?
Отделяйте повтор модели от повтора действия инструмента. Используйте ключи идемпотентности для действий, меняющих данные, проверяйте, прошла ли первая попытка, и валидируйте полные аргументы инструмента перед выполнением.
Могу ли я переключаться между локальным эндпоинтом и CometAPI без изменения поведения приложения?
Держите настраиваемыми эндпоинт, учётные данные и ID модели. Тестируйте стриминг, вызовы инструментов, поля рассуждений и мультимодальные вводы на обоих маршрутах и подтвердите требования к маршрутизации данных перед включением фолбэка.
Что тестировать перед приёмом мультимодальных вводов?
Тестируйте репрезентативные изображения и видео, включая низкое качество и неподдерживаемые файлы. Отдельно проверяйте препроцессинг, ограничения размера, качество ответов и таймауты; успешный текстовый запрос не валидирует мультимодальный путь.
Как понять, что развёртывание готово для реальных пользователей?
Задайте цели по успешности задач, валидным вызовам инструментов, задержке, ошибкам и стоимости. Тестируйте реалистичный трафик, проверьте мониторинг и поведение фолбэка, затем расширяйте с малого только пока эти цели выдерживаются.