
TLDR Kimi K3 — новейшая флагманская модель Moonshot AI, запущенная в июле 2026 года для долгосрочного кодинга, глубокого рассуждения, мультимодального понимания и сквозной работы с знаниями. Moonshot описывает её как открытую модель класса 3T с 2,8 трлн параметров, встроенным зрением и контекстным окном на 1M токенов.
Для разработчиков, которым нужен быстрый доступ без управления отдельными аккаунтами провайдеров, CometAPI указывает Kimi K3 как доступную под идентификатором модели kimi-k3, используя совместимый с OpenAI эндпоинт /v1/chat/completions и базовый URL https://api.cometapi.com/v1. На странице CometAPI для Kimi K3 актуальная цена ввода — $2.40 за 1M токенов, вывода — $12.00 за 1M токенов, по сравнению с официальными ставками Kimi API: $3.00 за невзятые из кэша входные токены и $15.00 за выходные. Поскольку спрос на Kimi K3 уже привёл к временной ограниченной подписке у Moonshot, продакшен-командам стоит использовать CometAPI не только для простого запуска, но и для сравнения моделей, мониторинга использования и резервной маршрутизации.
Ключевые выводы
- В продакшене сохраняйте полные сообщения ассистента в многошаговых сценариях, ограничивайте
max_completion_tokens, отслеживайте использование токенов и стройте резервные маршруты. - Kimi K3 — модель Moonshot AI с 2,8T параметрами (Mixture-of-Experts) и контекстным окном на 1M токенов, со встроенным визуальным пониманием.
- В CometAPI модель Kimi k3 имеет ID
kimi-k3; основной эндпоинт:POSThttps://api.cometapi.com/v1/chat/completions. - K3 всегда рассуждает. Используйте
reasoning_effortсо значениямиlow,highилиmax;max— значение по умолчанию в документации Kimi. - Стриминг настоятельно рекомендуется для длинных задач по кодингу, исследованиям и анализу, поскольку пользователи видят частичный вывод, пока модель ещё работает.
- Ввод для зрения должен использовать мультимодальные массивы
content. Документация Kimi указывает, что публичные URL изображений не поддерживаются для маршрутов зрения Kimi; используйте base64 или загруженные файлы. - Kimi K3 поддерживает структурированный вывод, режим JSON, вызов инструментов,
tool_choice, динамическую загрузку инструментов и кеширование контекста.
CometAPI — практичный способ оценивать Kimi K3 вместе с GPT, Claude, Gemini, DeepSeek, Qwen и другими моделями через единый слой API.
Что такое Kimi K3: флагманская модель Moonshot AI
Moonshot AI выпустила Kimi K3 16 июля 2026 года как свою наиболее мощную модель — разреженную архитектуру Mixture-of-Experts (MoE) с ~2,8 трлн общих параметров (16 из 896 экспертов активны на токен). В ней реализованы Kimi Delta Attention для ускорения декодирования до 6,3x в миллионных контекстах и Attention Residuals для ~25% прироста эффективности обучения.
Ключевые характеристики (по официальным и независимым источникам):
| Возможности | Детали Kimi K3 |
|---|---|
| Идентификатор модели | kimi-k3 |
| Контекстное окно | 1,048,576 токенов (1M) |
| Параметры | 2.8T всего (MoE) |
| Ввод | Текст + встроенное зрение (изображения) |
| Рассуждение | Всегда включено, максимальное усилие при запуске |
| Функции | Вызов инструментов, структурированный/JSON-вывод, стриминг |
| Открытые веса | Обещано до 27 июля 2026 (Modified MIT) |
Она превосходно справляется с долгосрочным кодингом, агентными задачами, визуальным пониманием и работой с знаниями. Независимые бенчмарки оценивают её конкурентоспособно (например, 57.1 на Artificial Analysis Intelligence Index, сильные результаты во фронтенд-кодинге).
Последние новости от Business Insider: Спрос после запуска вырос настолько, что Moonshot временно приостановила новые подписки. Это сигнализирует о рывке Китая в сторону открытых моделей на переднем крае, а Moonshot рассматривает крупное IPO.
Полные веса запланированы на 27 июля 2026
Документация Kimi K3 от Moonshot говорит, что полные веса модели будут опубликованы до 27 июля 2026 года. Пока релиз не завершён и сторонние инструменты деплоя не созреют, большинству команд стоит считать хостед-доступ по API самым быстрым практичным путём. Даже после появления весов, обслуживание модели MoE с 2,8T параметров — не то же самое, что запуск небольшой открытой модели на одной рабочей станции. Технический блог Moonshot рекомендует конфигурации суперуза с 64 и более ускорителями для деплоя K3, так что хостед API останется выбором по умолчанию для многих SaaS-команд, агентств, разработчиков внутренних инструментов и AI-продуктов.
Производительность на бенчмарках: данные, источники и анализ
Kimi K3 показывает передовые результаты, особенно в кодинге и агентных сценариях, оставаясь конкурентной в целом. Независимые лаборатории, такие как Artificial Analysis, подтверждают заявления вендора с некоторыми оговорками (например, по уровню галлюцинаций).
Общий интеллект
- Artificial Analysis Intelligence Index v4.1: 57.1 (4-е место; позади Fable 5 ~60, GPT-5.6 Sol ~59; впереди Claude Opus 4.8 ~55.7).
- GDPval-AA v2 Elo: 1,668 (большой скачок от K2.6 с 1,190; обходит Opus 4.8, отстаёт от Fable 5).

Источник: reddit
Бенчмарки по кодингу (вендор + независимые)
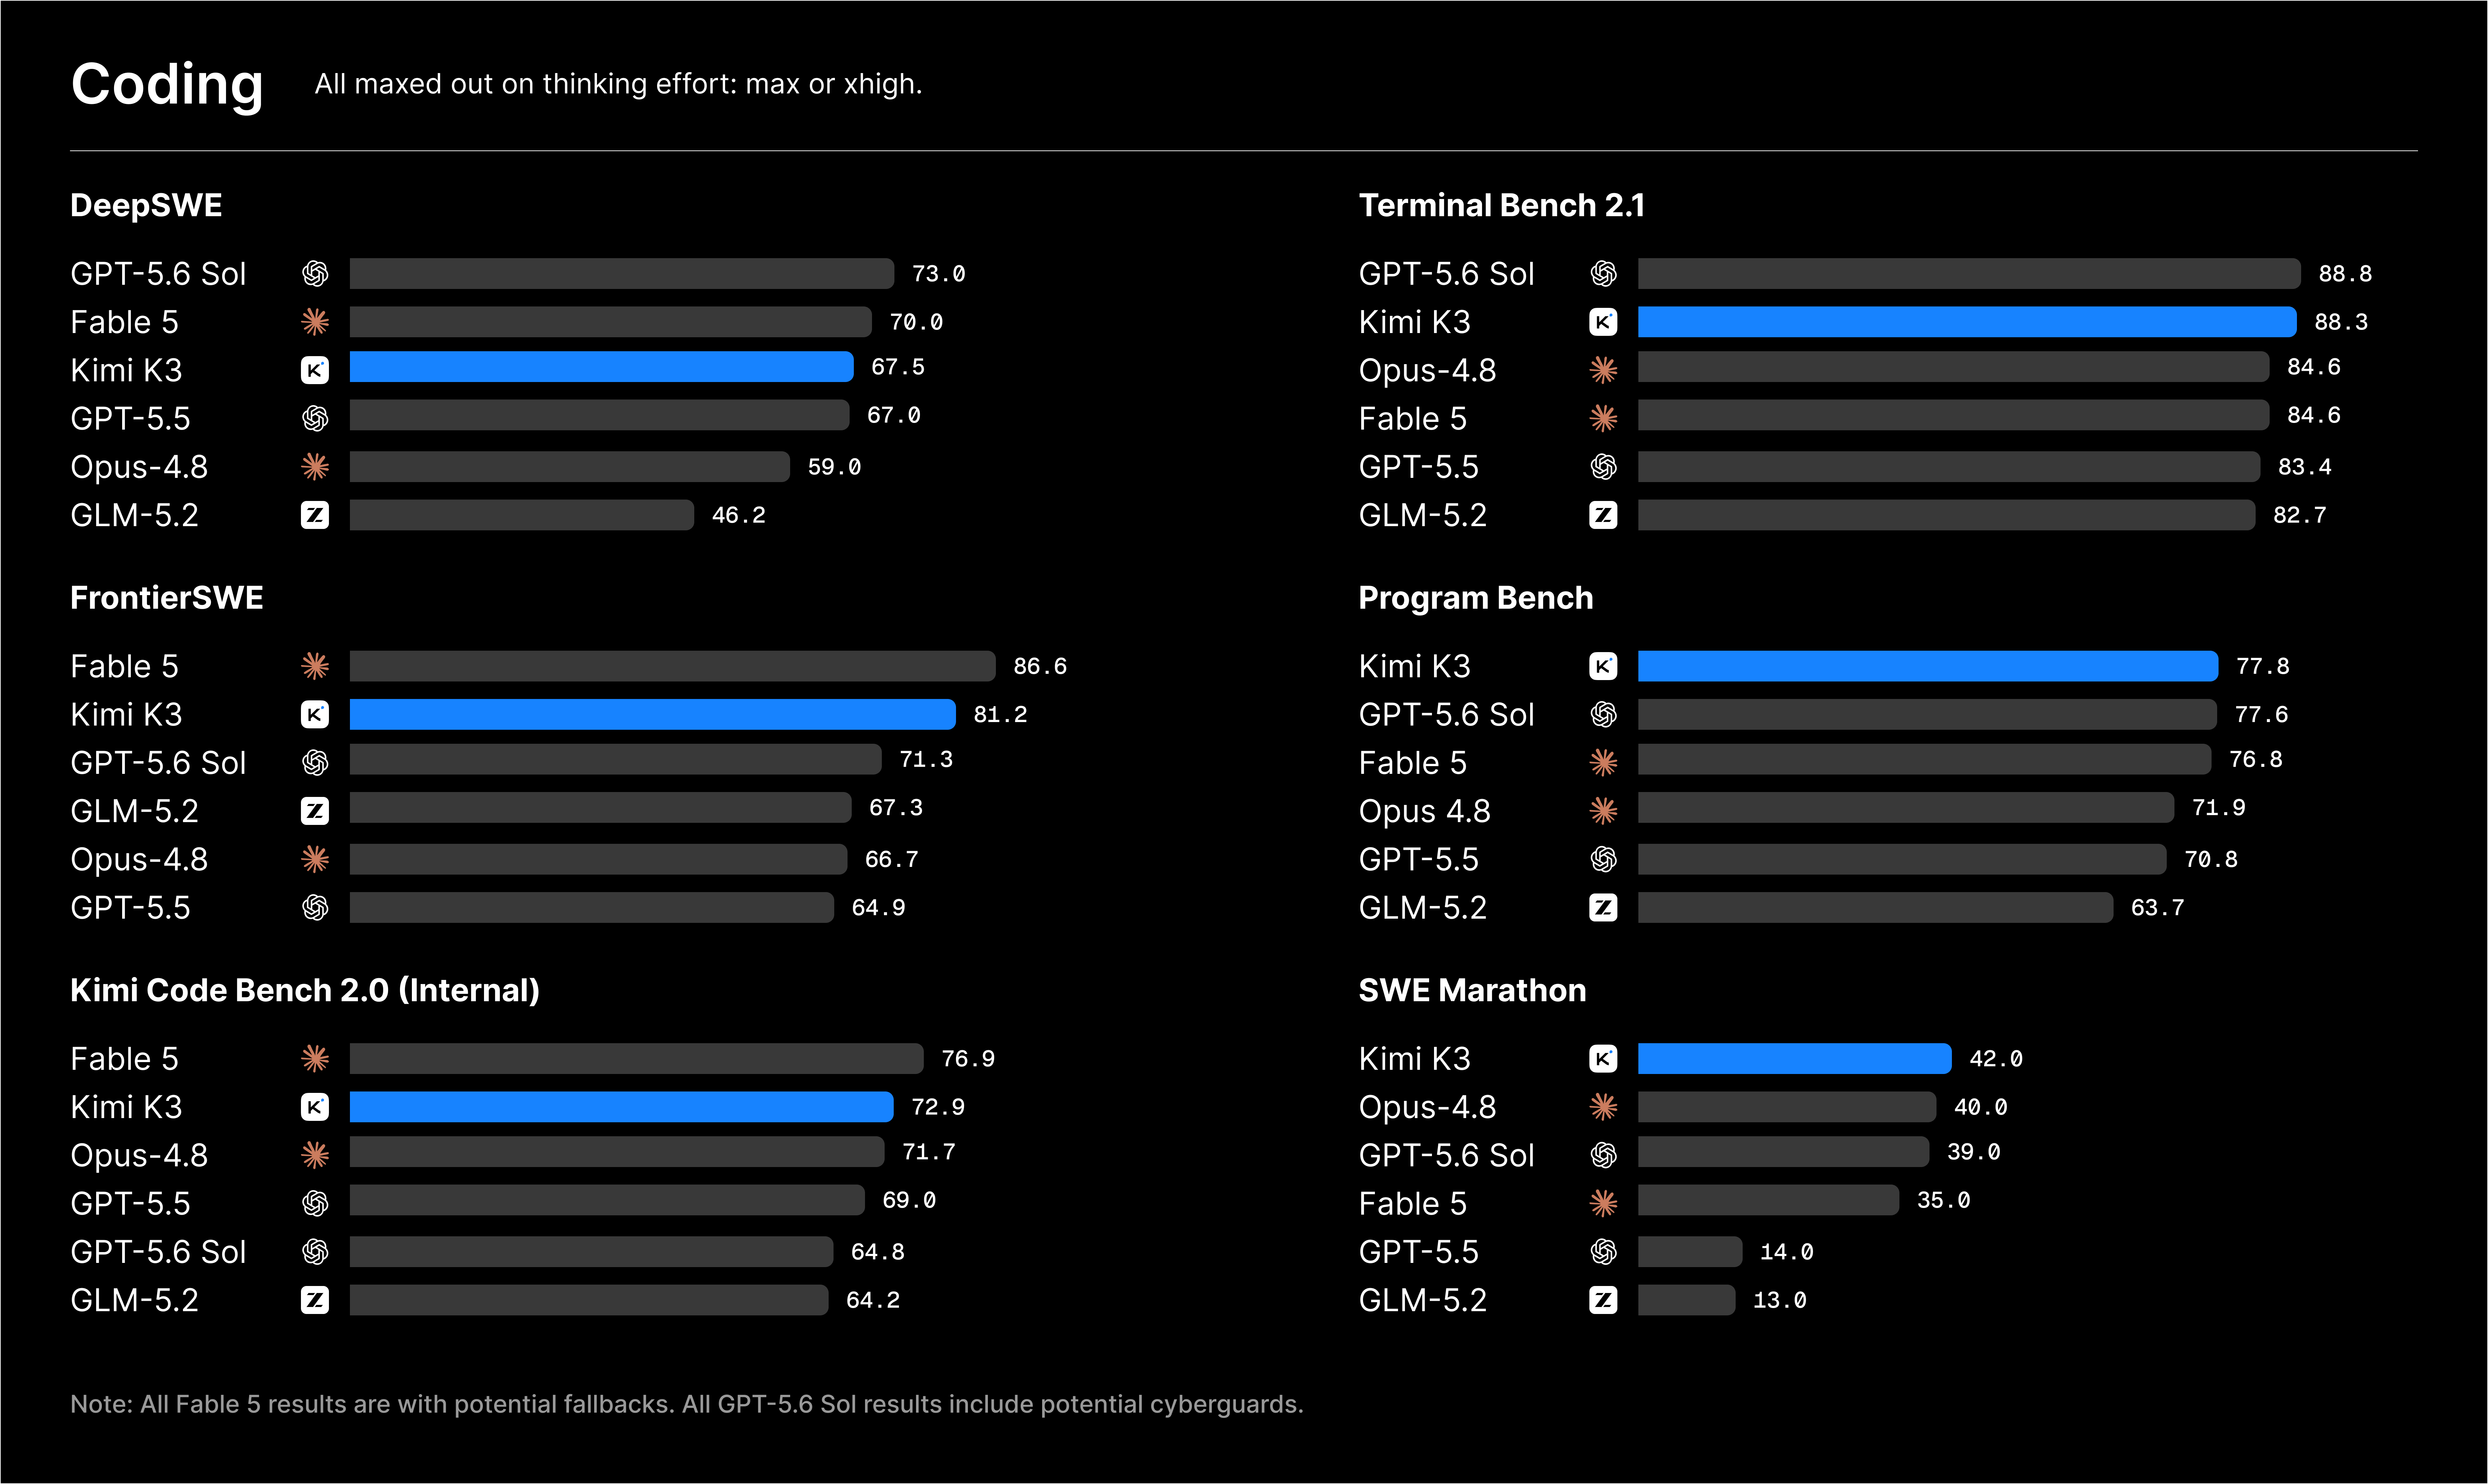
K3 особенно силён здесь, возглавляет Frontend Code Arena (1,679 Elo, #1, впереди Fable 5 и Sol).
Источник: Kimi
Coding Index (Artificial Analysis): высокий ~76, конкурентен с лидерами.
K3 отлично справляется с задачами масштаба репозитория, фронтендом с визуальными итерациями и агентами, использующими инструменты. Разработчики отмечают уровень «Opus 4.8+» для многих задач кодинга.
Что такое Kimi K3 API?
Kimi K3 простыми словами для разработчиков
Kimi K3 API даёт разработчикам хостед-доступ к модели K3 от Moonshot AI через интерфейс в стиле chat-completions. Типичный запрос отправляет список сообщений, выбирает model: "kimi-k3" и получает ответ ассистента. Помимо базового формата чата, K3 добавляет важные для продакшена функции: настраиваемые усилия рассуждения, длинный контекст, визуальный ввод, стриминг, JSON и вывод с ограничениями по схеме, вызов инструментов и кеширование контекста.
Kimi K3 не стоит понимать как «дешёвый общий чат-бот». Её главное ценностное предложение — тяжёлая работа. Если вашему продукту нужно загрузить в модель большой репозиторий, длинный пакет документов, плотный экспорт из таблиц, несколько скриншотов, стенограмму отладки или сложный план инструментов, K3 создана для таких сессий. Если приложению нужны короткие FAQ или классификация по малым входам, меньшая модель может быть экономичнее.
Новые функции и использование API K3
Kimi K3 развивает предыдущие модели Kimi с передовыми улучшениями:
- 1M контекст: Обрабатывайте целые репозитории, книги или длинные диалоги без усечения.
- Встроенное зрение: Анализируйте изображения прямо в сообщениях (base64 или URL).
- Всегда включённое рассуждение: Максимальное усилие по умолчанию; поддерживает структурированные следы мышления (стриминг отдает дельты).
- Вызов инструментов и агенты: Полноценный function calling в стиле OpenAI для сложных воркфлоу.
- Структурированный вывод: Режим JSON для надёжного парсинга.
- Кеширование: Автоматическое кеширование префикса резко снижает стоимость при повторяющемся контексте (сообщается о 90%+ попаданий в кодинге).
Ключевые возможности Kimi K3 API на CometAPI
Контекст на 1M токенов для длинных документов и больших кодовых баз
CometAPI указывает у Kimi K3 контекстное окно на 1,000k токенов. Этот размер меняет подходы к проектированию воркфлоу. Вместо разбиения каждого документа на множество чанков вы можете тестировать рабочие процессы с гораздо большим контекстом в одном запросе: архитектурные документы плюс фрагменты кода, продуктовые требования плюс отчёты о багах, научные статьи плюс заметки или длинные истории поддержки.
Это не значит, что каждый запрос должен использовать полный контекст. Длинный контекст дорог и может замедлять задержку первого токена. Используйте его, когда модели нужна глобальная видимость, а не как замену чистому дизайну извлечения. Сильный продакшен-паттерн в CometAPI — гибридная маршрутизация: используйте эмбеддинги или поиск для извлечения релевантных срезов, но держите K3 доступной для редких задач, где широкий контекст действительно повышает качество ответа.
Всегда включённое рассуждение с настраиваемым reasoning_effort
Документация Kimi говорит, что K3 всегда рассуждает и поддерживает верхнеуровневое поле reasoning_effort со значениями low, high и max. Используйте низкое усилие для лёгких задач, где важны задержка и стоимость; используйте высокое или максимальное для отладки, математических выводов, ревью архитектуры, миграции кода, синтеза длинных документов и многопрометных планов инструментов.
В CometAPI передавайте reasoning_effort в запросе Chat Completions, когда маршрут Kimi K3 поддерживает провайдер-специфичные параметры. Если ваша версия SDK отклоняет верхнеуровневое поле, отправьте его через extra_body или используйте сырой HTTPS.
Стриминг ответов для лучшего UX
Документация Kimi по стримингу объясняет, что стриминг отправляет токены через Server-Sent Events вместо ожидания полного ответа. Это особенно полезно для K3, поскольку глубокое рассуждение и длинные выводы могут занимать больше времени, чем маленькие чат-задачи. В девелопер-инструменте сначала стримьте план, затем код. В исследовательском ассистенте — стримьте краткие разделы. Во внутреннем аналитическом приложении — стримьте предварительные наблюдения, пока генерируется финальный структурированный ответ.
Визуальный ввод для скриншотов, диаграмм и видео
Kimi K3 поддерживает визуальное понимание. Документация Kimi по зрению говорит, что K3 понимает изображения и видео, и что сообщения для зрения должны использовать массивы content с частями image_url или video_url. Те же документы указывают, что URL-формат изображений не поддерживается; используйте base64 или ссылки на загруженные файлы. Для пользователей CometAPI начните с base64-ввода изображений на стейдже — это просто, портируемо и безопасно логируется без зависимости от публичного хоста изображений.
Структурированный вывод, режим JSON и вызов инструментов
Kimi K3 поддерживает структурированный вывод через response_format, а также вызов инструментов через декларации функций в формате JSON Schema. Новые функции API K3 включают tool_choice и динамическую загрузку инструментов. Это важно для агентных продуктов, потому что инвентарь инструментов может стать огромным. Вместо отправки описаний всех инструментов в каждом запросе ваше приложение может сначала показать небольшую функцию search_tools, извлечь только релевантные инструменты и динамически вставить их описания в диалог.
Практическое решение простое: не выбирайте по таблицам бенчмарков в одиночку. Используйте CometAPI, чтобы построить воспроизводимый набор оценок из ваших собственных промтов. Включите как минимум 20–50 реальных задач: исправления багов, задачи по извлечению, скриншоты, PDF, вопросы клиентов, трассы вызовов инструментов и запросы с чувствительной стоимостью. Маршрутизируйте Kimi K3 на задания, где её длинный контекст, рассуждение и поддержка зрения окупают себя.
Цены API: сколько стоит Kimi K3
Цены CometAPI для Kimi K3
Страница модели Kimi K3 на CometAPI указывает:
| Маршрут провайдера | Цена ввода | Цена вывода | Контекст | Идентификатор модели |
|---|---|---|---|---|
| CometAPI Kimi K3 | $2.40 за 1M токенов | $12.00 за 1M токенов | 1,000k токенов | kimi-k3 |
Та же страница сравнивает эти числа с официальными ценами: $3.00 на ввод и $15.00 на вывод за 1M токенов, показывая 20% скидку в актуальном листинге CometAPI. Цены могут меняться, поэтому проверяйте живую страницу модели CometAPI перед публикацией высокотрафикового прайсинга или планированием бюджета продакшена.
Официальные цены Kimi API
Технический блог Moonshot указывает цены Kimi API: $0.30 за 1M входных токенов при попадании в кэш, $3.00 за 1M входных токенов при промахе кэша и $15.00 за 1M выходных токенов. Там же говорится, что официальный Kimi API достигает коэффициента попаданий кэша свыше 90% в задачах по кодингу. Воспринимайте эту цифру 90% как заявленную провайдером для конкретных нагрузок, а не гарантию для каждого приложения. Ваш показатель попаданий кэша зависит от стабильности промтов, описаний инструментов, префиксов репозиториев и истории сессий.
Простые примеры стоимости на CometAPI
| Пример запроса | Входные токены | Выходные токены | Оценочная стоимость на CometAPI |
|---|---|---|---|
| Короткий код-ревью | 20,000 | 2,000 | $0.072 |
| Вопрос по среднему репозиторию | 100,000 | 5,000 | $0.300 |
| Анализ большого документа | 500,000 | 20,000 | $1.440 |
| Почти полный контекстный синтез | 950,000 | 50,000 | $2.880 |
Формула: (input_tokens / 1,000,000 * 2.40) + (output_tokens / 1,000,000 * 12.00).
Важно отметить два момента. Во-первых, токены рассуждения обычно тарифицируются как выходные токены в моделях рассуждения, поэтому вдумчиво задавайте max_completion_tokens. Во-вторых, длинный контекст должен быть намеренным. Отправить 500,000 токенов — мощно, но редко разумно, если 20,000 высокосигнальных токенов дадут тот же ответ.
Как использовать Kimi K3 API в CometAPI
Шаг 1: Создайте ключ CometAPI
Создайте или войдите в аккаунт CometAPI, откройте страницу ключей API и создайте ключ. Сохраните его как серверную переменную окружения COMETAPI_KEY. Не размещайте продакшен-ключи в JavaScript на стороне клиента, мобильных приложениях, публичных репозиториях, скриншотах или клиентских логах.
PowerShell:
$env:COMETAPI_KEY = "your_cometapi_key_here"
macOS или Linux:
export COMETAPI_KEY="your_cometapi_key_here"
Шаг 2: Установите SDK OpenAI
CometAPI поддерживает SDK, совместимые с OpenAI. В Python установите SDK один раз:
python -m pip install --upgrade openai
Шаг 3: Сделайте свой первый вызов Kimi K3 API
Используйте базовый URL CometAPI и идентификатор модели kimi-k3:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

completion = client.chat.completions.create(
    model="kimi-k3",
    messages=[
        {
            "role": "system",
            "content": "You are a precise technical assistant for API developers.",
        },
        {
            "role": "user",
            "content": "Explain when I should use Kimi K3 for a coding agent.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
Эквивалентный запрос cURL:
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "kimi-k3",
    "messages": [
      {"role": "system", "content": "You are a precise technical assistant for API developers."},
      {"role": "user", "content": "Explain Kimi K3 in one paragraph."}
    ],
    "max_completion_tokens": 800
  }'
Новые функции и использование API K3
Усилие мышления
Используйте reasoning_effort, чтобы управлять бюджетом рассуждения K3. Документация Kimi перечисляет low, high и max, где max — значение по умолчанию. В продакшене выбирайте по типу задачи:
| Тип задачи | Рекомендуемое усилие | Почему |
|---|---|---|
| Короткие резюме, перефразирование, простые вопросы-ответы | low | Быстрее и дешевле для низкорисковых задач |
| Код-ревью, извлечение, планирование, анализ | high | Лучший баланс качества и стоимости |
| Сложная отладка, математика, агентные задачи, длинный контекст | max | Лучшая качество, когда глубокое рассуждение оправдывает задержку и стоимость вывода |
Пример на Python:
completion = client.chat.completions.create(
    model="kimi-k3",
    reasoning_effort="high",
    messages=[
        {
            "role": "user",
            "content": (
                "Review this migration plan for hidden risks. "
                "Return the top 5 issues and a safer rollout sequence."
            ),
        }
    ],
    max_completion_tokens=2000,
)

message = completion.choices[0].message
print(message.content)
Если ваша версия SDK OpenAI не принимает reasoning_effort как именованный аргумент, передайте его через extra_body:
completion = client.chat.completions.create(
    model="kimi-k3",
    messages=[{"role": "user", "content": "Solve this scheduling problem."}],
    extra_body={"reasoning_effort": "high"},
)
Важная деталь реализации: документация Kimi по мышлению говорит, что в многошаговых диалогах K3 следует сохранять полное сообщение ассистента, возвращаемое API, включая поля вроде reasoning_content и tool_calls. Если вы храните только видимое content, это может ухудшить непрерывность рассуждения в длинных сессиях.
Стриминг ответов
Используйте стриминг, когда ответ может быть длинным, когда важна задержка или когда вы хотите показывать прогресс в чат-UI.
stream = client.chat.completions.create(
    model="kimi-k3",
    messages=[
        {
            "role": "user",
            "content": "Create a detailed refactor plan for a 200k-line monolith.",
        }
    ],
    stream=True,
    stream_options={"include_usage": True},
    max_completion_tokens=3000,
)

for chunk in stream:
    choice = chunk.choices[0]
    delta = choice.delta

    reasoning = getattr(delta, "reasoning_content", None)
    if reasoning:
        # In most products, store reasoning securely or hide it from end users.
        pass

    if delta.content:
        print(delta.content, end="", flush=True)

    usage = getattr(choice, "usage", None)
    if usage:
        print("\n\nUsage:", usage)
Документация Kimi по стримингу подчёркивает, что SSE-потоки завершаются маркером data: [DONE]. В сыром клиенте SSE не считайте поток завершённым до появления этого маркера.
Визуальный ввод
Kimi K3 может анализировать изображения и видео. Самый безопасный первый тест в CometAPI — запрос с изображением в base64. Используйте мультимодальный массив content, а не JSON-строку, содержащую массив.
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard-screenshot.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
image_b64 = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="kimi-k3",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{image_b64}",
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Review this dashboard screenshot. "
                        "Identify UX issues, missing states, and data-quality risks."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1800,
)

print(completion.choices[0].message.content)
Документация Kimi по зрению перечисляет поддерживаемые форматы изображений, такие как PNG, JPEG, WebP и GIF, и поддерживаемые форматы видео, такие как MP4, MOV, AVI, WebM и другие. Также рекомендуется держать разрешение изображений не выше 4K и видео — не выше FHD, поскольку более высокое разрешение может увеличивать время обработки без улучшения понимания модели.
Структурированный вывод с JSON Schema
Для производственных пайплайнов не парсите свободный текст, если следующий шаг ожидает структурированные данные. Используйте response_format с JSON Schema, когда это поддерживается маршрутом.
import json

completion = client.chat.completions.create(
    model="kimi-k3",
    messages=[
        {
            "role": "user",
            "content": (
                "Extract implementation tasks from this request: "
                "Add SSO, migrate billing webhooks, and create admin audit logs."
            ),
        }
    ],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "name": "implementation_tasks",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "tasks": {
                        "type": "array",
                        "items": {
                            "type": "object",
                            "properties": {
                                "title": {"type": "string"},
                                "risk": {"type": "string"},
                                "owner": {"type": "string"},
                            },
                            "required": ["title", "risk", "owner"],
                            "additionalProperties": False,
                        },
                    }
                },
                "required": ["tasks"],
                "additionalProperties": False,
            },
        },
    },
)

data = json.loads(completion.choices[0].message.content)
print(data["tasks"])
Вызов инструментов и tool_choice
Рекомендации по вызову инструментов для K3 советуют избегать огромных инвентарей инструментов в одном запросе. Паттерн: сначала откройте функцию поиска инструментов, принудите извлечение с tool_choice: "required" на первом шаге, затем динамически загрузите только нужные определения инструментов.
Минимальный пример «погоды»-стиля:
import json

tools = [
    {
        "type": "function",
        "function": {
            "name": "get_order_status",
            "description": "Look up a customer's order status.",
            "parameters": {
                "type": "object",
                "properties": {
                    "order_id": {"type": "string"},
                },
                "required": ["order_id"],
                "additionalProperties": False,
            },
        },
    }
]

messages = [
    {"role": "user", "content": "Where is order A1024?"},
]

first = client.chat.completions.create(
    model="kimi-k3",
    messages=messages,
    tools=tools,
    tool_choice="required",
)

assistant_message = first.choices[0].message
messages.append(assistant_message.model_dump(exclude_none=True))

for call in assistant_message.tool_calls or []:
    args = json.loads(call.function.arguments)
    result = {"order_id": args["order_id"], "status": "Shipped", "eta": "2026-07-24"}
    messages.append(
        {
            "role": "tool",
            "tool_call_id": call.id,
            "content": json.dumps(result),
        }
    )

final = client.chat.completions.create(
    model="kimi-k3",
    messages=messages,
    tools=tools,
)

print(final.choices[0].message.content)
Лучшие практики Kimi K3 для продакшен-команд
Используйте Kimi K3 там, где её сильные стороны очевидны
Kimi K3 — сильный кандидат для анализа репозиториев, фронтенд-кодинга, воспроизведения багов, синтеза длинных документов, рассуждений по таблицам, QA с поддержкой зрения и агентных воркфлоу, которым нужны инструменты. Она может быть избыточной для генерации коротких текстов, простой классификации или низкостратегических саппорт-макросов. В CometAPI создайте правила маршрутизации моделей, чтобы K3 получала сложную работу, пока более дешёвые модели обрабатывают рутину.
Стройте резервные сценарии, поскольку запуск идёт с ограничениями по ёмкости
Сообщение AP о том, что Moonshot приостановила новые подписки, — напоминание, что доступность — часть выбора модели. Стройте резервные сценарии на уровне приложения. Если Kimi K3 возвращает ошибку «ёмкость провайдера», маршрутизируйте на другую модель CometAPI с похожими сильными сторонами, уменьшайте размер контекста или ретрайте с бэкоффом. Держите UX аккуратным: показывайте прогресс, сохраняйте черновики и делайте сбои восстановимыми.
Аккуратно сохраняйте контекст в многоходовых сессиях
Kimi K3 обучалась с сохранением истории мышления. Технический блог Moonshot предупреждает, что переключение на K3 в середине сессии или непередача полного исторического сообщения ассистента может снизить стабильность. На практике храните полный объект сообщения ассистента, возвращаемый API, для дев-инструментов и агентов. Не сжимайте tool_calls или специфичные для провайдера поля рассуждения, пока не проверите влияние.
Контролируйте стоимость вывода и рассуждения
Всегда задавайте max_completion_tokens. Справочник Kimi говорит, что по умолчанию у K3 max_completion_tokens равен 131,072 и может быть установлен до 1,048,576, с учётом лимита контекста модели. Это мощно, но может неприятно удивить биллинг, если промт приглашает огромный ответ. Для большинства продуктовых потоков определяйте отдельные лимиты: 800–1,500 токенов для резюме, 2,000–4,000 для подробного анализа и более крупные лимиты — только для явной длинной генерации.
Проектируйте под кеширование
Кеширование контекста Kimi лучше всего работает, когда повторяющийся начальный контекст остаётся стабильным. Текущая документация по кешированию контекста Kimi описывает его как автоматическое: не требуется ручное создание кеша, ID кеша или управление TTL. Для кодинговых агентов держите инструкции по репозиторию, определения инструментов и проектные политики в стабильном префиксе. Для документального QA держите пакет документов стабильным между связанными вопросами. Избегайте переписывания системного промта на каждом шаге и размещайте фиксированный большой контекст ближе к началу массива messages, чтобы кеш распознавал повторяющиеся префиксы.
Используйте зрение осознанно
Визуальный ввод ценен, но изображения и видео потребляют токены в зависимости от контента и разрешения. Используйте изображения, когда они несут информацию, которую текст не передаёт: макеты UI, диаграммы, рукописные заметки, дизайнерские мокапы, скриншоты CAD и экранов с ошибками. Понижайте слишком высокое разрешение, обрезайте лишние поля и дополняйте изображение точным вопросом.
Итоги и рекомендации
Kimi K3 на CometAPI предоставляет передовые возможности — гигантский контекст, зрение и рассуждение — по доступным ценам и с минимальной интеграцией. Если вы создаёте кодинговых агентов, мультимодальные приложения или масштабируемые AI-сервисы, начните с CometAPI для унифицированного доступа, экономии и надёжности. Зарегистрируйтесь, попробуйте квикстарты выше и масштабируйтесь уверенно.