Технические характеристики Qwen3.8-Flash
| Спецификация | Qwen3.8-Flash |
|---|---|
| Поставщик | Alibaba / Qwen |
| Семейство моделей | Qwen3.8 |
| Идентификатор модели | qwen3.8-flash |
| Тип модели | Мультимодальная модель рассуждения |
| Входные модальности | Текст, изображение, видео |
| Выходная модальность | Текст |
| Окно контекста | 1,000,000 токенов |
| Максимальный вывод | 128,000 токенов |
| Максимальный бюджет рассуждения | 262,144 токенов |
| Режим мышления | Поддерживается |
| Вызов функций | Поддерживается |
| Встроенные инструменты | Поддерживаются |
Текущая документация API Qwen указывает qwen3.8-flash как продукционную модель Qwen3.8 с контекстным окном в 1M токенов и максимальным выводом 128K. Она поддерживает ввод текста, изображений и видео, вызов функций, встроенные инструменты и структурированный вывод.
Для визуальных задач задокументированы ограничения: до 16 мегапикселей на изображение, до 2,048 URL-адресов изображений или 250 изображений Base64, и до 64 видео, длительностью до 2 часов.
Что такое Qwen3.8-Flash?
Qwen3.8-Flash — экономичная мультимодальная модель рассуждения от Alibaba в семействе Qwen3.8, предназначенная для программирования, агентных рабочих процессов, анализа длинного контекста и визуального понимания. Она предоставляет тот же класс контекста на 1M токенов, что и Qwen3.8-Max, при этом ориентируется на существенно более низкую стоимость API. В руководстве для разработчиков Qwen прямо рекомендуется Qwen3.8-Flash, когда нужны схожие возможности по более низкой цене, тогда как Qwen3.8-Max позиционируется как более сильная модель для рассуждений.
Эта модель особенно интересна тем, что «Flash» не означает просто маленькую модель. Продукционная модель API сочетает длительные рассуждения в большом контексте, мультимодальный ввод, использование инструментов и структурированный вывод в относительно недорогом эндпоинте.
Каковы основные возможности Qwen3.8-Flash?
- 1M-токеновый контекст: Qwen3.8-Flash может обрабатывать чрезвычайно длинные документы и кодовые базы, что делает её подходящей для анализа репозиториев и длительных сессий агентов.
- Мультимодальное понимание: API принимает текст, изображения и видео, позволяя разработчикам объединять код, скриншоты, графики, документы и видео в одном рабочем процессе.
- Режим рассуждения: Модель поддерживает режим мышления Qwen, с задокументированным максимальным бюджетом рассуждения 262,144 токенов.
- Поддержка агентов и инструментов: Поддерживаются вызов функций и встроенные инструменты, включая возможности веб-поиска, выполнения кода и связанные инструменты, размещённые Qwen.
- Структурированный вывод: Разработчики могут запрашивать структурированные ответы, что упрощает интеграцию модели в приложения, требующие JSON или результатов, ограниченных схемой.
- Понимание длинных видео: Документация визуального API указывает, что на вход можно подавать видео длительностью до двух часов, что делает Qwen3.8-Flash полезной для анализа видео, а не только задач краткого описания изображений.
Лучшие сценарии использования Qwen3.8-Flash
Программирование и инженерия программного обеспечения
Контекст на 1M токенов полезен для больших репозиториев, длительных сеансов отладки и анализа мног файлового кода. Поддержка вызова функций и режимов рассуждения делает модель подходящей для кодовых агентов, а не только для автодополнения кода.
Агентные рабочие процессы
Qwen3.8-Flash поддерживает вызов функций и встроенные инструменты, позволяя приложению давать модели возможность извлекать информацию, выполнять код или взаимодействовать с внешними системами.
Анализ длинных документов
Контекст на миллион токенов делает модель подходящей для больших контрактов, технической документации, исследовательских коллекций и корпоративных баз знаний, где в противном случае потребовалось бы многократное разбиение информации на части.
Анализ видео и визуальных данных
Qwen3.8-Flash принимает как изображения, так и видео. Текущие ограничения визуального API позволяют видео длительностью до двух часов, что важно для записей встреч, обучающих материалов, лекций, демонстраций и анализа длинного визуального контента.
Производственный ИИ с ориентацией на стоимость
Вероятно, это самое большое коммерческое преимущество модели. Qwen явно рекомендует Flash как более доступную альтернативу Qwen3.8-Max, что делает её подходящей для высокообъёмных приложений, где флагманский уровень рассуждений не нужен в каждом запросе.
Ограничения Qwen3.8-Flash
Qwen3.8-Flash не следует интерпретировать как модель с наивысшей производительностью в семействе Qwen3.8 лишь потому, что у неё такое же окно контекста, как у Qwen3.8-Max.
Основной компромисс — это возможности против стоимости: сам Qwen рекомендует Qwen3.8-Max, когда требуется максимальная сила рассуждений.
Второй важный момент — окно контекста в 1M токенов не означает, что каждый запрос должен содержать миллион токенов. Большие контексты повышают требования к обработке, и разработчикам следует использовать поиск, кэширование и управление контекстом, когда всякий раз весь контекст не необходим.
Наконец, разработчикам следует различать размещённую qwen3.8-flash и открытовесовую Qwen3.8-Flash-Next. Последняя — архитектурная предварительная версия с независимо задокументированными весами и архитектурой; продукционная модель API должна документироваться согласно собственным спецификациям API.
Подходит ли Qwen3.8-Flash для продукционных приложений API?
Да, особенно когда приложению требуется мультимодальное рассуждение, длинный контекст, использование инструментов и относительно низкая стоимость токенов.
Она является более сильным кандидатом для продакшена, чем Flash-Next, когда требуется просто вызывать размещённый API Qwen, поскольку qwen3.8-flash явно представлен как продукционная модель в документации API Qwen с определёнными ограничениями на контекст, вывод, инструменты и мультимодальность.
Для максимального качества рассуждений более подходящим выбором остаётся Qwen3.8-Max. Для высокообъёмных нагрузок, где важнее стоимость и пропускная способность, Qwen3.8-Flash — более экономичный вариант.
Параметры API Qwen3.8-Flash
Стандартный запрос, совместимый с OpenAI, может использовать следующие параметры:
| Параметр | Назначение |
|---|---|
| model | qwen3.8-flash |
| messages | Диалог и мультимодальный ввод |
| temperature | Управление выборкой |
| max_tokens | Максимально генерируемый вывод |
| stream | Потоковая выдача |
| tools | Определения функций/инструментов |
| tool_choice | Поведение выбора инструмента |
| response_format | Конфигурация структурированного вывода |
| enable_thinking | Включение режима мышления в поддерживаемых API Qwen |
Документация по быстрому старту использует SDK OpenAI с идентификатором модели qwen3.8-flash. В примере режим рассуждения включается через extra_body={"enable_thinking": True}.
Как использовать API qwen3.8-flash в CometAPI
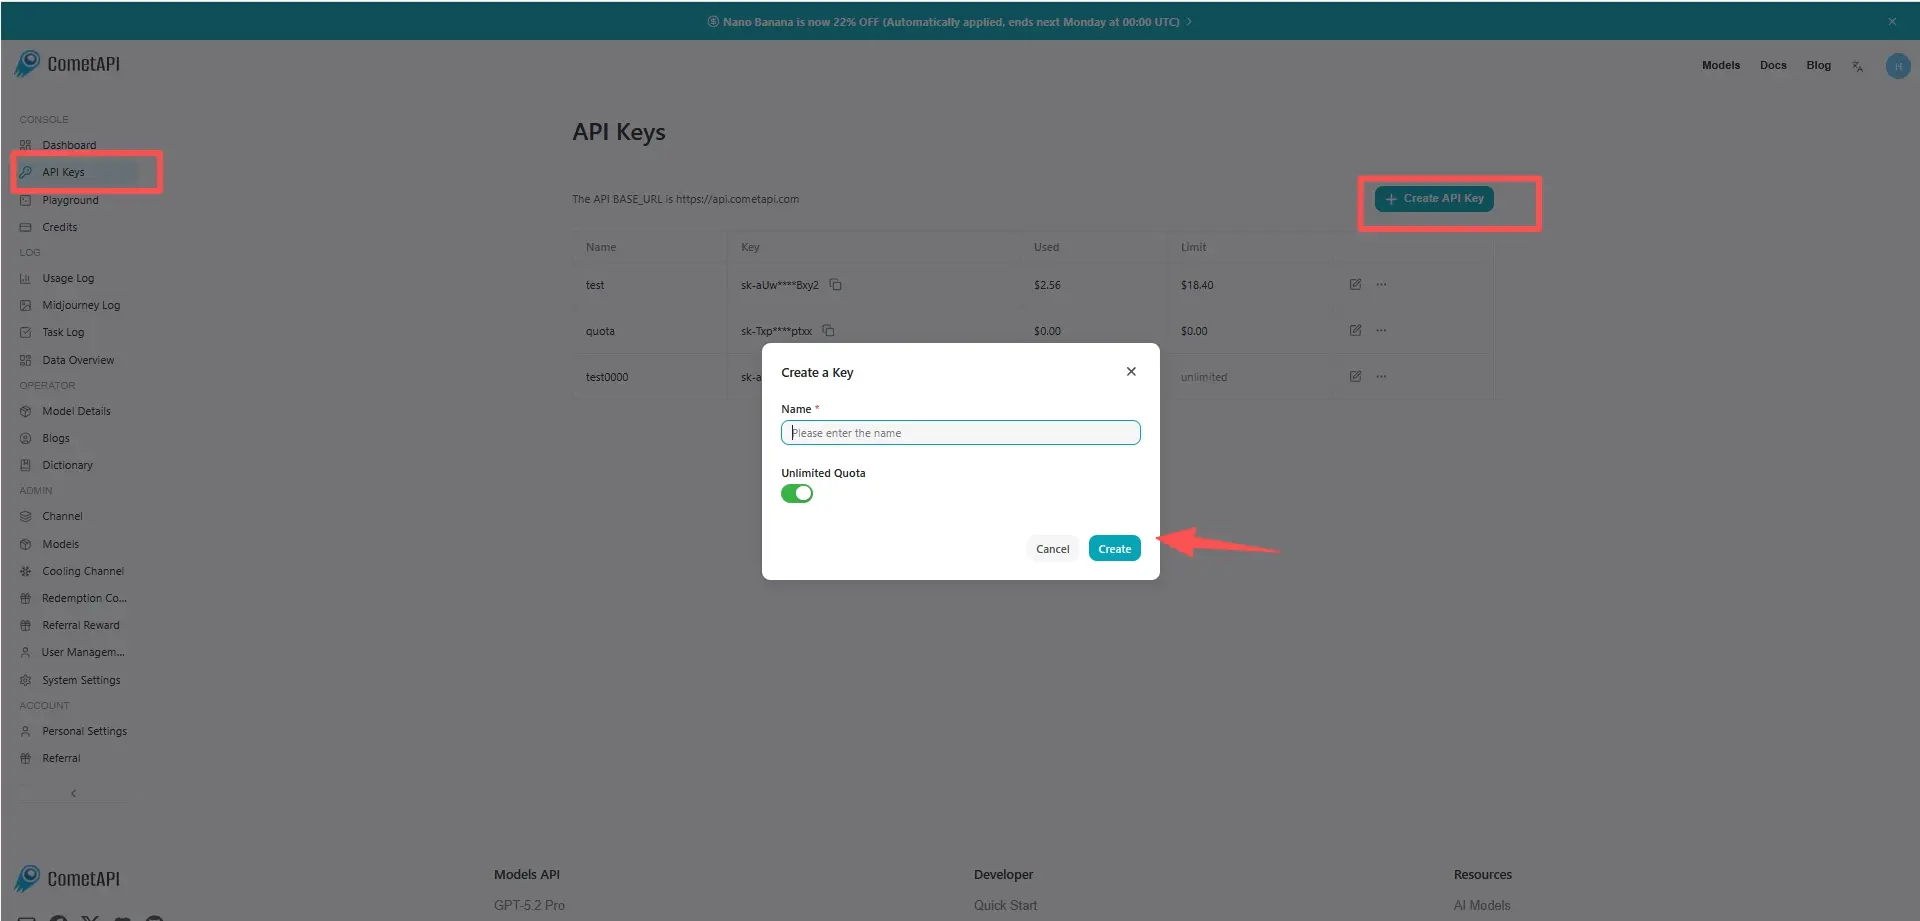
Шаг 1: Получить доступ к API
Войдите в cometAPI. Если вы ещё не наш пользователь, сначала зарегистрируйтесь. Авторизуйтесь в нашей Консоли CometAPI. Получите ключ доступа API. Нажмите «Добавить токен» в разделе токенов API в личном кабинете, получите ключ токена: sk-xxxxx и отправьте.
Шаг 2: Отправить запросы к API qwen3.8-flash
Выберите эндпоинт «qwen3.8-flash» для отправки запроса к API и задайте тело запроса. Метод запроса и тело запроса доступны в документации API на нашем сайте. Наш сайт также предоставляет тестирование в Apifox для вашего удобства. Замените <YOUR_API_KEY> на ваш фактический ключ CometAPI из вашего аккаунта.
Вставьте свой вопрос или запрос в поле content — именно на него модель ответит. Обработайте ответ API, чтобы получить сгенерированный результат. Поддерживаются AI SDK, интерфейсы, совместимые с OpenAI Chat Completions, OpenAI Responses и Anthropic Messages.
Шаг 3: Обработка ответов
API возвращает структурированные варианты ответов, включая сгенерированный текст, ссылки, метаданные безопасности и необязательные выводы инструментов. Для мультимодальных запросов содержимое сообщения можно структурировать с текстовыми и графическими входными данными, когда выбранный эндпоинт CometAPI предоставляет возможности зрения модели.