Создавайте с CometAPIНужен один API для нескольких моделей?Протестируйте рабочий процесс в Playground, затем создайте API-ключ, когда модель и стоимость подойдут для вашего сценария.
Как сократить расходы на токены агента ИИ в продакшене
Сократите расходы на токены ИИ-агентов, контролируя рост контекста, выходные данные инструментов, число повторных попыток, процесс рассуждений и работу субагентов. Включает 12-шаговый пример затрат.
Стоимость токенов у ИИ-агентов растет, когда на каждом шаге снова и снова обрабатываются инструкции, история переписки, результаты инструментов и промежуточное состояние.
Сократите объем токенов с помощью бюджетов на весь запуск, фильтрации результатов инструментов, сжатия контекста, лимитов повторных попыток и управляемого рассуждения. Используйте кэширование промптов для стабильного повторяющегося ввода, но сначала оптимизируйте цикл агента, а уже затем переключайтесь на более дешевую модель.
Самая полезная метрика в проде — это стоимость на успешно выполненную задачу, измеренная по всему запуску, а не цена за запрос или размер контекста финального вызова.
Это руководство сфокусировано именно на многошаговых ИИ-агентах. В нем объясняется, как повторяющийся контекст накапливается в ходе запуска, как найти крупнейший источник потерь и какие меры внедрять в первую очередь.
Introduction
Чат-бот может делать один запрос к модели на каждое сообщение. ИИ-агент может сделать 10, 20 и более вызовов, прежде чем завершит одну задачу.
Проверено на ясность, указание источников и актуальную терминологию API.
На каждом шаге могут снова отправляться инструкции, история переписки, результаты инструментов и промежуточное состояние. Повторы, рассуждение и сабагенты добавляют еще больше использования, так что короткий финальный ответ все равно может потребить большое число токенов.
По мере масштабирования эти затраты становятся труднее предсказуемыми и могут быстро снизить маржинальность продукта. Снижение их требует оптимизации всего цикла агента, а не просто переключения на более дешевую модель.
Эта статья сосредоточена на расходах, специфичных для агентов. Более широкое руководство по кэшированию промптов, кэшированию точных ответов, семантическому кэшированию, маршрутизации моделей и общему управлению затратами API смотрите в How to Reduce AI API Costs (https://www.cometapi.com/reduce-ai-api-costs/).
Why Do AI Agent Token Costs Compound?
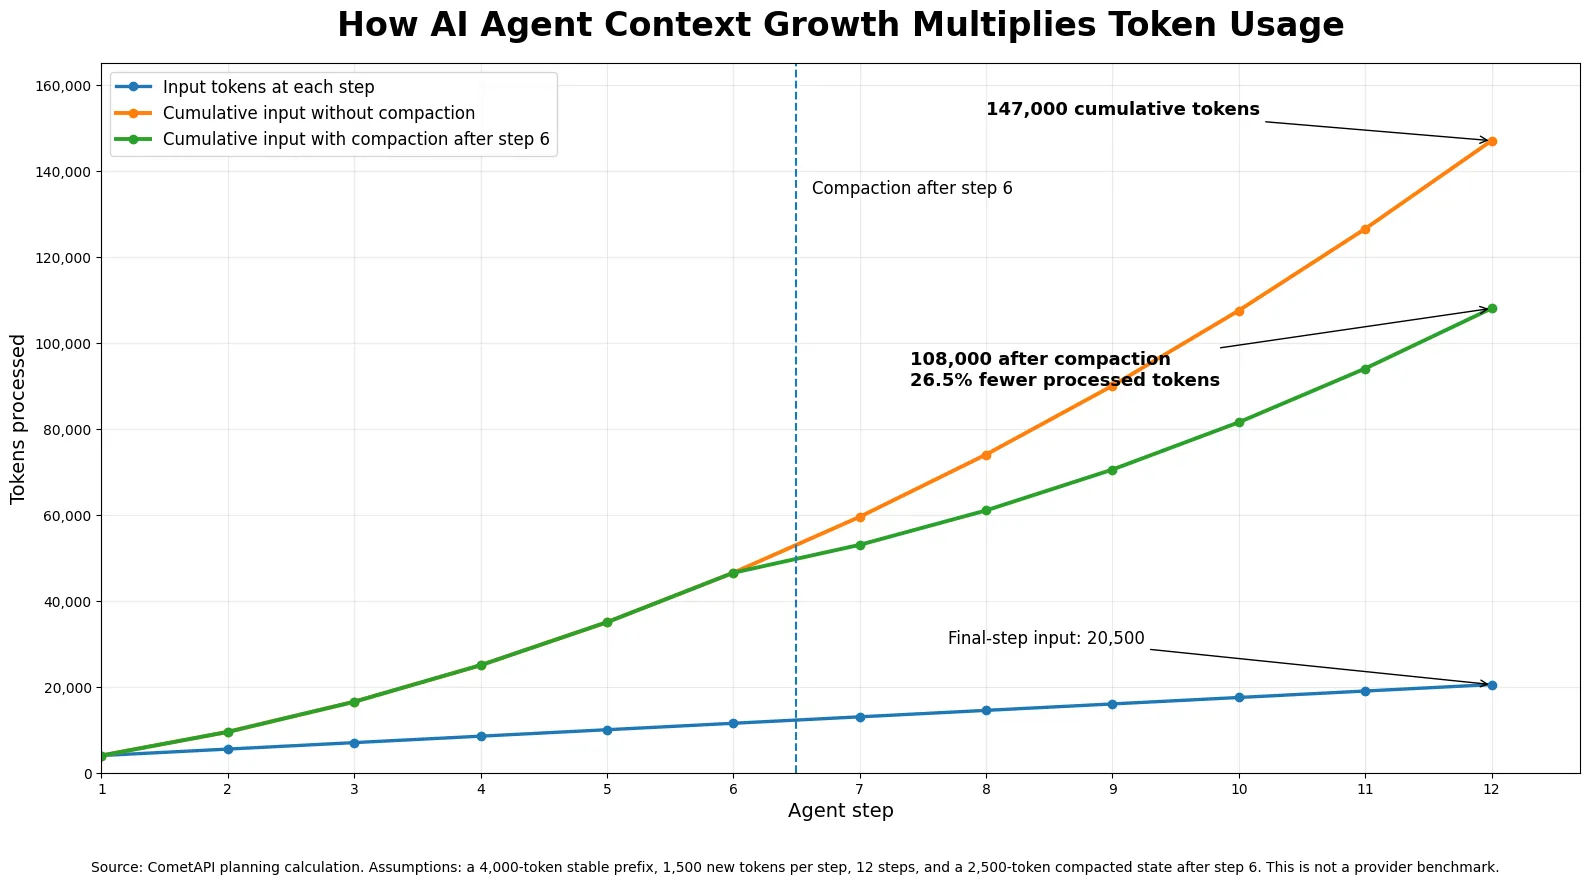
В многошаговом агенте стоимость одной задачи — это сумма всех вызовов модели, а не только финального ответа.
В финальном вызове лишь 20 500 входных токенов, но за весь запуск обрабатывается 147 000 входных токенов.
Теперь применим два контроля:
Кэшируем стабильный префикс в 4 000 токенов после первого вызова.
После шестого шага сжимаем историю в 2 500‑токеновое состояние.
Scenario
Uncached input
Cached input
Total processed input
Change
Full history on every step
147,000
0
147,000
Базовый уровень
Stable prefix cached
103,000
44,000
147,000
Тот же объем, более дешевая смесь
Cache plus compaction
64,000
44,000
108,000
26.5% fewer processed tokens
Это расчет для планирования, а не бенчмарк провайдера.
Он предполагает, что каждый запрос включает полностью накопленную историю. Агенты, которые выборочно конструируют состояние, суммируют старые сообщения или извлекают только релевантную информацию, могут иметь другую кривую затрат.
Правило роста затрат: измеряйте совокупный вход за весь запуск. Размер финального контекста не отражает общее число обработанных токенов.
Which Metrics Reveal Agent Token Waste?
Не начинайте со смены модели. Сначала определите, где рабочий процесс тратит токены без улучшения результата.
Записывайте эти поля для каждого шага агента:
Field
Why it matters
run_id, step_id, parent_step_id
Восстанавливают дерево агента и сабагентов
Rendered input tokens
Показывают рост контекста между вызовами
Cached and uncached input
Отделяют переиспользуемый ввод от нового
Output and reasoning tokens
Выявляют дорогие по генерации шаги
Tool result size and retained tokens
Показывают, сколько сырой доказательной базы попало в последующие подсказки
Retry reason and attempt number
Идентифицируют повторяющиеся сбои
Compaction tokens before and after
Измеряют фактическое сокращение контекста
Worker ID and returned tokens
Показывают дублирование работы сабагентов
Accepted, rejected, or escalated result
Связывает стоимость с качеством выполнения задачи
Основная метрика должна быть:
cost per successful task
= total workflow cost
/ accepted tasks
Более дешевый запуск — не улучшение, если он приводит к росту неуспешных задач, повторных вызовов инструментов или ручной правки.
Четыре метрики, специфичные для агентов, помогают найти проблему.
Высокое значение говорит о многократной обработке раннего контекста.
Tool Retention Ratio
tool retention ratio
= tool-result tokens retained in context
/ tokens originally returned by tools
Высокая доля может означать, что агент переносит слишком много сырой доказательной базы между шагами.
Retry Tax
retry tax
= retry and repair cost
/ total workflow cost
Reasoning Share
reasoning share
= reasoning-token cost
/ total model cost
Измеряйте каждую нагрузку отдельно. Агентов для ресерча, кодинга, браузинга и поддержки клиентов не стоит сводить к одному глобальному базовому уровню.
Six Ways to Reduce AI Agent Token Costs
1. Set a Budget for the Complete Run
Лимит на вывод в одном запросе не контролирует многошагового агента.
Задайте лимиты на уровне всего запуска:
Общее число шагов модели
Совокупный вход и выход
Вызовы инструментов и размер их результатов
Повторы по типам сбоев
Сабагенты
Общее время или ориентировочная стоимость
Ниже нейтральный к провайдерам пример на Python, который оценивает запуск перед каждым вызовом модели:
from dataclasses import dataclass
from enum import Enum


class Action(str, Enum):
    CONTINUE = "continue"
    COMPACT = "compact"
    STOP = "stop"


@dataclass(frozen=True)
class Budget:
    max_steps: int = 12
    max_input_tokens: int = 120_000
    max_output_tokens: int = 18_000
    compact_at: float = 0.80


@dataclass
class Usage:
    steps: int = 0
    input_tokens: int = 0
    output_tokens: int = 0


def evaluate_budget(usage: Usage, budget: Budget) -> Action:
    if (
        usage.steps >= budget.max_steps
        or usage.input_tokens >= budget.max_input_tokens
        or usage.output_tokens >= budget.max_output_tokens
    ):
        return Action.STOP

    input_ratio = usage.input_tokens / budget.max_input_tokens

    if input_ratio >= budget.compact_at:
        return Action.COMPACT

    return Action.CONTINUE
Запускайте эту проверку перед каждым обращением к модели и обновляйте Usage по данным о токенах от провайдера.
На 80% входного бюджета сжимайте состояние или сужайте следующий запрос к инструменту. На 100% останавливайтесь со структурированным объяснением причины.
Распространенная ошибка: ограничивать каждый ответ, но допускать неограниченные шаги, инструменты и повторы.
2. Filter Tool Results Before They Enter the Transcript
Возвращайте только те доказательства, которые нужны для следующего решения агента.
Не добавляйте целиком:
веб‑страницу,
файл логов,
дерево репозитория,
ответ базы данных,
сеанс терминала,
payload API,
когда на следующем шаге нужны лишь несколько полей.
Инструмент поиска может вернуть:
{
  "source_id": "search_17",
  "title": "Relevant page title",
  "url": "https://example.com/page",
  "relevant_passage": "A short evidence block"
}
Храните полный артефакт вне подсказки и позже извлекайте более узкий фрагмент.
Правило фильтрации инструментов: возвращайте поля, необходимые для следующего решения, а не все поля, которые могут понадобиться когда‑нибудь.
Распространенная ошибка: усекать первые 1 000 символов JSON‑пейлоада. Это может сломать структуру или удалить нужные записи. Сначала распарсьте payload, выберите поля структурно, ограничьте массивы, а затем сериализуйте валидный JSON.
3. Compact Operational State, Not Just Conversation Text
Сжатие должно сохранять информацию, необходимую для продолжения задачи, и удалять историю, которая больше не влияет на следующий шаг.
Полезное сжатое состояние содержит:
Цель пользователя и критерии успеха
Принятые решения
Проверенные факты и ID источников
Измененные файлы или записи
Неудавшиеся подходы
Открытые вопросы
Следующее действие
Ограничения по безопасности и формату вывода
Оно не должно пересказывать всю беседу.
OpenAI документирует сжатие для долгих взаимодействий в Responses API. Anthropic предоставляет средства управления контекстом для очистки или суммирования старого содержимого. Реализации различаются — перед интеграцией проверьте актуальные поля у вашего провайдера.
Правило сжатия: сохраняйте решения и незавершенную работу. Удаляйте повествование и доказательства, которые можно заново извлечь.
Распространенная ошибка: терять ID источников, измененные имена файлов, отклоненные подходы или нерешенные ограничения.
После добавления сжатия измерьте, не повторяет ли агент поиски или вызовы инструментов. Более короткая подсказка не дешевле, если агент вынужден восстанавливать потерянное состояние.
4. Keep the Reusable Prefix Stable
Подсказки агента часто содержат большие переиспользуемые блоки:
Системные инструкции
Схемы инструментов
Политики безопасности
Форматы вывода
Общие справочные материалы
Инструкции по репозиторию или продукту
Размещайте эти стабильные элементы перед данными, специфичными для запроса:
1. System instructions
2. Policies and constraints
3. Tool definitions
4. Stable examples
5. Shared reference material
6. Request-specific data
Избегайте размещения временных меток, ID запросов, данных сессии или часто меняющихся значений в начале.
Кэширование наиболее полезно, когда префикс длинный, стабильный и переиспользуется. Для коротких сессий или часто меняющихся подсказок оно может не дать экономии.
Распространенная ошибка: оптимизировать частоту попаданий в кэш, не измеряя стоимость записи, чтения и хранения.
Для более широкого сравнения кэширования промптов у разных провайдеров, кэширования точных ответов и семантического кэширования см. How to Reduce AI API Costs (https://www.cometapi.com/reduce-ai-api-costs/).
5. Prevent Retries From Replaying the Same Context
Повтор — это еще один шаг агента, часто с тем же большим промптом.
Не повторяйте неудавшийся запрос, не изменив причину сбоя.
Failure
Better response
Invalid structured output
Вернуть ошибку валидации и повторить один раз
Tool timeout
Повторить идемпотентную операцию один раз, затем остановиться или использовать fallback
Context overflow
Сжать состояние или извлечь меньше доказательств
Repeated tool call
Дедуплицировать с помощью хеша операции
Rate limit
Отложить повтор и/или использовать проверенный маршрут‑замену
Low-confidence result
Запросить недостающую информацию или эскалировать
Используйте ключи идемпотентности для операций с побочными эффектами, таких как платежи, письма, деплой и запись в БД.
Распространенная ошибка: несколько раз повторять вызов ограниченной по скорости модели, каждый раз пересылая весь контекст агента.
Отслеживайте «налог на повторы» по типам сбоев, чтобы команда сначала чинила самый затратный цикл.
6. Limit Reasoning and Subagents to Steps That Need Them
Не каждый шаг агента требует глубокого рассуждения.
Извлечение, форматирование, классификация, валидация и рутинный выбор инструментов часто могут выполняться с меньшими усилиями на рассуждение и с компактным структурированным выводом.
Оставляйте более высокий уровень рассуждения для задач:
Сложное планирование
Трудный кодинг
Синтез по нескольким документам
Амбигуозные решения
Восстановление после неудавшегося выполнения
Правило рассуждения: используйте минимально необходимый уровень рассуждения, который сохраняет долю принятых задач.
Сабагентам также нужны четкие границы. Давайте каждому воркеру:
Узкую задачу
Срез контекста под задачу
Разрешенный список инструментов
Бюджет токенов
Компактную схему вывода
Корневому агенту обычно нужны выводы, ID доказательств, уверенность и нерешенные вопросы — а не полный протокол воркера.
Правило для субагентов: параллелизируйте независимую работу, а не дублируйте контекст.
Распространенная ошибка: отправлять всю историю корневого агента каждому воркеру до назначения узкой задачи.
Which Optimization Should You Apply First?
Используйте телеметрию агента, чтобы выбрать первое вмешательство.
Нижеприведенные пороги — поводы для исследования, а не универсальные стандарты.
Observed signal
Start here
Context amplification is high
Сжимайте историю и выборочно извлекайте состояние
Tool output dominates the prompt
Фильтруйте поля и храните полные артефакты вне подсказки
Retry tax is high
Исправляйте валидацию, таймауты и повторные вызовы инструментов
Reasoning share is high
Снижайте усилия на рутинных шагах
Subagents repeat the same evidence
Сужайте области ответственности и срезы контекста
Cached input remains low
Стабилизируйте переиспользуемый префикс
Costs remain high after loop cleanup
Сравните маршруты с более дешевыми моделями
Безопасная последовательность внедрения:
Измерьте совокупный вход, удержание данных из инструментов, повторы и рассуждение.
Добавьте жесткие лимиты на шаги, инструменты, повторы и общее число токенов.
Для прод‑фолбэка следуйте руководству CometAPI по резервированию модели (https://apidoc.cometapi.com/guides/model-fallback-with-cometapi), чтобы переключать маршруты без повторения уже выполненных вызовов инструментов и без потери проверенного состояния.
Единая точка доступа упрощает сравнение моделей и внедрение фолбэка. Однако бюджеты токенов, сжатие, валидация, фильтрация инструментов, лимиты повторов и критерии приемки должны оставаться на уровне приложения.
FAQ
Why do AI agents use more tokens than chatbots?
Агенты делают несколько вызовов к модели и могут на каждом шаге пересылать предыдущие сообщения, результаты инструментов, инструкции и промежуточное состояние. Это приводит к многократной обработке раннего контекста.
Does prompt caching reduce context-window usage?
Нет. Кэширование промптов может снизить эффективную цену или латентность повторяющегося ввода, но кэшированные токены все равно остаются частью обрабатываемого контекста. Чтобы уменьшить размер подсказки, используйте сжатие, фильтрацию или выборочное извлечение.
When should an AI agent compact its context?
Сжимайте до того, как рост контекста начнет влиять на стоимость, латентность или доступное место для вывода. Убедитесь, что сжатое состояние сохраняет решения, ID источников, измененные файлы, открытые вопросы и ограничения по безопасности.
Do subagents reduce token costs?
Не автоматически. Они могут снизить время или улучшить покрытие независимых задач, но дублирование контекста и пересекающийся анализ часто увеличивают общий расход токенов.
What is the best metric for AI agent cost optimization?
Используйте стоимость на успешно выполненную задачу как основную метрику. Диагностируйте ее через совокупный вход, усиление контекста, удержание данных из инструментов, налог на повторы, долю рассуждения, латентность и время ручной проверки.