Choose your path
Блог Qwen3
Как использовать Qwen3.8-Flash API: Полное руководство для разработчиков
Узнайте, как использовать API Qwen3.8-Flash с CometAPI, включая Python, JavaScript, cURL, стриминг, режим размышления, мультимодальный ввод и структурированный вывод.
Как развернуть Qwen 3.8 Max локально: аппаратное обеспечение, vLLM, SGLang и руководство по квантизации
Ниже — практическая памятка по локальному развёртыванию Qwen 3.8 Max на открытых весах Qwen3.8-2.4T-A95B с учётом GPU-требований, FP8/FP4, vLLM, SGLang, 1M-контекста и prod-оптимизаций. 1) Аппаратные требования и форматы чисел - Архитектура/размер: - Если это dense ~95B: FP16 весов ≈ 2 байта/параметр → ~190 ГБ только на веса (без KV-кэша и оверхеда). Нужны минимум 4×80 ГБ (A100/H100) с тензорным параллелизмом. - Если это MoE A95B (модель с суммарно ~95B параметров, но активен поднабор экспертов): потребление VRAM ближе к «активным» параметрам. Уточняйте число активных экспертов/экспертных параметров — от этого зависит реальная планка VRAM. - FP8: - Полноценный FP8 (Transformer Engine/TE) требует Hopper (H100/H200) или новее. Выигрыш по памяти ≈ 2× против FP16. - Для vLLM/SGLang обычно доступно FP8 для вычислений и/или KV-кэша; поддержка FP8 именно для весов — зависит от сборки/бекэнда. - FP4/INT4: - На практике чаще используется weight-only 4-bit (AWQ/GPTQ, NF4/INT4). Экономит ~4× на весах, но активации и KV остаются FP16/FP8/FP32 по настройке. - KV-кэш и 1M контекст: - Память KV-кэша растёт линейно с длиной контекста: ~layers × heads × head_dim × 2 (K+V) × bytes × tokens. - Для больших моделей пер-токенный KV может составлять мегабайты. 1M токенов в полном KV нереалистичен в чистой VRAM (счёт на десятки/сотни ТБ). На практике используют: - Paged KV (выгрузка на CPU/NVMe), - квантованный KV (FP8/bf16), - скользящее окно/streaming attention, - chunked prefill и агрессивное освобождение «дальних» ключей/значений. 2) Получение весов - Скачайте репозиторий модели (HF/safetensors): - git lfs install - git clone https://huggingface.co/ORG/Qwen3.8-2.4T-A95B - Проверьте config.json: max_position_embeddings, rope_scaling, attention_impl. Для 1M желательно уже обученные или валидированные long-context веса. Если их нет — используйте RoPE-scaling (например, YaRN/NTK-aware) на свой риск качества. Пример rope_scaling (в config.json): { "rope_scaling": { "type": "yarn", "factor": 8, "original_max_position_embeddings": 131072 } } - factor подберите под целевой максимум (для 1M обычно нужен большой множитель); корректные параметры зависят от исходных настроек RoPE у Qwen 3.8. 3) Квантование весов (опционально) - AWQ (weight-only 4-bit): - Подготовьте отдельный репозиторий/папку с квантованной моделью AutoAWQ/GPTQ. Для vLLM/SGLang удобнее сразу указывать готовый quantized чекпоинт. - FP8 для весов: - Если поддерживается вашим стеком (Hopper + TE/встроенная поддержка в движке), используйте соответствующую сборку и флаги. В противном случае — используйте FP16/BF16 для весов и FP8 для KV. 4) Развёртывание с vLLM - Требования: CUDA 12.x, PyTorch 2.1+, FlashAttention/FlashInfer (входит в vLLM), драйверы NVIDIA актуальные. Для FP8 — Hopper. - Базовый сервер (FP16, шардирование по GPU): vllm serve /path/to/Qwen3.8-2.4T-A95B \ --tensor-parallel-size 4 \ --dtype float16 \ --max-model-len 1048576 \ --gpu-memory-utilization 0.90 \ --max-num-seqs 256 \ --enforce-eager \ --kv-cache-dtype fp8 \ --enable-chunked-prefill \ --host 0.0.0.0 --port 8000 Ключевые моменты: - --tensor-parallel-size: число GPU. - --max-model-len: целевая длина контекста (например, 1,048,576). - KV-кэш: используйте --kv-cache-dtype fp8 для экономии памяти; при необходимости настройте swap/offload. - Включайте chunked prefill для длинного ввода. - С AWQ (4-bit, weight-only): vllm serve /path/to/Qwen3.8-2.4T-A95B-AWQ \ --quantization awq \ --tensor-parallel-size 2 \ --dtype float16 \ --max-model-len 1048576 \ --gpu-memory-utilization 0.95 \ --kv-cache-dtype fp8 \ --enable-chunked-prefill Примечания: - Указывайте именно квантованный репозиторий. - Веса 4-bit, но активации/KV остаются FP16/FP8; производительность/качество проверьте на своих задачах. - FP8 для весов (если доступно в вашей сборке): - Используйте dtype/параметры TE согласно документации сборки vLLM+TE. Обязательно Hopper. Часто это билд-опция/переменные окружения. KV оставляйте fp8. - Длинный контекст: - Настройте rope_scaling в config.json (см. выше) или используйте override (если ваша версия vLLM поддерживает). - Рассмотрите windowed/streaming attention, чтобы удерживать в VRAM только «окно» недавних токенов; остальное — в NVMe/CPU либо отбрасывать. - Продакшен-настройки vLLM: - --gpu-memory-utilization 0.9–0.95, --max-num-seqs по целевому TPS, - включите PagedAttention v2 (по умолчанию в новых версиях), - при больших префиллах — --enable-chunked-prefill, - выставьте таймауты и лимиты на длину генерации, - используйте Prometheus-метрики vLLM для автоскейлинга. 5) Развёртывание с SGLang - Требования: CUDA 12.x, PyTorch 2.1+, FlashInfer, совместимые колёса SGLang. Для FP8 — Hopper. - Базовый запуск (FP16): python -m sglang.launch_server \ --model /path/to/Qwen3.8-2.4T-A95B \ --tp 4 \ --dtype float16 \ --max-model-len 1048576 \ --kv-cache-dtype fp8 \ --enable-chunked-prefill \ --host 0.0.0.0 --port 30000 - С AWQ (4-bit): python -m sglang.launch_server \ --model /path/to/Qwen3.8-2.4T-A95B-AWQ \ --quantization awq \ --tp 2 \ --dtype float16 \ --max-model-len 1048576 \ --kv-cache-dtype fp8 - Примечания: - Переопределяйте длину контекста через config.json (rope_scaling) у модели. - Включите speculative decoding (если доступно в версии SGLang) с лёгкой черновой моделью — даст значительный прирост TPS при длинном контексте. - SGLang хорош на многозапросной нагрузке (эффективный планировщик, FlashInfer). Тюньте размер батча префилла и decode-конкарренси. 6) 1M контекст на практике - Реально держать полный 1M KV для 95B в VRAM нельзя. Рабочие стратегии: - Prefill большими чанками с chunked prefill, далее — агрессивное окно (например, 8k–32k) для decode. - FP8 KV-кэш, CPU/NVMe offload, при необходимости — ограничение исторического KV на уровне фреймворка. - Алгоритмика: сжатие контекста, RAG, суммаризация, индексирование, многошаговые пайплайны вместо «сырого» 1M. 7) Оптимизация для продакшена - Параллелизм: - Tensor Parallel (TP) по GPU; при очень больших моделях — добавляйте Pipeline Parallel (если поддерживается сборкой). - Закрепляйте topology (NVLink/NVSwitch приоритетен для TP). - Память и кэш: - FP8 KV, paged KV, оффлоад на CPU/NVMe, ограниченное окно внимания. - Выделите достаточно системной RAM и быстрый NVMe (несколько ТБ на узел), настройте своп пространства у движка. - Планировщик и throughput: - Включите chunked prefill, настройте лимиты на max_num_seqs и concurrency под вашу задержку/TPS-цель. - Спекулятивная декодировка (черновая маленькая модель) для ускорения decode. - Квантование: - Начните с AWQ/GPTQ 4-bit для весов (минимум усилий, сильная экономия VRAM). - Для Hopper — рассматривайте FP8 (веса/активации) в поддерживаемой сборке, тщательно валидируйте качество. - Стабильность и мониторинг: - Health-checks, автоперезапуск, лимиты на длину/время запроса. - Метрики (GPU util, VRAM, P50/P95 latency, токены/с) → автоскейлинг. - Закрепление версий драйверов/CUDA/библиотек, реплицируемые образы контейнеров. - Тестирование качества: - Отдельные профили для long-context: проверяйте деградацию точности при RoPE-scaling. - A/B: FP16 vs FP8 KV; AWQ 4-bit vs FP16; выбирайте порог, приемлемый для бизнеса. 8) Быстрые ориентиры по конфигурациям - Минимум для FP16 (dense ~95B): 4×H100 80 ГБ (или 4–8×A100 80 ГБ) + быстрый NVMe для KV/офлоада. 1M только через окно/оффлоад. - FP8 (Hopper): 2×H100 80 ГБ для весов может быть достаточно при FP8 весах и FP8 KV, но всё равно потребуется оффлоад для длинного контекста. - AWQ 4-bit: 1×H100/A100 80 ГБ может уместить веса, но длинный контекст потребует оффлоад и/или окна; для стабильной нагрузки лучше 2×80 ГБ. 9) Проверка работоспособности - Сделайте короткий прогон с max_model_len = 8k–32k, затем поэтапно увеличивайте до 128k/256k/512k/1M, измеряя: - пиковое VRAM/CPU/NVMe потребление, - пропускную способность префилла/декода, - стабильность и качество ответов. Итого: берите готовые long-context конфиги у Qwen 3.8, включайте rope_scaling, используйте FP8 для KV и weight-only 4-bit/FP8 для весов по доступности «железа», разворачивайте модель во vLLM или SGLang с тензорным параллелизмом, chunked prefill и оффлоадом KV. Для 1M контекста опирайтесь на окно внимания и/или дисковый кэш; «полный» 1M в VRAM нецелесообразен.
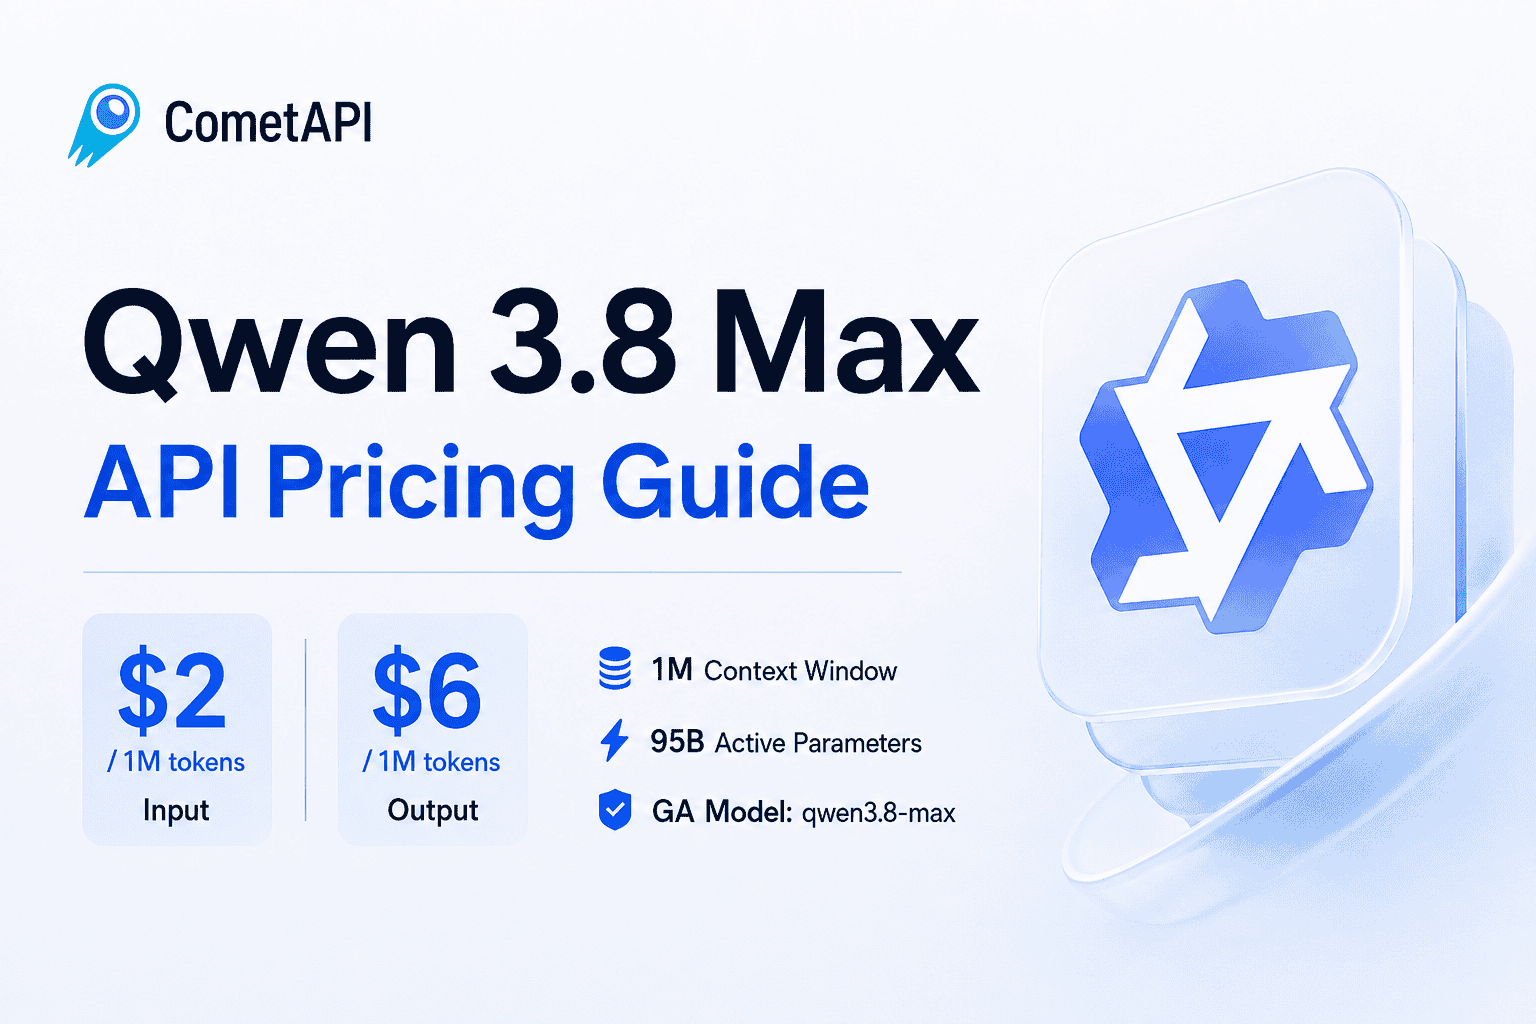
Цены API Qwen 3.8 Max: $2 за ввод, $6 за вывод, 1M контекста
Qwen 3.8 Max стоит $2/M на вход и $6/M на выход. Сравните плату за кэш, стоимость инструментов, реальные примеры, ограничения и рекомендации по миграции с Qwen 3.7.
Как использовать API Qwen 3.5
В канун Лунного Нового года (16–17 февраля 2026 года) Alibaba Group выпустила своё следующее поколение модели Qwen 3.5 — мультимодальную модель с агентными возможностями, ориентированную на то, что компания называет эпохой «агентного ИИ». Отраслевые публикации подчеркнули заявления о значительном повышении эффективности и снижении стоимости, а также о быстром подключении поддержки со стороны производителей аппаратного обеспечения и облачных провайдеров. CometAPI — вариант для разработчиков, которым нужен хостинговый доступ к API или совместимая с OpenAI интеграция, тогда как AMD объявила о поддержке GPU Day-0 для модели на своей линейке Instinct. ByteDance — один из основных внутренних конкурентов, выпустивший обновления в тот же праздничный период. OpenAI остаётся точкой отсчёта для сравнения по бенчмаркам и стилю интеграции.
Qwen-3.5 в Лунный Новый год — превзойдет ли он топовые модели с закрытым исходным кодом в 2026 году?
Новый Qwen3.5 от Alibaba — значительный шаг вперёд: он сокращает разрыв и в ряде агентных / мультимодальных сценариев заявляет паритет или преимущество над некоторыми передовыми закрытыми моделями по результатам множества публичных бенчмарков и внутренних тестов. Однако «превосходство» зависит от сценария: в агентном использовании инструментов, понимании мультимодальных документов/видео и стоимости одного инференса Qwen3.5, по сообщениям, крайне конкурентоспособен (и в некоторых диаграммах поставщиков — впереди). Практический вывод: Qwen3.5 выглядит реальным претендентом на переднем крае в начале 2026 года — для многих корпоративных агентных и мультимодальных сценариев он теперь жизнеспособен как основной вариант.
Как использовать Qwen3-max thinking
Qwen3-Max-Thinking от Alibaba — «мыслящий» вариант масштабного семейства Qwen3 — стал одной из главных новостей в сфере ИИ в этом году: флагман с числом параметров более триллиона, настроенный на глубокое рассуждение, работу с длинным контекстом и агентные рабочие процессы. Вкратце, это шаг поставщика к тому, чтобы дать приложениям более медленный и более отслеживаемый режим мышления «System‑2»: модель не просто отвечает — она может демонстрировать (и использовать) шаги, инструменты и промежуточные проверки контролируемым образом.

Alibaba AI представляет Qwen3-Max: модель Qwen с триллионом параметров и поддержкой CometAPI
Команда Qwen компании Alibaba выпустила Qwen3-Max-Preview (Instruct) — крупнейшую на сегодняшний день модель компании, содержащую более 1 триллиона параметров, — и сделала ее
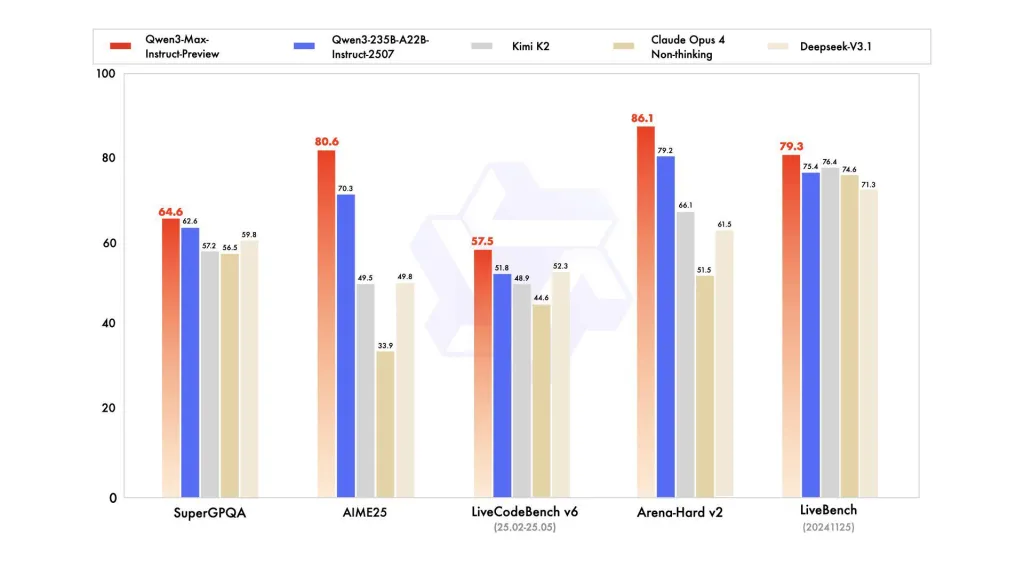
API Qwen3-Max-Preview
Qwen3-Max-Preview — это новейшая флагманская модель Alibaba в линейке Qwen3. Модель типа «микс экспертов» (MoE) с более чем триллионом параметров и сверхдлинным окном контекста токенов в 262 XNUMX, выпущенная в предварительной версии для корпоративного/облачного использования. Она ориентирована на *глубокие рассуждения, понимание длинных документов, кодирование и агентские рабочие процессы.