
Запуск Qwen3.8-Max локально теперь возможен, но выражение «Qwen 3.8 Max локально» требует важного уточнения. Хостинговый продукт Max от Alibaba и доступный для скачивания чекпойнт тесно связаны, но это не идентичные продукты.
Qwen впервые запустила управляемый сервис Max в начале августа 2026 года и выпустила Qwen3.8-2.4T-A95B как открытые веса 12 августа 2026 года. Именно этот чекпойнт вы фактически разворачиваете в своей инфраструктуре.
Это не обычный учебник «Ollama на игровом ПК». Не квантизированный чекпойнт — это Mixture-of-Experts модель с 2,4 трлн параметров, и текущий рецепт vLLM оценивает размер её весов в BF16 в 4,45 ТиБ. Даже ориентированные на продакшн варианты с 4-битной плавающей запятой всё ещё занимают примерно 1,3–1,5 ТиБ весов.
Ответ коротко: полноценный self-hosting класса Qwen 3.8 Max — это развёртывание в дата-центре. Практическая отправная точка для продакшна — FP4 чекпойнт на 8× B300 или 8× MI355X GPU; для H200 нужно больше GPU. Для обычной рабочей станции используйте Qwen3.8-27B.
Qwen 3.8 Max и открытая модель, которую вы фактически разворачиваете
Скачиваемый чекпойнт Qwen3.8-2.4T-A95B официально описывается как каузальная языковая модель с 2,4T параметров и около 95B активируемых параметров на токен. Управляемый сервис Max добавляет продуктовые возможности, которых нет в текущем открытом чекпойнте.
| Характеристика | Хостинговый сервис Qwen3.8-Max | Открытый чекпойнт Qwen3.8-2.4T-A95B |
|---|---|---|
| Всего параметров | 2.4T | 2.4T |
| Активных параметров | ~95B | ~95B |
| Архитектура | Разреженный MoE | Разреженный MoE |
| Ввод | Текст, изображение, видео | Текст |
| Контекст | 1M управляемого контекста | 262 144 нативно; расширяемо до ~1,01M |
| Поведение рассуждений | Управляемые/неуправляемые режимы | Требуются рассуждения; усилие настраивается |
| Встроенные инструменты | Доступны в управляемом сервисе | Приложение должно предоставлять инструменты |
| Самостоятельный хостинг | Управление весами не требуется | Да; открытый чекпойнт |
Хостинговый продукт предоставляет ввод текста, изображений и видео с контекстом 1 000 000 токенов. В отличие от него, открытый чекпойнт — только для текста и имеет нативный контекст в 262 144 токена. Эта разница важна, если ваше приложение зависит от мультимодального ввода или управляемых встроенных инструментов.
Архитектура и спецификации Qwen 3.8
CometAPI уже охватывает фон модели в What is Qwen3.8 Max, поэтому это руководство по развёртыванию фокусируется на деталях, влияющих на память, параллелизм и сервинг.
| Важная для развёртывания спецификация | Qwen3.8-2.4T-A95B |
|---|---|
| Всего / активных параметров | 2.4T / ~95B на токен |
| Слоистая структура | 92 слоя: 69 Gated DeltaNet + 23 full attention |
| Маршрутизация MoE | 512 маршрутизируемых экспертов; 10 маршрутизируемых + 1 общий активны |
| Heads в full-attention | 64 query / 4 key-value heads |
| Нативный контекст | 262 144 токена |
| Расширенный контекст | До примерно 1 010 000 токенов |
| Multi-Token Prediction | Поддерживается |
| Модальность открытого чекпойнта | Только текст |

Официальная гибридная архитектура Qwen, использованная в руководстве по развёртыванию SGLang Qwen3.8.
Не интерпретируйте «95B активных параметров» как объём памяти модели в 95B. Разреженная активация снижает вычисления на токен, но система сервинга всё равно должна иметь доступ ко всему набору весов экспертов.
Снимок бенчмарков Qwen 3.8 Max
Поскольку существующий обзор Qwen3.8 Max на CometAPI уже подробно обсуждает бенчмарки, эта статья использует только релевантное для развёртывания подмножество из официальной таблицы бенчмарков модель-карты Qwen.
| Бенчмарк | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (max) |
|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 74.5 | 88.8 |
| SWE-bench Pro | 67.7 | 60.6 | 64.6 |
| PaperBench | 93.0 | 64.8 | 90.5 |
| FrontierSWE | 73.5 | 40.7 | — |
| CoWorkBench | 74.8 | 64.6 | 71.5 |
| GPQA Diamond | 92.6 | 92.4 | 94.1 |
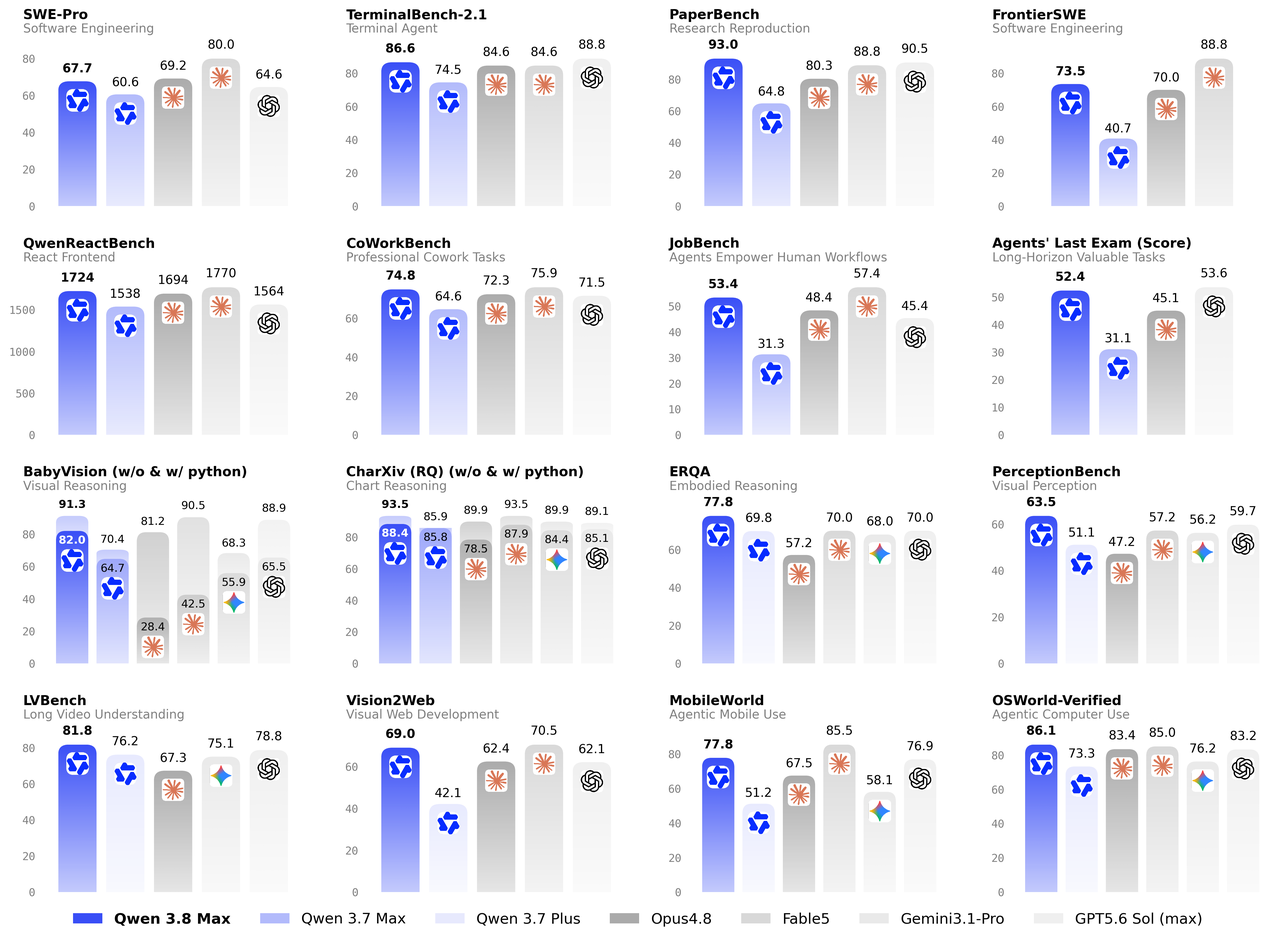
Официальная графика производительности Qwen3.8, опубликованная командой Qwen.
Наибольшие заявленные улучшения по сравнению с Qwen3.7-Max в этом подмножестве — PaperBench и FrontierSWE. Qwen3.8-Max также превосходит GPT-5.6 Sol в SWE-bench Pro и PaperBench, в то время как GPT-5.6 Sol остаётся впереди в Terminal Bench 2.1. Для решений о развёртывании относитесь к этим значениям как к контексту возможностей; приведённые ниже измерения по памяти и сквозной производительности более актуальны операционно.
Таблицы бенчмарков — это не универсальные рейтинги. Харнесс, таймауты, лимиты контекста, доступ к инструментам и квантизация могут менять результаты. Бенчмарките именно тот чекпойнт, точность, движок сервинга и распределение подсказок, которые планируете использовать.
Какое оборудование нужно Qwen3.8 для локального развёртывания?
Требования к GPU для Qwen3.8-2.4T-A95B
Это ключевой вопрос развёртывания. Текущий рецепт vLLM для Qwen3.8 публикует объёмы чекпойнта и реалистичные числа GPU с запасом по рантайму, что полезнее, чем оценка VRAM по числу параметров.
| Точность | Объём весов | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Наилучшее применение |
|---|---|---|---|---|---|
| BF16 | 4,45 ТиБ | 24 GPU | 24 GPU | 48 GPU | Максимальная достоверность/исследования |
| FP8 | 2,27 ТиБ | 16 GPU | 16 GPU | 32 GPU | Высокая достоверность в продакшне |
| MXFP4 | 1,45 ТиБ | — | 8 GPU | 16 GPU | Практичное развёртывание на AMD |
| NVFP4 W4A4 | 1,32 ТиБ | 8 GPU | — | 16 GPU | Практичное развёртывание на NVIDIA |
Для большинства организаций, которым действительно нужен self-hosted Qwen3.8, FP4 — практичная отправная точка. Выдающаяся конфигурация NVIDIA — NVFP4 W4A4 на 8× B300; соответствующий путь для AMD — MXFP4 на 8× MI355X.
Сервер с 8× H200 недостаточен для этих рекомендованных развертываний полного масштаба. Официальный рецепт оценивает H200 в 16 GPU для FP4, 32 для FP8 и 48 для BF16.
Требования к VRAM для Qwen3.8-27B
Qwen3.8-27B — практичная альтернатива уровня рабочей станции. Память под «сырые» веса составляет примерно 54 ГБ в BF16, 27 ГБ в FP8 и 13,5 ГБ при 4-битной точности. Накладные расходы рантайма и KV-кэш повышают фактические требования, особенно при длинных контекстах.
| Точность | Ориентир по памяти весов | Практические рекомендации по развёртыванию |
|---|---|---|
| BF16 | ~54 ГБ | Используйте GPU на 64–80 ГБ в зависимости от контекста и накладных расходов. |
| FP8 / INT8 | ~27 ГБ | GPU на 40–48 ГБ обеспечивает более практичный запас по рантайму. |
| 4-бит | ~13,5 ГБ | Потребительский GPU на 20–24 ГБ может быть достаточен при умеренных длинах контекста. |
Эти цифры — плановые оценки, выведенные из числа параметров. Подтвердите точный чекпойнт, формат квантизации, движок сервинга, длину контекста и настройки KV-кэша перед sizing аппаратного обеспечения для продакшна.
Можно ли запускать Qwen3.8 на потребительских GPU?
Полный Qwen3.8-2.4T-A95B непрактичен на обычных потребительских GPU, даже при агрессивной квантизации. Сообщество продемонстрировало агрессивно сжатую сборку UD-Q1_0 на 397 ГБ на четырёх системах DGX Spark, но это путь экстремальной квантизации, а не базовый вариант для сервинга, чувствительного к качеству.
Для рабочей станции или домашней лаборатории более подходящая модель — Qwen3.8-27B, открытые веса которой были выпущены 14 августа 2026 года. Эта модель на порядки проще в хостинге и является правильным выбором, если «локально» означает одну рабочую станцию, а не кластер GPU.
Прежде чем устанавливать Qwen 3.8 Max
Спланируйте инфраструктуру до выполнения команды установки. Вам понадобятся Linux, совместимый стек ускорителей, достаточно локального или общего хранилища для чекпойнта, высокоскоростные межсоединения GPU и — при跨узловой работе — сеть, спроектированная для распределённого инференса. Рецепт vLLM в настоящее время рекомендует vLLM nightly и Transformers 5.4.0 или новее.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
Как развернуть Qwen 3.8 в FP8 с vLLM
FP8 — разумный выбор, когда вы хотите чекпойнт, предоставленный Qwen, и можете позволить себе многоузловую инфраструктуру. Официальный чекпойнт — Qwen/Qwen3.8-2.4T-A95B-FP8.
Для двух узлов и 16 GPU класса B300 запустите головной узел:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
На рабочем узле используйте ту же топологию с другим рангом узла и без API-сервера:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Не копируйте пример с 16 GPU на серверы H200 без изменения топологии. Тот же вариант FP8 в текущем рецепте vLLM рассчитан на 32× H200.
Как запустить Qwen 3.8 на одном сервере с 8× B300
Для NVIDIA Blackwell наиболее практичная конфигурация полного масштаба — NVFP4. vLLM в настоящее время валидирует NVFP4 W4A4 с тензорным параллелизмом по восьми GPU B300.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Сборка Inferact NVFP4 — это квантизированный чекпойнт, а не оригинальный артефакт Qwen в BF16. Проверьте качество модели на своём наборе приемочных тестов, прежде чем считать её полноценной заменой BF16 или FP8.
Как развернуть Qwen 3.8 с SGLang
SGLang добавил поддержку Qwen3.8 в день релиза — 12 августа и особенно привлекателен для высокопроизводительного сервинга, префиксного кэширования, expert parallelism, speculative decoding и разнесения prefill/decode.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
SGLang сообщает 346 токенов/с на вывод при размере батча 1 на TP8 B300 с MTP и существенно более высокую суммарную пропускную способность в разнесённых схемах сервинга. Рассматривайте эти числа как показатели стека сервинга, а не бенчмарки качества модели.
Тест локального совместимого с OpenAI эндпойнта
И vLLM, и SGLang предоставляют совместимые с OpenAI API, что упрощает интеграцию приложений.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
Официальная модель-карта рекомендует temperature=1.0, top_p=0.95 и top_k=20 как базовые параметры сэмплирования. Для агентных задач оставляйте достаточно бюджета на вывод для рассуждений, а не задавайте max_tokens только под конечный видимый ответ.
Включение окна контекста 1M
Открытый чекпойнт Qwen3.8-2.4T-A95B имеет нативный контекст 262 144 токена и может быть расширен примерно до 1,01M. Рецепт vLLM документирует следующий шаблон:
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
Не делайте 1M значением по умолчанию только потому, что это поддерживается. Большие максимальные контексты резервируют больше ёмкости кэша и могут резко снизить конкуррентность. Устанавливайте --max-model-len под реальную нагрузку.
Как улучшить производительность инференса Qwen3.8?
Используйте MTP-3 для снижения задержки одного пользователя
Qwen3.8 включает Multi-Token Prediction. В опубликованных измерениях vLLM MTP-3 увеличивает скорость вывода на пользователя с 130 до 307 токенов/с для FP8 TP16 и с 133 до 304 токенов/с для NVFP4 TP8.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
Используйте fastsafetensors для ускорения старта
Для моделей терабайтного масштаба время старта имеет значение. В одном измерении vLLM время загрузки весов сократилось с 545 с до 306 с с fastsafetensors и ленивой загрузкой.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Используйте expert parallelism для увеличения конкуррентной пропускной способности
Для высокой конкуррентности Qwen3.8 выигрывает от схем с expert-parallel, поскольку у неё 512 маршрутизируемых экспертов. vLLM сообщает до 3 200 суммарных токенов/с на GPU для FP8 EP и до 4 300 суммарных токенов/с на GPU для оптимизированной конфигурации NVFP4 DEP16.
Настройте --max-model-len для баланса VRAM и конкуррентности
Устанавливайте значение --max-model-len по самой длинной последовательности, которая действительно нужна нагрузке. Большое значение резервирует больше ёмкости KV-кэша, увеличивает давление на память и может снизить число параллельных запросов, даже если веса модели уже помещаются.
Начните с репрезентативного продакшн-процентиля, а не с максимального рекламируемого контекста модели. Проведите нагрузочное тестирование выбранного лимита с той же точностью, паттерном батчей и движком сервинга, что в продакшне, и повышайте его только при реальной необходимости большего контекста.
Локальное развёртывание Qwen 3.8 Max vs. API
Открытые веса автоматически не делают локальный инференс экономичным. Правильное решение зависит от утилизации, требований по размещению данных, штата, целевых уровней доступности и от того, нужны ли вам на самом деле мультимодальные возможности управляемой модели.
| Измерение | Self-hosted Qwen3.8-2.4T-A95B | Qwen3.8-Max через CometAPI |
|---|---|---|
| Инфраструктура | Многогпу-сервер или кластер | Без GPU-инфраструктуры |
| Модальность | Текст | Текст, изображение, видео |
| Контекст | 262K нативно; ~1,01M расширяемо | Управляемый 1M |
| Контроль данных | Максимальный | Облачный API |
| Операции | Вы отвечаете за мониторинг, обновления и HA | Управляется провайдером |
| Лучшее применение | Размещение данных, устойчивая утилизация, своя инфраструктурная команда | Большинство продуктовых команд и переменные нагрузки |
Если у вас уже есть подходящие ускорители и стабильно высокая утилизация, self-hosting может быть оправдан. Если вы купили бы кластер только ради этой модели, Qwen3.8-Max на CometAPI обычно — путь с меньшим трением. Существующее руководство по API охватывает интеграцию с управляемым сервисом, а руководство по ценам — моделирование стоимости; поэтому эта статья остаётся сфокусированной на локальном развёртывании.
Типичные проблемы локального развёртывания Qwen 3.8
Сервер исчерпывает память GPU во время старта
Сначала уменьшите --max-model-len, если проблема в кэше. Если сами веса не помещаются, уменьшение контекста не решит корень проблемы; переходите на валидированный чекпойнт более низкой точности или добавляйте GPU.
Тензорный параллелизм не работает из-за недопустимого размера
У Qwen3.8 — 64 attention heads в слоях full-attention, поэтому vLLM требует, чтобы TP делил 64. Простые размеры TP: 1, 2, 4, 8, 16 и 32. Поэтому суммарной VRAM недостаточно для выбора топологии.
Сервер долго запускается
Загрузка от одного до нескольких терабайт весов плюс JIT ядер может занять минуты. Увеличьте VLLM_ENGINE_READY_TIMEOUT_S и проверяйте реальный эндпойнт инференса, а не полагайтесь на короткое окно старта.
Локальная модель не может обработать изображение
Это ожидаемо. Открытый чекпойнт Qwen3.8-2.4T-A95B — только для текста. Это ограничение специфично для Qwen3.8-2.4T-A95B. Qwen3.8-27B поддерживает визуальный ввод при загрузке его отдельных файлов vision projection.
Контекст 1M резко снижает пропускную способность
Уменьшите --max-model-len до самой длинной последовательности, которая действительно нужна вашей нагрузке. Наибольшее поддерживаемое окно контекста не обязательно лучший продакшн-настрой; выберите лимит контекста, который балансирует требования нагрузки, использование KV-кэша и конкуррентность.
Могут ли Ollama или LM Studio запустить Qwen 3.8 Max?
Экосистема может упаковывать сильно квантизированные веса Qwen3.8 для инференса в стиле llama.cpp, но это не следует путать с обычным десктопным рабочим процессом Ollama. Квантизированная сборка, занимающая сотни гигабайт, всё равно требует сотен гигабайт доступной памяти и связана со значительными компромиссами по качеству и производительности.
Для обычной локальной разработки правильная цель — Qwen3.8-27B. Полную модель 2,4T следует рассматривать как серверную/кластерную, даже когда экстремальные квант-сборки сообщества делают её технически запускаемой на необычном оборудовании.
Какой метод развёртывания выбрать?
Для NVIDIA Blackwell наиболее чистой отправной точкой полного масштаба является развёртывание NVFP4 на 8× B300. Для AMD соответствующая практичная конфигурация — 8× MI355X с MXFP4. Используйте FP8, когда вы отдаёте приоритет происхождению чекпойнта и качеству над размером инфраструктуры, и BF16 — только когда максимальная достоверность оправдывает требования к памяти на уровне нескольких стоек.
Для рабочей станции используйте Qwen3.8-27B. Для продуктовых команд, которым нужны возможности Max без эксплуатации GPU-кластера, используйте управляемую модель Qwen3.8-Max на CometAPI.
Заключение
Qwen3.8-Max пересёк важную границу со времени первоначального запуска API: семейство Qwen класса Max теперь имеет открытый чекпойнт 2,4T, который организации могут полностью эксплуатировать в своей инфраструктуре.
Но открытые веса — это не потребительское железо. Следы в 4,45 ТиБ для BF16, 2,27 ТиБ для FP8 и 1,3–1,5 ТиБ для FP4 делают Qwen3.8-2.4T-A95B одной из самых требовательных к инфраструктуре открытых моделей. Практический плюс в том, что vLLM и SGLang уже поддерживают эту архитектуру, а FP4 делает развёртывание на одном узле 8× B300 или 8× MI355X осуществимым.
Хостите самостоятельно, когда контроль над данными, устойчивая утилизация и владение инфраструктурой оправдывают кластер. В противном случае используйте управляемый Max API — или Qwen3.8-27B, если на самом деле вам нужна сильная модель Qwen на одной рабочей станции.