Solutions Choose your path
For individuals Build, learn, and create with simple usage-based access. For business Scale teams, billing, governance, and model workflows. More English 繁體中文 日本語 한국어 Français Deutsch Español Italiano Português Русский العربية ไทย Tiếng Việt Bahasa Indonesia Bahasa Melayu Türkçe Polski Nederlands Danish Norsk Қазақ اردو
เริ่มต้นฟรี เริ่มต้นฟรี
500+ AI Model API, All In One API.
Just In CometAPI © 2026 CometAPI · All rights reserved
Home Blog ทางเลือกที่ดีที่สุดแทน GPT-6 Astra API: ราคา, เบนช์มาร์ก, และกรณีการใช้งาน ai-comparisons / งานวิจัย CometAPI
ทางเลือกที่ดีที่สุดแทน GPT-6 Astra API: ราคา, เบนช์มาร์ก, และกรณีการใช้งาน ทางเลือกที่ดีที่สุดสำหรับ GPT-6 Astra API รวมถึง Claude Opus 5, Claude Fable 5.1, GPT-5.6 Sol, Gemini 3.8 Flash, Claude Sonnet 5 และ DeepSeek V4.1 Flash
Deon Goodwin ทีมวิจัยโมเดล AI และ API ทางเลือกที่ดีที่สุดสำหรับ GPT-6 Astra API รวมถึง Claude Opus 5, Claude Fable 5.1, GPT-5.6 Sol, Gemini 3.8 Flash, Claude Sonnet 5 และ DeepSeek V4.1 Flash
ใช้สรุปนี้เพื่อดูคำตอบอย่างรวดเร็ว แล้วอ่านคู่มือเพื่อดูบริบท ตัวอย่าง และรายละเอียดการใช้งาน
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_COMETAPI_KEY",
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-5-mini",
    messages=[{"role": "user", "content": "Build this workflow."}],
)

print(response.choices[0].message.content)TL;DR: ควรเลือกทางเลือกแทน GPT-6 Astra API รุ่นใด?
เลือกโมเดลให้เหมาะกับภาระงาน: Claude Opus 5 หากต้องการตัวแทนพรีเมียมที่ใกล้เคียงที่สุด, Claude Fable 5.1 สำหรับโจทย์ให้เหตุผลที่ยากและต่อเนื่อง, GPT-5.6 Sol เมื่อต้องการย้ายจาก OpenAI ด้วยแรงเสียดทานต่ำสุด, Claude Sonnet 5 สำหรับงานผลิตปริมาณมาก, Gemini 3.8 Flash สำหรับงานมัลติโหมดต้นทุนต่ำ และ DeepSeek V4.1 Flash เมื่อต้นทุนโทเคนคือข้อจำกัดหลัก
คงใช้ GPT-6 Astra ต่อไปสำหรับภาระงานที่ความสามารถด้านการใช้คอมพิวเตอร์ การดำเนินงานอัตโนมัติ การให้เหตุผลเชิงวิทยาศาสตร์ หรือความปลอดภัยไซเบอร์ที่แข็งแกร่งกว่าสามารถลดการลองใหม่และการแทรกแซงจากมนุษย์ได้อย่างเป็นรูปธรรม
ประเด็นสำคัญ: อะไรที่สำคัญเมื่อจะเปลี่ยนจาก GPT-6 Astra?
GPT-6 Astra แทนที่ได้ยากในงานเอเจนต์ที่แข็งแกร่งที่สุด ตารางเกณฑ์ชี้วัดอย่างเป็นทางการของ GPT-6 Astra บันทึก 57.9% บน Terminal-Bench 4.0, 97.6% บน FrontierMath Tier 4 และ 96.0% บน GPQA Diamond
Claude Opus 5 เป็นตัวเลือกตรงที่สมดุลที่สุดให้ทดสอบก่อน Anthropic ตั้งราคา Opus 5 ที่ $5/$25 ต่อ 1M โทเคนขาเข้า/ขาออก ครึ่งหนึ่งของอัตราโทเคนฐานของ Astra
เรียนรู้ต่อ
เชื่อมโยงบทความนี้กับการตัดสินใจถัดไป ดูทุกหัวข้อ เผยแพร่เมื่อ Sep 25, 2026 อัปเดตล่าสุด Sep 28, 2026 ตรวจสอบความชัดเจน การอ้างอิงแหล่งที่มา และคำศัพท์ API ปัจจุบันแล้ว
Claude Fable 5.1 ไม่ใช่ตัวเลือกประหยัด ราคา $10/$50 ขาเข้า/ขาออก เทียบเท่าอัตราพาดหัวของ Astra ขณะที่การประเมินบางรายการด้านความรู้และการให้เหตุผลระยะยาวโน้มเอียงไปทาง Fable 5.1
GPT-5.6 Sol เป็นการลดระดับที่ง่ายสุด มากกว่าการสลับแพลตฟอร์มจริง หน้าต่างบริบท 1.05M เอาต์พุตสูงสุด 128K และราคา $4/$20 ลดแรงเสียดทานในการย้ายสำหรับแอป OpenAI
DeepSeek V4 Flash อยู่ในชั้นต้นทุนที่ต่างออกไป อัตราช่วงพีคและนอกพีคอย่างเป็นทางการต่ำกว่าราคาของโมเดลพรีเมียมมาก แต่โทเคนถูกกว่าไม่ได้ยืนยันอัตราความสำเร็จของเอเจนต์เทียบเท่ากัน
เมตริกผลิตจริงที่ดีที่สุดมักเป็นต้นทุนต่อ “งานสำเร็จที่ถูกยอมรับ” รวมการลองใหม่ ความล้มเหลวของเครื่องมือ เวลาแฝง การใช้โทเคนเอาต์พุต และการแก้ไขโดยมนุษย์
GPT-6 Astra API คืออะไร? Astra ต่างจากแชตบอททั่วไปเพราะออกแบบมาสำหรับการทำงานยาวนาน เอกสารภาพรวมความสามารถอย่างเป็นทางการเน้น การใช้คอมพิวเตอร์และงานระดับมืออาชีพ ควบคู่กับวิศวกรรมซอฟต์แวร์ การท่องเว็บ วิทยาศาสตร์ ความปลอดภัยไซเบอร์ และการให้เหตุผลที่ซับซ้อน
รหัสโมเดล API gpt-6-astra ผู้ให้บริการ OpenAI หน้าต่างบริบท 1,050,000 tokens เอาต์พุตสูงสุด 128,000 tokens อินพุต Text, images เอาต์พุต Text ขอบเขตความรู้ April 30, 2026 ระดับการให้เหตุผล Low, medium, high, xhigh, max ราคาขาเข้ามาตรฐาน $10 / 1M tokens อินพุตแคช $1 / 1M tokens ราคาขาออกมาตรฐาน $50 / 1M tokens เกณฑ์บริบทยาว More than 272K input tokens
หมายเหตุการคิดราคาแบบบริบทยาว:
คำขอที่มีอินพุตเกิน 272K โทเคน
จะถูกปรับราคาใหม่ทั้งคำขอที่ $20/M ขาเข้า และ $75/M ขาออก ควรวางงบคำขอประเภทนี้แยกต่างหาก
เหตุผลที่หลายทีมมองหาทางเลือกอื่นแทน GPT-6 Astra Astra โดดเด่นที่สุดเมื่อความสามารถเพิ่มเติมช่วยกำจัดความพยายามที่ล้มเหลว ข้อผิดพลาดของเครื่องมือ การแทรกแซงด้วยมือ หรือการเรียกใช้โมเดลที่อ่อนกว่าซ้ำๆ ราคาพรีเมียมจึงยากจะคุ้มสำหรับการสรุป การดึงข้อมูล การจัดประเภท RAG ทั่วไป แชตธรรมดา และการสร้างโค้ดมาตรฐาน
ดังนั้นทีมจึงประเมินทางเลือกเพื่อ: ลดต้นทุน อยู่ในระบบนิเวศของผู้ให้บริการเดิม ปรับปรุงเศรษฐศาสตร์ของแคช เพิ่มการรองรับมัลติโหมด หรือใช้โมเดลที่เร็วกว่าเพื่อทราฟฟิกประจำ ขณะสงวน Astra ไว้สำหรับการยกระดับ
การเปรียบเทียบเกณฑ์ชี้วัดและข้อจำกัด
หมายเหตุหลักฐาน: ตารางใช้กรอบการเปรียบเทียบที่ OpenAI เผยแพร่ เพื่อวางหลายทางเลือกไว้ภายใต้การตั้งค่าร่วมกัน คะแนนที่ผู้ขายรายงานอาจเปลี่ยนได้ตามสแน็ปช็อตโมเดล พรอมต์ เครื่องมือ และระเบียบวิธีการประเมิน; ใช้เพื่อคัดสั้นรายชื่อ แล้วจึงตรวจยืนยันตัวท้าชิงรอบสุดท้ายบนงานผลิตที่เป็นตัวแทนจริง
Terminal-Bench 4.0 57.9% 37.3% 55.8% 52.6% 19.1% DeepSWE v1.1 74.1% 72.7% 67.4% 73.7% 73.8% FrontierCode 1.1 Extended 64.5% 60.6% 63.6% 63.6% 56.3% GPQA Diamond 96.0% 94.6% 93.7% 93.7% 95.3% FrontierMath Tier 4 97.6% 83.0% 87.8% 73.2% — Humanity’s Last Exam, with tools 57.2% — 65.0% 63.6% —
ผลลัพธ์แสดงให้เห็นว่าการเรียกโมเดลใดๆ ว่า “ตัวแทน Astra แบบสากล” นั้นทำให้เข้าใจผิด Astra นำหน้าชัดเจนในหลายการประเมินด้านเอเจนต์และวิทยาศาสตร์ ขณะที่ Fable 5.1 ทำได้ดีกว่าใน Humanity’s Last Exam และหลายทางเลือกยังคงไล่จี้กันใกล้มากบน DeepSWE
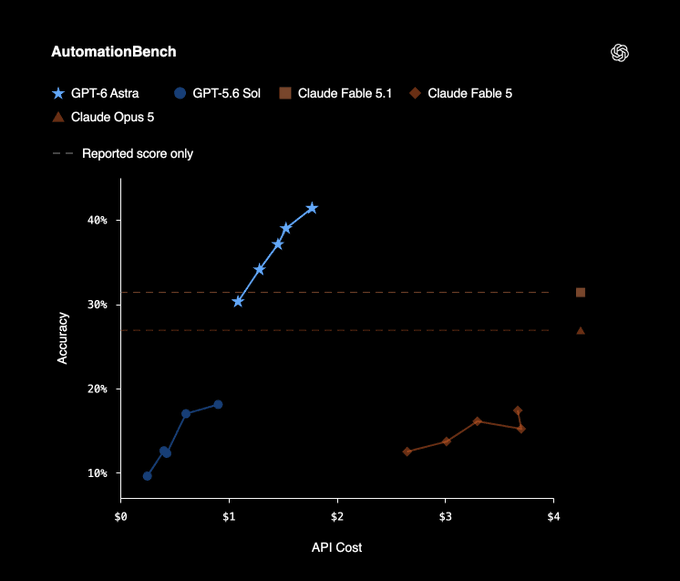
กราฟิกผลทดสอบ AutomationBench อย่างเป็นทางการของ OpenAI
ดัชนีเกณฑ์ชี้วัดสาธารณะยังสามารถเปลี่ยนได้เมื่อปรับระเบียบวิธีและสแน็ปช็อตโมเดล ใช้เพื่อคัดสั้น ไม่ใช่แทนการประเมินเฉพาะภาระงาน
ทางเลือกแทน GPT-6 Astra ไม่มีโมเดลเดียวที่แทน Astra ได้ครบทุกภาระงาน ตัวเลือกที่ใช้ได้จริงที่สุดขึ้นกับความสามารถที่ต้องการ ระบบนิเวศผู้ให้บริการที่ใช้อยู่ และต้นทุนของการรันที่ล้มเหลวหรือซ้ำซ้อน
Claude Opus 5 $5 / $25 1M ตัวแทนพรีเมียมโดยรวมที่ใกล้เคียงที่สุด Claude Fable 5.1 $10 / $50 1M การให้เหตุผลที่ยากและเอเจนต์ระยะยาว GPT-5.6 Sol $4 / $20 1.05M ย้ายจาก OpenAI ด้วยแรงเสียดทานต่ำสุด Claude Sonnet 5 $2 / $10 1M งานผลิตปริมาณมาก Gemini 3.8 Flash $0.75 / $3.75 แบบโปรโมชัน 1M งานมัลติโหมดและแบตช์ต้นทุนต่ำ DeepSeek V4.1 Flash $0.22–$0.44 / $0.66–$1.32 1M ต้นทุนโทเคนต่ำสุดและการประมวลผลปริมาณสูง
Claude Opus 5
เหตุผลที่ควรพิจารณา Claude Opus 5 คือทางเลือกแรกที่ควรทดสอบเมื่อผลิตภัณฑ์ต้องการประสิทธิภาพพรีเมียมด้านการให้เหตุผล การเขียนโค้ด หรือการทำงานระดับมืออาชีพ ที่มีราคาป้ายต่ำกว่า Astra
ราคา บริบท และแคช Anthropic ระบุราคา Claude Opus 5 ที่ $5/M ขาเข้า และ $25/M ขาออก พร้อมหน้าต่างบริบท 1M โทเคน ตรวจสอบเงื่อนไขแคชปัจจุบันก่อนทำงบผลิต
จุดเด่น แข่งขันได้ในการเขียนโค้ด การวิเคราะห์ การเขียนเชิงมืออาชีพ และเวิร์กโฟลว์เอเจนต์; ตารางเกณฑ์ชี้วัดที่อ้างถึงจัดวางมันไว้ใกล้ Astra บน DeepSWE และ FrontierCode
ข้อจำกัด ยังไม่สามารถชนะ Astra ได้อย่างสม่ำเสมอ Astra ยังคงแข็งแกร่งกว่าเมื่อการควบคุมคอมพิวเตอร์ การดำเนินงานอัตโนมัติขั้นสูง ความปลอดภัยไซเบอร์ หรือเครื่องมือแบบเนทีฟของ OpenAI เป็นแกนกลางของผลิตภัณฑ์
เหมาะสำหรับ / หลีกเลี่ยงเมื่อ เหมาะสำหรับ: เอเจนต์เขียนโค้ดพรีเมียม การวิเคราะห์ซับซ้อน และการเขียนเชิงมืออาชีพ หลีกเลี่ยงเมื่อ: เวิร์กโฟลว์พึ่งพาเครื่องมือเฉพาะของ Astra หรือความสามารถด้านการใช้คอมพิวเตอร์อย่างหนัก
Claude Fable 5.1
เหตุผลที่ควรพิจารณา Claude Fable 5.1 เป็นเรือธงคู่แข่งสำหรับการให้เหตุผลที่ยากที่สุด งานวิจัย การเขียนโค้ด และเอเจนต์ระยะยาว มากกว่าจะเป็นตัวแทนราคาถูก
ราคา บริบท และแคช อัตรา $10/M ขาเข้า และ $50/M ขาออก เทียบเท่าราคาพาดหัวของ Astra หน้าต่างบริบท 1M โทเคน และราคาอ่านแคช $0.25/M อาจปรับปรุงเศรษฐศาสตร์ได้เมื่อมีการใช้พรอมป์ตซ้ำบ่อย
จุดเด่น น่าสนใจเป็นพิเศษสำหรับการให้เหตุผลต่อเนื่องและเอเจนต์ที่พึ่งพาแคช; ในการเปรียบเทียบที่อ้างถึง มันนำหน้า Astra บน Humanity’s Last Exam พร้อมเครื่องมือ
ข้อจำกัด ไม่ลดอัตราโทเคนพาดหัว และ Astra ยังได้เปรียบบนเกณฑ์ชี้วัดเอเจนต์และวิทยาศาสตร์หลายรายการ รวมถึงเครื่องมือแบบเนทีฟของ OpenAI
เหมาะสำหรับ / หลีกเลี่ยงเมื่อ เหมาะสำหรับ: คุณภาพการให้เหตุผลสูงสุดและเวิร์กโฟลว์บริบทยาวที่ใช้ซ้ำ หลีกเลี่ยงเมื่อ: เป้าหมายหลักคือการลดราคามาตรฐานของโทเคนอย่างมาก
GPT-5.6 Sol
เหตุผลที่ควรพิจารณา GPT-5.6 Sol มอบการย้ายที่แรงเสียดทานต่ำสุดสำหรับแอปที่สร้างบนพฤติกรรมและเครื่องมือที่เข้ากันได้กับ OpenAI อยู่แล้ว
ราคา บริบท และแคช ข้อกำหนดที่อ้างถึงระบุราคา $4/M ขาเข้า และ $20/M ขาออก หน้าต่างบริบท 1.05M โทเคน และเอาต์พุตสูงสุด 128K ตรวจสอบเงื่อนไขอินพุตแคชปัจจุบันก่อนทำงบสุดท้าย
จุดเด่น ยังคงใกล้เคียงกับ Astra บน DeepSWE และ GPQA Diamond ขณะมีต้นทุนต่ำกว่ามากภายใต้อัตรามาตรฐานบริบทสั้น
ข้อจำกัด ช่องว่างขยายบนงานที่แทนด้วย Terminal-Bench และ FrontierMath ดังนั้นการประหยัดอาจหายไปถ้าการทำงานสำเร็จที่อ่อนลงก่อให้เกิดการลองใหม่หรือการซ่อมด้วยมือ
เหมาะสำหรับ / หลีกเลี่ยงเมื่อ เหมาะสำหรับ: แอป OpenAI ที่ใช้อยู่และภาระงานทั่วไปที่ไม่ต้องการความสามารถเอเจนต์ที่แข็งแกร่งที่สุดของ Astra หลีกเลี่ยงเมื่อ: ภาระงานได้ประโยชน์ซ้ำๆ จากความได้เปรียบขนาดใหญ่ของ Astra บนเกณฑ์ชี้วัด
Claude Sonnet 5
เหตุผลที่ควรพิจารณา Claude Sonnet 5 เป็นค่าเริ่มต้นของงานผลิตที่ปฏิบัติได้สำหรับงานความรู้ที่มั่นคง ทำซ้ำได้ โดยไม่ต้องใช้เรือธงแนวหน้าทุกคำขอ
ราคา บริบท และแคช อัตราถาวรที่อ้างถึงคือ $2/M ขาเข้า และ $10/M ขาออก พร้อมหน้าต่างบริบท 1M โทเคน ยืนยันเงื่อนไขแคชปัจจุบันสำหรับการปรับใช้ที่ใช้พรอมป์ตซ้ำหนัก
จุดเด่น เหมาะกับการจัดประเภททิกเก็ต การดึงข้อมูลเอกสาร RAG มาตรฐาน การแปลงคอนเทนต์ การอธิบายโค้ด การเรียกฟังก์ชันประจำ และการสร้างแบบมีโครงสร้าง
ข้อจำกัด ไม่สามารถทดแทน Astra ได้อย่างน่าเชื่อถือในทุกปัญหาการให้เหตุผลระยะยาวหรือแนวหน้า
เหมาะสำหรับ / หลีกเลี่ยงเมื่อ เหมาะสำหรับ: ทราฟฟิกผลิตปริมาณมากและระบบอัตโนมัติทางธุรกิจประจำ หลีกเลี่ยงเมื่อ: ความล้มเหลวบนงานเอเจนต์ที่ยากมีค่าใช้จ่ายสูงกว่าพรีเมียมของเรือธง
Gemini 3.8 Flash
เหตุผลที่ควรพิจารณา Gemini 3.8 Flash ผสานอินพุตมัลติโหมด บริบทใหญ่ และต้นทุน API แบบโฮสต์ต่ำ สำหรับเอกสาร สื่อ การเขียนโค้ด และสายงานแบบแบตช์
ราคา บริบท และแคช อัตราเปิดตัวที่อ้างถึงคือ $0.75/M ขาเข้า และ $3.75/M ขาออก ถึงวันที่ 31 ธันวาคม 2026 พร้อมหน้าต่างบริบท 1M โทเคน และการทำแคชแบบส่วนลดในช่วงโปรโมชัน
จุดเด่น เหมาะกับการดึงข้อมูลมัลติโหมด PDF เสียง วิดีโอ รูปภาพ คอลเลกชันเอกสารใหญ่ การวิเคราะห์แบบแบตช์ และงานเขียนโค้ดที่อ่อนไหวต่อราคา
ข้อจำกัด ราคาช่วงโปรโมชันมีระยะเวลา และงานเอเจนต์อัตโนมัติที่ยากที่สุดหรือการใช้คอมพิวเตอร์ยังต้องตรวจยืนยันเฉพาะภาระงานเทียบกับ Astra
เหมาะสำหรับ / หลีกเลี่ยงเมื่อ เหมาะสำหรับ: มัลติโหมดต้นทุนต่ำและการประมวลผลแบบแบตช์ปริมาณสูง หลีกเลี่ยงเมื่อ: แอปต้องการการดำเนินงานอัตโนมัติที่แข็งแกร่งที่สุดโดยไม่คำนึงถึงต้นทุนโทเคน
DeepSeek V4.1 Flash
เหตุผลที่ควรพิจารณา DeepSeek V4.1 Flash คือตัวเลือกเน้นต้นทุนสำหรับการให้เหตุผล เขียนโค้ด สรุป ดึงข้อมูล จัดประเภท และประมวลผลออฟไลน์ที่มีอัตราทะลุผ่านสูง
ราคา บริบท และแคช ตารางพีค/นอกพีคที่อ้างถึงระบุอินพุตแคชฮิตที่ $0.007–$0.014/M อินพุตแคชมิสที่ $0.22–$0.44/M และเอาต์พุตที่ $0.66–$1.32/M พร้อมหน้าต่างบริบท 1M โทเคน ตรวจหน้าเพจราคาปัจจุบันของ V4.1 ก่อนเผยแพร่
จุดเด่น น่าสนใจเมื่อราคาต่อโทเคนครองเกม และแอปสามารถใช้การรูตติ้ง การตรวจสอบความถูกต้อง หรือการตรวจคุณภาพแบบออฟไลน์เพื่อจัดการความแปรปรวน
ข้อจำกัด โทเคนที่ถูกกว่ามากไม่ได้ยืนยันความสำเร็จงานอัตโนมัติที่เทียบเท่า ต้องวัดความน่าเชื่อถือ พฤติกรรมเครื่องมือ เวลาแฝง และอัตราการยอมรับบนภาระงานเป้าหมาย
เหมาะสำหรับ / หลีกเลี่ยงเมื่อ เหมาะสำหรับ: การประมวลผลขนาดใหญ่ที่อ่อนไหวต่อต้นทุนพร้อมการตรวจความถูกต้อง หลีกเลี่ยงเมื่อ: งานอัตโนมัติที่มีมูลค่าสูงล้มเหลวครั้งเดียวมีต้นทุนสูงกว่าการประหยัดโทเคน
GPT-6 Astra เทียบทางเลือก: โมเดลไหนชนะในแต่ละหมวด? เมื่อพิจารณาราคา สถาปัตยกรรม บริบท และหลักฐานเกณฑ์ชี้วัดร่วมกัน จะได้ตารางตัดสินใจที่มีประโยชน์กว่าการจัดอันดับจากหนึ่งถึงหก
ทางเลือกโดยรวมแทน Astra Claude Opus 5 คุณภาพใกล้แนวหน้าพร้อมอัตราราคาครึ่งหนึ่งของ Astra การให้เหตุผลสูงสุด Claude Fable 5.1 การให้เหตุผลระดับเรือธงและสมรรถนะระยะยาวแข็งแกร่ง อยู่ในระบบ OpenAI เดิม GPT-5.6 Sol ระบบนิเวศ API ใกล้เคียงพร้อมราคาต่อโทเคนลดลง ~60% งานผลิตปริมาณมาก Claude Sonnet 5 คุณภาพแข็งแกร่งที่ $2/$10 ราคา/ประสิทธิภาพมัลติโหมด Gemini 3.8 Flash บริบท 1M บวกกับราคาเปิดตัวปี 2026 ที่ต่ำมาก ต้นทุน API ต่ำสุด DeepSeek V4.1 Flash ขาเข้า $0.22–$0.44 และขาออก $0.66–$1.32 เอเจนต์ที่ใช้คอมพิวเตอร์อย่างหนัก GPT-6 Astra หนึ่งในจุดต่างที่ชัดเจนที่สุดของ Astra เวิร์กโฟลว์วิทยาศาสตร์และคณิตศาสตร์ยาก GPT-6 Astra ผลลัพธ์ FrontierMath และเอเจนต์วิทยาศาสตร์แข็งแกร่งมาก เอเจนต์ยาวที่พึ่งพาแคช Claude Fable 5.1 อ่านแคช $0.25/M
ผลลัพธ์สำคัญที่สุดคือ GPT-6 Astra ยังชนะในบางหมวด บทความทางเลือกไม่ควรสื่อว่าโมเดลที่ถูกกว่าจะแทนที่มันได้อย่างสากล Astra จะแพงเมื่อใช้ทั่วทั้งระบบ; แต่มันยังคุ้มค่าได้เมื่ออัตราการทำงานสำเร็จที่สูงกว่าแทนที่การพยายามด้วยโมเดลที่อ่อนกว่าหลายครั้ง
คุณจะประหยัดได้จริงเท่าไรหากแทนที่ GPT-6 Astra API? พิจารณาภาระงานที่ใช้โทเคนขาเข้าแบบไม่แคช 1 ล้าน และโทเคนขาออก 200,000 โดยไม่รวมส่วนลดแคช ค่าธรรมเนียมเครื่องมือ การลองใหม่ ราคาแบตช์ และค่าบริบทยาว:
GPT-6 Astra $20.00 Claude Fable 5.1 $20.00 Claude Opus 5 $10.00 GPT-5.6 Sol $8.00 Claude Sonnet 5 $4.00 Gemini 3.8 Flash promotional rate $1.50 DeepSeek V4.1 Flash off-peak $0.35
total_cost =
(input_tokens / 1,000,000 * input_rate)
+
(output_tokens / 1,000,000 * output_rate)
ตัวอย่างง่ายๆ นี้ยังชี้ให้เห็นว่าทำไมราคาโทเคนจึงไม่ใช่เมตริกเดียว หากคำขอ Astra ราคา $20 สำเร็จครั้งเดียว ในขณะที่โมเดล $4 ต้องพยายามหกครั้ง มีการลองเครื่องมือซ้ำ และต้องซ่อมโดยมนุษย์ Astra กลับถูกกว่าจริง
cost_per_accepted_task =
total_model_and_tool_cost
/
number_of_tasks_accepted_without_rework
ติดตามตัวเลขนั้นควบคู่กับเวลาแฝง ความสำเร็จของงาน อัตราการลองใหม่ ข้อผิดพลาดในการเรียกเครื่องมือ และอัตราการยกระดับไปหามนุษย์
ประโยชน์เชิงปฏิบัติของเลเยอร์ API หลายโมเดลคือการประเมินไม่จำเป็นต้องกลายเป็นโปรเจ็กต์อินทิเกรตผู้ให้บริการ CometAPI มี GPT-6 Astra API , GPT-5.6, Claude Fable 5.1, Claude Sonnet 5, Gemini 3.8 Flash และ DeepSeek V4.1 Flash ในแค็ตตาล็อกเดียว
ด้วยไคลเอนต์ที่เข้ากันได้กับ OpenAI สามารถตั้งค่าโมเดลให้ปรับเปลี่ยนได้แทนการฮาร์ดโค้ด:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Review this migration plan and identify the three highest-risk assumptions.",
        }
    ],
)

print(response.choices[0].message.content)
คุณสามารถรันชุดการประเมินเดิมซ้ำได้ด้วยรหัสโมเดลเช่น:
gpt-6-astra
gpt-5.6
claude-fable-5-1
claude-sonnet-5
gemini-3.8-flash
deepseek-v4-flash
วิธีนี้มักให้ข้อมูลมากกว่าการเลือกทางเลือกจากกระดานผู้นำเกณฑ์ชี้วัดเพียงอย่างเดียว นำพรอมป์ตผลิตที่เป็นตัวแทน 100–500 รายการมารันและบันทึกความสำเร็จของงาน การยอมรับโดยมนุษย์ การลองใหม่ ข้อผิดพลาดเครื่องมือ จำนวนโทเคนรวม เวลาแฝง และต้นทุน API รวม
ควรแทนที่ GPT-6 Astra ด้วยโมเดลเดียวหรือใช้การจัดเส้นทางโมเดล? สำหรับหลายแอป การแทนที่ Astra ด้วยโมเดลเดียวแบบสากลเป็นการปรับให้เหมาะสมที่ผิด โครงสร้างที่มีประสิทธิภาพมากกว่าคือ:
ทราฟฟิกประจำ → Claude Sonnet 5, Gemini 3.8 Flash หรือ DeepSeek V4.1 Flash
การให้เหตุผลที่ยาก → Claude Opus 5 หรือ GPT-5.6 Sol
งานระยะยาวที่ยากมาก → Claude Fable 5.1 หรือ GPT-6 Astra
เวิร์กโฟลว์เอเจนต์ที่ใช้คอมพิวเตอร์หนักหรือเฉพาะของ Astra → GPT-6 Astra
แนวทางนี้ทำให้ Astra เป็นโมเดลสำหรับการยกระดับแทนการเป็นค่าเริ่มต้น หากมีเพียง 10% ของคำขอที่ต้องการสมรรถนะเอเจนต์แนวหน้าจริงๆ การส่งทราฟฟิก 100% ผ่าน Astra เท่ากับจ่ายราคาพรีเมียมให้กับอีก 90% ที่ไม่จำเป็น
ควรเลือกทางเลือก GPT-6 Astra API ตัวไหน? เลือก Claude Opus 5 หากต้องการสมดุลคุณภาพ/ราคาโดยรวมที่ใกล้เคียงที่สุด
เลือก Claude Fable 5.1 หากความสามารถการให้เหตุผลสูงสุดสำคัญกว่าการลดอัตราโทเคนพาดหัว
เลือก GPT-5.6 Sol หากใช้งาน OpenAI อยู่แล้วและต้องการเปลี่ยนแปลงการอินทิเกรตให้น้อยที่สุด
เลือก Claude Sonnet 5 หากทราฟฟิกผลิตส่วนใหญ่เป็นงานความรู้ที่ดีพอแต่ธรรมดา
เลือก Gemini 3.8 Flash หากมัลติโหมด สเกล และต้นทุน API แบบโฮสต์ต่ำมีความสำคัญ
เลือก DeepSeek V4.1 Flash หากต้นทุนโทเคนครองเกมและภาระงานของคุณทนต่อการประเมิน/ตรวจความถูกต้องได้มากขึ้น
และเลือก GPT-6 Astra เอง เมื่อแอปของคุณได้ประโยชน์จริงจากความสามารถในการใช้คอมพิวเตอร์ งานซอฟต์แวร์อัตโนมัติที่ยาก การให้เหตุผลเชิงวิทยาศาสตร์ หรือความสามารถเอเจนต์อื่นๆ
ความผิดพลาดหลักไม่ใช่การ “เลือกโมเดลแนวหน้าผิดตัว” แต่คือการจ่ายราคาของโมเดลแนวหน้าสำหรับคำขอที่ไม่เคยต้องการโมเดลแนวหน้าเลยตั้งแต่แรก
คำถามที่พบบ่อย ทางเลือกโดยรวมที่ดีที่สุดแทน GPT-6 Astra API คืออะไร?
Claude Opus 5 เป็นหนึ่งในตัวแทนวัตถุประสงค์กว้างที่แข็งแกร่ง ให้หน้าต่างบริบท 1M ความสามารถเอเจนต์และการเขียนโค้ดที่แข็งแรง และราคาป้าย $5/$25 — ครึ่งหนึ่งของอัตรามาตรฐานของ Astra
ทางเลือกที่ถูกที่สุดของ GPT-6 Astra คืออะไร?
ในบรรดาโมเดลที่ครอบคลุมที่นี่ DeepSeek V4.1 Flash มีราคาต่อโทเคนจากผู้ให้บริการต่ำสุด อัตรานอกพีคปัจจุบันคือ $0.22/M อินพุตแบบไม่แคช และ $0.66/M เอาต์พุต อย่างไรก็ตาม ไม่ควรสันนิษฐานว่าจะทำงานอัตโนมัติสำเร็จเทียบเท่า Astra เพียงเพราะราคาถูกกว่า
Claude Fable 5.1 ดีกว่า GPT-6 Astra หรือไม่?
ไม่มีโมเดลใดชนะทุกภาระงาน การเปรียบเทียบของ OpenAI ให้ความได้เปรียบสำคัญกับ Astra บน FrontierMath Tier 4 และ Terminal-Bench 4.0 ขณะที่ Fable 5.1 ได้คะแนนสูงกว่าใน Humanity’s Last Exam พร้อมเครื่องมือ
GPT-5.6 Sol ยังคุ้มใช้หลังมี GPT-6 Astra ไหม?
ใช่ ราคา API มาตรฐาน $4/$20 ต่ำกว่า Astra $10/$50 อย่างมาก ในขณะที่ยังคงหน้าต่างบริบท 1.05M จึงอาจเป็นค่าเริ่มต้นที่ดีกว่าสำหรับภาระงานที่ความได้เปรียบของ Astra ไม่ได้ปรับปรุงอัตรางานสำเร็จอย่างมีนัยสำคัญ
Gemini 3.8 Flash ดีพอจะแทน GPT-6 Astra หรือไม่?
สำหรับงานเขียนโค้ดบางประเภท มัลติโหมด เอกสาร และการประมวลผลแบบแบตช์ ใช่ มันถูกกว่ามากและมีหน้าต่างบริบท 1M แต่สำหรับเอเจนต์อัตโนมัติที่ยากที่สุดและการใช้คอมพิวเตอร์ Astra ยังเป็นตัวเลือกที่แข็งแกร่งกว่า
GPT-6 Astra มีข้อเสียด้านราคาเมื่อใช้พรอมป์ตยาวมากหรือไม่?
มี OpenAI ใช้อัตราราคาที่สูงขึ้นเมื่ออินพุตเกิน 272K โทเคน ดังนั้นคำขอบริบทยาวควรถูกวางงบแยกต่างหาก
ควรเทียบโมเดลด้วยราคาโทเคนหรือคะแนนเกณฑ์ชี้วัด?
ใช้ทั้งสองอย่างเพื่อคัดกรองเท่านั้น เมตริกที่สำคัญที่สุดในการผลิตมักเป็นต้นทุนต่อ “งานสำเร็จที่ถูกยอมรับ” รวมโทเคนให้เหตุผล การลองใหม่ การเรียกเครื่องมือ เวลาแฝง และการแก้ไขโดยมนุษย์
สามารถใช้ทางเลือกหลายตัวของ GPT-6 Astra ในแอปเดียวกันได้ไหม?
ได้ ในหลายแอป การจัดเส้นทางโมเดลดีกว่าการมอบทุกคำขอให้โมเดลเดียว โมเดลต้นทุนต่ำสามารถจัดการคำขอประจำ ขณะที่โมเดลที่แข็งแกร่งกว่าจะรับงานที่ยากขึ้นตามลำดับการยกระดับ