GPT-5.2 API คืออะไร
GPT-5.2 API เหมือนกับ GPT-5.2 Thinking ใน ChatGPT. GPT-5.2 Thinking คือรุ่นระดับกลางในตระกูล GPT-5.2 ของ OpenAI ที่ออกแบบมาเพื่อการทำงาน เชิงลึก: การให้เหตุผลหลายขั้นตอน การสรุปเอกสารยาว การสร้างโค้ดคุณภาพ และงานความรู้เชิงวิชาชีพที่ให้ความสำคัญกับความแม่นยำและโครงสร้างที่นำไปใช้ได้มากกว่าความเร็วดิบ ใน API จะเปิดให้ใช้ผ่านโมเดล gpt-5.2 (Responses API / Chat Completions) และอยู่ระหว่างรุ่น Instant ที่หน่วงต่ำ กับรุ่น Pro ที่คุณภาพสูงกว่าแต่มีค่าใช้จ่ายสูงกว่า
คุณสมบัติหลัก
- บริบทยาวมากและการบีบอัด: หน้าต่างใช้งานได้ 400K และเครื่องมือบีบอัดเพื่อจัดการความเกี่ยวข้องตลอดบทสนทนาและเอกสารที่ยาว
- ปรับระดับความพยายามในการให้เหตุผลได้:
none | medium | high | xhigh(xhigh เปิดใช้การประมวลผลภายในสูงสุดสำหรับการให้เหตุผลที่ยาก) โดยxhighมีให้ในรุ่น Thinking/Pro - รองรับเครื่องมือและฟังก์ชันที่แข็งแกร่งขึ้น: การเรียกใช้เครื่องมือระดับหนึ่ง ไวยากรณ์ (CFG/Lark) เพื่อจำกัดผลลัพธ์เชิงโครงสร้าง และพฤติกรรมเชิงตัวแทนที่ปรับปรุงให้ทำให้งานอัตโนมัติหลายขั้นตอนที่ซับซ้อนง่ายขึ้น
- ความเข้าใจแบบมัลติโมดัล: การทำความเข้าใจภาพ+ข้อความที่ลึกขึ้นและการผสานเข้ากับงานหลายขั้นตอน
- การปรับปรุงด้านความปลอดภัย / การจัดการเนื้อหาละเอียดอ่อน: มาตรการเฉพาะเพื่อลดการตอบสนองที่ไม่พึงประสงค์ในประเด็นอย่างการทำร้ายตนเองและบริบทที่ละเอียดอ่อนอื่น ๆ
ความสามารถทางเทคนิคและสเปค (มุมมองนักพัฒนา)
- จุดเชื่อมต่อ API และรหัสโมเดล:
gpt-5.2สำหรับ Thinking (Responses API),gpt-5.2-chat-latestสำหรับเวิร์กโฟลว์ chat/instant และgpt-5.2-proสำหรับระดับ Pro; ใช้งานได้ผ่าน Responses API และ Chat Completions ตามที่ระบุ - โทเค็นสำหรับการให้เหตุผลและการจัดการความพยายาม: API รองรับพารามิเตอร์แบบชัดเจนเพื่อจัดสรรการประมวลผล (reasoning effort) ต่อคำขอ; ความพยายามที่สูงขึ้นเพิ่มเวลาแฝงและต้นทุน แต่ช่วยปรับปรุงคุณภาพผลลัพธ์สำหรับงานที่ซับซ้อน
- เครื่องมือเอาต์พุตเชิงโครงสร้าง: รองรับไวยากรณ์ (Lark / CFG) เพื่อจำกัดผลลัพธ์ของโมเดลให้เป็น DSL หรือไวยากรณ์ที่แม่นยำ (มีประโยชน์สำหรับ SQL, JSON, การสร้าง DSL)
- การเรียกใช้เครื่องมือแบบขนานและการประสานเชิงตัวแทน: ความเป็นขนานที่ดีขึ้นและการจัดการเครื่องมือที่เป็นระเบียบลดความจำเป็นในการใช้ system prompts ที่ซับซ้อนและโครงร่างหลายตัวแทน
ผลการทดสอบเชิงมาตรฐานและข้อมูลประกอบ
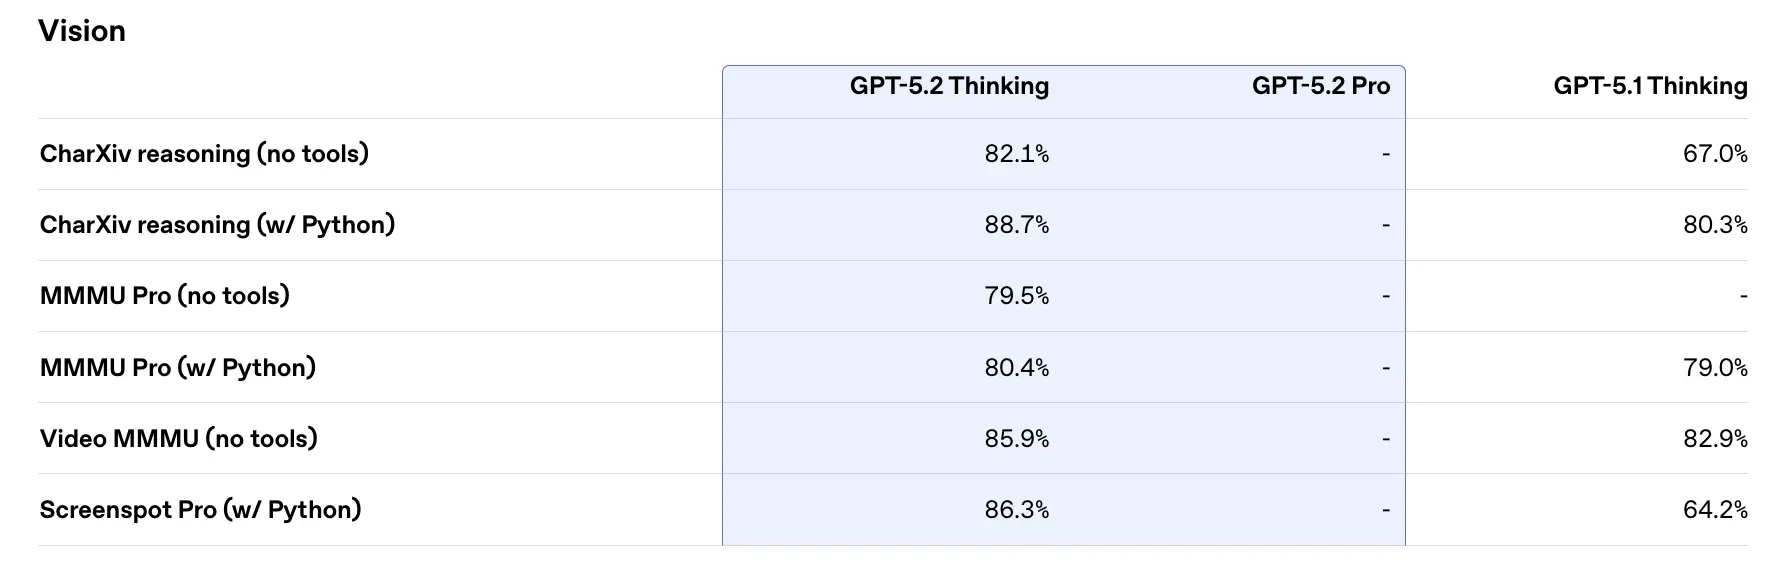
OpenAI เผยแพร่ผลการทดสอบเชิงมาตรฐานทั้งภายในและภายนอกสำหรับ GPT-5.2 โดยสรุปประเด็นเด่นบางส่วน (ตัวเลขจากรายงานของ OpenAI):
- GDPval (44 อาชีพ งานความรู้) — GPT-5.2 Thinking “เอาชนะหรือเทียบชั้นมืออาชีพชั้นนำในอุตสาหกรรมใน 70.9% ของการเปรียบเทียบ”; OpenAI รายงานว่าผลลัพธ์ถูกผลิตด้วย ความเร็วมากกว่า 11× และ ต้นทุนน้อยกว่า 1% เมื่อเทียบกับผู้เชี่ยวชาญในงาน GDPval ของพวกเขา (ประมาณการความเร็วและต้นทุนอิงข้อมูลในอดีต) งานเหล่านี้รวมถึงโมเดลสเปรดชีต งานนำเสนอ และวิดีโอสั้น
- SWE-Bench Pro (coding) — GPT-5.2 Thinking ทำได้ ≈55.6% บน SWE-Bench Pro และ ~80% บน SWE-Bench Verified (Python เท่านั้น) ตามข้อมูลของ OpenAI ซึ่งตั้งมาตรฐานใหม่สำหรับการสร้างโค้ด/การประเมินวิศวกรรมในการทดสอบของพวกเขา ซึ่งหมายถึงการดีบักที่เชื่อถือได้มากขึ้นและการแก้ไขแบบ end-to-end ในการใช้งานจริง ตามตัวอย่างของ OpenAI
- GPQA Diamond (Q&A วิทยาศาสตร์ระดับบัณฑิตศึกษา) — GPT-5.2 Pro: 93.2%, GPT-5.2 Thinking: 92.4% บน GPQA Diamond (ไม่มีเครื่องมือ ใช้เหตุผลสูงสุด).
- ซีรีส์ ARC-AGI — บน ARC-AGI-2 (เกณฑ์ทดสอบการให้เหตุผลแบบยืดหยุ่นที่ยากกว่า) GPT-5.2 Thinking ได้คะแนน 52.9% และ GPT-5.2 Pro 54.2% (OpenAI ระบุว่านี่เป็นสถิติใหม่ระดับ state-of-the-art สำหรับโมเดลสไตล์ chain-of-thought).
- Long-context (OpenAI MRCRv2) — GPT-5.2 Thinking แสดงความแม่นยำเกือบ 100% บน MRCR รุ่น 4-needle จนถึง 256k โทเค็น และได้คะแนนที่ดีขึ้นอย่างมีนัยสำคัญเมื่อเทียบกับ GPT-5.1 ในสภาพแวดล้อมบริบทยาว (OpenAI เผยแพร่กราฟและตาราง MRCRv2).
การเปรียบเทียบกับรุ่นร่วมสมัย
- เทียบกับ Google Gemini 3 (Gemini 3 Pro / Deep Think): Gemini 3 Pro ได้รับการประชาสัมพันธ์ว่ามีหน้าต่างบริบท ~1,048,576 (≈1M) โทเค็น พร้อมอินพุตมัลติโมดัลที่หลากหลาย (ข้อความ ภาพ เสียง วิดีโอ PDF) และการผสานเชิงตัวแทนที่แข็งแกร่งผ่าน Vertex AI / AI Studio โดยในเชิงสเปค หน้าต่างบริบทที่ใหญ่กว่าของ Gemini 3 เป็นตัวแยกแยะสำหรับงานโหลดขนาดใหญ่มากในเซสชันเดียว; ข้อแลกเปลี่ยนรวมถึงขอบเขตเครื่องมือและความเข้ากันได้กับระบบนิเวศ
- เทียบกับ Anthropic Claude Opus 4.5: Opus 4.5 ของ Anthropic เน้นเวิร์กโฟลว์การเขียนโค้ด/ตัวแทนระดับองค์กร และรายงานผล SWE-bench ที่แข็งแกร่งและความทนทานสำหรับเซสชันตัวแทนระยะยาว; Anthropic วางตำแหน่ง Opus สำหรับงานอัตโนมัติและการสร้างโค้ดด้วยหน้าต่างบริบท 200k และการผสานตัวแทน/Excel เฉพาะทาง Opus 4.5 เป็นคู่แข่งที่แข็งแกร่งในงานอัตโนมัติระดับองค์กรและงานโค้ด
ข้อสรุปเชิงปฏิบัติ: GPT-5.2 มุ่งปรับปรุงอย่างสมดุล (บริบท 400k การผลิตโทเค็นจำนวนมาก การให้เหตุผล/การเขียนโค้ดที่ดีขึ้น) Gemini 3 มุ่งเป้าบริบทขนาดใหญ่ที่สุดในเซสชันเดียว (≈1M) ในขณะที่ Claude Opus เน้นวิศวกรรมระดับองค์กรและความทนทานของตัวแทน ควรเลือกโดยพิจารณาขนาดบริบท ความต้องการด้านโมเดลิตี ความเหมาะสมของฟีเจอร์/เครื่องมือ และข้อแลกเปลี่ยนด้านต้นทุน/เวลาแฝง
วิธีเข้าถึงและใช้งาน GPT-5.2 API
ขั้นตอนที่ 1: สมัครรับ API Key
เข้าสู่ระบบที่ cometapi.com หากคุณยังไม่ได้เป็นผู้ใช้ของเรา โปรดลงทะเบียนก่อน ลงชื่อเข้าใช้ CometAPI console รับ API key สำหรับการเข้าถึงอินเทอร์เฟซ คลิก “Add Token” ที่ API token ในศูนย์ส่วนบุคคล รับ token key: sk-xxxxx และส่ง
ขั้นตอนที่ 2: ส่งคำขอไปยัง GPT-5.2 API
เลือก endpoint “gpt-5.2” เพื่อส่งคำขอ API และกำหนด request body วิธีการร้องขอและ request body สามารถดูได้จากเอกสาร API บนเว็บไซต์ของเรา เว็บไซต์ของเรายังมีการทดสอบ Apifox เพื่อความสะดวกของคุณ แทนที่ <YOUR_API_KEY> ด้วย CometAPI key จริงจากบัญชีของคุณ นักพัฒนาสามารถเรียกใช้ผ่าน Responses API / Chat endpoints.
Insert your question or request into the content field—this is what the model will respond to . Process the API response to get the generated answer.
ขั้นตอนที่ 3: ดึงและตรวจสอบผลลัพธ์
ประมวลผลการตอบกลับของ API เพื่อรับคำตอบที่สร้างขึ้น หลังจากประมวลผล API จะตอบกลับด้วยสถานะงานและข้อมูลผลลัพธ์
ดูเพิ่มเติม Gemini 3 Pro Preview API